SelectDB介绍:
SelectDB是基于ApacheDoris构建的现代化数据仓库,支持大规模实时数据上的极速查询分析,主要用于OLAP场景下对大规模数据进行快速分析和查询,它支持多维分析、实时查询、增量更新、高效的数据更新等功能。
SelectDB目前有两个商业化产品:SelectDBCloud和SelectDBEnterprise,能够差异化地满足来自云上和私有化部署用户的不同需求。
SelectDB主要有四个应用场景:实时报表、湖仓一体、日志存储与分析、用户画像与行为分析。
Elasticsearch介绍:
Elasticsearch(简称ES)是一个分布式的、基于RESTfulAPI的搜索和分析引擎,广泛用于大规模的数据存储和快速检索。它最初由ShayBanon于2010年开发,是开源的,并且是ElasticStack(通常称为ELKStack)的核心组成部分,另外组成部分是Logstash、Beats(用于数据收集和处理)和Kibana(用于数据可视化)。
案例分享:
从Elasticsearch到SelectDB,观测云实现日志存储与分析的10倍性价比提升
在云计算逐渐成熟的当下,越来越多的企业开始将业务迁移到云端,传统的监控和故障排查方法已经无法满足企业的需求。观测云可以实现对云、云原生、应用及业务的统一监测,提供整体数据的分析、洞察、可视化、自动化、监测告警、智能巡查、安全巡查等服务。本文将分享 SelectDB 如何助力观测云完成日志数据存储和分析架构升级,实现在存储成本降低70%的同时、查询性能提升2-4倍,最终实现整体性价比10倍提升,为日志存储和分析场景服务提供强大动力。
面临的挑战和痛点:
观测云基于VictoriaMetrics存储模块研发了时序存储引擎MetricStore,同时在泛日志场景集成了Elasticsearch/OpenSearch。这样的设计使GuanceDB(GuanceDB是一个观测云自主研发的由多种数据库技术组成的多模态数据库)对外有统一的写入和查询接口,能适应不同类型的数据格式和业务需求。在当前的实现中,MetricStore已经具备卓越的性能。然而,对于日志类和用户行为类数据的处理来说,Elasticsearch却有诸多不足,具体表现如下:
1、写入占用资源多:Elasticsearch在处理高频写入大量的数据时,会占用较高的CPU和内存资源,这不仅会显著增加集群成本,还会挤占查询所占用的资源。
2、对无模式表支持差:Elasticsearch对于Schemaless支持有限,当前的DynamicMapping在面对大量的用户自定义字段时,会频繁造成字段类型冲突,导致数据丢失,需要人工介入进行手动处理。
3、聚合查询性能差:Elasticsearch在面对海量数据时,聚合性能表现较差。例如对亿级数据计算分位数、错误率时,极易出现超时,很难满足大规模数据下的业务分析需求。
解决方案:基于SelectDB的存储架构升级
在可观测性场景中,几乎所有的查询都涉及时间的筛选,同时大部分的聚合也需要按照时间窗口来进行,并且针对时间序列,还需要支持按单个序列在时间窗口前后进行Rollup。在这些场景中,使用SQL来表达相同的语义就需要嵌套多层子查询,导致表达过程和编写都异常复杂。
因此开始尝试简化语法元素,在此基础上设计出了新的查询语言DQL,并且增强了在可观测场景下的常见计算函数,通过DQL即可查询指标、日志、链路追踪、对象等所有的可观测数据。
从GuanceDB内部结构来看,本次升级使用SelectDB替换了Elasticsearch/OpenSearch,原有的查询架构保持不变。
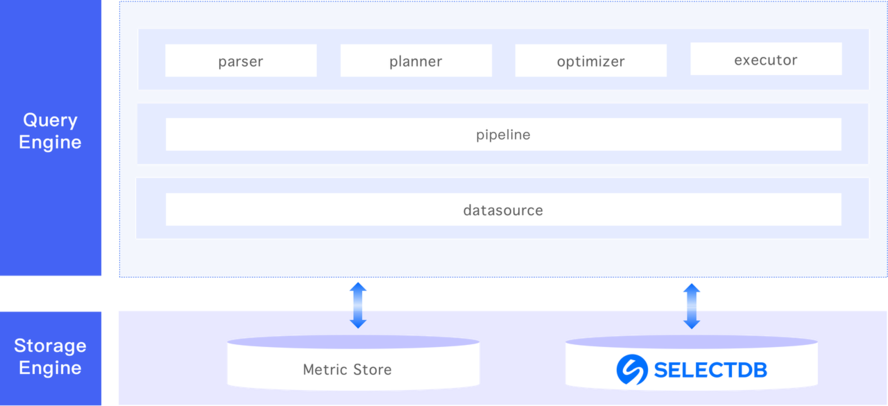
在引入SelectDB之后,DQL查询的工作模式如下图:
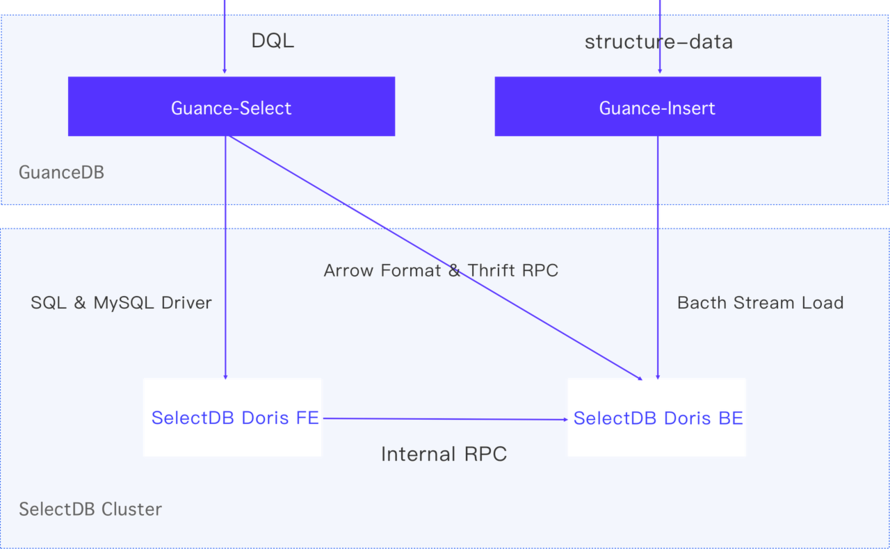
如上图所示,Guance-Insert是数据写入组件,Guance-Select是DQL查询引擎。
在Guance-Insert中,实现了分租户的数据攒批逻辑,均衡了写入吞吐量和写入延迟两大指标,尽量高效地将数据通过StreamLoad接口写给SelectDBDorisBE组件。当海量日志产生时,该方式攒批速度很快,平均日志入库延迟在2-3秒。
在Guance-Select中,Guance-Select会根据当前查询SelectDB的SQL支持情况,选择是否将查询下推给FE计算。通常情况下,常见的聚合查询都可以下推给FE计算,但当遇到FE不支持的SQL语义或函数时,我们就会选择Fallback到仅下推谓词到BE,通过ThriftRPC接口获取Arrow格式的列存数据,再在Guance-Select中计算。由于此方案无法将计算逻辑下推BE,因此实际性能会略差于在FE中的查询。不过在大部分场景下,这种方案是可以满足需求的。
当前的查询架构是综合FE和BE能力的混合计算架构,DQL即可以利用SelectDB已经充分优化的查询能力,也可以让语法拓展不受SelectDB本身SQL能力的限制。
收益:
1、存储成本降低约70%、查询性能提升3倍
SelectDB的引入,实现了综合成本的大幅降低。之前我们在云上某可用区使用的是由20台16C64G云主机组成的Elasticsearch集群提供查询服务,同时采用了独立的索引写入服务(相当于使用20台云主机)。在替换成SelectDB之后,只需要13台同配置的云主机,总成本下降了67%。
2、倒排索引满足日志场景全文检索需求
倒排索引能够显著提升全文检索的性能并降低查询的资源开销,是实现高效日志分析的必备能力。SelectDB支持倒排索引,以下是我们从Elasticsearch迁移到SelectDB过程中关键能力的介绍:
支持字符串全文检索,包括可同时匹配多个关键字
MATCH_ALL
、匹配任意一个关键字
MATCH_ANY
、匹配短语词组
MATCH_PHRASE
的查询方式。我们对日志文本内容创建倒排索引时使用
MATCH_PHRASE
进行查询,能够完整覆盖原来在Elasticsearch上的功能。
支持英文、中文及Unicode多语言分词,中文分词还支持自定义词库、自定义停用词。我们将原先在Elasticsearch上使用的中文词库和停用词配置到SelectDB上,完成了用户体验平滑迁移。

除了在功能上能够满足日志全文检索的需求,SelectDB倒排索引还支持在线按需增减索引。Elasticsearch索引在创建时是固定的,后续无法新增索引字段,这就需要提前规划哪些字段需要建立索引,后续如需变更索引则需要重写,变更成本非常高。
3、Variant数据类型,解决数据Schema频繁变化痛点
在常见的数据库中,大部分数据表的Schema是静态的,也有一些数据库如Elasticsearch可以通过Mapping实现动态Schema。然而,动态Schema可能会遇到字段类型冲突或因历史字段不失效而导致字段数量达到上限的问题。在引入SelectDB之后,我们使用最新特性Variant动态数据类型(该特性将在ApacheDoris2.1版本中正式发布)可以很好地支持这类场景。
本案例中SelectDB对比Elasticsearch的具体优势体现
1、SelectDB写入性能高于Elasticsearch;
2、SelectDB数据和索引压缩率高于Elasticsearch;
3、SelectDB支持冷热数据分层存储;
4、SelectDB倒排索引支持在线按需增减索引;
5、SelectDB的Variant数据类型能够解决字段类型冲突或因历史字段不失效而导致字段数量达到上限的问题;
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70017904/viewspace-3050985/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Apache Doris 基于 Lance 的向量检索深度解析
- Apache Doris x Fluss:面向湖流一体的统一查询与分析
- Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
- StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
- 快手基于 Apache Doris 千亿多模态检索的实践
- 某头部保险公司基于 SelectDB 的统一 OLAP 架构实践
- Doris 直查 Paimon 索引:快手湖上向量检索的共建与落地
- Apache Doris+ Paimon 2.0:构建 Agentic AI 数据闭环
- Apache Doris + Lance:让多模态数据真正进入智能驾驶与具身智能的分析闭环
- Apache Doris 5.0 年度版本前瞻(一):构建统一的多模湖仓实时分析平台
