作者:肖康, 技术 副总裁 、 Committer
日志数据是企业大数据体系中重要的组成部分之一,这些数据记录了网络设备、操作系统以及应用程序的详细历史行为,蕴含了丰富的信息价值,在可观测性、网络安全、业务分析等关键业务领域发挥着重要作用,可帮助企业更好了解系统及业务运行情况,及时发现及解决问题,以保障系统安全稳定运行。具体而言,日志数据可以通过以下方式为企业带来价值:
- 可观测性:日志是可观测性的三大基石(Logging,Metrics,Tracing)之一,其数据规模占比最高,常用于监控告警、故障排查时快速检索、Trace 关联等,可保证系统稳定运行、提升运维效率;
- 网络安全:日志记录了网络和主机上发生的每一个事件和行为,用于安全分析、调查取证、安全检测等,是提升系统安全性、降低被攻击风险的重要手段;
- 业务分析:在常见的业务分析中,比如在用户行为分析和用户画像等场景中,通常需要对用户行为日志进行复杂分析,帮助企业了解用户的喜好和行为轨迹,进一步提高用户满意度、促进留存和转化。因此日志不仅用于运维和安全保障,对于业务增长也发挥着不可或缺的作用。
日志数据本质是一系列系统事件的有序记录,其生成方式和使用场景决定了具备以下几个特点:
-
Schema Free:日志数据最初始的表现形态为非结构化原始日志,以 Free Text 的形式存在,然而非结构化数据是不便于进行聚合统计等分析操作的。如果想对这些数据进行存储分析,就需要先通过 ETL 将非结构化数据加工为结构化表格,再在数据库/数据仓库中进行分析。而在这个过程中,当日志结构发生变化时,还需要对 ETL 和结构化表格进行相应的调整,这就需要研发和 DBA 团队的协助,流程复杂、耗费时间长且执行难度高。在此之后进一步诞生了以 JSON 为主的半结构化日志,日志生成者可以自主增减字段,日志存储系统根据数据调整存储结构。
-
数据量大:日志数据规模通常非常庞大并生产周期不间断,特别是在大型企业或典型的日志应用中,每天产生的日志数据可达十 TB 或百 TB级别。同时为了满足业务需求或符合监管要求,日志数据往往需要存储半年甚至更长时间,存储总量经常达到 PB 级别,为各企业带来高昂的存储成本。而随着时间的推移,日志数据的价值也在逐渐下降,因此对于日志系统来说,存储成本也变的更加敏感。
-
实时写入与检索:日志数据常用于故障排查、安全追踪等时效要求较高的场景,因此如果数据写入延迟过高,就无法及时获取最新发生的事件;如果关键字检索响应慢则无法满足工程师、分析师的交互式分析需求。因此对于日志系统而言,要求在高吞吐写入的前提下保证秒级以下的查询响应时间,并能够提供全文检索的能力以及秒级响应的交互式查询能力。
为了应对以上需求、发挥出日志数据的更高价值,业界对于日志场景有不少解决方案,而以 Elasticsearch 为核心的 ELK 体系则是其中典型代表。在此我们以 Elasticsearch 为例,来分享基于 Elasticsearch 的日志系统架构是如何面临挑战。
基于 Elasticsearch 的日志系统挑战
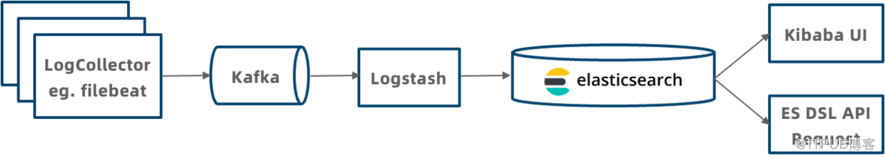
基于 Elasticsearch 的日志系统典型架构如上图所示,整个系统分为下面几个模块:
-
日志收集:通过 Filebeat 采集本地的日志文件,写入到 Kafka 消息队列;
-
日志传输:使用 Kafka 消息队列集中和缓存日志;
-
日志转换:LogStash 消费 Kafka 中的日志,进行数据过滤、格式转换等操作;
-
日志存储:LogStash 将日志以 JSON 格式写入 ES 存储中;
-
日志查询:通过 Kibana 可视化查询 ES 中的日志,或者通过 ES DSL API 发起查询请求;
基于 Elasticsearch 的日志系统架构具有较好的实时日志检索能力,然而该系统在实际应用中也存在一些痛点,如写入吞吐低、存储成本高、不支持复杂查询等问题。
Schema Free 支持不够
Elasticsearch 的 Index Mapping 定义了数据的 Schema,包括字段的名字、数据类型、是否建索引等。
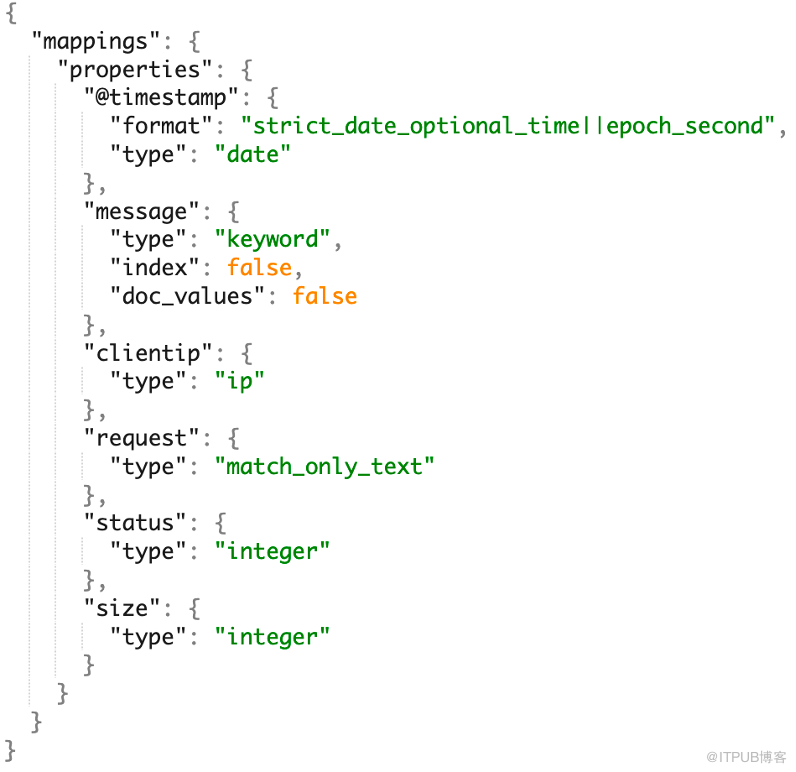
Elasticsearch 的 Dynamic Mapping 可以根据写入的 JSON 数据自动增加 Mapping 中的字段,对日志数据的Schema Free 提供了一定程度的支持,但是也存在明显不足:
- Dynamic Mapping 性能差:当遇到脏数据时容易出现大量字段,严重影响系统性能和稳定性。
- 字段类型固定:当业务类型变更时无法进行修改,为了满足不同的业务需求,用户常常使用 text 类型来兼容,但是 text 类型的查询性能是远不如 integer 等二进制类型的查询性能。
- 字段的索引固定:无法根据需求自行增加或删除某个字段的索引,灵活性较差。因此用户为了保证查询过滤的速度,通常会在所有字段上都创建索引。而在所有字段上创建索引又会带来写入速度变慢、存储空间增加等新的问题。
分析能力弱
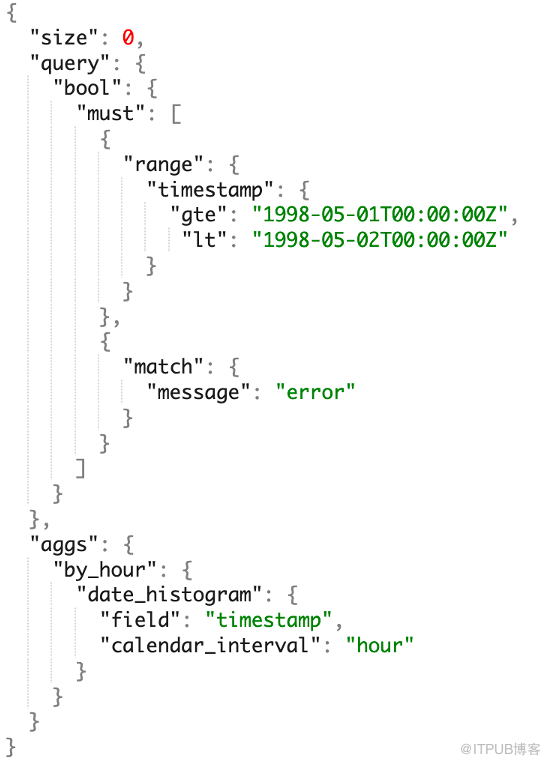
Elasticsearch 开发的 ES DSL(Domain Specific Language,特定领域语言)与大多数工程师、数据分析师熟悉的技术栈差异比较大,这为用户设置了较高的学习和使用门槛,并需要学习大量的多新的概念和语法,即使学会之后还需要经常查阅手册才能写出正确的 DSL 语句。同时,Elasticsearch 生态自成体系、比较封闭,与其他系统如 BI 工具等打通比较困难。 更重要的是, Elasticsearch 分析能力较弱,只支持简单的单表分析,不支持多表 JOIN、子查询、视图等复杂分析,无法满足企业日志分析需求。
成本高,性价比低
基于 Elasticsearch 的日志系统使用成本较高也是一个被用户长期诟病的问题,成本主要来源于两个方面:
- 写入的计算成本:Elasticsearch 在写入时要构建倒排索引,会进行分词、倒排表排序等计算密集型操作,CPU 资源占用较大,单核写入性能在 2MB/s 左右。当一个 Elasticsearch 集群的大多数 CPU 资源都被写入消耗时,在遇到写入流量高峰时极易触发写入 Reject,从而导致数据延迟变长、查询速度变慢。
- 数据的存储成本:为加速检索和分析的速度,Elasticsearch 存储了原始数据正排、倒排索引、Docvalue 列存等多份数据,因此造成存储成本大幅增高,且单副本存储的压缩率整体被限制在 1.5 倍左右,远低于日志数据常见的 5 倍压缩比。
而随着数据和集群规模增长, Elasticsearch 集群还面临一些稳定性问题:
- 写入不稳定:当遇到写入高峰时,将造成集群负载高的问题,从而影响写入的稳定性。
- 查询不稳定:由于查询都在内存中处理,大查询容易触发 JVM OOM,进而影响整个集群的写入和查询的稳定性。
- 故障恢复慢:Elasticsearch 集群在故障后恢复时需要进行 Index 加载等资源占用较大的操作,因此故障恢复时间经常需要数十分钟,对服务可用性和 SLA 提出了很大的挑战。
基于 Apache Doris 构建新一代日志分析系统
从以上方案对可知,基于 Elasticsearch 的日志系统架构在应用中无法同时兼顾高吞吐、低存储成本和实时高性能的要求,且不支持复杂查询。那么是否有其他方案可以较好的平衡成本与性能,且能提供更好的分析能力呢?答案是有的。
立志于通过一个系统解决多个场景的数据分析问题、降低复杂技术展带来的运维和使用成本,为了更加契合日志数据分析的场景需求,Apache Doris 在 2.0 版本中引入了多项功能优化:例如支持原生的半结构数据类型,优化了 Text 匹配速度和文本算法,从而提升了日志数据导入和查询的性能;增加了倒排索引、以满足字符串类型的全文检索和普通数值/日期等类型的等值、范围检索。最终通过 Benchmark 测试和实际应用验证表明, 基于 Apache Doris 构建的新一代日志分析系统相较于 Elasticsearch 具有最高 10 倍的性价比提升。
基于 Apache Doris 的日志系统典型架构如下图所示,相较于 Elasticsearch 整个系统架构更加开放:
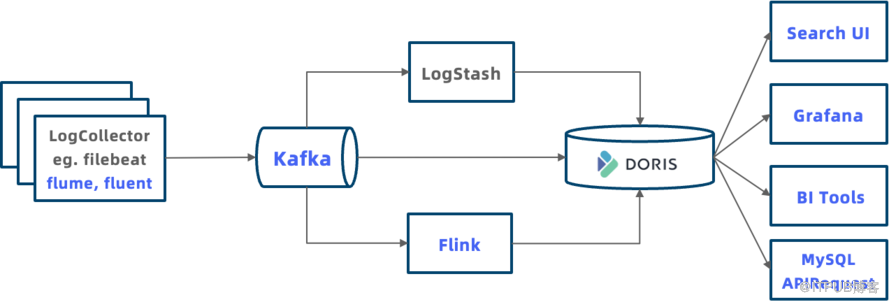
- 更多日志接入方式:Doris 提供了多种日志数据的导入方式。例如支持 LogStash 通过 HTTP Output 将日志推送到 Doris、支持使用 Flink 对日志进行加工后再写入 Doris,支持 Routine Load 和 S3 Load 导入存储在 Kafka 或者对象存储中的日志数据。
- 统一存储消除数据孤岛:日志数据可以统一存储到 Doris 中,并可以和数仓中其他数据进行关联分析,不再是独立存在的数据孤岛。
- 开放生态,更强分析能力:Doris 兼容 MySQL 协议,各类数据分析工具或者客户端可以通过 MySQL 连接到 Doris ,包括可观测性系统 Grafana、常见的 BI 分析工具 Tableau 等。应用程序也可以通过 JDBC、ODBC 等标准 API 来连接 Doris ,以进行业务特定的查询分析。后续我们还将完成类似于 Kibana 的可视化日志探索分析系统,进一步提升日志分析的体验。
除此之外,基于 Apache Doris 的日志系统还具备以下几个重要的优势:
原生的半结构化数据支持
为了更好的适应 Text、JSON 格式日志 Schema Free 的特点,Apache Doris 在这两个方面进行了增强:
-
提供丰富的数据类型:优化已有 Text 的数据类型,通过向量化技术提升字符串查找、正则匹配的性能,通过这些优化实现性能提升 2-10倍;增加 JSON 数据类型,在数据写入对 JSON字符串进行解析并存储成紧凑高效的二进制格式,可使得查询性能提升 4 倍;增加 Array Map 复杂数据类型,将原本使用字符串拼接的复杂类型结构化,进一步提升了存储压缩率和查询性能。
-
支持 Schema Evolution:与 Elasticsearch 不同的是,Apache Doris 支持根据业务需要对 Schema 进行调整,包括按需在线增减字段、增减索引、更改字段数据类型等。
- Apache Doris 推出的 Light Schema Change 功能可以根据数据变化进行毫秒级增减字段:
-
-- 增加列,毫秒级返回,立即生效ALTER TABLE lineitem ADD COLUMN l_new_column INT;
- 通过 Light Schema Change 还可以按需增加倒排索引,无需为所有字段创建索引,避免不必要的写入和存储开销。Doris 在增加索引时,默认对新写入数据生成索引,并可以对历史数据选择对哪些分区生成索引,用户可灵活控制。
-- 增加倒排索引,毫秒级返回,新写入数据自动生成索引ALTER TABLE table_name ADD INDEX index_name(column_name) USING INVERTED;-- 历史partition可以按需BUILD INDEX,后台增量生成索引BUILD INDEX index_name ON table_name PARTITIONS(partition_name1, partition_name2);
基于 SQL 的分析引擎
Apache Doris 支持标准 SQL、兼容 MySQL 协议和语法,因此基于 Doris 的日志系统能够使用 SQL 进行日志分析,这使得日志系统具备以下优势:
-
简单易用:工程师和数据分析师对于 SQL 非常熟悉,经验可以复用,不需要学习新的技术栈即可快速上手。
-
生态丰富:MySQL 生态是数据库领域使用最广泛的语言,因此可以与 MySQL 生态的集成和应用无缝衔接。 Doris 可以利用 MySQL命令行与各种 GUI 工具、BI 工具等大数据生态结合,实现更复杂及多样化的数据处理分析需求。
-
分析能力强:SQL 语言已经成为数据库和大数据分析的事实标准,它具有强大的表达能力和功能,支持检索、聚合、多表 JOIN、子查询、UDF、逻辑视图、物化视图等多种数据分析能力。
相对于 Elasticsearch 5-10 倍性价比提升
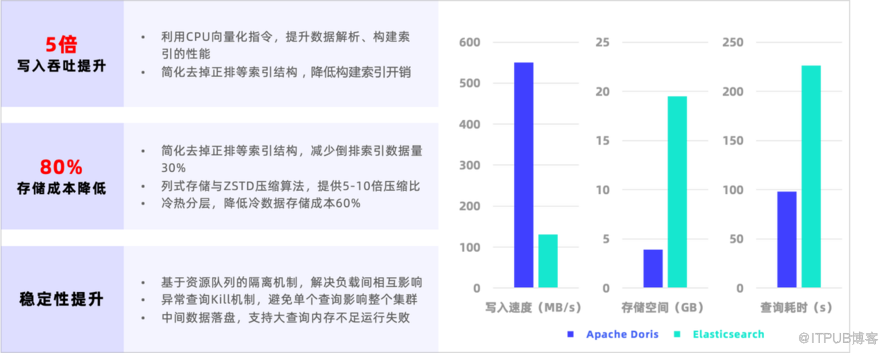
经过 Benchmark 测试及生产验证,基于 Apache Doris 高性能基础引擎针对日志场景进行优化后,日志系统性价比相对于 Elasticsearch 具有 5-10 倍的提升。
- 写入吞吐提升:Elasticsearch 写入的性能瓶颈在于解析数据和构建倒排索引的 CPU 消耗。相比之下,Doris 进行了两方面的写入优化:一方面利用 SIMD 等 CPU 向量化指令提升了 JSON 数据解析速度和索引构建性能;另一方面针对日志场景简化倒了排索引结构,去掉日志场景不需要的正排等数据结构,有效降低了索引构建的复杂度。
- 存储成本降低:Elasticsearch 存储瓶颈在于正排、倒排、Docvalue 列存多份存储和通用压缩算法压缩率较低。相比之下,Doris 在存储上进行了以下优化:去掉正排,缩减了30%的索引数据量;采用列式存储和 ZSTD 压缩算法,压缩比可达到 5-10 倍,远高于 Elasticsearch 的 1.5 倍;日志数据中冷数据访问频率很低,Doris 冷热分层功能可以将超过定义时间段的日志自动存储到更低的对象存储中,冷数据的存储成本可降低 70% 以上。
我们在 Elasticsearch 提供的官方性能 Benchmark Rally 的 HTTP Logs 测试集上进行了对比测试。如下图可知,Doris 写入速度是 Elasticsearch 的 5 倍,存储空间减少了 80%,达到 550 MB/s,写入后的数据压缩比接近 1:10、存储空间节省超 80% ,查询耗时下降 57%、查询性能是 Elasticsearch 的 2.3 倍。加上冷热数据分离降低冷数据存储成本,整体相较 Elasticsearch 实现 10 倍以上的性价比提升。
用户实践
在用户实际场景的验证中,Doris 也表现出了超出预期的性价比优势。例如,某游戏公司最初使用的是 Elasticsearch,通过标准的 ELK 进行日志分析,使用成本非常高。由于存储成本过高,使得该公司在日志数据的合理存储和高效分析受到了很大的限制,无法满足业务需求。而在使用 Doris 搭建日志系统后,所需存储空间仅是 Elasticsearch 的 1/6,极大的降低了存储成本。同时 Doris 的高性能和优秀的分析能力,也使得该公司能够更高效灵活的处理日志数据,并提供更好的业务支持。此外,某安全公司利用 Doris 提供的倒排索引构建了日志分析系统,仅使用原来 1/5 的服务器,承载了 30 万每秒的写入流量,导入及查询速度更快。Doris 的引入,不仅降低了该公司运营成本,也极大的提升了分析的效率及系统稳定性,为业务提供了强有力的支持
实践指南
下面为大家介绍基于 Apache Doris 构建新一代日志系统的实践步骤。
首先需要在 Apache Doris 官网: 下载 2.0 及以上版本;下载完成后参考部署文档进行集群部署: https://doris.apache.org/zh-CN/docs/dev/install/standard-deployment
-
建表
参考下面的例子建表,关键点如下:
- 使用 DATETIMEV2 类型的时间字段作为 Key,在查询最新 N 条日志时有明显加速
- 对经常查询的字段创建索引,对需要全文检索的字段指定分词器 Parser 参数
- 分区使用时间字段上的 RANGE 分区,开启动态 Partiiton 可按天自动管理分区
- 分桶使用 RANDOM 随机分桶,使用 AUTO 可让系统根据集群规模和数据量自动计算分桶数量
- 使用冷热分离配置 log_s3 对象存储和 log_policy_1day 超过1天转存 s3 策略
CREATE DATABASE log_db;USE log_db;CREATE RESOURCE "log_s3"PROPERTIES( "type" = "s3", "s3.endpoint" = "your_endpoint_url", "s3.region" = "your_region", "s3.bucket" = "your_bucket", "s3.root.path" = "your_path", "s3.access_key" = "your_ak", "s3.secret_key" = "your_sk");CREATE STORAGE POLICY log_policy_1dayPROPERTIES( "storage_resource" = "log_s3", "cooldown_ttl" = "86400");CREATE TABLE log_table( `ts` DATETIMEV2, `clientip` VARCHAR(20), `request` TEXT, `status` INT, `size` INT, INDEX idx_size (`size`) USING INVERTED, INDEX idx_status (`status`) USING INVERTED, INDEX idx_clientip (`clientip`) USING INVERTED, INDEX idx_request (`request`) USING INVERTED PROPERTIES("parser" = "english"))ENGINE = OLAPDUPLICATE KEY(`ts`)PARTITION BY RANGE(`ts`) ()DISTRIBUTED BY RANDOM BUCKETS AUTOPROPERTIES ("replication_num" = "1","storage_policy" = "log_policy_1day","deprecated_dynamic_schema" = "true","dynamic_partition.enable" = "true","dynamic_partition.time_unit" = "DAY","dynamic_partition.start" = "-3","dynamic_partition.end" = "7","dynamic_partition.prefix" = "p","dynamic_partition.buckets" = "AUTO","dynamic_partition.replication_num" = "1");
-
日志导入
Apache Doris 支持多种数据导入方式,对于实时日志数据,推荐 3 种导入方式:
- 如果日志数据在 Kafka 消息队列中,配置 Doris Routine Load 可从 kafka 中实时拉取数据。
- 如果之前使用了 Logstash 等工具将日志写入 Elasticsearch,可以选择配置 Logstash 通过 HTTP 接口将日志写入到 Doris 中。
- 如果是自定义的写入程序,也可以通过 HTTP 接口将日志写入到 Doris 中。
Kafka 导入
将 JSON 格式的日志写入 Kafka 消息队列,创建 Kafka Routine Load,让 Doris 从 Kafka 中主动拉取数据。示例如下,其中
property.* 配置是非必须的:
-- 准备好kafka集群和topic log _topic-- 创建routine load,从kafka log _topic将数据导入log_table表CREATE ROUTINE LOAD load_log_kafka ON log_db.log_tableCOLUMNS(ts, clientip, request, status, size)PROPERTIES ( "max_batch_interval" = "10", "max_batch_rows" = "1000000", "max_batch_size" = "109715200", "strict_mode" = "false", "format" = "json")FROM KAFKA ( "kafka_broker_list" = "host:port", "kafka_topic" = "log _topic", "property.group.id" = "your_group_id", "property.security.protocol"="SASL_PLAINTEXT", "property.sasl.mechanism"="GSSAPI", "property.sasl.kerberos.service.name"="kafka", "property.sasl.kerberos.keytab"="/path/to/xxx.keytab", "property.sasl.kerberos.principal"="xxx@yyy.com");
创建好 Routine Load 后,可以通过
SHOW ROUTINE LOAD 查看运行状态。更多使用说明请参考
https://doris.apache.org/zh-CN/docs/dev/data-operate/import/import-way/routine-load-manual。
Logstash 导入
配置 Logstash 的 HTTP Output,将数据通过 HTTP Stream Load 发送到 Doris。
-
lo``gstash.yml配置 Batch 攒批条数和时间,用于提升数据写入性能
pipeline.batch.size: 100000pipeline.batch.delay: 10000
-
testlog.conf日志采集配置文件中增加一个 HTTP Output、URL 配置 Doris 的 Stream Load 地址。
- 目前因为 Logstash 不支持 HTTP 跳转,需要配置 BE 地址,不能用 FE 地址。
- Headers 中 Authorization 是
http basic auth,用命令echo -n 'username:password' | base64 来计算。 - Headers 中
load_to_single_tablet参数能够减少导入的小文件。
output { http { follow_redirects => true keepalive => false http_method => "put" url => "[ "format", "json", "strip_outer_array", "true", "load_to_single_tablet", "true", "Authorization", "Basic cm9vdDo=", "Expect", "100-continue" ] format => "json_batch" }}
自定义程序导入
参考下面的方式通过 Http Stream Load 接口导入数据到 Doris,关键点如下:
- 使用
basic auth进行 HTTP 鉴权,用命令echo -n 'username:password' | base64来计算 - 设置
http header "format:json",指定数据格式为 JSON - 设置
http header "read_json_by_line:true",指定每行一个 JSON - 设置
http header "load_to_single_tablet:true",指定一次写入一个分桶 - 目前建议写入客户端一个 Batch 100MB ~ 1GB,后续版本会通过服务端 Group Commit 降低客户端 Batch 大小
curl \--location-trusted \-u username:password \-H "format:json" \-H "read_json_by_line:true" \-H "load_to_single_tablet:true" \-T logfile.json \
-
查询
Doris 支持标准 SQL,可以通过 MySQL客 户端或者通过 JDBC 等方式连接到集群,然后执行 SQL 进行查询。
mysql -h fe_host -P fe_mysql_port -u root -Dlog_db
下面是日志分析场景中,常见的几种查询。
- 查看最新的 10 条数据
SELECT * FROM log_table ORDER BY ts DESC LIMIT 10;
- 查询 clientip 为 '8.8.8.8'的最新 10 条数据
SELECT * FROM log_table WHERE clientip = '8.8.8.8' ORDER BY ts DESC LIMIT 10;
- 检索 request 字段中有 error 或者 404 的最新 10 条数据, MATCH_ANY 是 Doris 全文检索的 SQL 语法关键字,匹配参数中任意一个关键字
SELECT * FROM log_table WHERE request MATCH_ANY 'error 404' ORDER BY ts DESC LIMIT 10;
- 检索 request 字段中有 image 和 faq 的最新 10 条数据, MATCH_ALL 是 Doris 全文检索的 SQL 语法关键字,匹配参数中所有的关键字
SELECT * FROM log_table WHERE request MATCH_ALL 'image faq' ORDER BY ts DESC LIMIT 10;
总结
Apache Doris 针对日志场景进行了多项优化,最终达到存储空间节省超 80% 、写入速度是 Elasticsearch 的 5倍、查询性能是 Elasticsearch 的 2.3 倍。在冷热数据分层功能加持下,整体相较 Elasticsearch 实现 10 倍以上的性价比提升。这些都表明,Apache Doris 已经足够支撑各企业构建新一代日志系统。
后续倒排索引还会增加对 JSON、Map 等复杂数据类型的支持。而 BKD 索引可以支持多维度类型的索引,为未来 Doris 增加 GEO 地理位置数据类型和索引打下了基础。与此同时 Apache Doris 在半结构化数据分析方面还有更多能力扩展,比如丰富的复杂数据类型(Array、Map、Struct、JSON)以及高性能字符串匹配算法等,这些更显将满足更加丰富的日志应用场景。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70017904/viewspace-2966501/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Apache Doris x Fluss:面向湖流一体的统一查询与分析
- Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
- StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
- 快手基于 Apache Doris 千亿多模态检索的实践
- 某头部保险公司基于 SelectDB 的统一 OLAP 架构实践
- Doris 直查 Paimon 索引:快手湖上向量检索的共建与落地
- Apache Doris+ Paimon 2.0:构建 Agentic AI 数据闭环
- Apache Doris + Lance:让多模态数据真正进入智能驾驶与具身智能的分析闭环
- Apache Doris 5.0 年度版本前瞻(一):构建统一的多模湖仓实时分析平台
- 统一全文检索与 SQL 分析:Apache Doris 日志分析实践
