前言
上一篇讲述了
KunlunBase的查询优化原理(
KunlunBase 查询优化(一)),本篇讲述Project和Filter下推演示。
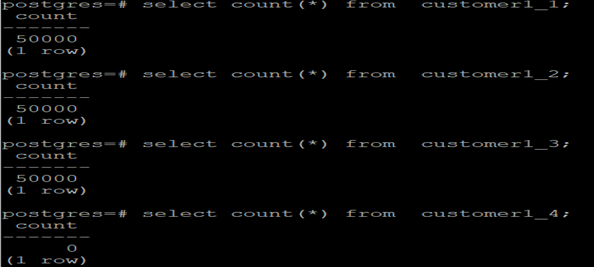
一、测试表基本信息
select t1.name, t2.shard_id, t2.hostaddr, t2.port, t2.user_name, t2.passwd from pg_shard t1, pg_shard_node t2 where t2.shard_id=t1.id;
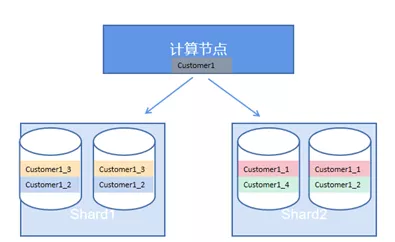
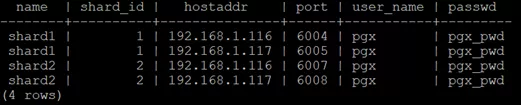
select t1.nspname, t2.relname,t2.relshardid, t2.relkindfrom pg_namespace t1 join pg_class t2 ont1.oid = t2.relnamespace where t2.relshardid != 0 and relkind='r' and relname like '%customer1%' order by t2.relname;
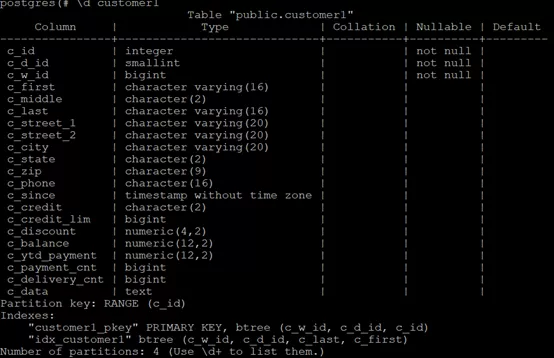
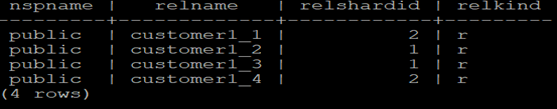
二、查询过程
explain select c_id,c_first,c_middle from customer1where c_id=4;
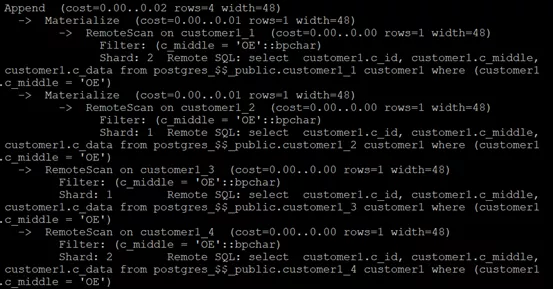
explain select c_id ,c_middle,c_data from customer1 where c_middle='OE';
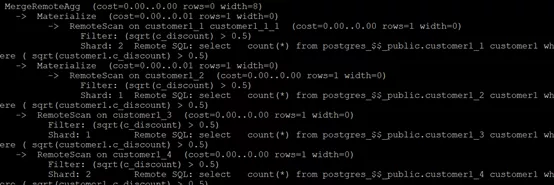
explain select count(*) from customer1 where sqrt(c_discount)>0.5;
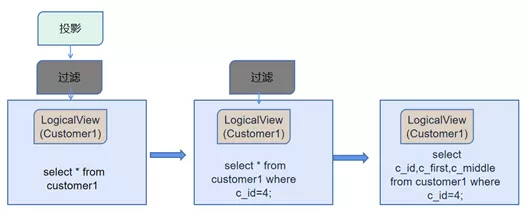
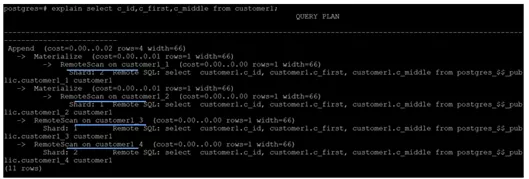
explain select c_id,c_first,c_middle from customer1;
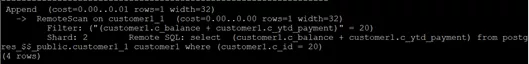
explain selectc_balance + c_ytd_payment from customer1where c_id =20;
-
对应用程序透明,即应用程序不需要做任何修改就可以访问数据。
-
存储节点对数据做读取及投影操作,减少计算节点的负载(更少的CPU 和内存消耗)。
-
数据分布在不同的存储节点上,方便系统弹性扩展IO 能力及避免IO 的热点竞争。
-
投影和过滤操作,减少数据块读写范围 ,可以提高查询效率。
三、性能比对
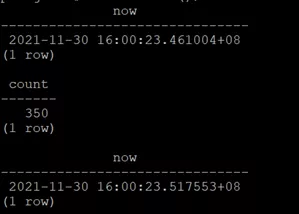
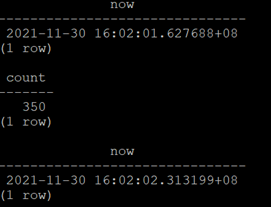
select now(); select count(*) from customer1 where c_id between 4 and 10;select now();
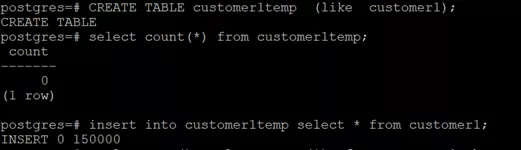
CREATE TABLEcustomer1temp (like customer1);insert intocustomer1temp select * From customer1
select now(); select count(*) from customer1temp where c_idbetween 4 and 10 ;select now();
推荐阅读
KunlunBase架构介绍
KunlunBase技术优势介绍
KunlunBase技术特点介绍
PostgreSQL vs MySQL TPC-H 测试
Kunlun-Storage vs PostgreSQL OLTP 测试
-END-
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70011764/viewspace-2852637/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
KunlunBase 查询优化(一)

请登录后发表评论
登录
全部评论
最新文章
- 《Klustron Tech Talk》直播选题有奖问卷调查,获MySQL系列丛书
- 《Klustron Tech Talk》直播选题有奖问卷调查,获MySQL系列丛书
- 北京 Meetup 预告 | 内含六个话题,满满干货,期待见面!
- 北京 Meetup 预告 | 内含六个话题,满满干货,期待见面!
- 报名开启!KunlunBase今年首场线下MeetUP,期待与您的见面!
- 【明晚直播】KunlunBase 1.1 版本发布:完善MySQL 兼容性,OLAP性能提升
- 【明晚直播】KunlunBase 1.1 版本发布:完善MySQL 兼容性,OLAP性能提升
- KunlunBase功能体验范例
- KunlunBase功能体验范例
- KunlunBase 1.0 发布了!
