对某项技术进行系统性的学习,始终离不开对该项技术的整体认知。只有领略其全貌,方可将各块知识点更好的串联起来。为了进一步理解和学习MySQL,我们有必要了解一下MySQL的体系构架、存储引擎和索引结构。
MySQL体系构架
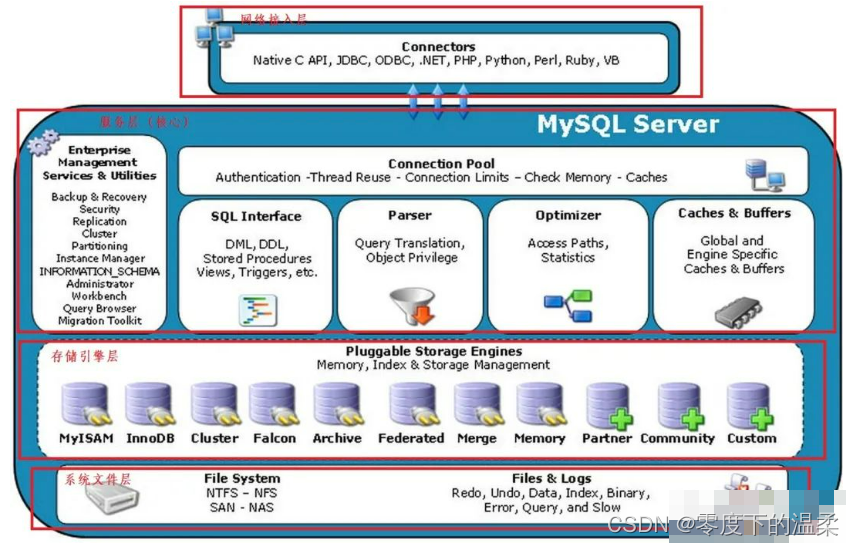
以下是官网MySQL体系构架图,我们稍微对其进行了层级划分。

英文不好的同学可以看下中文版的:
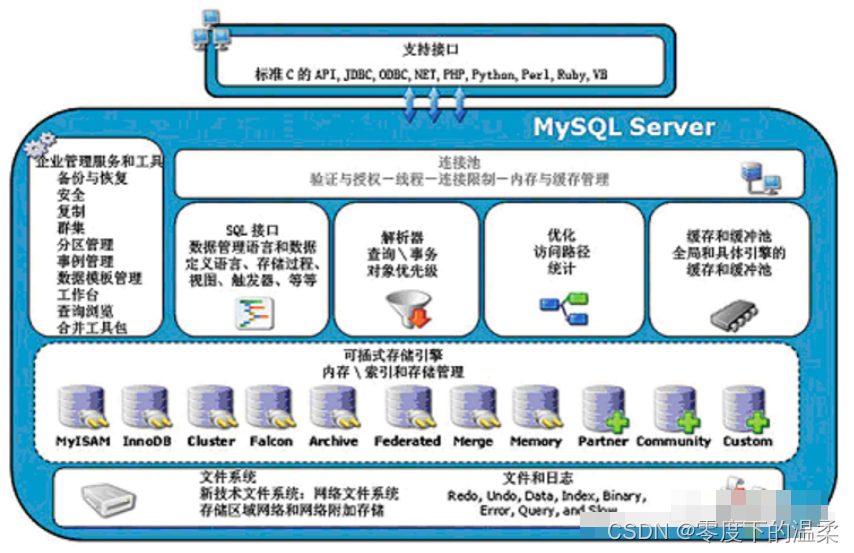
由上至下,我们可以MySQL的体系构架划分为:1.网络接入层 2.服务层 3.存储引擎层 4.文件系统层
网络接入层
提供了应用程序接入MySQL服务的接口。客户端与服务端建立连接,客户端发送SQL到服务端。
服务层
管理工具和服务
系统管理和控制工具,例如备份恢复、Mysql复制、集群等
连接池
主要负责连接管理、授权认证、安全等等。每个客户端连接都对应着服务器上的一个线程。服务器上维护了一个线程池,避免为每个连接都创建销毁一个线程。当客户端连接到MySQL服务器时,服务器对其进行认证。可以通过用户名与密码认证,也可以通过SSL证书进行认证。登录认证后, 【关注尚硅谷,轻松学IT】服务器还会验证客户端是否有执行某个查询的操作权限_ 。
由于每次建立连接需要消耗很多时间,连接池的作用就是将这些连接缓存下来,下次可以直接用已经建立好的连接,提升服务器性能。
SQL接口
接受用户的SQL命令,并且返回用户操作的结果。
查询解析器
SQL命令传递到解析器的时候会被解析器验证和解析。
MySQL是一个DBMS(数据库管理系统),没法直接理解SQL语句。Parser负责对SQL语句进行解析好让DBMS知道该怎么做。
查询优化器
SQL语句在查询之前会使用查询优化器对查询进行优化。它使用的是“选取-投影-联接”策略进行查询以此选择一个最优的查询路径。
select uid,name from user where gender = 1;
select 查询先根据 where 语句进行选取,而不是先将表全部查询出来以后再进行条件过滤
select查询先根据 uid 和 name 进行属性投影,而不是将属性全部取出以后再进行过滤
将这两个查询条件联接起来生成最终查询结果
缓存(8.0版本之前支持查询缓存,8.0之后不支持了)
查询缓存,如果查询缓存有命中的查询结果,查询语句就可以直接去查询缓存中取数据。
通过LRU算法将数据的冷端溢出,未来得及时刷新到磁盘的数据页,叫脏页。
这个缓存机制是由一系列小缓存组成的。比如表缓存,记录缓存,key缓存,权限缓存等
存储引擎层
负责数据的存储和读取,与数据库文件打交道。服务器中的查询执行引擎通过API与存储引擎进行通信,通过接口屏蔽了不同存储引擎之间的差异。
MySQL采用插件式的存储引擎。MySQL为我们提供了许多存储引擎,每种存储引擎有不同的特点。我们可以根据不同的业务特点,选择最适合的存储引擎。
MySQL区别于其他数据库的最重要的一个特点就是插件式的表存储引擎,注意:存储引擎是基于表的。
系统文件层
该层主要是将数据库的数据存储在文件系统之上,并完成与存储引擎的交互。
存储引擎是基于表的,以下分别使用MyISAM和InnoDB存储引擎建立两张表,看看其在文件系统中对应的文件存储格式。
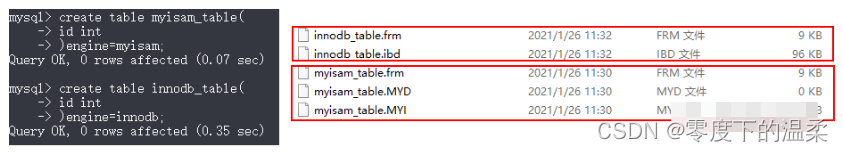
存储引擎为MyISAM:
- *.frm:与表相关的元数据信息都存放在frm文件,包括表结构的定义信息等
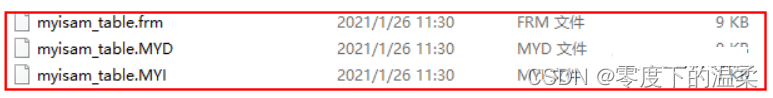
- *.MYD:MyISAM DATA,用于存储MyISAM表的数据
- *.MYI:MyISAM INDEX,用于存储MyISAM表的索引相关信息
存储引擎为InnoDB:
- *.frm:与表相关的元数据信息都存放在frm文件,包括表结构的定义信息等
- *.ibd:InnoDB DATA,表数据和索引的文件。该表的索引(B+树)的每个非叶子节点存储索引,叶子节点存储索引和索引对应的数据
除了.ibd文件InnoDB还有一种文件的存储格式为.ibdata文件,那么他们之间有什么区别呢?
InnoDB的数据存储方式能够通过配置来决定是使用共享表空间存放存储数据,还是用独享表空间存放存储数据。独享表空间存储方式使用.ibd文件,并且每个表为一个ibd文件。共享表空间存储方式采用.ibdata文件,所有的表共同使用一个ibdata文件,即所有的数据文件都存在一个文件中。决定使用哪种表的存储方式可以通过mysql的配置文件中innodb_file_per_table选项来指定。
InnoDB默认使用的是独享表的存储方式,这种方式的好处是当数据库产生大量文件碎片的时,整理磁盘碎片对线上运行环境的影响较小。
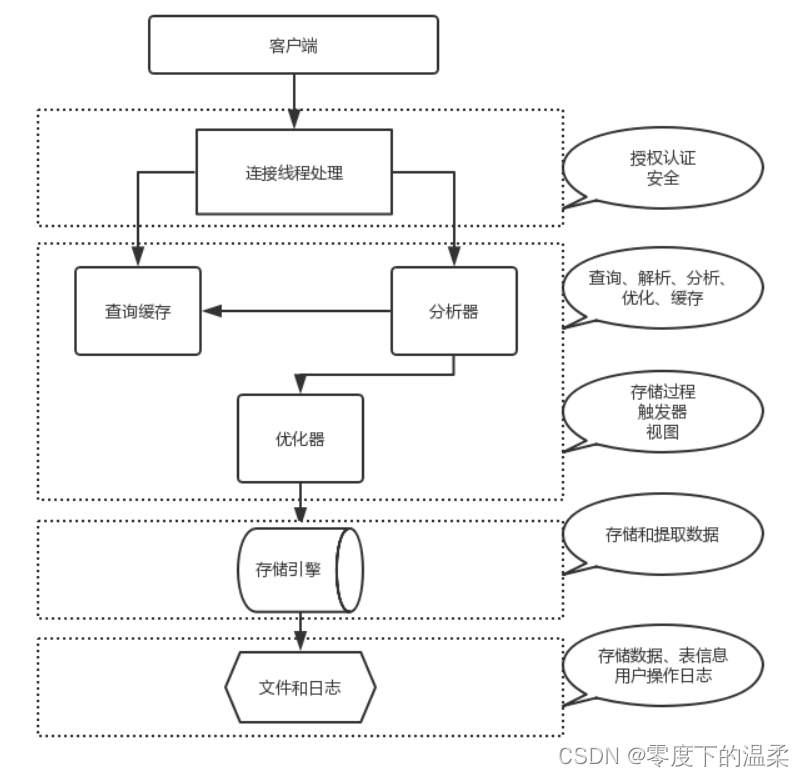
【拓展】一个SQL语句在MySQL中的整体流程
:

简化版:
存储引擎
了解存储引擎
MySQL中的数据用各种不同的技术存储在文件(或者内存)中。每一种技术都使用不同的存储机制、索引技巧、锁定水平并且最终提供广泛的不同的功能和能力。通过选择不同的技术,能够获得额外的速度或者功能,从而改善应用的整体功能。这些不同的技术以及配套的相关功能在MySQL中被称作存储引擎(也称作表类型)。
MySQL区别于其他数据库的最重要的一个特点就是插件式的表存储引擎,也就是说存储引擎是基于表的。
存储引擎的概念是MySQL里面才有的, 【关注尚硅谷,轻松学IT】不是所有的关系型数据库都有存储引擎这个概念 。其它数据库系统 (包括大多数商业选择)仅支持一种类型的数据存储, 也就是说采用“ 一个尺码满足一切需求 ”的存储方式,也意味着“功能强大,性能平庸”。而MySQL默认配置了许多不同的存储引擎,你可以根据业务需求选取一种最适配最高效的存储引擎。这也是为什么MySQL为何如此受欢迎的主要原因之一。
存储引擎分类
查看当前安装的MySQL版本支持的存储引擎
-- 查看MySQL版本
select version();
-- 查看版本支持的存储引擎
show engines;
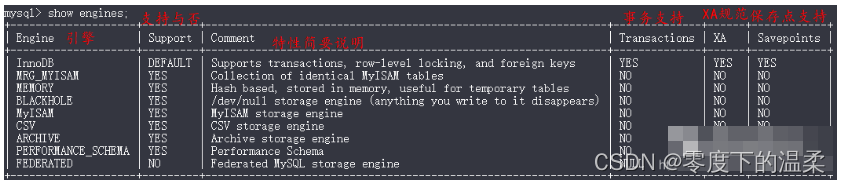
我本地安装的社区版MySQL,版本号为5.7.23,支持9种存储引擎或者说是8种(FEDERATED NO SUPPORT 不支持FEDERATED),而官网提供了10种存储引擎。本地与官网支持的存储引擎略微不同,个人估计是社区版和商用版的差别的缘故,或者是安装时候配置项设置导致的差异,有清楚的小伙伴还望告知一下。
官网5.7版本支持的10种存储引擎:
- MyISAM:拥有较高的插入,查询速度,但不支持事务
- InnoDB :5.5.8版本后Mysql的默认数据库引擎,支持ACID事务,支持行级锁定
- BDB:源自Berkeley DB,事务型数据库的另一种选择,支持COMMIT和ROLLBACK等其他事务特性
- Memory :所有数据置于内存的存储引擎,拥有极高的插入,更新和查询效率。但是会占用和数据量成正比的内存空间。并且其内容会在Mysql重新启动时丢失
- Merge :将一定数量的MyISAM表联合而成一个整体,在超大规模数据存储时很有用
- Archive :非常适合存储大量的独立的,作为历史记录的数据。因为它们不经常被读取。Archive拥有高效的插入速度,但其对查询的支持相对较差
- Federated:将不同的Mysql服务器联合起来,逻辑上组成一个完整的数据库。非常适合分布式应用
- Cluster/NDB :高冗余的存储引擎,用多台数据机器联合提供服务以提高整体性能和安全性。适合数据量大,安全和性能要求高的应用
- CSV:逻辑上由逗号分割数据的存储引擎。它会在数据库子目录里为每个数据表创建一个.CSV文件。这是一种普通文本文件,每个数据行占用一个文本行。CSV存储引擎不支持索引。
- BlackHole :黑洞引擎,写入的任何数据都会消失,一般用于记录binlog做复制的中继
常用存储引擎特性
存储特性要求
存储引擎常见的目标特性要求
并发性:某些应用程序比其他应用程序具有更高的颗粒级锁定要求(如行级锁定)。
事务支持:并非所有的应用程序都需要事务,但对的确需要事务的应用程序来说,有着定义良好的需求,如ACID兼容等。
引用完整性:通过DDL定义的外键,服务器需要强制保持关联数据库的引用完整性。
物理存储:它包括各种各样的事项,从表和索引的总的页大小,到存储数据所需的格式,到物理磁盘。
索引支持:不同的应用程序倾向于采用不同的索引策略,每种存储引擎通常有自己的编制索引方法,但某些索引方法(如B-tree索引)对几乎所有的存储引擎来说是共同的。
内存高速缓冲:与其他应用程序相比,不同的应用程序对某些内存高速缓冲策略的响应更好,因此,尽管某些内存高速缓冲对所有存储引擎来说是共同的(如用于用户连接的高速缓冲,MySQL的高速查询高速缓冲等),其他高速缓冲策略仅当使用特殊的存储引擎时才唯一定义。
性能帮助:包括针对并行操作的多I/O线程,线程并发性,数据库检查点,成批插入处理等。
其他目标特性:可能包括对地理空间操作的支持,对特定数据处理操作的安全限制等。
以上特性很多是互斥的,一个存储引擎只能具备其中某些要求。
具体查考官网Storage Engines Feature Summary
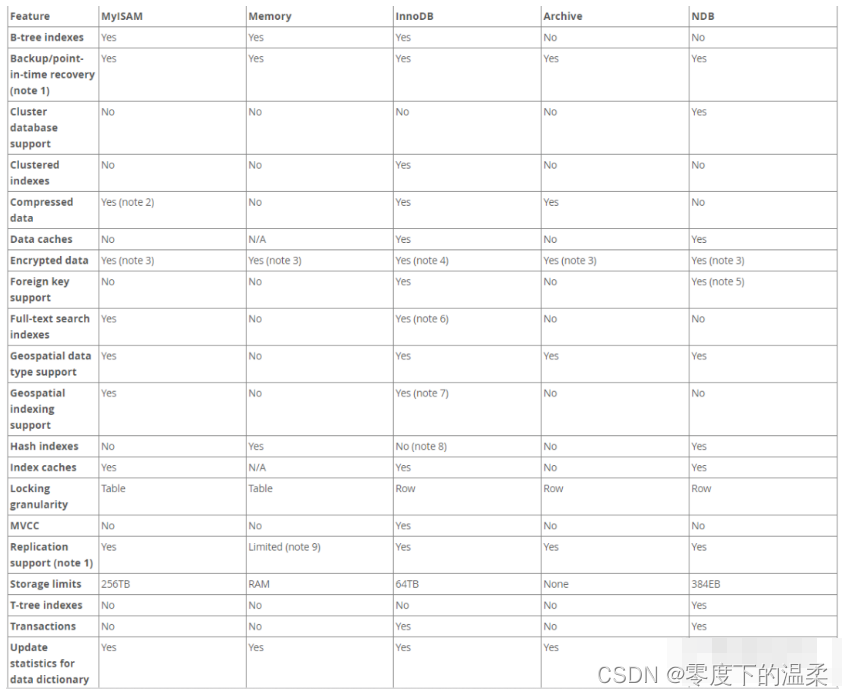
Notes:
- 在服务器中实现,而不是在存储引擎中。
- 只有使用压缩行格式时,才支持压缩的MyISAM表。使用MyISAM压缩行格式的表是只读的。
- 在服务器端通过加密功能实现。
- 在服务器端通过加密功能实现;在MySQL 5.7和更高版本中,支持数据静止表空间加密。
- 在MySQL Cluster NDB 7.3和更高版本中支持外键。
- InnoDB在MySQL 5.6和更高版本中提供对 全文索引(FULLTEXT ) 的支持。
- InnoDB在MySQL 5.7和更高版本中提供对地理空间索引的支持。
- InnoDB内部利用哈希索引来实现自适应哈希索引特性。
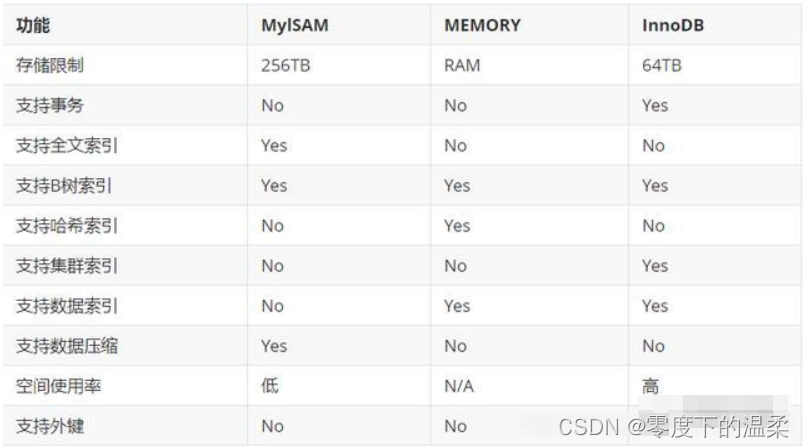
下文主要介绍InnoDB MyISAM Memory三种存储引擎,以下是三者简要特性对比
InnoDB引擎
InnoDB 是一个事务安全的存储引擎,它具备提交、回滚以及崩溃恢复的功能以保护用户数据。InnoDB 的行级别锁定保证数据一致性提升了它的多用户并发数以及性能。InnoDB 将用户数据存储在聚集索引中以减少基于主键的普通查询所带来的 I/O 开销。为了保证数据的完整性,InnoDB 还支持外键约束。默认使用B+TREE数据结构存储索引。
特点
- 支持事务,支持4个事务隔离(ACID)级别
- 行级锁定(更新时锁定当前行)
- 读写阻塞与事务隔离级别相关
- 既能缓存索引又能缓存数据
- 支持外键
- InnoDB更消耗资源,读取速度没有MyISAM快
- 在InnoDB中存在着缓冲管理,通过缓冲池,将索引和数据全部缓存起来,加快查询的速度;
- 对于InnoDB类型的表,其数据的物理组织形式是聚簇表。所有的数据按照主键来组织。数据和索引放在一块,都位于B+数的叶子节点上;
业务场景
- 需要支持事务的场景(银行转账之类)
- 适合高并发,行级锁定对高并发有很好的适应能力,但需要确保查询是通过索引完成的
- 数据修改较频繁的业务
InnoDB引擎调优
- 主键尽可能小,否则会给Secondary index带来负担
- 避免全表扫描,这会造成锁表
- 尽可能缓存所有的索引和数据,减少IO操作
- 避免主键更新,这会造成大量的数据移动
补充:事务(ACID)
A 事务的原子性(Atomicity):指一个事务要么全部执行,要么不执行.也就是说一个事务不可能只执行了一半就停止了.比如你从取款机取钱,这个事务可以分成两个步骤:1划卡,2出钱.不可能划了卡,而钱却没出来.这两步必须同时完成.要么就不完成.
.
C 事务的一致性(Consistency):指事务的运行并不改变数据库中数据的一致性.例如,完整性约束了a+b=10,一个事务改变了a,那么b也应该随之改变.
.
I 独立性(Isolation):事务的独立性也有称作隔离性,是指两个以上的事务不会出现交错执行的状态.因为这样可能会导致数据不一致.
.
D 持久性(Durability):事务的持久性是指事务执行成功以后,该事务所对数据库所作的更改便是持久的保存在数据库之中,不会无缘无故的回滚.
MyISAM引擎
MyISAM既不支持事务、也不支持外键、其优势是访问速度快,但是表级别的锁定限制了它在读写负载方面的性能,因此它经常应用于只读或者以读为主的数据场景。默认使用B+TREE数据结构存储索引。
特点
- 不支持事务
- 表级锁定(更新时锁定整个表)
- 读写互相阻塞(写入时阻塞读入、读时阻塞写入;但是读不会互相阻塞)
- 只会缓存索引(通过key_buffer_size缓存索引,但是不会缓存数据)
- 不支持外键
- 读取速度快
业务场景
- 不需要支持事务的场景(像银行转账之类的不可行)
- 一般读数据的较多的业务
- 数据修改相对较少的业务
- 数据一致性要求不是很高的业务
MyISAM引擎调优
- 设置合适索引
- 启用延迟写入,尽量一次大批量写入,而非频繁写入
- 尽量顺序insert数据,让数据写入到尾部,减少阻塞
- 降低并发数,高并发使用排队机制
- MyISAM的count只有全表扫描比较高效,带有其它条件都需要进行实际数据访问
Memory引擎
在内存中创建表。每个MEMORY表只实际对应一个磁盘文件(frm 表结构文件)。MEMORY类型的表访问非常得快,因为它的数据是放在内存中的,并且默认使用HASH索引。要记住,在用完表格之后就删除表格,不然一直占据内存空间。
特点
- 支持的数据类型有限制,比如:不支持TEXT和BLOB类型(长度不固定),对于字符串类型的数据,只支持固定长度的行,VARCHAR会被自动存储为CHAR类型;
- 支持的锁粒度为表级锁。所以,在访问量比较大时,表级锁会成为MEMORY存储引擎的瓶颈;
- 由于数据是存放在内存中,一旦服务器出现故障,数据都会丢失;
- 查询的时候,如果有用到临时表,而且临时表中有BLOB,TEXT类型的字段,那么这个临时表就会转化为MyISAM类型的表,性能会急剧降低;
- 默认使用hash索引。
- 如果一个内部表很大,会转化为磁盘表。
业务场景
- 那些内容变化不频繁的代码表,或者作为统计操作的中间结果表,便于高效地堆中间结果进行分析并得到最终的统计结果。
- 目标数据比较小,而且非常频繁的进行访问,在内存中存放数据,如果太大的数据会造成内存溢出。可以通过参数max_heap_table_size控制Memory表的大小,限制Memory表的最大的大小。
- 数据是临时的,而且必须立即可用得到,那么就可以放在内存中。
- 存储在Memory表中的数据如果突然间丢失的话也没有太大的关系。
存储引擎构架
为了进一步深入理解MySQL存储引擎,我们有必要了解一下存储引擎的数据存储结构,在此之前,我们得先了解下数据在文件系统中的存储。
磁盘基本知识
数据库的数据存储在文件系统中。文件系统是操作系统用来 明确 存储设备(常见的是磁盘,也有基于NAND Flash的固态硬盘)或分区上的文件 的方法和数据结构。磁盘上数据必须用一个三维地址唯一标示:柱面号、盘面号、块号(磁道上的盘块)。
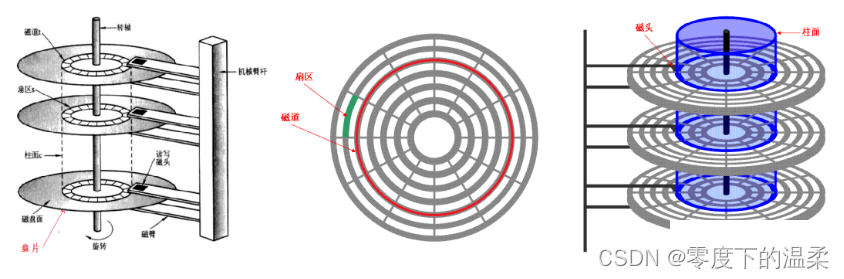
硬盘只是磁盘的一种,或说是经典代表,以下通过硬盘模型图讲解磁盘中的各个概念。
硬盘整体模型图

硬盘模型图
磁盘重点概念
- 盘片(platter):硬盘中承载数据存储的介质
硬盘一般由多个盘片组成,每个盘片包含两个面,每个盘面都对应地有一个读/写磁头。受到硬盘整体体积和生产成本的限制,盘片数量都受到限制,一般都在5片以内。盘片的编号自下向上从0开始,如最下边的盘片有0面和1面,再上一个盘片就编号为2面和3面。关注终端研发部获取2T的面试java开发资料
- 磁头(head):通过磁性原理读取磁性介质上数据的部件
- 磁道(track):当磁盘旋转时,磁头若保持在一个位置上,则每个磁头都会在磁盘表面划出一个圆形轨迹,这些圆形轨迹就叫做磁道
- 扇区(sector):磁盘上的每个磁道被等分为若干个弧段,这些弧段便是硬盘的扇区,同一块硬盘上的扇区大小是一致的
“每个磁道的扇区数一样的”说的是老的硬盘,外圈的密度小,内圈的密度大(简单理解就是,磁盘存储媒介为
磁性记忆材料,在内圈涂的密度高),故每圈可存储的数据量是一样的。新的硬盘数据的密度都一致,这样磁道的周长越长,扇区就越多,存储的数据量就越大。
- 柱面(cylinder):在有多个盘片构成的盘组中,由不同盘片的面,但处于同一半径圆的多个磁道组成的一个圆柱面
物理扇区(physical sector)与逻辑扇区(logical sector)
近年来,为了最求更高的硬盘容量,便出现了扇区存储容量为2048、4096等字节的硬盘,我们称这样的扇区为”物理扇区”。这样的大扇区会导致许多兼容性问题,有的系统或软件无法适应。为了解决这个问题,硬盘内部将物理扇区在逻辑上划分为多个扇区片段并将其作为普通的扇区(一般为512字节大小)报告给操作系统及应用软件。这样的扇区片段我们称之为“逻辑扇区”。实际读写时由硬盘内的程序(固件)负责在逻辑扇区与物理扇区之间进行转换,上层程序“感觉”不到物理扇区的存在。
逻辑扇区是硬盘可以接受读写指令的最小操作单元, 【关注尚硅谷,轻松学IT】是操作系统及应用程序可以访问的扇区,多数情况下其大小为512字节。我们通常所说的扇区一般就是指的逻辑扇区。物理扇区是硬盘底层硬件意义上的扇区,是实际执行读写操作的最小单元。是只能由硬盘直接访问的扇区,操作系统及应用程序一般无法直接访问物理扇区。当要读写某个逻辑扇区时,硬盘底层在实际操作时都会读写逻辑扇区所在的整个物理扇区。
磁盘容量计算
- 旧式——非ZBR区位记录(不同磁道扇区数相同)
存储容量 = 磁头数 × 磁道(柱面)数 × 每道扇区数 × 每扇区字节数
比如上图最右边硬盘容量:6 * 7 * 12 * 512 = 258048 byte
- 新式——ZBR区位记录(不同磁道扇区数不同)
块(Block)/簇(Cluster)
块/簇两者指的是同一个逻辑上的概念,只是在Linux与Windows中的称呼不同。
- 块/簇 是操作系统中最小的逻辑存储单位。操作系统与磁盘打交道的最小单位是块/簇。
- 在Windows下如NTFS等文件系统中叫做簇;在Unix和Linux下如Ext4等文件系统中叫做块(block)。
- 每个簇或者块可以包括2、4、8、16、32、64…2的n次方个扇区。
块/簇 用来干什么的
磁盘的最小单位是扇区,操作系统使用的是 块/簇 作为IO的基本单位。
- 读取方便:扇区容量小,数据多会加大寻址难度。操作系统将相邻的扇区组合一起形成块,再对块整体操作
- 分离对底层的依赖:操作系统忽略对底层物理存储结构的设计。通过虚拟出来磁盘块的概念,在系统中认为块是最小的单位
扇区是对硬盘而言,块是对文件系统而言,出于不同的需要。
查看块/簇的大小
不同文件系统中block的大小不一样。
Windows:(使用管理员命令提示行)
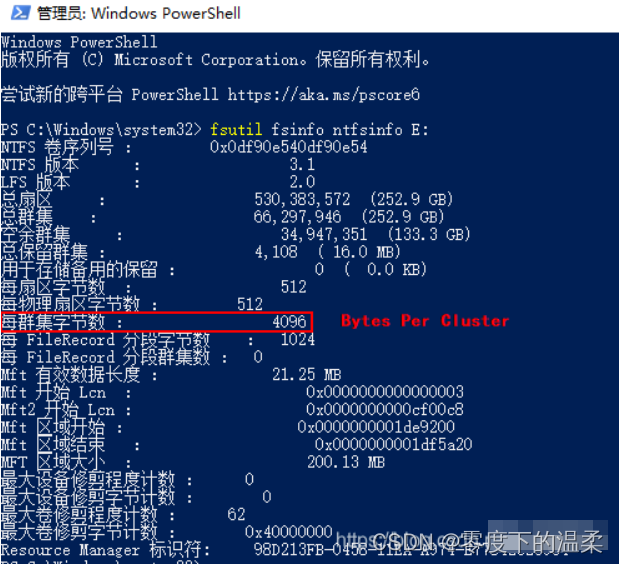
fsutil fsinfo ntfsinfo E:
Linux:
stat /home | grep "IO Block"
如下所示,Windows下E盘的Cluster的大小为4Kb大小,如下所示:
页(Page)
操作系统经常与内存和硬盘这两种存储设备进行通信,类似于“块”的概念,都需要一种虚拟的基本单位。与内存操作,是虚拟一个页的概念来作为最小单位。与硬盘打交道,就是以块为最小单位。
扇区、块/簇、页的关系
- 扇区:硬盘的最小读写单元
- 块/簇:是操作系统针对硬盘读写的最小单元
- 页:是内存与操作系统之间操作的最小单元。
- 扇区 <= 块/簇 <= 页
MySQL的InnoDB数据存储结构
MySQL的InnoDB数据存储结构可以划分为逻辑存储结构和物理存储结构。
前置:数据库磁盘读取与系统磁盘读取
- 系统从磁盘中读取数据到内存时是以磁盘块(block)为基本单位,位于同一个磁盘块中的数据会被一次性读取出来。
- InnoDB存储引擎中有页(Page)的概念,页是数据库管理磁盘的最小单位,InnoDB存储引擎中默认每个页的大小为16kb,每次读取磁盘时都将页载入内存中。
- 系统一个磁盘块的大小空间往往没有16kb这么大,因此InnoDB每次io操作时都会将若干个地址连续的磁盘块的数据读入内存,从而实现整页读入内存。
物理存储结构
从物理意义上来看,InnoDB表由共享表空间、日志文件组(更准确地说,应该是Redo文件组)、表结构定义文件组成。若将innodb_file_per_table设置为on,则每个表将独立地产生一个表空间文件,以ibd结尾,数据、索引、表的内部数据字典信息都将保存在这个单独的表空间文件中。表结构定义文件以frm结尾,这个是与存储引擎无关的,任何存储引擎的表结构定义文件都一样,为.frm文件。
逻辑存储结构
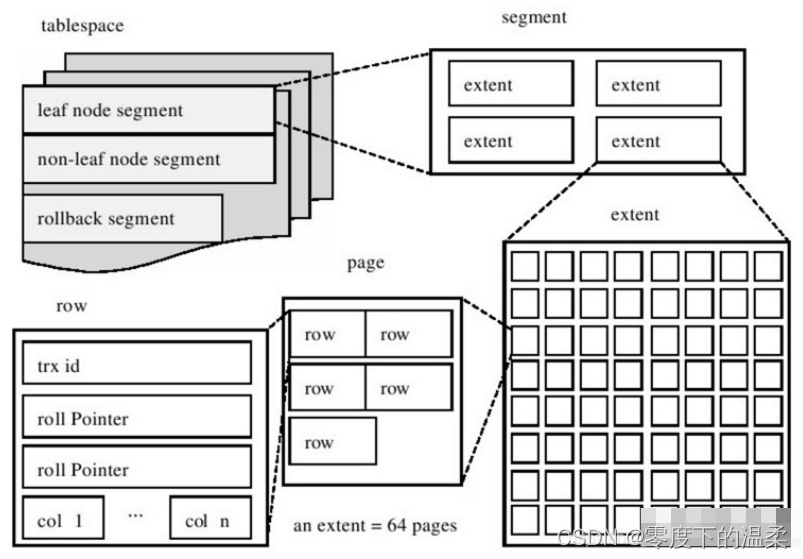
InnoDB存储引擎的逻辑存储结构和Oracle大致相同,所有数据都被逻辑地存放在一个空间中,我们称之为表空间。表空间又由段、区、页组成。1 extent = 64 pages,InnoDB存储引擎的逻辑存储结构大致如图所示。
表空间(tablespace)
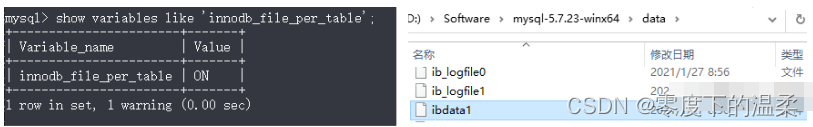
表空间可以看做是InnoDB存储引擎逻辑结构的最高层,所有的数据都是存放在表空间中。默认情况下InnoDB存储引擎有一个共享表空间ibdata1,即所有数据都放在这个表空间内。如果我们启用了参数innodb_file_per_table,则每张表内的数据可以单独放到一个表空间内。关注终端研发部获取2T的面试java开发资料
对于启用了innodb_file_per_table的参数选项, 【关注尚硅谷,轻松学IT】需要注意的是,每张表的表空间内存放的只是数据、索引和插入缓冲,其他类的数据,如撤销(Undo)信息、系统事务信息、二次写缓冲(double write buffer)等还是存放在原来的共享表空间内。这也就说明了另一个问题:即使在启用了参数innodb_file_per_table之后,共享表空间还是会不断地增加其大小。
段(segment)
表空间是由各个段组成的,常见的段有数据段、索引段、回滚段等。
InnoDB存储引擎表是由索引组织的(index organized),因此数据即索引,索引即数据。InnoDB采取B+树作为存储数据的结构,数据段即为B+树的叶节点(上图的leaf node segment),索引段即为B+树的非叶子节点(上图的non-leaf node segment)。
InnoDB存储引擎对于段的管理是由引擎本身完成。
区(extent)
一个区是由64个连续的页组成的,每个页大小为16KB,即每个区的大小为1MB。对于大的数据段,InnoDB存储引擎最多每次可以申请4个区,以此来保证数据的顺序性能。
在我们启用了参数innodb_file_per_talbe后,创建的表默认大小是96KB,新建的InnoDB表就是一个区。区是64个连续的页,那创建的表的大小至少是1MB才对啊?其实这是因为在每个段开始时,先有32个页大小的碎片页(fragment page)来存放数据,当这些页使用完之后才是64个连续页的申请。
create table innodb_table(
id int primary key
)engine=innodb default charset=utf8;
页(page)
每个页大小为16KB,页是InnoDB磁盘管理的最小单位,整页整页的读取。
InnoDB中主要的页类型:
- 数据页(BTreeNode)
- Undo页(undo Log page)
- 系统页(System page)
- 事务数据页(Transaction SystemPage)
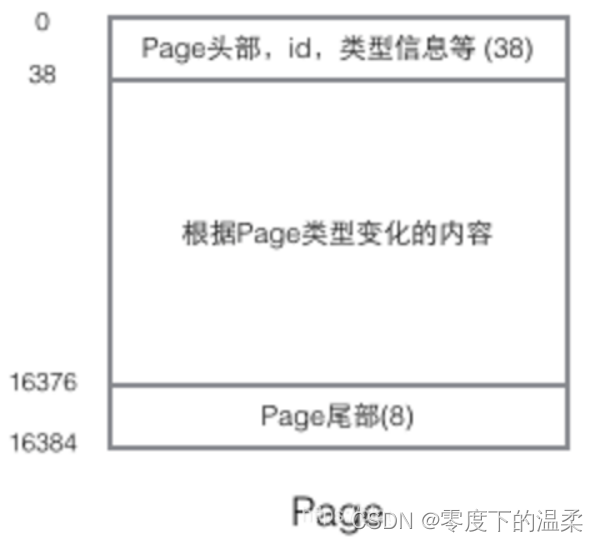
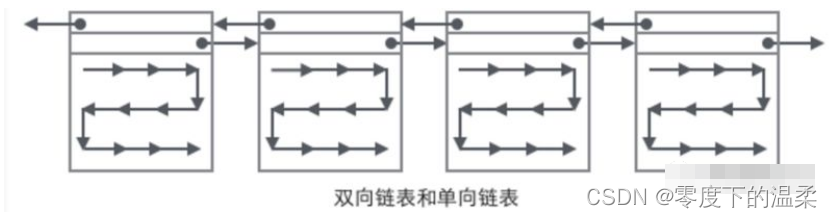
- 0-38:页头占据38位字节,页面id(32位的整数),页面类型,以及两个分别指向前一个page和后一个page的指针(page是一个双向列表)等信息关注终端研发部获取2T的面试java开发资料
- 38-16376:不同的类型页所含的数据不同,这部分空间包含系统记录(SystemRecord)和用户记录(UserRecord),我们表中的一条条记录就放在UserRecord部分
- 16376-16384:页面结束标识
由页组成的链表,页之间是双向列表,页里面的数据是单向链表,这种结构组成了主键索引B+树,组成了叶子节点数据。
拓展:定位一条表记录的过程
select * from user where id = 29
这里id是主键,我们通过这棵B+树来查找,首先找到根页,你怎么知道user表的根页在哪呢?
其实每张表的根页位置在表空间文件中是固定的。系统经过解析sql语句,首先从找到user表的跟页面(一个表通常需要多个页面组成,跟页面就是起始页),层级遍历非叶子节点页(索引)读取到key值为29的指针(遍历非叶子节点的过程随着节点的遍历会将一个或多个页加载到内存), 【关注尚硅谷,轻松学IT】最后到指针指向的叶子节点所在的页中,然后遍历找出该条记录。
如果使用了二级索引则先读取二级索引page遍历这个二级索引,找到装有主键信息叶子节点page页,遍历找到该主键。然后再根据主键索引寻找到该条记录,关注终端研发部获取2T的面试java开发资料
索引结构
常见的索引结构
Mysql数据库中的常见索引结构有多种,常用Hash,B-树,B+树等数据结构来进行数据存储。树的深度加深一层,意味着多一次查询,对于数据库磁盘而言,就是多一次IO操作,导致查询效率低下。
前置:二叉搜索树
了解下二叉搜索树有助于我们理解B-树、B+树,二叉搜索树的特点是:
- 所有非叶子结点至多拥有两个儿子(Left和Right);
- .所有结点存储一个关键字;
- 非叶子结点的左指针指向小于其关键字的子树,右指针指向大于其关键字的子树;
以下都是二叉搜索树:
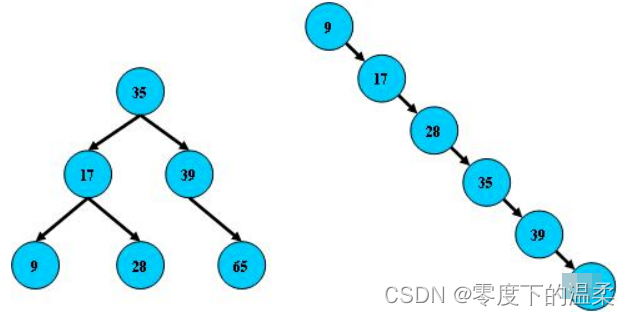
如果要找到65,左边的二叉树需要扫描3层(3次IO),而右边的却需要6层。
B-Tree(B树)
B-tree树即B树,B即Balanced,平衡的意思。因为B树的原英文名称为B-tree,而国内很多人喜欢把B-tree译作B-树,其实,这是个非常不好的直译,很容易让人产生误解。事实上,B-tree就是指的B树。
B树是一种多路搜索树,一棵m阶的B树满足下列条件:
- 树中每个结点至多有m个孩子
- 根结点的儿子数为[2, M];
- 除根结点以外的非叶子结点的儿子数为[M/2, M];
- 每个结点存放至少M/2-1(取上整)和至多M-1个关键字;(至少2个关键字)
- 非叶子结点的关键字个数 = 指向子节点的指针个数-1;
- 非叶子结点的关键字:K[1], K[2], …, K[M-1];且K[i] < K[i+1];
- 非叶子结点的指针:P[1], P[2], …, P[M];其中P[1]指向关键字小于K[1]的子树,P[M]指向关键字大于K[M-1]的子树,其它P[i]指向关键字属于(K[i-1], K[i])的子树;更多阅读:在100G内存下,MySQL查询200G大表会OOM么?
- 所有叶子结点位于同一层;
以下是3阶B树

磁盘读取数据是以盘块(block)为基本单位的。
以下结合磁盘块作图

B树的特征:
- 关键字集合分布在整颗树中;
- 任何一个关键字出现且只出现在一个结点中;
- 搜索有可能在非叶子结点结束;
- 其搜索性能等价于在关键字全集内做一次二分查找;
- 自动层次控制;
B树的搜索,从根结点开始,对结点内的关键字(有序)序列进行二分查找,如果命中则结束,否则进入查询关键字所属范围的儿子结点;重复,直到所对应的儿子指针为空,或已经是叶子结点;更多阅读:在100G内存下,MySQL查询200G大表会OOM么?
B+ Tree
B+树是B-树的变体,也是一种多路搜索树:(❀ 表示两者间的不同点)
- 树中每个结点至多有m个孩子
- 根结点的儿子数为[2, M];
- 除根结点以外的非叶子结点的儿子数为[M/2, M];
- 每个结点存放至少M/2-1(取上整)和至多M-1个关键字;(至少2个关键字)
- 非叶子结点的关键字:K[1], K[2], …, K[M-1];且K[i] < K[i+1];
- ❀ 非叶子结点的子树指针与关键字个数相同;
- ❀ 非叶子结点的子树指针P[i],指向关键字值属于[K[i], K[i+1])的子树;(B树是开区间);
- ❀ 为所有叶子结点增加一个链指针;
- ❀ 所有关键字都在叶子结点出现;
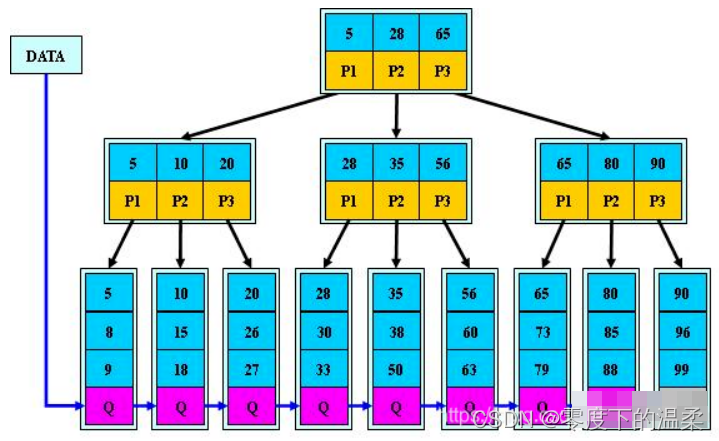
B+树的特征:
- 所有关键字都出现在叶子结点的链表中(稠密索引),且链表中的关键字恰好是有序的;
- 不可能在非叶子结点命中;
- 非叶子结点相当于是叶子结点的索引(稀疏索引),叶子结点相当于是存储(关键字)数据的数据层;
- 每一个叶子节点都包含指向下一个叶子节点的指针,从而方便叶子节点的范围遍历。
- 更适合文件索引系统;
B+树的搜索与B-树也基本相同,区别是B+树只有达到叶子结点才命中(B-树可以在非叶子结点命中),其性能也等价于在关键字全集做一次二分查找;
为什么B+ 树比B 树更适合作为索引?
- B+ 树的磁盘读写代价更低
B+ 树的数据都集中在叶子节点,分支节点 只负责指针(索引);B 树的分支节点既有指针也有数据 。这将导致B+ 树的层高会小于B 树的层高,也就是说B+ 树平均的Io次数会小于B 树。 - B+ 树的查询效率更加稳定
B+ 树的数据都存放在叶子节点,故任何关键字的查找必须走一条从根节点到叶子节点的路径。所有关键字的查询路径相同,每个数据查询效率相当。 - B+树更便于遍历
由于B+树的数据都存储在叶子结点中,分支结点均为索引,遍历只需要扫描一遍叶子节点即可;B树因为其分支结点同样存储着数据,要找到具体的数据,需要进行一次中序遍历按序来搜索。 - B+树更擅长范围查询
B+树叶子节点存放数据,数据是按顺序放置的双向链表。B树范围查询只能中序遍历。 - B+ 树占用内存空间小
B+ 树索引节点没有数据,比较小。在内存有限的情况下,相比于B树索引可以加载更多B+ 树索引。
Hash
哈希索引就是采用一定的哈希算法,把键值换算成新的哈希值,检索时不需要类似B+树那样从根节点到叶子节点逐级查找,只需一次哈希算法即可立刻定位到相应的位置,速度非常快。Memory存储引擎使用Hash。

Hash索引仅仅能满足”=”,“IN”和”<=>”查询,不能使用范围查询。也不支持任何范围查询,例如WHERE price > 100。
由于Hash索引比较的是进行Hash运算之后的Hash值,所以它只能用于等值的过滤,不能用于基于范围的过滤,因为经过相应的Hash算法处理之后的Hash值的大小关系,并不能保证和Hash运算前完全一样。更多阅读:在100G内存下,MySQL查询200G大表会OOM么?
从上面的图来看,B+树索引和哈希索引的明显区别是:
- 如果是等值查询,那么哈希索引明显有绝对优势,因为只需要经过一次算法即可找到相应的键值;这有个前提,键值都是唯一的。如果键值不是唯一的,就需要先找到该键所在位置,然后再根据链表往后扫描,直到找到相应的数据;
- 如果是范围查询检索,这时候哈希索引就毫无用武之地了,因为原先是有序的键值,经过哈希算法后,有可能变成不连续的了,就没办法再利用索引完成范围查询检索;
- 哈希索引也没办法利用索引完成排序,以及like ‘xxx%’ 这样的部分模糊查询(这种部分模糊查询,其实本质上也是范围查询);
- 哈希索引也不支持多列联合索引的最左匹配规则;
- B+树索引的关键字检索效率比较平均,不像B树那样波动幅度大,在有大量重复键值情况下,哈希索引的效率也是极低的,因为存在所谓的哈希碰撞问题。
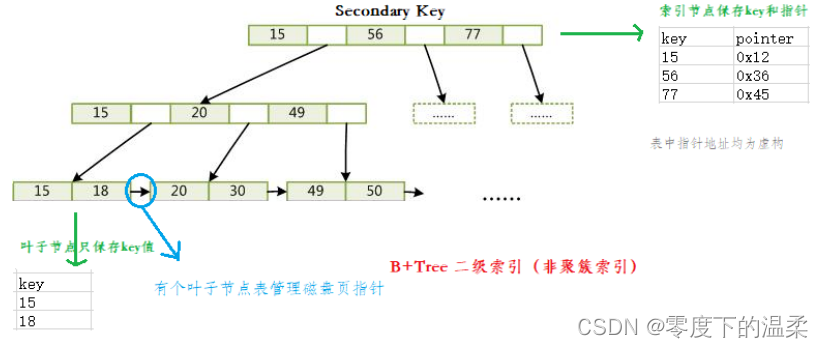
InnoDB B+Tree结构来存储索引
。一个表中只能存在一个聚簇索引(主键索引),但可以存在多个非聚簇索引。
B+树 叶子节点包含数据表中行记录就是聚簇索引(索引和数据是一块的)。

B+树 叶子节点没包含数据表中行记录就是非聚簇索引(索引和数据是分开的)。
B+ 树可以存储多少行数据
InnoDB存储引擎也有自己的最小储存单元——页(Page),一个页的大小默认是16K。
mysql> show variables like 'innodb_page_size';
+------------------+-------+
| Variable_name | Value |
+------------------+-------+
| innodb_page_size | 16384 |
+------------------+-------+
磁盘扇区、文件系统、InnoDB存储引擎都有各自的最小存储单元
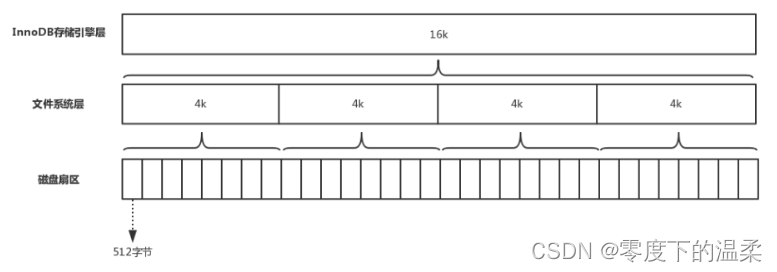
数据表中的数据都是存储在页中的,所以一个页中能存储多少行数据呢?假设一行数据的大小是1k,那么一个页可以存放16行这样的数据。更多阅读:在100G内存下,MySQL查询200G大表会OOM么?
如果数据库只按这样的方式存储,那么如何查找数据就成为一个问题?
因为我们不知道要查找的数据存在哪个页中,也不可能把所有的页遍历一遍,那样太慢了。
于是人们想到了用B+ 树的方式组织这些数据,下图以InnoDB为例。
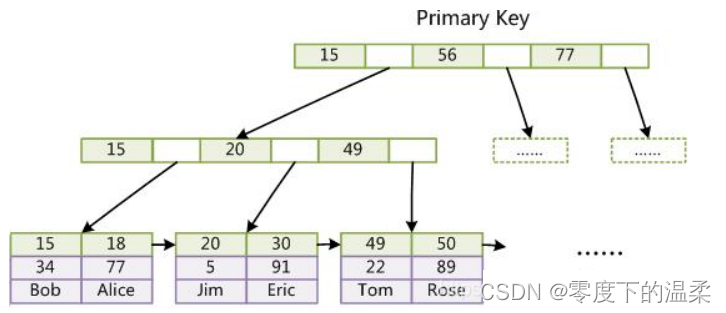
pointer往往是6个字节,指明对应key值的页面位置信息。key一般为索引主键,如果为单字段 bigint 类型,则为8字节。如此可计算一个页大概可以存放16 * 1024/(6+8)=1170行数据。假设一行数据1k,那么2层B+ 树(第一层索引,第二层叶子节点 存数据)就可以存储1170 * 16 = 18 720行;三层则可以存储1170 * 1170 * 16=21902400行。
MyISAM B+Tree结构来存储索引

可见,索引和数据是分开的 索引的data部分只是索引的地址值。其实上文也提到过,.MYI就是MyISAM表的索引文件,MYD是MyISAM表的数据文件。
文章转载来源于终端研发部
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70010293/viewspace-2889142/ ,如需转载,请注明出处,否则将追究法律责任。

