一、SQL解析细节(通用)
Parse:SQL语句解析生成AST
Bind:元数据绑定
Optimize:优化执行策略
Execute:执行
二、Catalyst概念
SQL优化器核心执行策略主要分为两个大的方向: 基于规则优化(RBO)以及基于代价优化(CBO), 基于规则优化是一种经验式、启发式的优化思路,更 多地依靠前辈总结出来的优化规则,简单易行且能够覆盖到大部分优化逻辑,但是对于核心优化算子Join却显得有点力不从心
一个简单的例子,两个表执行Join到底应该使用 BroadcastHashJoin还是 SortMergeJoin?
当前SparkSQL的方式是通过手工设定参数来确定,如果一个表的数据量小于这个值就使用BroadcastHashJoin,但是这种方案显得很不优雅,很不灵活,所以 基于代价优化就是为了解决这类问题,它会针对每个Join评估当前两张表使用每种Join策略的代价,根据代价估算确定一种代价最小的方案【关注尚硅谷,轻松学IT】
而这些优化都是通过 Catalyst去实现
三、Catalyst优化过程
Catalyst的转换框架分以下几个阶段
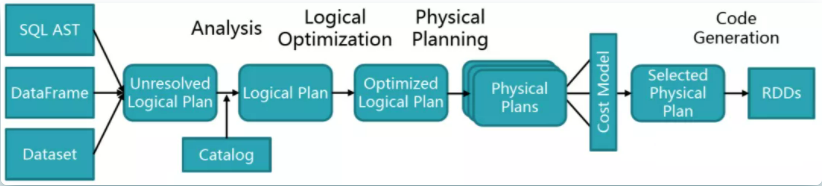

1、先将 AST、DataFrame、DataSet转化为 Unresolved Logical Plan
2、 Unresolved Logical Plan再和Catalog绑定(Catalog是一种元数据服务用来描述表的元数据等等),绑定完以后生成 Logical Plan
3、 Logical Plan进行 逻辑优化生成 Optimized Logical Plan
4、 Optimized Logical Plan做一个物理计划的生成,生成 Physical Plans
5、最后对 Physical Plans做 Cost Model找出代价最小的 Physical Plans
6、然后通过最小代价的 Physical Plans生成最后的代码进行相关的查询计划
Cost Model是基于成本模型,只 有知道物理计划以后才可以做成本模型的选择, 逻辑计划只是一个逻辑概念,并不知道具体的算子是什么,比如left join、right join就是一个逻辑层面的,而物理层面的join有ShuffleHashJoin、BroadcastHashJoin、SortMergeJoin等等,有了物理计划的内容才知道这条计划具体的花费是多少
四、算法
看完基于代价的优化(CBO)以后,想到了一道算法 剑指 Offer 63. GP的最大利润
最后以这个简单的动态规划算法结尾,同样也是最小的代价(挣钱最多、差值最大)相关的简单算法
两个关键点:每次都找出当前的花费成本也就是cost,这是需要我们买入的价格;然后再计算当前价格(price)-之前最小成本(cost)的最大值

文章来源:二九幂加八
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70010293/viewspace-2851862/ ,如需转载,请注明出处,否则将追究法律责任。

