在大数据技术生态当中,分布式集群是解决大规模数据处理任务的主要解决思路,主流的几代框架,如Hadoop 、 Spark 、 Flink 都是基于分布式去进行设计。而分布式系统,关于容错的问题就非常关键了。今天的大数据学习分享,我们就来讲讲 Hadoop 与 Spark 是如何设计容错的?

一般来说,关于容错,最朴素的想法就是通过下面的步骤实现状态与容错:
① 暂停所有数据的接收。
② 每个任务处理当前已经接收的数据。
③ 将此时所有任务的状态进行持久化。
④ 恢复数据的接收和处理。
当作业出现异常时,则可以从之前持久化的地方恢复。Hadoop 与 Spark 的容错机制就是该思想的实现。
Hadoop 的任务可以分为 Map 任务和 Reduce 任务。这是两类分批次执行的任务,后者的输入依赖前者的输出。 Hadoop 的设计思想十分简单 —— 当任务出现异常时,重新跑该任务即可。其实,跑成功的任务的输出,就相当于整个作业的中间结果得到了持久化。比如 Reduce 任务异常重跑时,就不必重跑它依赖的 Map 任务。
Spark 的实现也是这一想法的延续。虽然 Spark 不是 Hadoop 那样的批处理,但是它仍然把一个 “ 微批( micro batch ) ” 当作数据处理的最小单元,整个框架实际上延续了不少批处理的思想。 Spark 的容错机制相当经典,用到了其 RDD 的血统关系( lineage )。熟悉 Spark 的读者应该了解 “ 宽依赖 ” 、 “ 窄依赖 ” 等概念。当 RDD 中的某个分区出现故障,那么只需要按照这种依赖关系重新计算即可。以复杂一些的宽依赖为例, Spark 会找到其父分区,经过计算重新获取结果。
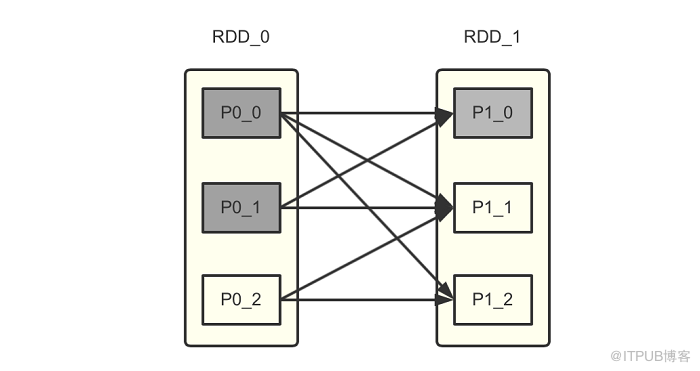
如上图所示,如果P10 发生故障,则 P00 与 P01 都会重新计算,而计算 P00 和 P01 又会继续找其父分区重新计算。按照这个血缘关系来看,一直向上追溯会付出极大的代价。因此 Spark 提供了将分区计算结果持久化的方法。如果 P00 与 P0_1 的数据进行了持久化,那么就可以利用该结果直接恢复状态。
从以上设计可以感受到,这种实现更适合于批计算的框架中。它相当于将前一个阶段的计算结果“ 存档 ” 下来,然后在任意时间后将该结果作为输入,运行下一个阶段的任务。这种实现的状态存储过程显然过于繁重,并不太适用于对 “ 低延时 ” 要求极高的流处理引擎。因此, Flink 设计了一套完全不同的分布式轻量级实现方式,并精巧地实现了各种一致性语义。 Flink 我们在接下来再细讲。
关于大数据学习,Hadoop 与 Spark 如何设计容错,以上就为大家做了大致的介绍了。 Hadoop 和 Spark ,本质上来说,都是基于批处理的思想去处理数据,自然,对于容错也是基于同样的思路。成都加米谷大数据,专业大数据培训机构,大数据开发、数据分析与挖掘,课程大纲及试学视频,可联系客服获取!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70005624/viewspace-2788342/ ,如需转载,请注明出处,否则将追究法律责任。

