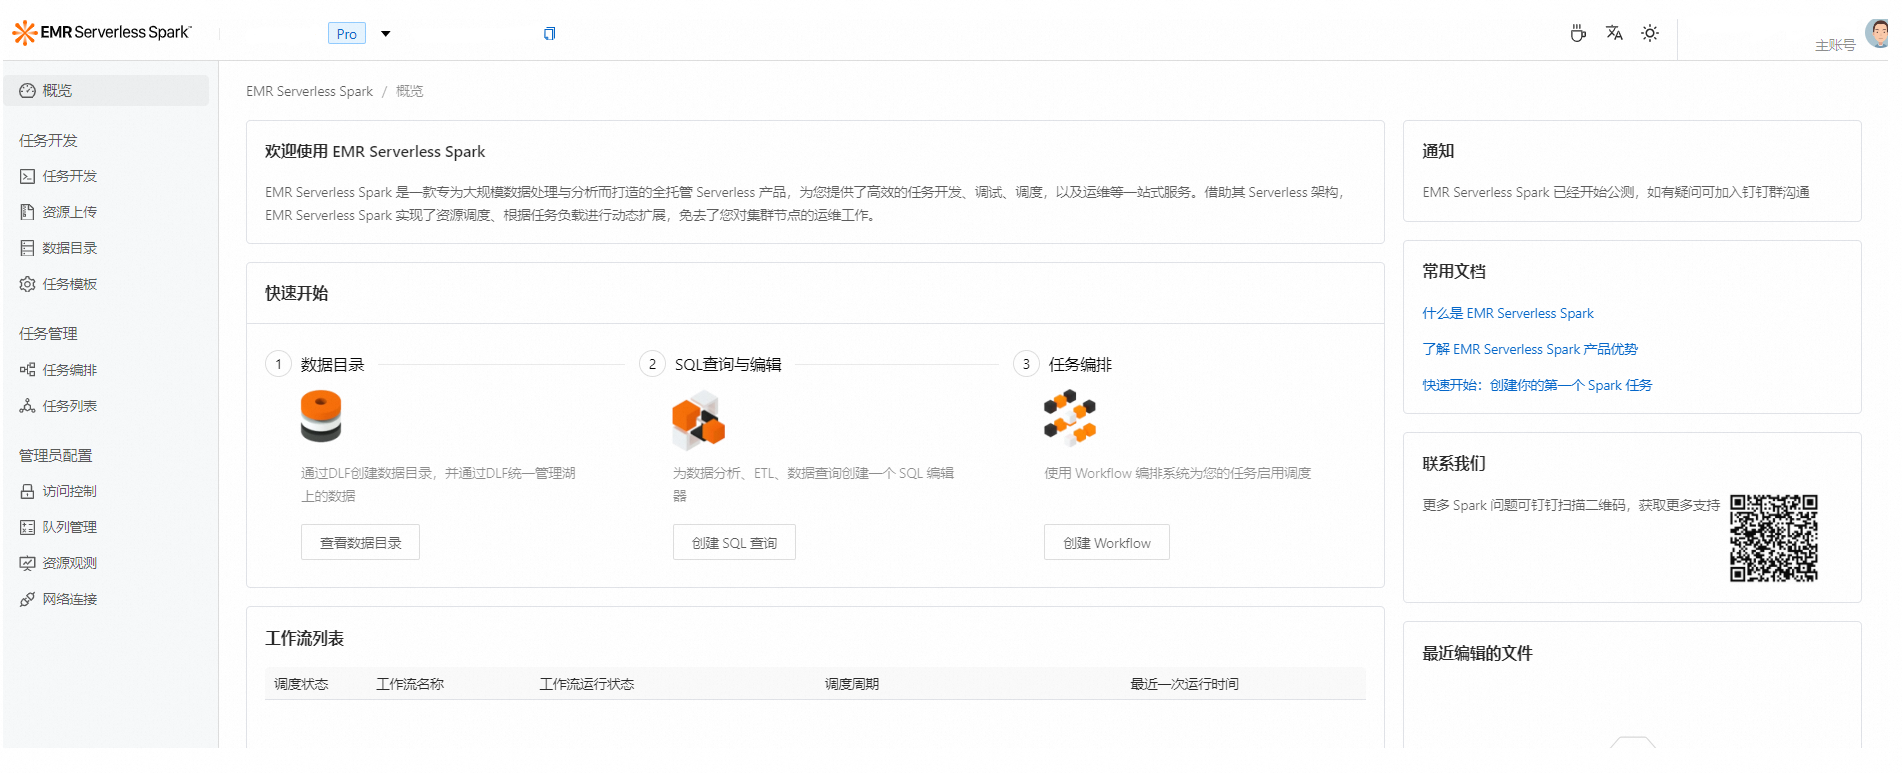
阿里云 EMR Serverless Spark 版免费邀测中
以强大的 Spark Native Engine 为基础,阿里云 EMR Serverless Spark 版旨在提供一个全托管、一站式的数据开发平台。它为用户提供 任务开发、调试、发布、调度和运维等全方位的产品化服务,显著简化了大数据计算的工作流程,使用户能更专注于数据分析和价值提炼,轻松应对海量数据分析和处理的挑战。
产品优势
-
内置 Spark Native Engine,相对开源版本 性能提升200%; -
内置 Celeborn,支持 PB 级 Shuffle 数据,计算资源总成本最高 下降 30% 。
开放化的数据湖架构
-
支持计算存储分离,计算可弹性伸缩、存储可按量付费;
-
对接 OSS-HDFS,完全兼容 HDFS 的云上存储,无缝平滑迁移上云;
-
中心化的 DLF 元数据,全面打通湖仓元数据。
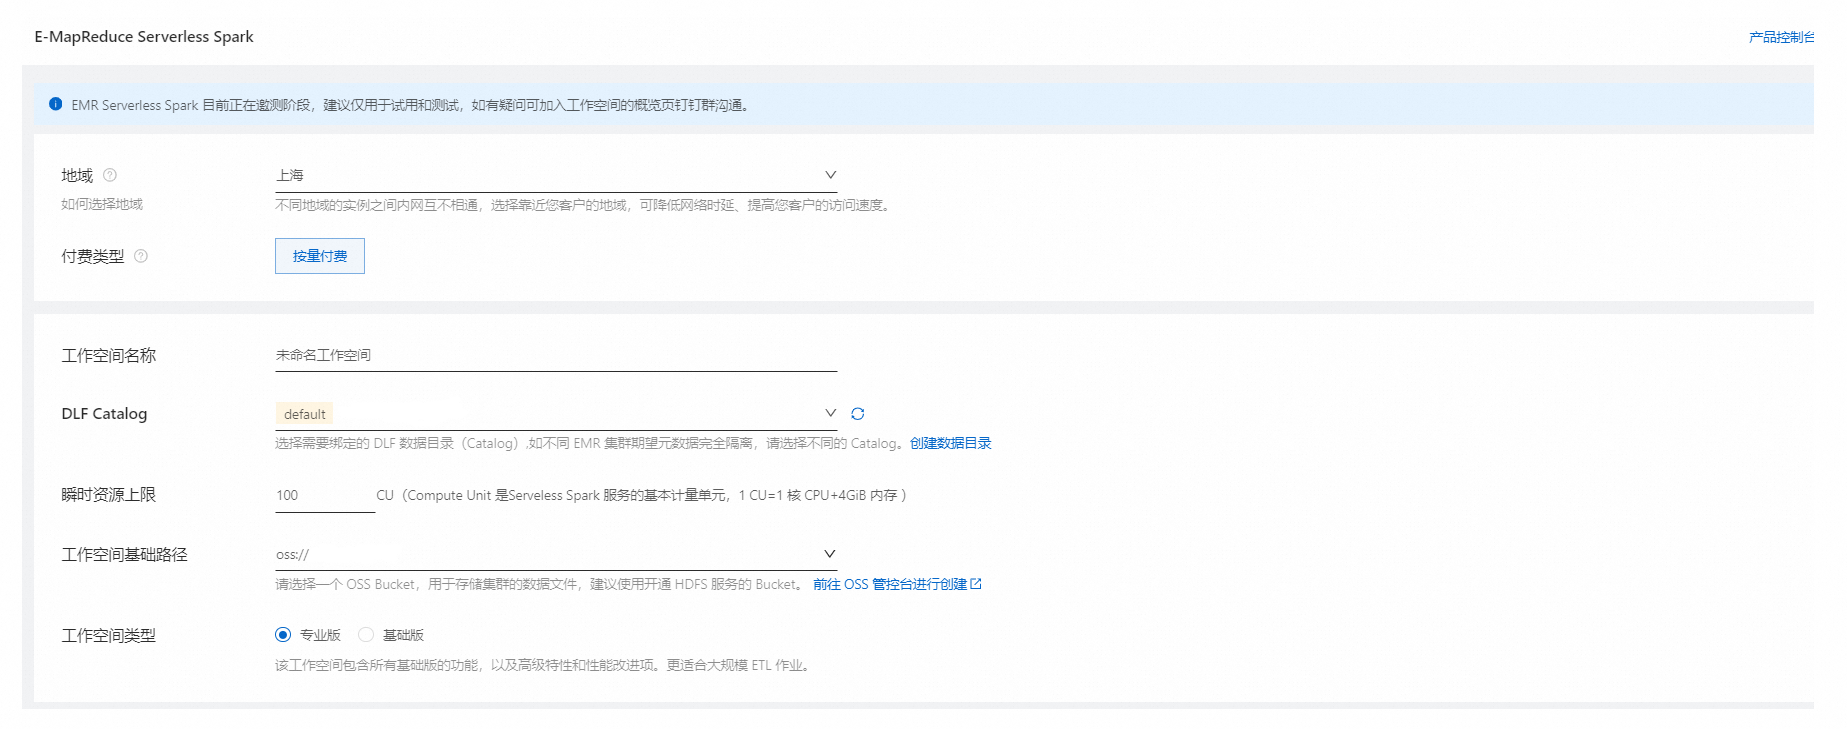
一站式的开发体验:
-
提供作业开发、调试、发布、调度等一站式数据开发体验;
-
内置版本管理、开发与生产隔离,满足企业级开发与发布标准。
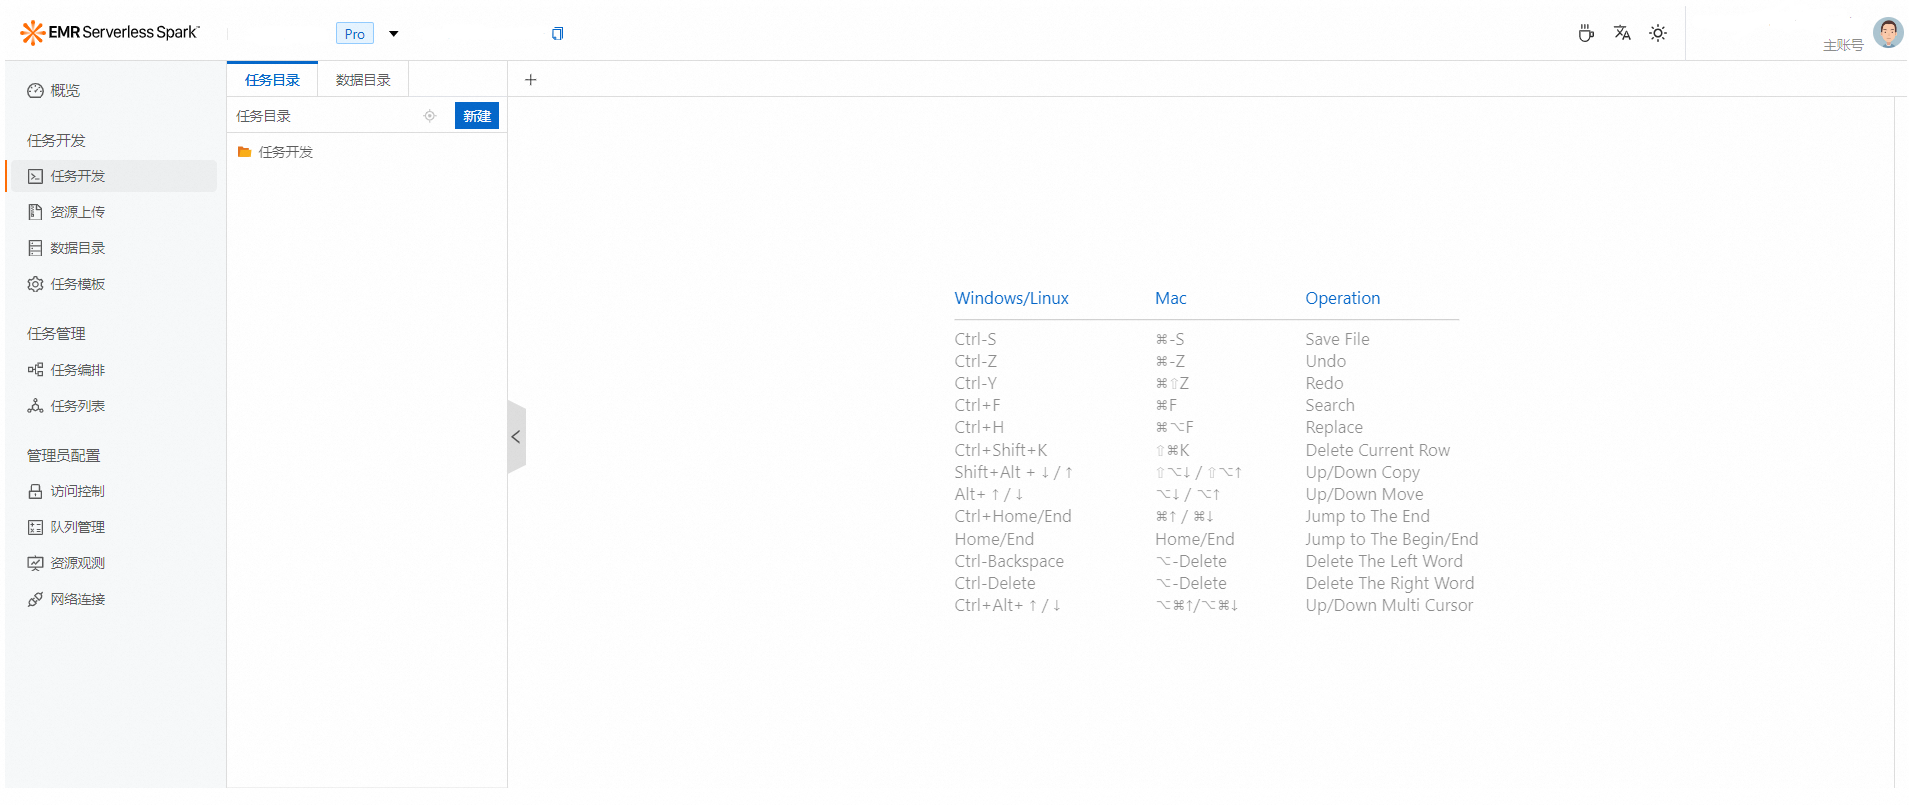
Serverless 的资源平台:
-
开箱即用,无需手动管理和运维云基础设施;
-
弹性伸缩,秒级资源弹性与供给;
-
按量付费,按实际计算资源量付费,进一步降低计算总成本。
应用场景
得益于其开放的产品架构,EMR Serverless Spark 版使得在数据湖中对结构化和非结构化数据进行分析与处理变得简单高效。此外,其还内置了任务调度系统,允许用户轻松构建和管理数据 ETL 任务,实现数据管道的自动化和周期性数据处理。
EMR Serverless Spark 版还内嵌了先进的版本管理系统,并提供了开发与生产环境的完全隔离,确保符合企业级用户在研发和发布流程方面的严格要求。这些特性共同保障了数据处理的可靠性和效率,同时满足企业级应用的高标准要求。

邀测信息
诚挚邀请您参与 EMR Serverless Spark 版免费测试,体验 100% 兼容 Spark 的 Serverless 服务。
您将收获:
如何申请:
扫描下方二维码即可提交申请!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70004426/viewspace-3009666/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
最新文章
- 阿里云 Hologres 登顶 VectorDBBench 性价比榜单四项第一
- 活动火热报名中 | Data+AI 融合趋势下的智能数仓平台建设
- 阿里云技术公开课:基于阿里云 Elasticsearch 构建 AI 搜索和可观测 Chatbot
- 超值选择:阿里云Elasticsearch Serverless在企业数据检索与分析中的高性能与灵活性
- 阿里云技术公开课直播预告:基于阿里云 Elasticsearch 构建 AI 搜索和可观测 Chatbot
- 重磅发布 | OpenSearch 推出向量检索 GPU 图算法方案并支持 GPU 规格售卖
- 有奖实践,基于 EMR StarRocks 实现游戏玩家画像和行为分析
- 加速 AI 应用落地!DataWorks 数据治理中心全新升级为数据资产治理
- 阿里云 Elastic Enterprise 正式上线!
- 阿里重磅开源 Fluss: Flink Unified Streaming Storage
