实时语音交互,打造更加智能便捷的应用
随着人工智能和自然语言处理技术的进步,用户对智能化和便捷化应用的需求不断增加。语音交互技术以其直观的语音指令,革新了传统的手动输入方式,简化了用户操作,让应用变得更加易用和高效。
通过语音交互,用户可以在不方便使用触屏操作例如驾驶、烹饪时通过语音指令进行操作;在需要输入大量文本时,通过语音输入,可以显著提高信息输入的效率;此外,语音交互也为视觉障碍或阅读困难的用户提供了一种便捷的替代交互方式。
HarmonyOS SDK 基础语音服务(Core Speech Kit)集成了语音类基础AI能力,包括 文本转语音(TextToSpeech)及 语音识别(SpeechRecognizer)能力,便于用户与设备进行互动,实现将实时输入的语音与文本之间相互转换。
文本转语音
可高效的将一段不超过10000字符的文本合成为可播报的音频流,将文字转换成流畅自然的人声,广泛适用于有声阅读、新闻播报、站厅播报等多个应用场景。
系统无障碍接入文本转语音能力,在无网状态下,也可以为视障人士提供普通话播报功能,音色为聆小珊女声。

语音识别
可高效实现将实时语音转写成文字,解放双手,适用于语音聊天、语音搜索、语音指令、语音问答等多个应用场景。
将一段音频(时长不超过60s)信息转换为文本。语音识别服务提供将音频信息转换为文本的能力,便于用户与设备进行互动,实现实时语音交互、语音识别。目前本服务支持的语种为中文,支持离线模型。
能力优势
稳定可靠:端侧能力,不依赖网络,稳定可靠。
即开即用:系统原生API,不占用应用空间,开箱即用。
功能丰富:针对不同场景,提供了丰富的扩展和调节参数。
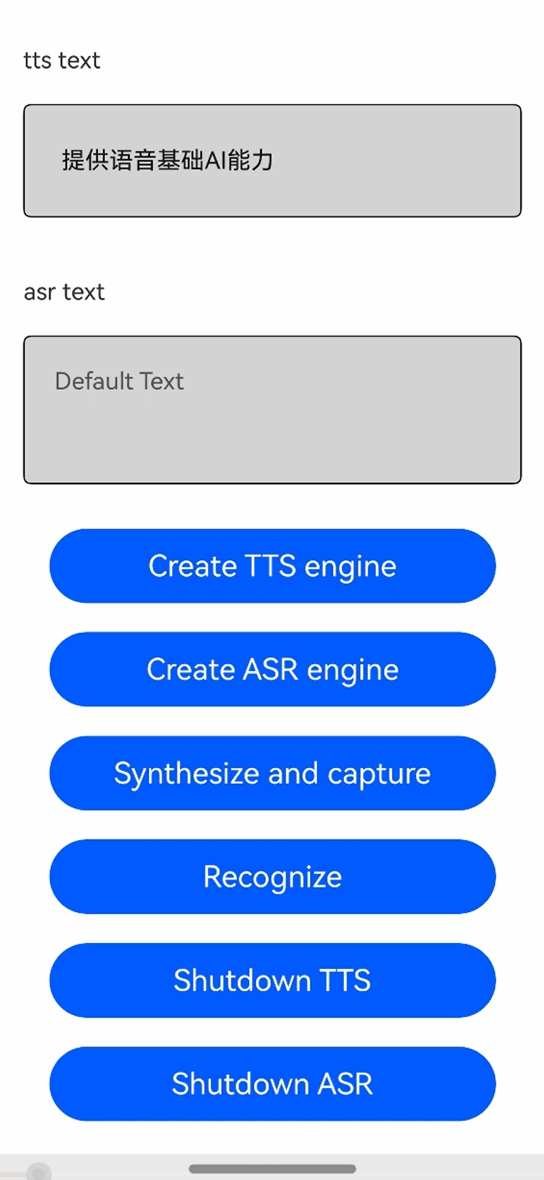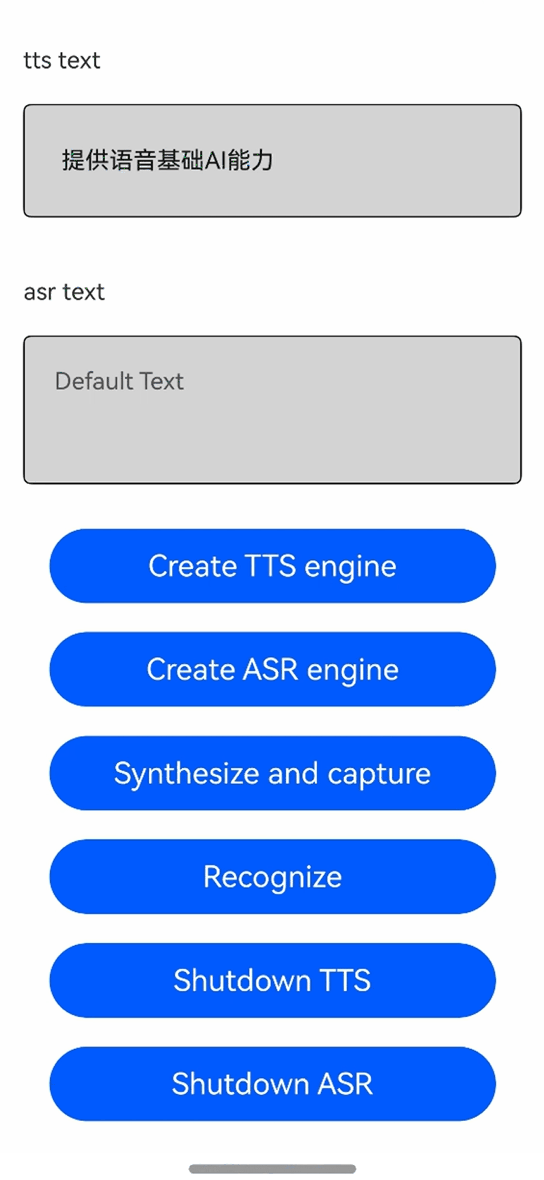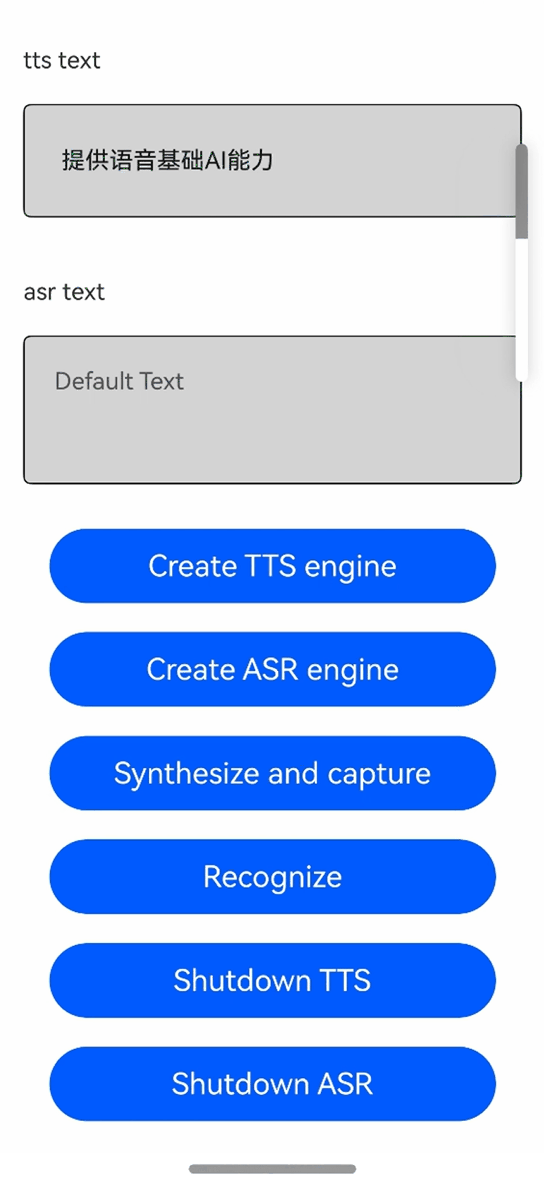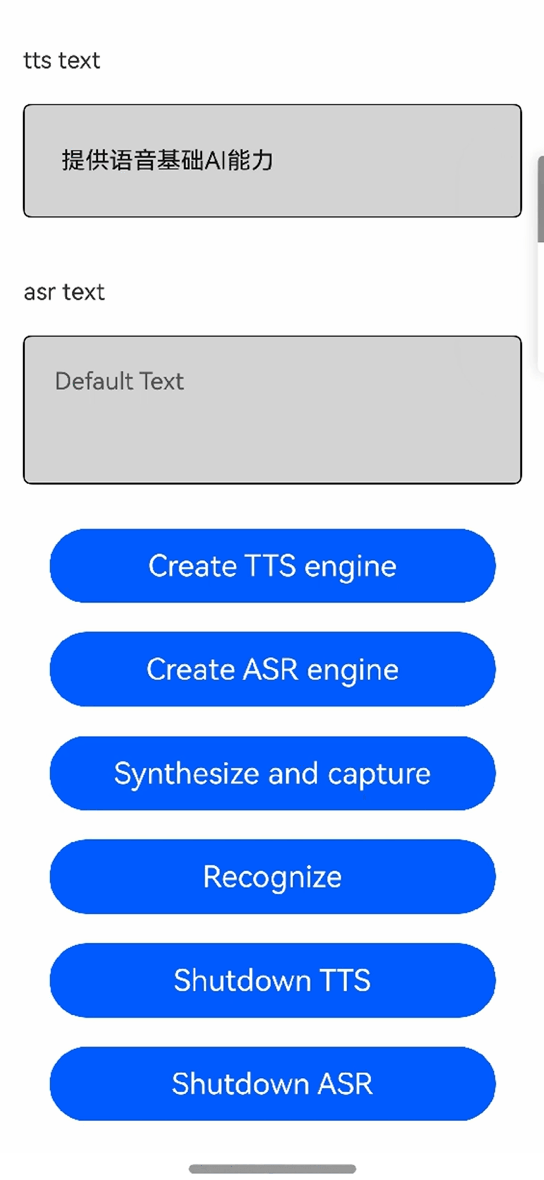
功能演示
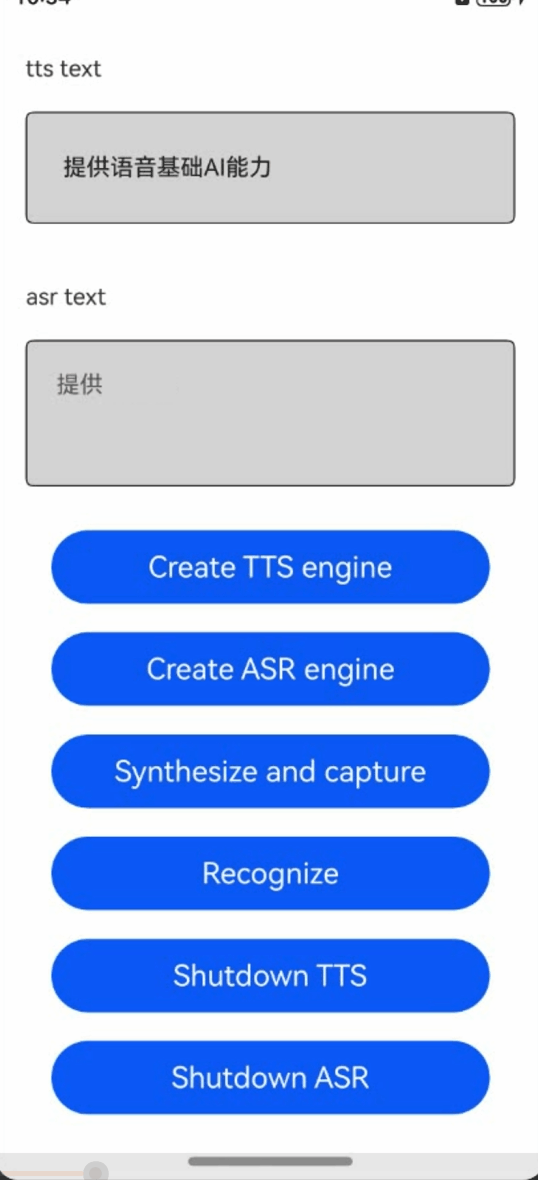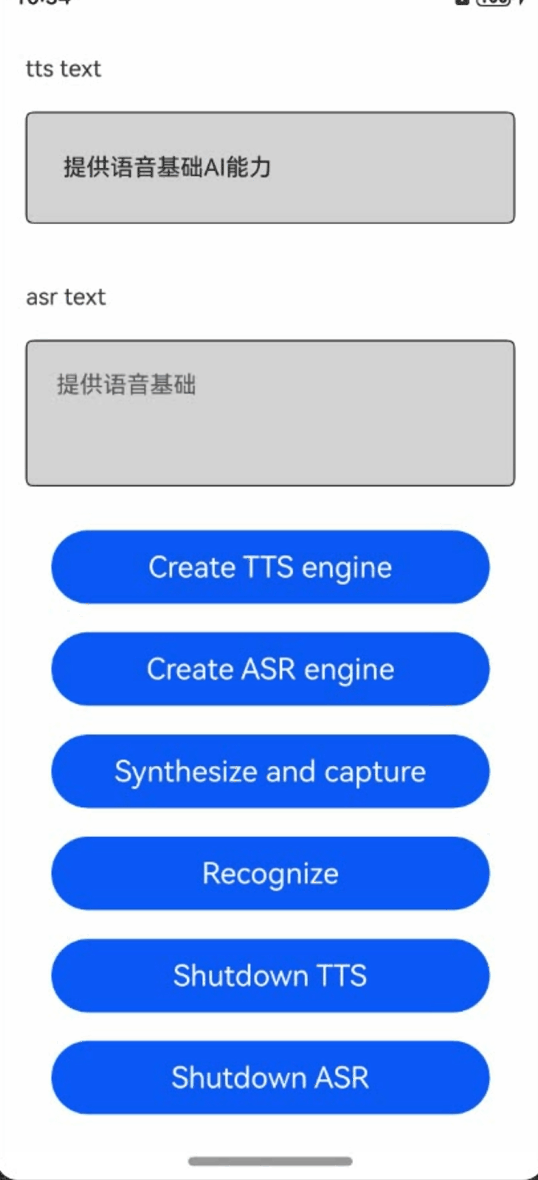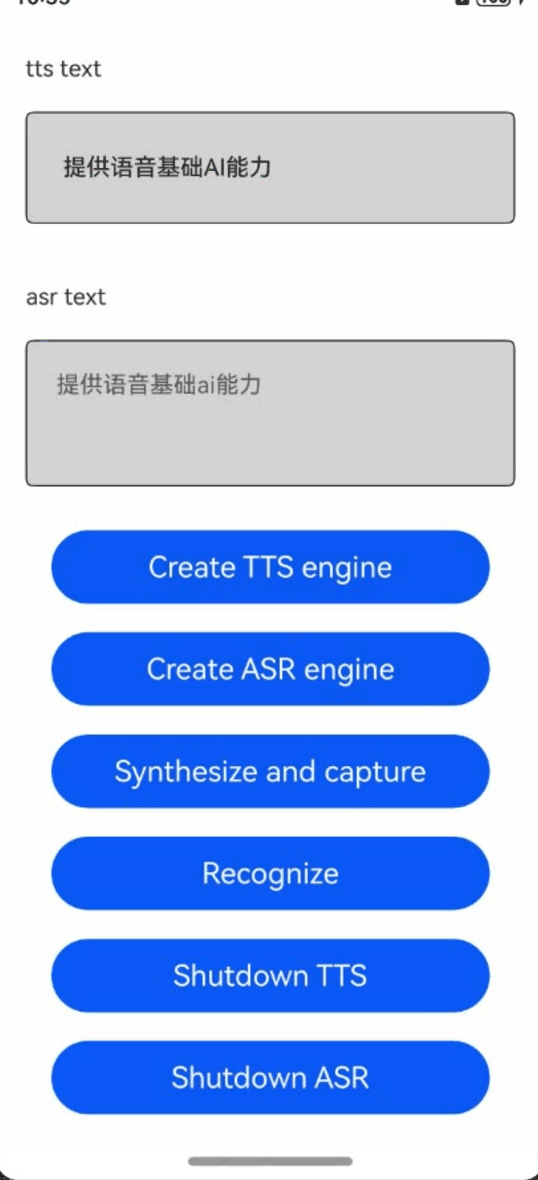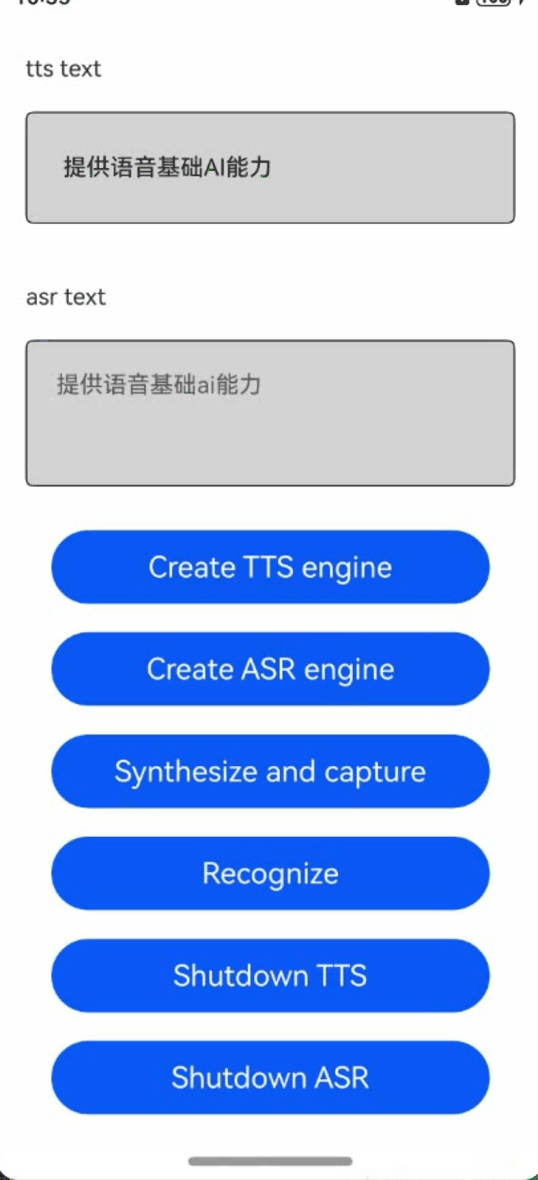
开发步骤
(一) 文本转语音
1.在使用文本转语音时,将实现文本转语音相关的类添加至工程。
import { textToSpeech } from '@kit.CoreSpeechKit';
import { BusinessError } from '@kit.BasicServicesKit';

2.调用 createEngine接口,创建textToSpeechEngine实例。
createEngine接口提供了两种调用形式,当前以其中一种作为示例,其他方式可参考 API参考。
let ttsEngine: textToSpeech.TextToSpeechEngine;
// 设置创建引擎参数
let extraParam: Record<string, Object> = {"style": 'interaction-broadcast', "locate": 'CN', "name": 'EngineName'};
let initParamsInfo: textToSpeech.CreateEngineParams = {
  language: 'zh-CN',
  person: 0,
  online: 1,
  extraParams: extraParam
};
// 调用createEngine方法
textToSpeech.createEngine(initParamsInfo, (err: BusinessError, textToSpeechEngine: textToSpeech.TextToSpeechEngine) => {
  if (!err) {
    console.info('Succeeded in creating engine');
    // 接收创建引擎的实例
    ttsEngine = textToSpeechEngine;
  } else {
    // 创建引擎失败时返回错误码1003400005,可能原因:引擎不存在、资源不存在、创建引擎超时
    console.error(`Failed to create engine. Code: ${err.code}, message: ${err.message}.`);
  }
});
3.得到 TextToSpeechEngine实例对象后,实例化 SpeakParams对象 、SpeakListener对象,并传入待合成及播报的文本originalText,调用 speak接口进行播报。
// 设置speak的回调信息
let speakListener: textToSpeech.SpeakListener = {
  // 开始播报回调
  onStart(requestId: string, response: textToSpeech.StartResponse) {
    console.info(`onStart, requestId: ${requestId} response: ${JSON.stringify(response)}`);
  },
  // 合成完成及播报完成回调
  onComplete(requestId: string, response: textToSpeech.CompleteResponse) {
    console.info(`onComplete, requestId: ${requestId} response: ${JSON.stringify(response)}`);
  },
  // 停止播报回调
  onStop(requestId: string, response: textToSpeech.StopResponse) {
    console.info(`onStop, requestId: ${requestId} response: ${JSON.stringify(response)}`);
  },
  // 返回音频流
  onData(requestId: string, audio: ArrayBuffer, response: textToSpeech.SynthesisResponse) {
    console.info(`onData, requestId: ${requestId} sequence: ${JSON.stringify(response)} audio: ${JSON.stringify(audio)}`);
  },
  // 错误回调
  onError(requestId: string, errorCode: number, errorMessage: string) {
    console.error(`onError, requestId: ${requestId} errorCode: ${errorCode} errorMessage: ${errorMessage}`);
  }
};
// 设置回调
ttsEngine.setListener(speakListener);
let originalText: string = '你好,华为';
// 设置播报相关参数
let extraParam: Record<string, Object> = {"queueMode": 0, "speed": 1, "volume": 2, "pitch": 1, "languageContext": 'zh-CN',
"audioType": "pcm", "soundChannel": 3, "playType": 1 };
let speakParams: textToSpeech.SpeakParams = {
  requestId: '123456', // requestId在同一实例内仅能用一次,请勿重复设置
  extraParams: extraParam
};
// 调用播报方法
ttsEngine.speak(originalText, speakParams);
(二) 语音识别
1.在使用语音识别时,将实现语音识别相关的类添加至工程。
import { speechRecognizer } from '@kit.CoreSpeechKit';
import { BusinessError } from '@kit.BasicServicesKit';
2.调用 createEngine方法,对引擎进行初始化,并创建 SpeechRecognitionEngine实例。
createEngine方法提供了两种调用形式,当前以其中一种作为示例,其他方式可参考 API参考。
let asrEngine: speechRecognizer.SpeechRecognitionEngine;
let requestId: string = '123456';
// 创建引擎,通过callback形式返回
// 设置创建引擎参数
let extraParam: Record<string, Object> = {"locate": "CN", "recognizerMode": "short"};
let initParamsInfo: speechRecognizer.CreateEngineParams = {
  language: 'zh-CN',
  online: 1,
  extraParams: extraParam
};
// 调用createEngine方法
speechRecognizer.createEngine(initParamsInfo, (err: BusinessError, speechRecognitionEngine: speechRecognizer.SpeechRecognitionEngine) => {
  if (!err) {
    console.info('Succeeded in creating engine.');
    // 接收创建引擎的实例
    asrEngine = speechRecognitionEngine;
  } else {
    // 无法创建引擎时返回错误码1002200008,原因:引擎正在销毁中
    console.error(`Failed to create engine. Code: ${err.code}, message: ${err.message}.`);
  }
});
3.得到 SpeechRecognitionEngine实例对象后,实例化 RecognitionListener对象,调用 setListener方法设置回调,用来接收语音识别相关的回调信息。
// 创建回调对象
let setListener: speechRecognizer.RecognitionListener = {
  // 开始识别成功回调
  onStart(sessionId: string, eventMessage: string) {
    console.info(`onStart, sessionId: ${sessionId} eventMessage: ${eventMessage}`);
  },
  // 事件回调
  onEvent(sessionId: string, eventCode: number, eventMessage: string) {
    console.info(`onEvent, sessionId: ${sessionId} eventCode: ${eventCode} eventMessage: ${eventMessage}`);
  },
  // 识别结果回调,包括中间结果和最终结果
  onResult(sessionId: string, result: speechRecognizer.SpeechRecognitionResult) {
    console.info(`onResult, sessionId: ${sessionId} sessionId: ${JSON.stringify(result)}`);
  },
  // 识别完成回调
  onComplete(sessionId: string, eventMessage: string) {
    console.info(`onComplete, sessionId: ${sessionId} eventMessage: ${eventMessage}`);
  },
  // 错误回调,错误码通过本方法返回
  // 如:返回错误码1002200006,识别引擎正忙,引擎正在识别中
  // 更多错误码请参考错误码参考
  onError(sessionId: string, errorCode: number, errorMessage: string) {
    console.error(`onError, sessionId: ${sessionId} errorCode: ${errorCode} errorMessage: ${errorMessage}`);
  }
}
// 设置回调
asrEngine.setListener(setListener);
4.设置开始识别的相关参数,调用 startListening方法,开始合成。
let audioParam: speechRecognizer.AudioInfo = {audioType: 'pcm', sampleRate: 16000, soundChannel: 1, sampleBit: 16};
let extraParam: Record<string, Object> = {"vadBegin": 2000, "vadEnd": 3000, "maxAudioDuration": 40000};
let recognizerParams: speechRecognizer.StartParams = {
  sessionId: requestId,
  audioInfo: audioParam,
  extraParams: extraParam
};
// 调用开始识别方法
asrEngine.startListening(recognizerParams);
5.传入音频流,调用 writeAudio方法,开始写入音频流。读取音频文件时,开发者需预先准备一个pcm格式音频文件。
let uint8Array: Uint8Array = new Uint8Array();
// 可以通过如下方式获取音频流:1、通过录音获取音频流;2、从音频文件中读取音频流
// 写入音频流,音频流长度仅支持640或1280
asrEngine.writeAudio(requestId, uint8Array);
了解更多详情>>
访问 基础语音服务联盟官网
获取 语音识别服务开发指导文档
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70003787/viewspace-3034981/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 【HarmonyOS API 26 】数字盾服务2.0:硬件级安全的随身虚拟U盾
- HarmonyOS智慧多窗,让应用在任意窗口都“恰到好处”
- AI 赋能 Push Kit 场景化消息开发,高效完成鸿蒙应用推送能力接入
- HarmonyOS Push Kit 自分类权益 Skill,助力提升权益申请通过率
- 基于增强QUIC协议优化弱网下的直播观看体验
- 焕新鸿蒙应用权限管理方案,应用授权体验再升级
- Account Kit 效率提升 ▏自动签名能力上线
- 从启动到畅玩:HarmonyOS SDK如何重塑一场连续的游戏体验
- 从“一屏一态”到“一屏多能”:WPS通过HarmonyOS多窗口能力重塑移动办公体验
- HarmonyOS SDK API诊断 Skill,一键定位功能故障问题
