一、事务概览
提起事务,我们第一印象可能就是ACID,需要满足原子性、一致性、事务隔离级别等概念,那kafka的事务能做到什么程度呢?我们首先看一下如何使用事务
Producer端代码如下
KafkaProducer<String, String> producer = new KafkaProducer<>(props);
producer.initTransactions();
producer.beginTransaction();

ProducerRecord<String, String> kafkaMsg1 = new ProducerRecord<>(TOPIC1, "msg val");
producer.send(kafkaMsg1);
ProducerRecord<String, String> kafkaMsg2 = new ProducerRecord<>(TOPIC2, "msg val");
producer.send(kafkaMsg2);

producer.commitTransaction();Consumer端不需要做特殊处理,跟消费普通消息一样
while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
    for (ConsumerRecord<String, String> record : records) {
        System.out.println(String.format("Consume partition:%d offset:%d", record.partition(), record.offset()));
    }
}
1.1、事务配置
那需要如何配置呢?
Producer | Consumer | ||
| 事务ID,类型为String字符串,默认为空,客户端自定义,例如"order_bus" |
| 事务隔离级别,默认为空,开启事务的话,需要将其设置为"read_committed" |
| 消息幂等开关,true/false,默认为false,当配置了transactional.id,此项一定要设置为true,否则会抛出客户端配置异常 | ||
| 事务超时时间,默认为10秒,最长为15分钟 | ||
当enable.idempotence设置为true时,kafka会检查如下一些级联配置
配置项 | 内容要求 | 说明 |
| 要求此配置项必须设置为all | 响应必须要设置为all,也就是leader存储消息,并且所有follower也存储了消息后再返回,保证消息的可靠性 |
| > 0 | 因为幂等特性保证了数据不会重复,在需要强可靠性的前提下,需要用户设置的重试次数 > 0 |
| <= 5 | 此项配置是表明在producer还未收到broker应答的最大消息批次数量。该值设置的越大,标识可允许的吞吐越高,同时也越容易造成消息乱序 |
相关配置约束: org.apache.kafka.clients.producer.ProducerConfig#postProcessAndValidateIdempotenceConfigs()
1.2、事务描述
由此,可以出一张事务的概览图
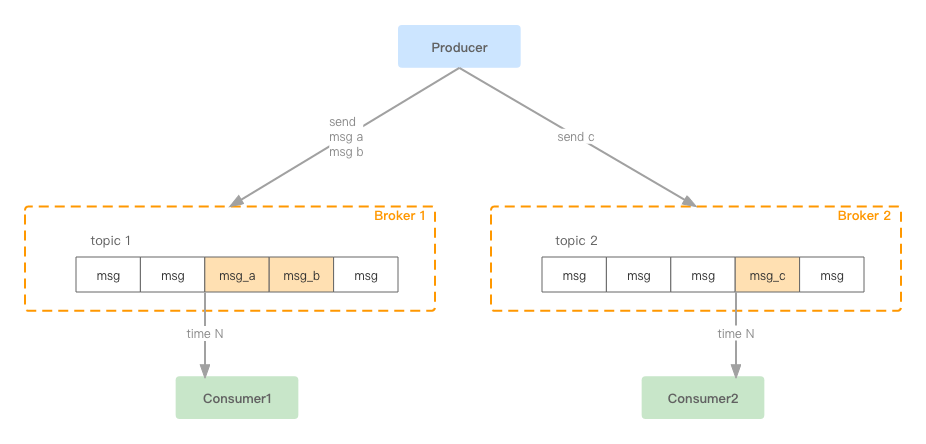
一个简单的事务可能就是这样:
- Producer开启一个事务
- 首先向Topic1发送两条消息 msg_a、msg_b
- 然后向Topic2发送一条消息msg_c
- 提交事务
假设有2个消费端此时正在消费这两个topic对应的分区,在事务提交前,所有的事务消息对两个consumer均不可见,事务一旦提交,在同一时刻,consumer1可以看到a、b消息,consumer2可看到c消息(这里首先作个申明,显而易见,kafka实现的是分布式事务,既然是分布式事务就脱离不了CAP定理,而kafka的事务也只是做到了最终一致性,后文还会详细展开)
那么整个事务是如何实现的呢?
二、事务流程

如上图所示,整个事务流程分一下几个步骤:
- 事务初始化
initTransactions - 启动事务
beginTransaction - 发送消息,一般发送多条,向1个或多个topic
producer.send - 事务提交
commitTransaction - 事务回滚
abortTransaction - 消费事务消息
当Producer发送N多条事务的话
- 事务初始化是一次性的
- 而事务启动、发送消息、事务提交/回滚则会一直循环运行
而这里面很多步骤都是需要多个角色参与的,例如“事务初始化”,就需要Producer及Broker协同实现
三、事务初始化
事务初始化由Producer端触发,代码为
KafkaProducer<String, String> producer = new KafkaProducer<>(props);
producer.initTransactions();
事务初始化经历了两个阶段:
- 定位TransactionCoordinator
- 初始化ProducerId
两者是递进关系,步骤2是严格依赖步骤1的,下面的流程图标注了它们的调用关系
3.1、定位TransactionCoordinator
参与方:Producer、Broker
什么是TransactionCoordinator?
TransactionCoordinator与GroupCoordinator类似,其本质也是一个后端的broker,只是这个broker起到了针对当前事物的协调作用,所有事务操作都需要直接发送给这个指定的broker
刚开始的时候,Producer并不知道哪个broker是TransactionCoordinator,那么目标broker是如何选择出来的呢?

Producer虽然不知道Coordinato的地址,但是他有所有broker的链接串,因此初始化时,整体步骤如下:
- 向任意一个节点发送获取Coordinato的请求,参数中携带客户端自定义的TransactionId;对应ApiKey为 ApiKeys.FIND_COORDINATOR
- Broker收到请求后,取TransactionId的hashCode,然后将其对50取模,(注:50为kafka内部topic
__transaction_state的默认分区数,该topic是kafka实现事务的关键,后文还会多次提及)获取对应的Partition,该Partition从属的Broker,即为TransactionCoordinator
获取Partition代码如下: kafka.coordinator.transaction.TransactionStateManager#partitionFor()
def partitionFor(transactionalId: String): Int = Utils.abs(transactionalId.hashCode) % transactionTopicPartitionCount3.2、初始化ProducerId
参与方:Producer、Coordinator
获取TransactionCoordinator后,便需要向其发送请求获取ProducerId及Epoch,对应的API为ApiKeys.INIT_PRODUCER_ID。可以认为ProducerId+Epoch是对事物型Producer的唯一标识,后续向broker发起的请求,也都需要携带这两个关键参数。这两个参数含义如下
参数 | 类型 | 含义 |
ProducerId | Long | 从0开始,对应Producer端配置的TransactionId,他们存在映射关系,可以通过TransactionId来查询ProducerId;映射关系存储在kafka内部topic |
Epoch | Short | 从0开始,Producer每次重启,此项值都会+1;当超过short最大值后,ProducerId+1 |
比如当前的ProducerId为2000,Epoch为10,Producer重启后,ProducerId为2000不变,Epoch变为11;如果此时Broker端再次收到epoch为10的数据,那么将会认为是过期数据不予处理
由此可见ProducerId与Epoch是持久化在Broker端的,主要目的就是为了应对Coordinator宕机;接下来就要引出非常重要的一个kafka内部compact topic:__transaction_state
__transaction_state 是一个compact topic,即最新key对应的value内容会将旧值覆盖,可以简单将其看做一个KV存储
Key | Value | ||
TransactionId | producerId | 8 | 从0开始,依次递增 |
epoch | 2 | 从0开始,依次递增 | |
transactionTimeoutMs | 4 | 事务超时时间,默认10秒,最大15分钟 | |
transactionStatus | 1 | 事务状态( 0-Empty 事务刚开始时init是这个状态 1-Ongoing 2-PrepareCommit 3-PrepareAbort 4-CompleteCommit 5-CompleteAbort 6-Dead 7-PrepareEpochFence ) | |
topicTotalNum | 4 | 当前事务关联的所有topic总和 | |
topicNameLen | 2 | topic长度 | |
topicName | X | topic内容 | |
partitionNum | 4 | partition的个数 | |
partitionIds | X | 例如有n个partition,X = n * 4,每个partition占用4 byte | |
transactionLastUpdateTimestampMs | 8 | 最近一次事务操作的更新时间戳 | |
transactionStartTimestampMs | 8 | 事务启动的时间戳 | |
这个Topic的可以让broker随时查看事务的当前状态,以及是否超时
相关代码 scala/kafka/coordinator/transaction/TransactionLog.scala#valueToBytes()
此步骤会让Broker向__transaction_state中写入一条数据(由于当前Coordinator是通过分区数取模得到的,因此向topic写入数据是直接写入本地盘的,没有网络开销),事务状态为Empty,同时向Producer返回ProducerId+Epoch。当前步骤在Broker端还有很多事务状态异常的判断,此处不再展开
四、事务启动-Transaction Begin
参与方:Producer
代码示例
producer.beginTransaction();注:此步骤Producer不会向Broker发送请求,只是将本地的事务状态修改为 State.IN_TRANSACTION
Broker也并没有独立的步骤来处理事务启动,Broker在收到第一条消息时,才认为事物启动;那么Kafka为何要设计这样一个看起来很鸡肋的功能呢?直接发送消息不行么
一个正常的事务流程是这样的:
- a、初始化
- b、事务开始
- c、发送消息
- d、事务提交
因为事务消息可能是发送多次的,每次通过producer.beginTransaction()开启事务,可以使得代码更清晰,也更容易理解;因此多次发送的顺序会是这样
- a、b、c、d
- b、c、d
- b、c、d
- b、c、d
- ......
五、事务消息发送-Transaction Send Msg
参与方:Producer、Broker
事务消息的发送是非常非常重要的环节,不论是Producer端还是Broker端,针对事务都做了大量的工作,不过在阐述核心功能前,还是需要对一些基础知识进行铺垫
5.1、消息协议
与RocketMQ不同,kafka消息协议的组装是在Producer端完成的,kafka消息协议经历了3个版本(v0、v1、v2)的迭代,我们看一下现存3个版本的协议对比

- V0 版本相当整洁,不写注释都能明白每个字段的含义,而且除了key、value外,其他字段均为定长编码。这里简单阐述下attribute字段,该字段的前3个bit用来标志消息压缩类型,剩下5个bit为保留字段
- V1 版本只是添加了时间戳字段,并启用了attribute字段的第4个bit,用来标志timestamp字段是消息born的时间,还是存储的时间
然而V2版本做了相当大的改动,甚至可以说是“面目全非”

V2版本引入了Record Batch的概念,同时也引入了可变长存储类型(本文不再展开),同一个Producer的消息会按照一定的策略归并入同一个Record Batch中;如果两个Producer,一个开启事务,一个关闭事务,分别向同一个Topic的同一个Partititon发送消息,那么存在在Broker端的消息会长什么样呢?

可见,同一个Record Batch中的Producer id、epoch、消息类型等都是一样的,所以不存在同一个Batch中,既有事务消息,又有非事务消息;换言之,某个Batch,要么是事务类型的,要么是非事务类型的,这点相当重要,在Consumer端消费消息时,还要依赖这个特性。因此在Producer端,即便是同一个进程内的2个producer实例,向同一个Topic的同一个Partition,一个发送事务消息,一个发送普通消息,两者间隔发送,这时会发现Record Batch的数量与消息的数量相同,即一个Record Batch中只会存放一条消息
5.2、消息幂等
众所周知,kafka是有消息超时重试机制的,既然存在重试,那么就有可能存在消息重复

- Producer发送Record Batch A
- Broker收到消息后存储并持久化下来,但是发送给Producer的response网络超时
- Producer发现发送消息超时,便重新发送该消息
- Broker并不知道收到的消息是重复消息,故再次将其存储下来,因此产生了重复数据
注:上述整个过程,Client的业务方并不知晓,重试逻辑由Producer内部控制,给业务方的感观便是消息发送了一份,却收到了两份数据
kafka要实现事务语义的话,消息重复肯定是接受不了的,因此保证消息幂等也就成了事务的前置条件。如何实现幂等呢,比较直观的思路便是给消息编号,这样Broker就可以判重了,事实上kafka也是这样做的;在Producer启动时,会进行初始化动作,此时会拿到(ProduceId+Epoch),然后在每条消息上添加Sequence字段(从0开始),之后的请求都会携带Sequence属性
- 如果存在重复的RecordBatch(通过produceId+epoch+sequence),那么Broker会直接返回重复记录,client收到后丢弃重复数据
scala/kafka/log/ProducerStateManager.scala#findDuplicateBatch()
- 如果Broker收到的RecordBatch与预期不匹配,例如比预期Sequence小或者大,都会抛出
OutOfOrderSequenceException异常
- 比预期Sequence小:这种请求就是典型的重复发送,直接拒绝掉并扔出异常
- 比预期Sequence大:因为设置了幂等参数后,
max.in.flight.requests.per.connection参数的设定最大值即为5,即Producer可能同时发送了5个未ack的请求,Sequence较大的请求先来到了,依旧扔出上述异常
处理重复数据的关键代码如下 kafka.log.ProducerStateEntry#findDuplicateBatch()
  def findDuplicateBatch(batch: RecordBatch): Option[BatchMetadata] = {
    if (batch.producerEpoch != producerEpoch)
       None
    else
      batchWithSequenceRange(batch.baseSequence, batch.lastSequence)
  }

  // Return the batch metadata of the cached batch having the exact sequence range, if any.
  def batchWithSequenceRange(firstSeq: Int, lastSeq: Int): Option[BatchMetadata] = {
    val duplicate = batchMetadata.filter { metadata =>
      firstSeq == metadata.firstSeq && lastSeq == metadata.lastSeq
    }
    duplicate.headOption
  }
处理Sequence过大或过小代码如下 kafka.log.ProducerAppendInfo#checkSequence()
  private def checkSequence(producerEpoch: Short, appendFirstSeq: Int, offset: Long): Unit = {
    if (producerEpoch != updatedEntry.producerEpoch) {
      ......
    } else {
      ......
      // If there is no current producer epoch (possibly because all producer records have been deleted due to
      // retention or the DeleteRecords API) accept writes with any sequence number
      if (!(currentEntry.producerEpoch == RecordBatch.NO_PRODUCER_EPOCH || inSequence(currentLastSeq, appendFirstSeq))) {
        throw new OutOfOrderSequenceException(s"Out of order sequence number for producer $producerId at " +
          s"offset $offset in partition $topicPartition: $appendFirstSeq (incoming seq. number), " +
          s"$currentLastSeq (current end sequence number)")
      }
    }
  }

  private def inSequence(lastSeq: Int, nextSeq: Int): Boolean = {
    nextSeq == lastSeq + 1L || (nextSeq ==  && lastSeq == Int.MaxValue)
  }
然而单纯依靠消息幂等,真正能够实现消息不重复、消息全局幂等吗?答案是否定的,假定这样的一个前置条件: “Produer发送了一条幂等消息,在收到ACK前重启了”
- 新启动的Produer实例会拥有新的Producer id,Broker并不能区分前后两个Producer是同一个,因此此条消息重发的话,就会产生消息重复
- 新启动的Produer可能直接将此条消息发送给了其他Partition,Broker会将数据存储在另外的这个Partition,这样从全局来看,这条消息重复了
因此消息幂等能只够保证在单会话(session)、单partition的场景下能保证消息幂等
5.3、消息发送-Producer
参与方:Producer、Broker
Producer端在发送消息阶段,Producer与Broker的交互分两部分:
- 向当前事物的Coordinator发送添加Partiton的请求
- 对应的API为ApiKeys.ADD_PARTITIONS_TO_TXN
- 这个请求同步发送结束后,才会真正发送消息
- 向对应的分区发送消息
- 对应的API为ApiKeys.PRODUCE

也是事务消息比较影响性能的一个点,在每次真正发送Record Batch消息之前,都会向Coordinator同步发送Partition,之后才会真正发送消息。而这样做的好处也显而易见,当Producer挂掉后,Broker是存储了当前事物全量Partition列表的,这样不论是事务提交还是回滚,亦或是事务超时取消,Coordinator都拥有绝对的主动权
贴少量关键源码(本人不太喜欢大篇幅粘贴源码,这样会破会行文的连贯性,相信读者也不会通过此文去翻看源码。不过在不影响阅读的前提下,本文还是会黏贴一些关键代码)
这里是消息确定了最终Partition后,向transactionManager注册
org/apache/kafka/clients/producer/KafkaProducer.java#doSend()
// Add the partition to the transaction (if in progress) after it has been successfully
// appended to the accumulator. We cannot do it before because the partition may be
// unknown or the initially selected partition may be changed when the batch is closed
// (as indicated by `abortForNewBatch`). Note that the `Sender` will refuse to dequeue
// batches from the accumulator until they have been added to the transaction.
if (transactionManager != null) {
    transactionManager.maybeAddPartition(appendCallbacks.topicPartition());
}
Sender线程构建add partition请求
org/apache/kafka/clients/producer/internals/Sender.java#maybeSendAndPollTransactionalRequest()
TransactionManager.TxnRequestHandler nextRequestHandler = transactionManager.nextRequest(accumulator.hasIncomplete());
if (nextRequestHandler == null)
    return false;
5.4、消息发送-Coordinator
在消息发送阶段,Coordinator的参与主要是记录当前事务消息所在的Parition信息,即更新topic __transaction_state 的状态,正如前文所述,__transaction_state 为compact类型,以下属性将会被更新
topicTotalNum | 4 | 当前事务关联的所有topic总和 |
topicNameLen | 2 | topic长度 |
topicName | X | topic内容 |
partitionNum | 4 | partition的个数 |
partitionIds | X | 例如有n个partition,X = n * 4,每个partition占用4 byte |
transactionLastUpdateTimestampMs | 8 | 最近一次事务操作的更新时间戳 |
题外话:如果Coordinator记录了某个Partition参与了事务,但却没有向该Partition发送事务消息,这样会有影响吗?
- 其实不会有影响的,在后文事务提交/取消模块会做详细说明,因为在topic
__transaction_state中虽然记录了某个Partition参与了事务,但在事务提交阶段,只会向该Partition发送marker类型的控制消息,Consumer在收到controller类型的消息后会自动过滤,另外也不会影响当前Partition的LSO向前推进
5.5、消息发送-Broker
消息发送时,Broker做的很重要的一个工作是维护 LSO(log stable offset),一个Partition中可能存了多个事务消息,也有可能存储了很多非事务的普通消息,而LSO为第一个正在进行中(已经commit/abort的事务不算)的事务消息的offset
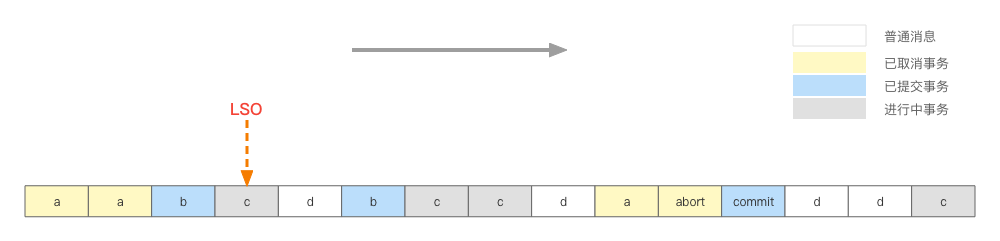
如上图:
- a: 已经无效的事务
- b: 已经提交的事务
- c: 正在进行中的事务(不确定最终是取消还是提交)
- d: 普通消息,非事务消息
因此LSO的位置就在第一个正在进行中的事务的首消息的offset。消息不断写入,Broker需要实时维护LSO的位置,而在LSO以下的位置的消息是不可以被标记为READ_COMMITED的consumer消费的。
这里稍微引申一下Consumer端的逻辑,LSO标记之前的消息都可以被consumer看到,那么如上图,LSO之前有3条消息,2个a(事务取消),1个b(事务提交),consumer读到这3条消息后怎么处理呢?无非就是以下两种处理逻辑:
- 暂存在consumer端,直至读取到事务最终状态,再来判断是吐给业务端(事务成功),还是消息扔掉(事务取消)
- 这样设计是没有问题的,可以保证消息的准确性,但是如果某个事物提交的数据量巨大(事务最长超时时间可达15分钟),这样势必造成consumer端内存吃紧,甚至OOM
- 实时判断当前消息是该成功消费还是被扔掉
- 能够实时判断肯定是非常理想的结果,可是如何实时判断呢?难道每次消费时都要再向broker发送请求获取消息的状态吗?
具体采用哪种策略,我们在消息消费的章节再来展开
六、事务提交-Transaction Commit
参与方:Producer、Broker
6.1、事务提交-Producer
事务提交时Producer端触发的,代码如下
producer.commitTransaction();事务提交对应的API为ApiKeys.END_TXN,Producer向Broker请求的入参为
transactionalId事务id,即客户自定义的字符串producerIdproducer id,由coordinator生成,递增epoch由coordinator生成committedtrue:commit false:abort
可以看到,在事务提交阶段,Producer只是触发了提交动作,并携带了事务所需的参数,所做的操作相当有限,重头还是在Coordinator端
注:这里的提交动作是直接提交给Coordinator的,就跟事务初始化阶段,获取Producer id一样
6.2、事务提交-Coordinator
在内部Topic __transaction_state 中存储了当前事物所关联的所有Partition信息,因此在提交阶段,就是向这些Partition发送control marker信息,用来标记当前事物的结束。而事务消息的标志正如前文消息协议所述,在attribute字段的第5个bit
attribute字段:
control |
如前文所说,LSO以下的消息是不会被消费到,这样控制了事务消息的可见性,想控制这点,难度应该不大;但事务提交后,所有当前事物的消息均可见了,那事务提交时,具体发生了什么,是如何控制可能分布在多台broker上的消息同时可见呢?

上图以3个Broker组成的事务举例:
- 1、Producer提交事务
- 2、Coordinator收到请求后 ,将事务状态修改为PrepareCommit(其实就是向
__transaction_state追加一条消息) - 3.1、向Producer响应,事务提交成功
- 3.2、之后向各个Broker发送control marker消息,Broker收到后将消息存储下来,用来比较当前事物已经成功提交
- 4、待各个Broker存储control marker消息后,Coordinator将事物状态修改为commit,事务结束
看起来是两阶段提交,且一切正常,但却有一些疑问:
问题1: 3.1向__transaction_state写完事务状态后,便给Producer回应说事务提交成功,假如说3.2执行过程中被hang住了,在Producer看来,既然事务已经提交成功,为什么还是读不到对应消息呢?
的确是这样,这里成功指的是Coordinator收到了消息,并且成功修改了事务状态。因此返回成功的语义指的是一阶段提交成功,因为后续向各个Partition发送写marker的会无限重试,直至成功
问题2: 3.2中向多个Broker发送marker消息,如果Broker1、Broker2均写入成功了,但是Broker3因为网络抖动,Coordinator还在重试,那么此时Broker1、Broker2上的消息对Consumer来说已经可见了,但是Broker3上的消息还是看不到,这不就不符合事务语义了吗?
事实确实如此,所以kafka的事务不能保证强一致性,并不是说kafka做的不够完美,而是这种分布式事务统一存在类似的问题,CAP铁律限制,这里只能做到最终一致性了。不过对于常规的场景这里已经够用了,Coordinator会不遗余力的重试,直至成功
kafka.coordinator.transaction.TransactionCoordinator#endTransaction() 这里是当__transaction_state状态改为PrepareCommit后,就向Producer返回成功
case Right((txnMetadata, newPreSendMetadata)) =>
  // we can respond to the client immediately and continue to write the txn markers if
  // the log append was successful
  responseCallback(Errors.NONE)

  txnMarkerChannelManager.addTxnMarkersToSend(coordinatorEpoch, txnMarkerResult, txnMetadata, newPreSendMetadata)
七、事务取消-Transaction Abort
参与方:Producer、Broker
7.1、事务取消-Producer
事务取消如果是Producer端触发的,代码如下
producer.abortTransaction();事务提交对应的API为ApiKeys.END_TXN(与事务提交是同一个API,不过参数不一样),Producer向Broker请求的入参为
transactionalId事务id,即客户自定义的字符串producerIdproducer id,由coordinator生成,递增epoch由coordinator生成committedfalse:abort
7.2、事务取消-Coordinator
事务取消除了由Producer触发外,还有可能由Coordinator触发,例如“事务超时”,Coordinator有个定时器,定时扫描那些已经超时的事务
kafka.coordinator.transaction.TransactionCoordinator#startup()
  def startup(retrieveTransactionTopicPartitionCount: () => Int, enableTransactionalIdExpiration: Boolean = true): Unit = {
    info("Starting up.")
    scheduler.startup()
    scheduler.schedule("transaction-abort",
      () => abortTimedOutTransactions(onEndTransactionComplete),
      txnConfig.abortTimedOutTransactionsIntervalMs,
      txnConfig.abortTimedOutTransactionsIntervalMs
    )
    txnManager.startup(retrieveTransactionTopicPartitionCount, enableTransactionalIdExpiration)
    txnMarkerChannelManager.start()
    isActive.set(true)

    info("Startup complete.")
}其实事务取消的流程在Coordinator端,跟事务提交大同小异,不过事务取消会向.txnindex文件写入数据,也就是.txnindex文件存储了所有已取消的事务详情。对应源码文件为 kafka.log.AbortedTxn.scala,.txnindex文件存储协议如下

currentVersion当前文件版本号,目前为0producerIdproducerIdfirstOffset当前事务的开始offsetlastOffset当前事务的结束offsetlastStableOffset存储时的LSO
存储详情中,不需要记录epoch、sequence等信息,因为这个文件的目的是配合Consumer进行消息过滤的,有了事务的起止offset已经足够
firstOffset 与 lastOffset 可能跨度很长,之间如果有多个事务如何区分呢?
其实首先明确一点,同一个ProducerId在同一个时间段,只会存在一个事物,例如某条记录是这样存储:(producerId:1000, firstOffset:20, lastOffset:80) ,也就是offset在20与80之间,producerId为1000的记录只会存在一条,当然也有可能出现如下记录
- (producerId:1001, firstOffset:30, lastOffset:40)
- (producerId:1001, firstOffset:50, lastOffset:60)
但是producerId一定不是1000了,这点很关键,因为在事务消息消费时,还要依赖这个
append“事务取消记录”入口 kafka.log.LogSegment#updateTxnIndex()
八、事务消费
参与方:Consumer、Broker
前文所有的工作,其实都体现在事务消费上,消费事务消息,也是kafka非常重要的课题
8.1、消费策略对比
当consumer的事务隔离级别(isolation.level)设置为 read_committed 后,便只能拉取LSO以下的记录,且返回的信息中还会携带已取消的事务
kafka.log.UnifiedLog#read
  def read(startOffset: Long,
           maxLength: Int,
           isolation: FetchIsolation,
           minOneMessage: Boolean): FetchDataInfo = {
    checkLogStartOffset(startOffset)
    val maxOffsetMetadata = isolation match {
      case FetchLogEnd => localLog.logEndOffsetMetadata
      case FetchHighWatermark => fetchHighWatermarkMetadata
      case FetchTxnCommitted => fetchLastStableOffsetMetadata
    }
    localLog.read(startOffset, maxLength, minOneMessage, maxOffsetMetadata, isolation == FetchTxnCommitted)
  }
正如前文所说,LSO之前的记录,均是已提交或已取消的事务;因此在一个事物未完成之前,是永远都不会被consumer拉取到的。此时还要引出前文提出的问题,即consumer消息策略
- 策略一:拉取位点设置为
High Water Mark,consumer不断拉取消息,不论是已经完结的事务消息还是未完结,亦或是普通消息,统一进行拉取;然后在consumer端进行过滤,发现某事物消息未完结,那么暂存在consumer,等收到control mark消息后,再判断将所有消息返回给业务方,或是丢弃 - 策略二:拉取位点设置为
Last Stable Offset,consumer只返回最后一个已完结事务之前的消息,consumer拉取消息后,即便是事务marker还未拉取,也可以判断是提交还是丢弃
其实很明显,现在kafka最新版本采用的是策略二,不过我们还是有必要比较一下两者优缺点
策略一 | 策略二 | |
优点 |
|
|
缺点 |
|
|
综合考虑后,kafka还是选择了可控性较强,且没有致命bug的策略二,虽然有一些性能损失,但换来的是整个集群的稳定性
8.2、常规消费事务消息
当consumer设置了read_committed消费消息时,除了返回常规的RecordBatch集合外,还会返回拉取区间已取消的事务列表。假定consumer收到了一段数据:
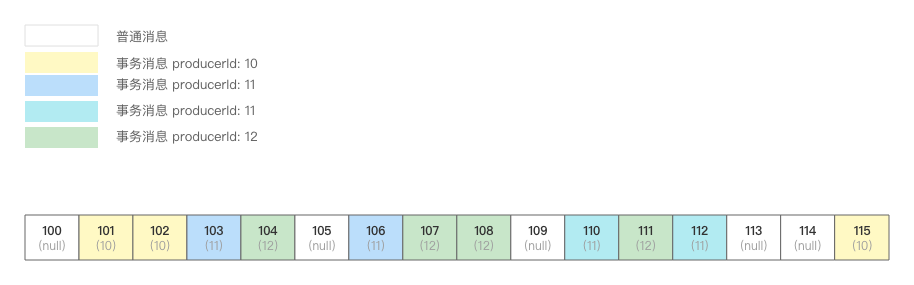
其中白色的为非事务消息,即普通消息,彩色的为事务消息,相同颜色的消息为同一事务。下面表格中,abortTxns的格式为 (producerId, startOffset, endOffset)
abortTxns | 有效消息 | 无效消息 | 说明 |
empty | 100-115 | 无 | 当取消事务列表为空时,说明当前读取到事务消息均为提交成功的事务消息 |
[(10, 101, 115)] | 100, 103-114 | 101,102,103 | abort列表表明producerId为10的事务已经取消,因此扫描整个列表,发现符合abort条件的记录是101、102、115 |
[(11, 110, 112)] | 100-109, 111, 113-115 | 110, 112 | 虽然103、106的producerId也是11,但是offset range并不匹配;虽然111的offset range匹配,但是其producerId不匹配 |
[(10, 101, 115), (11, 103, 106), (12, 104, 111)] | 100,105,109,110,112,113,114 | 101-104, 106-108, 111, 115 | 不再赘述,无效消息通过producerId+offset range统一来确定 |
注:consumer在读取以上信息的时候,可能并内有读取到control marker信息,但是已经能够确定目标消息是事务完结状态,且已经知道事务是commit或abort了,因此可以直接处理;而control消息是由coordinator发送给各个partition的,属于内部消息,consumer对于control消息是会自动过滤掉的
org.apache.kafka.clients.consumer.internals.Fetcher.CompletedFetch#nextFetchedRecord()
// control records are not returned to the user
if (!currentBatch.isControlBatch()) {
    return record;
} else {
    // Increment the next fetch offset when we skip a control batch.
    nextFetchOffset = record.offset() + 1;
}
8.3、业务方事务
既然kafka已经实现了事务,那么我们的业务系统中是否可以直接依赖这一特性?

假如这样使用kafka:
- 业务方通过consumer拉取一条消息
- 业务程序通过这条消息处理业务,可能将结果存入mysql或写入文件或其他存储介质
如果业务方将1、2整体当做是一个事务的话,那么理解就有偏差了,因为这个过程当中还缺少提交位点的步骤,假如步骤2已经执行完毕,但还未提交位点,consumer发生了重启了,那么这条消息还会被再次消费,因此kafka所说的事务支持,指的是读取、写入都在kafka集群上
8.4、Exactly Once
消息的消费可以分为三种类型
- At Least Once(至少一次)
- 也就是某条消息,至少会被消费一次,潜台词就是消息可能会被消费多次,也就是重复消费;kafka默认的消费类型,实现它的原理很简单,就是在业务方将消息消费掉后,再提交其对应的位点,业务方只要做好消息去重,运行起来还是很严谨的
- At Most Once (至多一次)
- 与至少一次相对,不存在重复消费的情况,某条消息最多被消费一次,潜台词就是可能会丢消息;实现原理还是控制位点,在消费某条消息之前,先提交其位点,再消费,如果提交了位点,consumer重启了,重启后从最新位点开始消费数据,也就是之前的数据丢失了,并没有真正消费
- Exactly Once(精确一次)
- 不论是“至少一次”还是“至多一次”都不如精确一次来的生猛,有文章说kafka事务实现了精确一次,但这样评论是不够严谨的,如果业务方将一次「拉取消息+业务处理」当做一次处理的话,那即便是开启了事务也不能保证精确一次;这里的精确一次指的读取、写入都是操作的kafka集群,而不能引入业务处理
关于Exactly Once,这里引用一下官方对其描述,Exactly-once Semantics in Apache Kafka
- Idempotent producer: Exactly-once, in-order, delivery per partition.
- Transactions: Atomic writes across partitions.
- Exactly-once stream processing across read-process-write tasks.
简单概括一下就是 1、幂等型的Producer,在单分区的前提下支持精准一次、有序的消息投递;2、事务,跨多分区的原子写入 3、Stream任务,类型为read-process-write形式的,可做到精确一次
举Stream中的例子:从1个Topic中读取数据,经过业务方的加工后,写入另外Topic中
producer.initTransactions();
producer.beginTransaction();

ConsumerRecords<String, String> consumerRecords = consumer.poll(Duration.ofMillis(1000));
Map<TopicPartition, OffsetAndMetadata> offsets = new HashMap<>();
for (TopicPartition partition : consumerRecords.partitions()) {
    List<ConsumerRecord<String, String>> partitionRecords = consumerRecords.records(partition);
    for (ConsumerRecord<String, String> record : partitionRecords) {
        ProducerRecord<String, String> producerRecord = new ProducerRecord<>("topic-sink", record.key(), record.value());
        producer.send(producerRecord);
    }
    long lastConsumedOffset = partitionRecords.get(partitionRecords.size() - 1).offset();
    offsets.put(partition, new OffsetAndMetadata(lastConsumedOffset + 1));
}
producer.sendOffsetsToTransaction(offsets, new ConsumerGroupMetadata("groupId"));

producer.commitTransaction();
可以简单认为,将一次数据读取,转换为了数据写入,并统一归并至当前事务中;关键代码为
producer.sendOffsetsToTransaction(offsets, new ConsumerGroupMetadata("groupId"));
这个请求对应的API是ApiKeys.ADD_OFFSETS_TO_TXN,参数列表为
- transactionalId
- producerId
- epoch
- groupId
核心思想就是算出groupId在__consumer_offsets中对应的partition,然后将该partition加入事务中,在事务提交/取消时,再统一操作,这样便实现了读与写的原子性。
不过这样做的前提是consumer需要将enable.auto.commit参数设置为false,并使用producer.sendOffsetsToTransaction()来提交offset
九、事务状态流转
事务总共有8种状态
state | desc |
0-Empty | Transaction has not existed yet
|
1-Ongoing | Transaction has started and ongoing
|
2-PrepareCommit | Group is preparing to commit
|
3-PrepareAbort | Group is preparing to abort
|
4-CompleteCommit | Group has completed commit Will soon be removed from the ongoing transaction cache |
5-CompleteAbort | Group has completed abort Will soon be removed from the ongoing transaction cache |
6-Dead | TransactionalId has expired and is about to be removed from the transaction cache |
7-PrepareEpochFence | We are in the middle of bumping the epoch and fencing out older producers. |

最常见的状态流转
- Empty->Ongong->PrepareCommit->CompleteCommit->Empty
- Empty->Ongong->PrepareAbort->CompleteAbort->Empty
十、事务Topic及文件
10.1、简单总结
总结一下kafka事务相关的一些topic及文件。topic只有一个,是专门为事务特性*服务的,而文件有两个,这里的文件指的是所有参与事务的topic下文件
- Topic
__transaction_state内部compact topic,主要是将事务状态持久化,避免Transactional Coordinator重启或切换后事务状态丢失
- 文件
.txnindex存放已经取消事务的记录,请问已经提到过,如果当前logSegment没有取消的事务,那么这个文件也不会存在.snapshot正如其名,因为Broker端要存放每个ProducerId与Sequence的映射关系,目的是sequence num的验重
10.2、.snapshot 文件
.snapshot 跟其他索引文件不同,其他索引文件都是随着记录的增加,动态append到文件中的;而.snapshot文件则是在logSegment roll时,也就是切换下一个log文件时,将当前缓存中的所有producerId及Sequence的映射关系存储下来。一旦发生Broker宕机,重启后只需要将最近一个.snapshot读取出来,并通过log文件将后续的数据补充进来,这样缓存中就可以存储当前分区的全量索引

field | desc |
Version | Version of the snapshot file |
Crc | CRC of the snapshot data |
Number | The entries in the producer table |
ProducerId | The producer ID |
ProducerEpoch | Current epoch of the producer |
LastSequence | Last written sequence of the producer |
LastOffset | Last written offset of the producer |
OffsetDelta | The difference of the last sequence and first sequence in the last written batch |
Timestamp | Max timestamp from the last written entry |
CoordinatorEpoch | The epoch of the last transaction coordinator to send an end transaction marker |
CurrentTxnFirstOffset | The first offset of the on-going transaction (-1 if there is none) |
附录
事务中使用的API
API KEY | 描述 |
ApiKeys.FIND_COORDINATOR | 寻找transaction coordinator |
ApiKeys.INIT_PRODUCER_ID | 初始化producerId及epoch |
ApiKeys.ADD_PARTITIONS_TO_TXN | 将某个partition添加进入事务 |
ApiKeys.PRODUCE | 发送消息 |
ApiKeys.END_TXN | 事务结束,包括事务提交跟事务取消 |
ApiKeys.FETCH | 拉取消息 |
ApiKeys.ADD_OFFSETS_TO_TXN | read-process-write模式时使用,用于将一次读操作转换为写行为 |
部分代码记录
注:本文所有代码截取均基于开源v3.3.1版本
- kafka topic 中的文件
kafka.log.UnifiedLog#1767
object UnifiedLog extends Logging {
  val LogFileSuffix = LocalLog.LogFileSuffix
  val IndexFileSuffix = LocalLog.IndexFileSuffix
  val TimeIndexFileSuffix = LocalLog.TimeIndexFileSuffix
  val ProducerSnapshotFileSuffix = ".snapshot"
  val TxnIndexFileSuffix = LocalLog.TxnIndexFileSuffix
  val DeletedFileSuffix = LocalLog.DeletedFileSuffix
  val CleanedFileSuffix = LocalLog.CleanedFileSuffix
  val SwapFileSuffix = LocalLog.SwapFileSuffix
  val DeleteDirSuffix = LocalLog.DeleteDirSuffix
val FutureDirSuffix = LocalLog.FutureDirSuffix- 根据TransactionId计算partition
kafka.coordinator.transaction.TransactionStateManager#partitionFor
def partitionFor(transactionalId: String): Int = Utils.abs(transactionalId.hashCode) % transactionTopicPartitionCount- 生成ProducerId
kafka.coordinator.transaction.ZkProducerIdManager#generateProducerId
  def generateProducerId(): Long = {
    this synchronized {
      // grab a new block of producerIds if this block has been exhausted
      if (nextProducerId > currentProducerIdBlock.lastProducerId) {
        allocateNewProducerIdBlock()
        nextProducerId = currentProducerIdBlock.firstProducerId
      }
      nextProducerId += 1
      nextProducerId - 1
    }
}- 过滤control消息
org.apache.kafka.clients.consumer.internals.Fetcher.CompletedFetch#nextFetchedRecord
if (record.offset() >= nextFetchOffset) {
    // we only do validation when the message should not be skipped.
    maybeEnsureValid(record);

    // control records are not returned to the user
    if (!currentBatch.isControlBatch()) {
        return record;
    } else {
        // Increment the next fetch offset when we skip a control batch.
        nextFetchOffset = record.offset() + 1;
    }
}
参考:
https://www.confluent.io/blog/simplified-robust-exactly-one-semantics-in-kafka-2-5/
https://www.slideshare.net/ConfluentInc/exactlyonce-semantics-in-apache-kafka
https://docs.google.com/document/d/11Jqy_GjUGtdXJK94XGsEIK7CP1SnQGdp2eF0wSw9ra8/edit
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70000523/viewspace-3169936/ ,如需转载,请注明出处,否则将追究法律责任。

