
当我们写下一条复杂的sql时,不是盲目去执行,选择提前explain分析sql,是一个不错的选择,避免没用到索引或者用到错误的索引导致mysql大量的扫表,造成线上不好的后果。
mysql提供的explain命令可以获取select语句的执行计划,通过explain我们可以知道:表的读取顺序,数据读取操作的类型,哪些索引可以使用,哪些索引实际使用了等等。
mysql> explain select * from user;
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | user  | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
1 row in set, 1 warning (0.01 sec)
以下全部基于mysql5.7.32
mysql> select version();
+-----------+
| version() |
+-----------+
| 5.7.32    |
+-----------+
1 row in set (0.00 sec)
id
mysql> explain select * from user a left join user_info b on a.id=b.user_id where a.id=1;
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref   | rows | filtered | Extra |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | a     | NULL       | const | PRIMARY       | PRIMARY | 8       | const |    1 |   100.00 | NULL  |
|  1 | SIMPLE      | b     | NULL       | ref   | user_id       | user_id | 8       | const |    1 |   100.00 | NULL  |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
id相同的时候,从上往下顺序执行
mysql> explain select * from user where id = (select user_id from user_info where age=10);
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
| id | select_type | table     | partitions | type  | possible_keys | key     | key_len | ref   | rows | filtered | Extra       |
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
|  1 | PRIMARY     | user      | NULL       | const | PRIMARY       | PRIMARY | 8       | const |    1 |   100.00 | NULL        |
|  2 | SUBQUERY    | user_info | NULL       | ALL   | NULL          | NULL    | NULL    | NULL  |    1 |   100.00 | Using where |
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
id不同的时候,越大的id越先执行,对于这种子查询,优先执行子sql拿到结果,才去执行主sql
mysql> explain select * from user  union  select * from user;
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
| id | select_type  | table      | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra           |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
|  1 | PRIMARY      | user       | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index     |
|  2 | UNION        | user       | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index     |
| NULL | UNION RESULT | <union1,2> | NULL       | ALL   | NULL          | NULL | NULL    | NULL | NULL |     NULL | Using temporary |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
3 rows in set, 1 warning (0.00 sec)
对于union查询,会创建一个临时表,对应的id是null
select_type
SIMPLE
simple是简单查询,mysql认为比较简单的查询,不包含子查询和union查询都是simple,哪怕简单的join都是simple
mysql> explain select * from user;
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | user  | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
mysql> explain select * from user a left join user_info b on a.id=b.user_id;
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref       | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+-------------+
|  1 | SIMPLE      | a     | NULL       | index | NULL          | name    | 402     | NULL      |    1 |   100.00 | Using index |
|  1 | SIMPLE      | b     | NULL       | ref   | user_id       | user_id | 8       | test.a.id |    1 |   100.00 | NULL        |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)
PRIMARY
查询中若包含任何复杂的子部分,最外层查询则被标记为primary
mysql> explain select * from user where id = (select id from user_info where age=10);
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
| id | select_type | table     | partitions | type  | possible_keys | key     | key_len | ref   | rows | filtered | Extra       |
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
|  1 | PRIMARY     | user      | NULL       | const | PRIMARY       | PRIMARY | 8       | const |    1 |   100.00 | NULL        |
|  2 | SUBQUERY    | user_info | NULL       | ALL   | NULL          | NULL    | NULL    | NULL  |    1 |   100.00 | Using where |
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)
mysql> explain select * from  user union all select * from user;
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
|  1 | PRIMARY     | user  | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index |
|  2 | UNION       | user  | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)
SUBQUERY
在SELECT或WHERE列表中包含了子查询的语句
mysql> explain select (select id from user) from user;
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
|  1 | PRIMARY     | user  | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index |
|  2 | SUBQUERY    | user  | NULL       | index | NULL          | name | 402     | NULL |    1 |   100.00 | Using index |
+----+-------------+-------+------------+-------+---------------+------+---------+------+------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)
mysql> explain select * from user where id= (select user_id from user_info where age=10);
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
| id | select_type | table     | partitions | type  | possible_keys | key     | key_len | ref   | rows | filtered | Extra       |
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
|  1 | PRIMARY     | user      | NULL       | const | PRIMARY       | PRIMARY | 8       | const |    1 |   100.00 | NULL        |
|  2 | SUBQUERY    | user_info | NULL       | ALL   | NULL          | NULL    | NULL    | NULL  |    1 |   100.00 | Using where |
+----+-------------+-----------+------------+-------+---------------+---------+---------+-------+------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)
DERIVED
派生表的select(from子句的子查询)
mysql> explain select * from (select * from user union select * from user) c;
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
| id | select_type  | table      | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra           |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
|  1 | PRIMARY      | <derived2> | NULL       | ALL   | NULL          | NULL | NULL    | NULL |    4 |   100.00 | NULL            |
|  2 | DERIVED      | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
|  3 | UNION        | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
| NULL | UNION RESULT | <union2,3> | NULL       | ALL   | NULL          | NULL | NULL    | NULL | NULL |     NULL | Using temporary |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
4 rows in set, 1 warning (0.00 sec)
UNION
union中后面的select语句
mysql> explain select * from user union select * from user;
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
| id | select_type  | table      | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra           |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
|  1 | PRIMARY      | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
|  2 | UNION        | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
| NULL | UNION RESULT | <union1,2> | NULL       | ALL   | NULL          | NULL | NULL    | NULL | NULL |     NULL | Using temporary |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
3 rows in set, 1 warning (0.02 sec)
DEPENDENT UNION
出现在union或union all语句中,但是这个查询要受到外部查询的影响
mysql> explain select * from user where id in(select id from user union select id from user);
+----+--------------------+------------+------------+--------+---------------+---------+---------+------+------+----------+--------------------------+
| id | select_type        | table      | partitions | type   | possible_keys | key     | key_len | ref  | rows | filtered | Extra                    |
+----+--------------------+------------+------------+--------+---------------+---------+---------+------+------+----------+--------------------------+
|  1 | PRIMARY            | user       | NULL       | index  | NULL          | name    | 1023    | NULL |    1 |   100.00 | Using where; Using index |
|  2 | DEPENDENT SUBQUERY | user       | NULL       | eq_ref | PRIMARY       | PRIMARY | 4       | func |    1 |   100.00 | Using index              |
|  3 | DEPENDENT UNION    | user       | NULL       | eq_ref | PRIMARY       | PRIMARY | 4       | func |    1 |   100.00 | Using index              |
| NULL | UNION RESULT       | <union2,3> | NULL       | ALL    | NULL          | NULL    | NULL    | NULL | NULL |     NULL | Using temporary          |
+----+--------------------+------------+------------+--------+---------------+---------+---------+------+------+----------+--------------------------+
4 rows in set, 1 warning (0.11 sec)
DEPENDENT SUBQUERY
同DEPENDENT UNION 差不多,包含子查询,且受到外部查询的影响
mysql> explain select * from user where id in(select id from user union select id from user);
+----+--------------------+------------+------------+--------+---------------+---------+---------+------+------+----------+--------------------------+
| id | select_type        | table      | partitions | type   | possible_keys | key     | key_len | ref  | rows | filtered | Extra                    |
+----+--------------------+------------+------------+--------+---------------+---------+---------+------+------+----------+--------------------------+
|  1 | PRIMARY            | user       | NULL       | index  | NULL          | name    | 1023    | NULL |    1 |   100.00 | Using where; Using index |
|  2 | DEPENDENT SUBQUERY | user       | NULL       | eq_ref | PRIMARY       | PRIMARY | 4       | func |    1 |   100.00 | Using index              |
|  3 | DEPENDENT UNION    | user       | NULL       | eq_ref | PRIMARY       | PRIMARY | 4       | func |    1 |   100.00 | Using index              |
| NULL | UNION RESULT       | <union2,3> | NULL       | ALL    | NULL          | NULL    | NULL    | NULL | NULL |     NULL | Using temporary          |
+----+--------------------+------------+------------+--------+---------------+---------+---------+------+------+----------+--------------------------+
4 rows in set, 1 warning (0.11 sec)
UNION RESULT
出现在union或union all中,表示的是一个结果集
mysql> explain select id from user union select id from user;
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
| id | select_type  | table      | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra           |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
|  1 | PRIMARY      | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
|  2 | UNION        | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
| NULL | UNION RESULT | <union1,2> | NULL       | ALL   | NULL          | NULL | NULL    | NULL | NULL |     NULL | Using temporary |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
3 rows in set, 1 warning (0.00 sec)
table
查询的表名,有时候显示的并不是真正的表名
mysql> explain select * from (select * from user union select * from user) c;
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
| id | select_type  | table      | partitions | type  | possible_keys | key  | key_len | ref  | rows | filtered | Extra           |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
|  1 | PRIMARY      | <derived2> | NULL       | ALL   | NULL          | NULL | NULL    | NULL |    4 |   100.00 | NULL            |
|  2 | DERIVED      | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
|  3 | UNION        | user       | NULL       | index | NULL          | name | 1023    | NULL |    1 |   100.00 | Using index     |
| NULL | UNION RESULT | <union2,3> | NULL       | ALL   | NULL          | NULL | NULL    | NULL | NULL |     NULL | Using temporary |
+----+--------------+------------+------------+-------+---------------+------+---------+------+------+----------+-----------------+
4 rows in set, 1 warning (0.00 sec)
比如id=1的table是derived2,说明它查的是一个派生表,其中derived
[num],这个num就是第几步执行的结果,这里是2,说明就是id=2的那一步执行的结果。
partitions
查询匹配记录的分区。对于非分区表,值为NULL。
先创建一张分区表
CREATE TABLE users (
     id INT NOT NULL ,
     name varchar(100) NOT NULL
)
PARTITION BY RANGE (id) (
     PARTITION p0 VALUES LESS THAN (10),
     PARTITION p1 VALUES LESS THAN (20),
     PARTITION p2 VALUES LESS THAN (30),
     PARTITION p3 VALUES LESS THAN MAXVALUE
);
通过id分了4个区,插入两条数据
mysql> select * from users;
+----+-------+
| id | name  |
+----+-------+
|  1 | Tom   |
| 11 | jerry |
+----+-------+
2 rows in set (0.00 sec)
mysql> explain select * from users where id=1;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | users | p0         | ALL  | NULL          | NULL | NULL    | NULL |    1 |   100.00 | Using where |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
id=1 分布在p0分区
mysql> explain select * from users where id=11;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | users | p1         | ALL  | NULL          | NULL | NULL    | NULL |    1 |   100.00 | Using where |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
id=11 分布在p1分区
type
type是非常重要的指标,它表示我们使用什么类型去查数据。下面由好到坏的介绍各个type类型
system
这种类型一般不会出现,官方解释:
The table has only one row (= system table). This is a special case of the const join type.
表只有一行记录,一般是系统表,是一种特殊的const类型
const
表最多有一个匹配行,因为只有一行,所以优化器的其余部分可以将此行中列的值视为常量。const表非常快,因为它们只读取一次。
mysql> explain select * from user where id=1;
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref   | rows | filtered | Extra |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | user  | NULL       | const | PRIMARY       | PRIMARY | 4       | const |    1 |   100.00 | NULL  |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.01 sec)
const一定是用到primary key或者unique的索引时候才会出现。
mysql> explain select * from user where name="Tom";
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+-------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref   | rows | filtered | Extra       |
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+-------------+
|  1 | SIMPLE      | user  | NULL       | ref  | name          | name | 1023    | const |    1 |   100.00 | Using index |
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+-------------+
1 row in set, 1 warning (0.01 sec)
虽然通过name也查出一条数据,但是由于name是普通索引,所以不是const
eq_ref
除了system和const 它是最好的。一般出现在连接查询中,且连接的条件是主键索引或者唯一索引时,就会用到它。
mysql> explain select * from user a left join user_info b on a.id=b.user_id;
+----+-------------+-------+------------+--------+---------------+---------+---------+-----------+------+----------+-------------+
| id | select_type | table | partitions | type   | possible_keys | key     | key_len | ref       | rows | filtered | Extra       |
+----+-------------+-------+------------+--------+---------------+---------+---------+-----------+------+----------+-------------+
|  1 | SIMPLE      | a     | NULL       | index  | NULL          | name    | 1023    | NULL      |    1 |   100.00 | Using index |
|  1 | SIMPLE      | b     | NULL       | eq_ref | user_id       | user_id | 4       | test.a.id |    1 |   100.00 | NULL        |
+----+-------------+-------+------------+--------+---------------+---------+---------+-----------+------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)
a.id是primary key
b.user_id是 unique key
先查a表,a表关联b表通过id和user_id来,因为id是主键索引,而user_id又是唯一索引,那么a表中的每条记录仅会关联b表的一条记录。所以b表的类型就是eq_ref。
ref
和eq_ref相比,不同的就是关联表查询的字段不是唯一或者主键索引,就是匹配到了,还要继续匹配,可能有多条记录。
mysql> explain select b.* from user a left join user_info b on a.id=b.user_id;
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref       | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+-------------+
|  1 | SIMPLE      | a     | NULL       | index | NULL          | name    | 402     | NULL      |    1 |   100.00 | Using index |
|  1 | SIMPLE      | b     | NULL       | ref   | user_id       | user_id | 8       | test.a.id |    1 |   100.00 | NULL        |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+-------------+
2 rows in set, 1 warning (0.01 sec)
a.id是
primary key
b.user_id是普通的索引
key
a可能关联b的多条记录,但是起码有索引,所以的b的type就是ref。
fulltext
全文索引的话,innodb不支持,随着各种搜索引擎的出现,一般出现需要全文索引的地方,都会用类似es擅长分词的存储。
ref_or_null
这种类型类似于ref,但是MySQL会额外搜索包含空值的行。
mysql> explain select * from user_info where user_id is null or user_id=1;
+----+-------------+-----------+------------+-------------+---------------+---------+---------+-------+------+----------+-----------------------+
| id | select_type | table     | partitions | type        | possible_keys | key     | key_len | ref   | rows | filtered | Extra                 |
+----+-------------+-----------+------------+-------------+---------------+---------+---------+-------+------+----------+-----------------------+
|  1 | SIMPLE      | user_info | NULL       | ref_or_null | user_id       | user_id | 9       | const |  108 |   100.00 | Using index condition |
+----+-------------+-----------+------------+-------------+---------------+---------+---------+-------+------+----------+-----------------------+
1 row in set, 1 warning (0.00 sec)
user_id是普通的索引
key,且允许为null。
index_merge
索引合并
mysql> explain select * from user_info where id=1 or user_id=999;
+----+-------------+-----------+------------+-------------+-----------------+-----------------+---------+------+------+----------+-------------------------------------------+
| id | select_type | table     | partitions | type        | possible_keys   | key             | key_len | ref  | rows | filtered | Extra                                     |
+----+-------------+-----------+------------+-------------+-----------------+-----------------+---------+------+------+----------+-------------------------------------------+
|  1 | SIMPLE      | user_info | NULL       | index_merge | PRIMARY,user_id | PRIMARY,user_id | 8,9     | NULL |    2 |   100.00 | Using union(PRIMARY,user_id); Using where |
+----+-------------+-----------+------------+-------------+-----------------+-----------------+---------+------+------+----------+-------------------------------------------+
1 row in set, 1 warning (0.00 sec)
id是主键索引,user_id是普通索引,结果用了两个索引的合并
unique_subquery
用于where中的in形式子查询,子查询返回不重复值唯一值,可以完全替换子查询,效率更高。 该类型替换了下面形式的IN子查询的ref。
explain select * from user_info where user_id in (select id from user where id>10);
子查询的id为
primary key或者
unique key。
index_subquery
类似于unique_subquery子查询,但是子查询返回的是非唯一索引。
explain select * from user_info where user_id in (select id from user where id>10);
子查询的id不是
primary key和
unique key。
range
索引范围扫描,一般条件使用了 >,<,between,in等运算符的查询。
mysql> explain select * from user where id>=1 and id <=100;
+----+-------------+-------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | user  | NULL       | range | PRIMARY       | PRIMARY | 8       | NULL |  100 |   100.00 | Using where |
+----+-------------+-------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
index
和全表扫差不多,但是只有索引树被扫描,这通常比全表扫快,因为索引文件通常比数据文件小。
mysql> explain select user_id from user_info;
+----+-------------+-----------+------------+-------+---------------+---------+---------+------+--------+----------+-------------+
| id | select_type | table     | partitions | type  | possible_keys | key     | key_len | ref  | rows   | filtered | Extra       |
+----+-------------+-----------+------------+-------+---------------+---------+---------+------+--------+----------+-------------+
|  1 | SIMPLE      | user_info | NULL       | index | NULL          | user_id | 9       | NULL | 100100 |   100.00 | Using index |
+----+-------------+-----------+------------+-------+---------------+---------+---------+------+--------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
ALL
全表扫描
mysql> explain select * from user_info where age=1;
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+-------------+
| id | select_type | table     | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra       |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+-------------+
|  1 | SIMPLE      | user_info | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 100100 |    10.00 | Using where |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
age没有索引,引擎层做了全表扫。
possible_keys
查询可能使用到的索引。
mysql> explain select * from user_info where id>1 and user_id >2;
+----+-------------+-----------+------------+-------+-----------------+---------+---------+------+-------+----------+-------------+
| id | select_type | table     | partitions | type  | possible_keys   | key     | key_len | ref  | rows  | filtered | Extra       |
+----+-------------+-----------+------------+-------+-----------------+---------+---------+------+-------+----------+-------------+
|  1 | SIMPLE      | user_info | NULL       | range | PRIMARY,user_id | PRIMARY | 8       | NULL | 50050 |    50.00 | Using where |
+----+-------------+-----------+------------+-------+-----------------+---------+---------+------+-------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
id和
user_id都有索引
key
执行器最终选择的索引
mysql> explain select * from user_info where id>1 and user_id >2;
+----+-------------+-----------+------------+-------+-----------------+---------+---------+------+-------+----------+-------------+
| id | select_type | table     | partitions | type  | possible_keys   | key     | key_len | ref  | rows  | filtered | Extra       |
+----+-------------+-----------+------------+-------+-----------------+---------+---------+------+-------+----------+-------------+
|  1 | SIMPLE      | user_info | NULL       | range | PRIMARY,user_id | PRIMARY | 8       | NULL | 50050 |    50.00 | Using where |
+----+-------------+-----------+------------+-------+-----------------+---------+---------+------+-------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
这里选择了主键索引。
key_len
使用的索引的长度,这里面的情况还是挺复杂的,特别对于一些复合索引。
假设存在这样的表
CREATE TABLE `testlen` (
  `id` int(11) unsigned NOT NULL AUTO_INCREMENT,
  `name1` varchar(10) not null default "",
  `name2` varchar(10),
  `num1` int(10) not null default 0,
  `num2` int(10),
   PRIMARY KEY (`id`),
   key(`name1`),
   key(`name2`),
   key(`num1`),
   key(`num2`)

) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
1.当字段为定长时,如char,int这些,需要有一个字节来标记是否为空,not null的话就不需要。
mysql> explain select * from testlen where num1=1;
+----+-------------+---------+------------+------+---------------+------+---------+-------+------+----------+-------+
| id | select_type | table   | partitions | type | possible_keys | key  | key_len | ref   | rows | filtered | Extra |
+----+-------------+---------+------------+------+---------------+------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | testlen | NULL       | ref  | num1          | num1 | 4       | const |    1 |   100.00 | NULL  |
+----+-------------+---------+------------+------+---------------+------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.03 sec)
mysql> explain select * from testlen where num2=1;
+----+-------------+---------+------------+------+---------------+------+---------+-------+------+----------+-------+
| id | select_type | table   | partitions | type | possible_keys | key  | key_len | ref   | rows | filtered | Extra |
+----+-------------+---------+------------+------+---------------+------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | testlen | NULL       | ref  | num2          | num2 | 5       | const |    1 |   100.00 | NULL  |
+----+-------------+---------+------------+------+---------------+------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)
2.当字段为变长的时候,如varchar这些,除了是否需要用一个字节来标记非not null的,还需要额外的两个字节标记长度
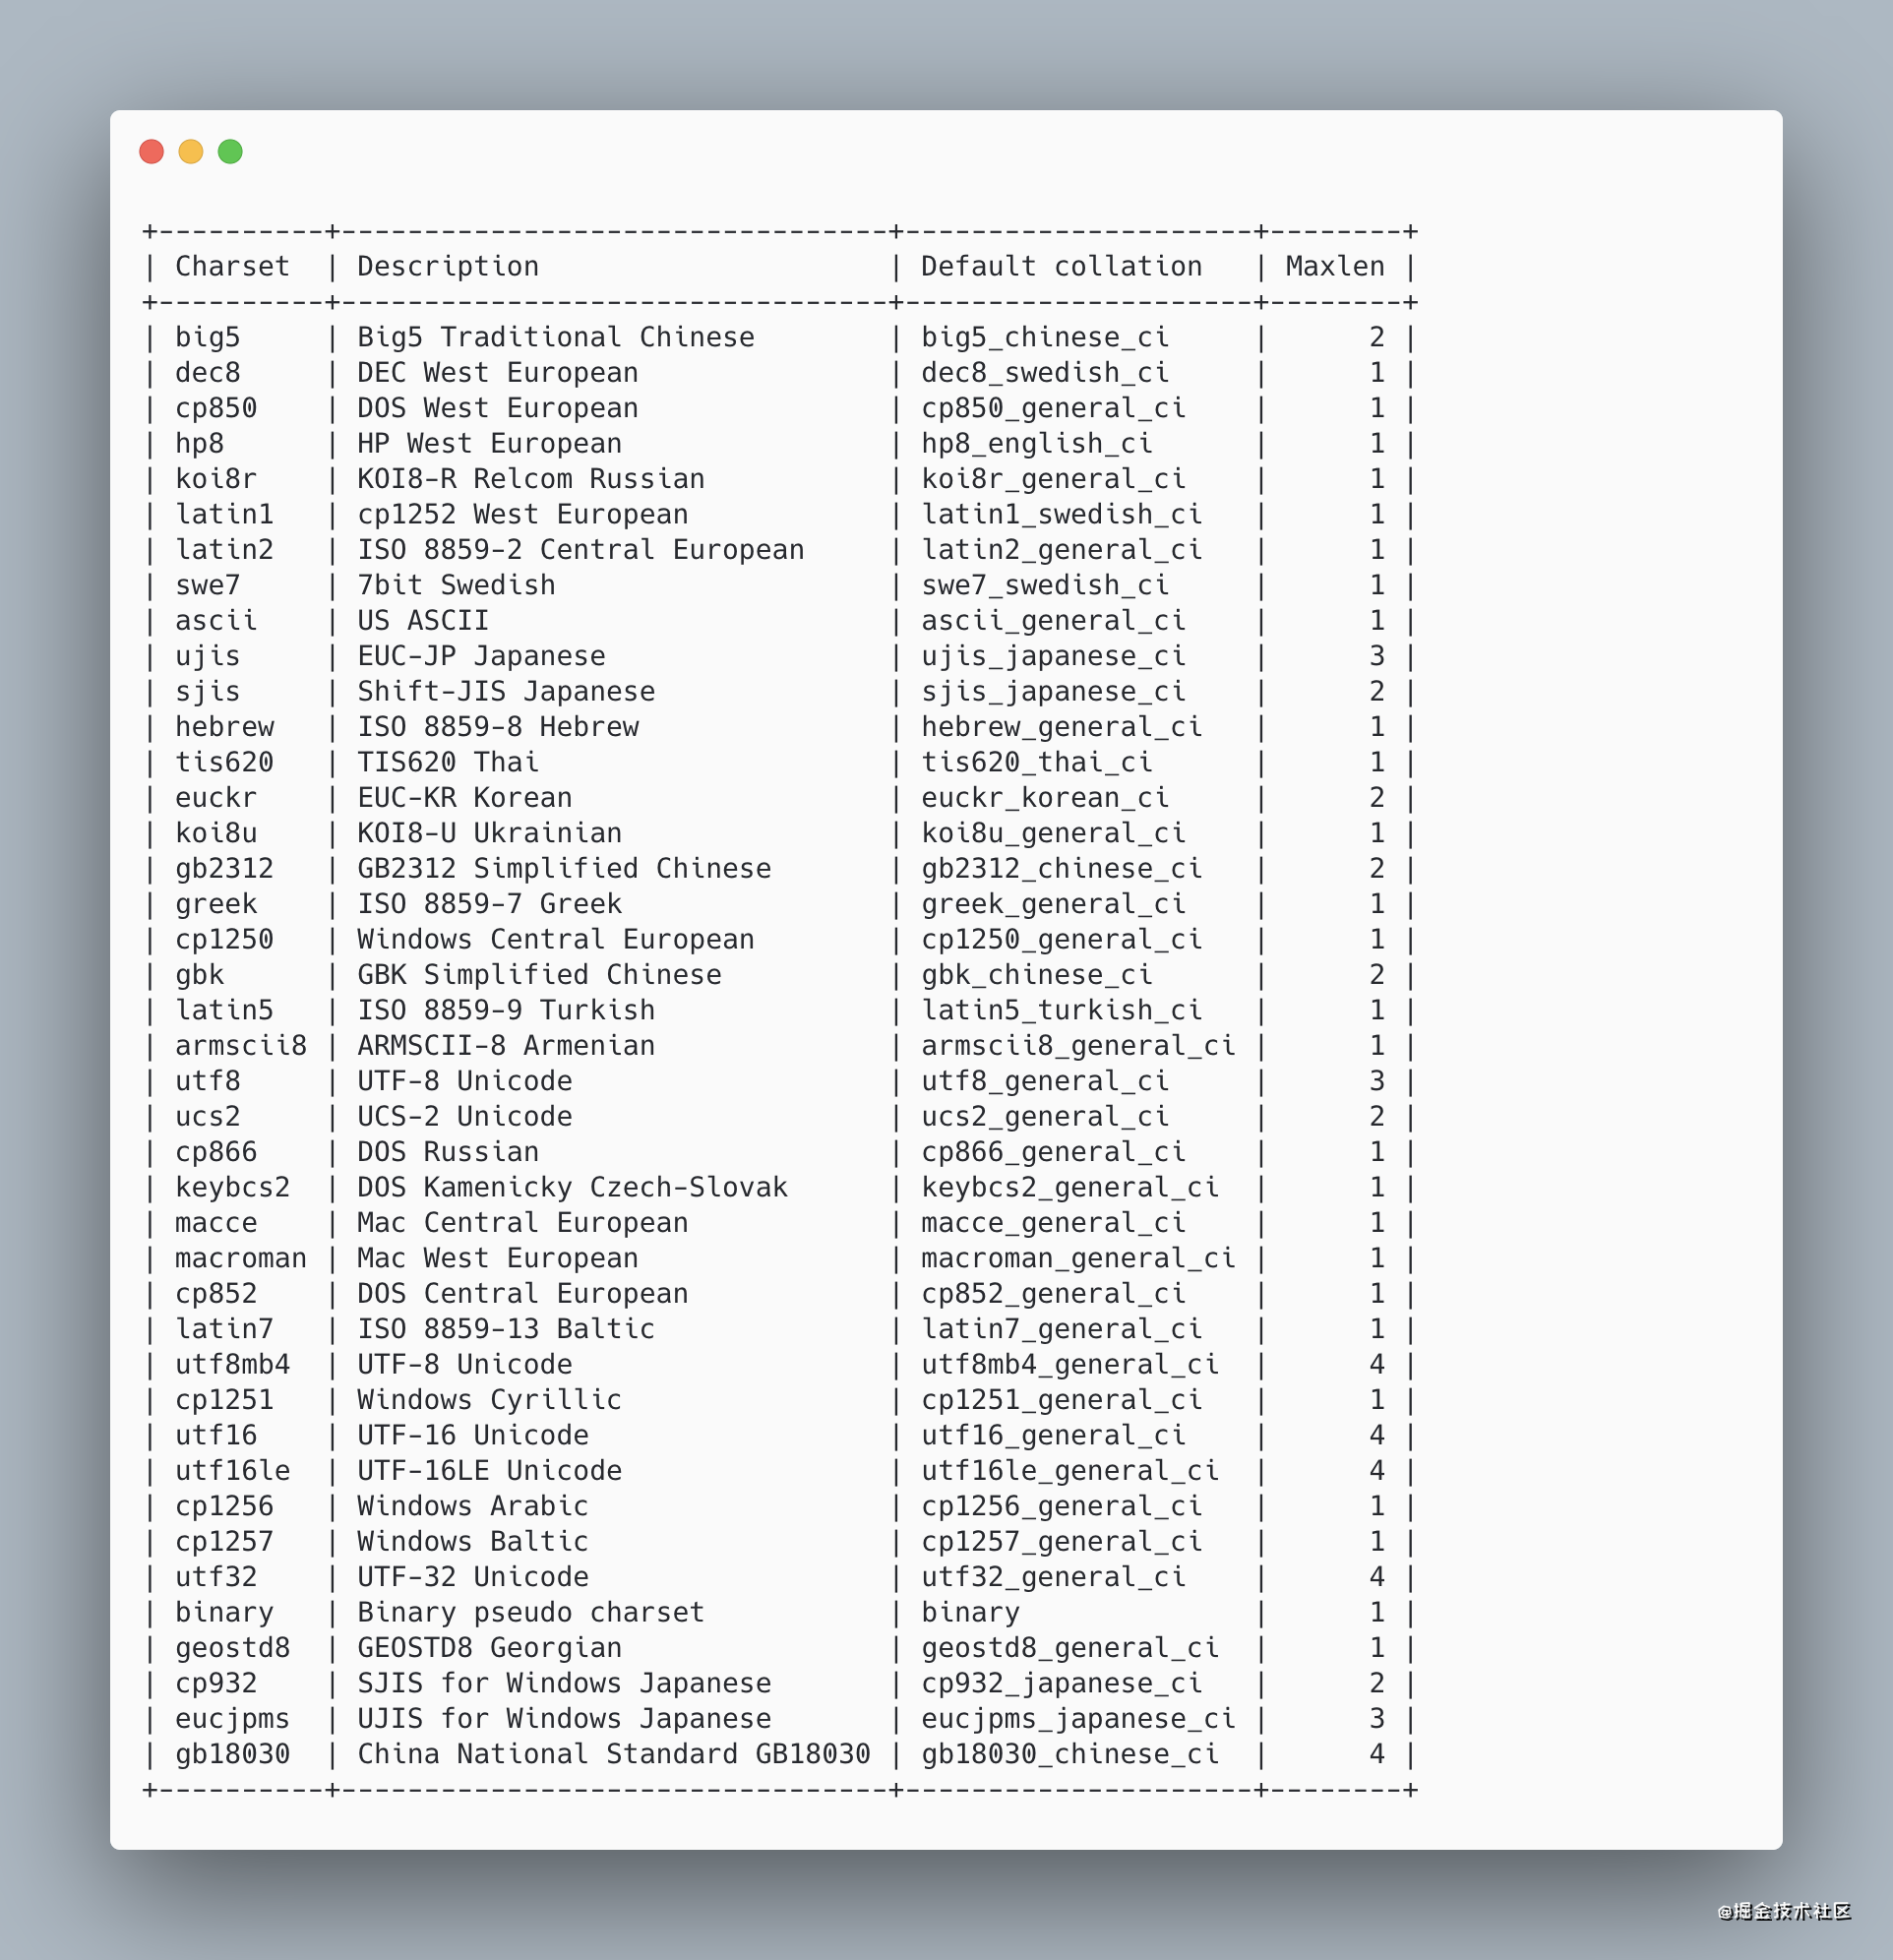
3.对于char、varchar这些,utf8编码的一个字符占用3个字节,utf8mb4一个字符占用4个字节
mysql> explain select * from testlen where name1='1';
+----+-------------+---------+------------+------+---------------+-------+---------+-------+------+----------+-------+
| id | select_type | table   | partitions | type | possible_keys | key   | key_len | ref   | rows | filtered | Extra |
+----+-------------+---------+------------+------+---------------+-------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | testlen | NULL       | ref  | name1         | name1 | 42      | const |    1 |   100.00 | NULL  |
+----+-------------+---------+------------+------+---------------+-------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.01 sec)
对于utf8mb4编码的来说,not null的varchar(10) 最终长度=10*4+2 = 42
mysql> explain select * from testlen where name2='1';
+----+-------------+---------+------------+------+---------------+-------+---------+-------+------+----------+-------+
| id | select_type | table   | partitions | type | possible_keys | key   | key_len | ref   | rows | filtered | Extra |
+----+-------------+---------+------------+------+---------------+-------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | testlen | NULL       | ref  | name2         | name2 | 43      | const |    1 |   100.00 | NULL  |
+----+-------------+---------+------------+------+---------------+-------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)
对于utf8mb4编码的来说,允许为null的varchar(10) 最终长度=10*4+2+1 = 43。
ref
这一列显示了在key列记录的索引中,表查找值所用到的列或常量。
mysql> explain select * from user where id=1;
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref   | rows | filtered | Extra |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | user  | NULL       | const | PRIMARY       | PRIMARY | 4       | const |    1 |   100.00 | NULL  |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.01 sec)
where 条件是
id=1,那么对应的ref列就是常量const。
mysql> explain select * from user a left join user_info b on a.id=b.user_id;
+----+-------------+-------+------------+--------+---------------+---------+---------+-----------+------+----------+-------------+
| id | select_type | table | partitions | type   | possible_keys | key     | key_len | ref       | rows | filtered | Extra       |
+----+-------------+-------+------------+--------+---------------+---------+---------+-----------+------+----------+-------------+
|  1 | SIMPLE      | a     | NULL       | index  | NULL          | name    | 1023    | NULL      |    1 |   100.00 | Using index |
|  1 | SIMPLE      | b     | NULL       | eq_ref | user_id       | user_id | 4       | test.a.id |    1 |   100.00 | NULL        |
+----+-------------+-------+------------+--------+---------------+---------+---------+-----------+------+----------+-------------+
2 rows in set, 1 warning (0.02 sec)
user_info关联user表,关联的条件是user.id,故
ref=test.a.id(test是库名)
rows
扫描出的行数,这个是个估算的值,并不是真正的结果集
filtered
filtered表示返回结果的行数占需读取行数的百分比,filtered列的值依赖于统计信息。
extra
一些额外的信息,主要说明如何找到数据的。
using index
使用覆盖索引的时候就会出现,只查找索引列的值。
mysql> explain select user_id from user_info;
+----+-------------+-----------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
| id | select_type | table     | partitions | type  | possible_keys | key     | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-----------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | user_info | NULL       | index | NULL          | user_id | 4       | NULL |    2 |   100.00 | Using index |
+----+-------------+-----------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
using where
MYSQL服务器层将在存储引擎层返回行以后再应用WHERE过滤条件,一般发生在不能走索引扫描的情况下或者走索引扫描,但是有些查询列不在索引当中的情况下。
mysql> explain select * from user_info where user_id>10;
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+-------------+
| id | select_type | table     | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra       |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+-------------+
|  1 | SIMPLE      | user_info | NULL       | ALL  | user_id       | NULL | NULL    | NULL | 100100 |    50.00 | Using where |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+-------------+
1 row in set, 1 warning (0.01 sec)
Using temporary
对于一些order by、group by可能会用到临时表。
mysql> explain select * from user a left join user_info b on a.id=b.user_id where a.id>=1 order by b.user_id;
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+----------------------------------------------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref       | rows | filtered | Extra                                        |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+----------------------------------------------+
|  1 | SIMPLE      | a     | NULL       | range | PRIMARY       | PRIMARY | 8       | NULL      | 5187 |   100.00 | Using where; Using temporary; Using filesort |
|  1 | SIMPLE      | b     | NULL       | ref   | user_id       | user_id | 9       | test.a.id |    1 |   100.00 | Using where                                  |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+------+----------+----------------------------------------------+
2 rows in set, 1 warning (0.01 sec)
Using filesort
一般order by相关的没用到索引,就要文件排序。
mysql> explain select * from user_info order by age desc;
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
| id | select_type | table     | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra          |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
|  1 | SIMPLE      | user_info | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 100100 |   100.00 | Using filesort |
+----+-------------+-----------+------------+------+---------------+------+---------+------+--------+----------+----------------+
Using index condition
相比using where,Using index condition把where条件用到的索引放在引擎层过滤一下,没用到索引的列,在server层再过滤一遍。
mysql> explain select * from user a left join user_info b on a.id=b.user_id where b.user_id>1;
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+-------+----------+-----------------------+
| id | select_type | table | partitions | type  | possible_keys | key     | key_len | ref       | rows  | filtered | Extra                 |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+-------+----------+-----------------------+
|  1 | SIMPLE      | a     | NULL       | index | PRIMARY       | name    | 402     | NULL      | 10375 |   100.00 | Using index           |
|  1 | SIMPLE      | b     | NULL       | ref   | user_id       | user_id | 9       | test.a.id |     1 |   100.00 | Using index condition |
+----+-------------+-------+------------+-------+---------------+---------+---------+-----------+-------+----------+-----------------------+
2 rows in set, 1 warning (0.00 sec)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70000438/viewspace-2780303/ ,如需转载,请注明出处,否则将追究法律责任。

