TDengine 在智慧矿山系统中的应用
公司简介
元智信息是国内领先的露天矿业项目管理咨询和技术方案提供商。元智公司为全国范围内的工矿企业提供一站式的技术支持服务, 包括可行性研究分析、矿山规划与调度、生产评估、生产优化、业务系统整合、系统集成和软件开发等专项服务。
行业背景
智慧矿山是以矿山数字化、信息化为前提和基础,对矿山生产、职业健康与安全、技术支持与后勤保障等各方面进行主动感知、自动分析和快速处理。建设智慧矿山,首先以建设和实现矿山在生产、安全、经营与管理等环节的信息化为前提,最终实现"矿山一张图"的系统管理目标,开启矿山“透明+智能+管控”的安全生产新模式。
使用场景介绍
数据类型
采:露天矿山采掘设备,超大型电铲与液压铲。矿山中利用采掘设备进行矿产资源以及覆盖物的挖掘工作,在实际应用中,需要采集和监控各个采掘设备的信息,如设备运行参数(像电压和电流等)和位置信息。 运:主要是运输环节。在采煤的过程中,需要对大量的剥离物(如表土和岩石)进行排弃,将原煤运输到煤仓、破碎站以及选煤厂。在此过程中,需要通过安全合理的调度来实现矿产附属物及矿品的运输。因此,我们会实时采集卡车运输设备位置信息、胎压、油耗等信息,以保障安全调度。 排:排土工作系指从露天采场将剥离覆盖在矿床上部及其周围的大量表土和岩石,运送到专门设置的场地如(排土场)。主要通过卡车运输来实现。即煤炭开采剥离过程中产生的渣土剥离后通过运输系统排出生产作业区,排土过程中合理规划以达到露天煤矿生态环保过程中的环保作业要求。
数据量级
一般大规模的矿山车辆数量,往往超过 800 台。如果是整个集团级别的应用,卡车数量可达 3000 ~ 7000 台。
以目前的安全生产要求,卡车的采集频率是 5 ~ 10 秒,在有更高要求的场景中,需要采用更高的频率,采集的数据内容包括卡车 GPS 定位数据、油耗数据、胎压数据以及卡车的速度信息。
以 800 台设备估算,采集频率 5 秒,一天 24 小时会产出大概 1000 多万条数据。这个数据量相对于传统的数据存储是个比较大的量级。
数据应用
在实际的应用场景中,对车辆的数据应用,其中一个主要维度就是车辆轨迹,特别是车辆的实时位置必须满足矿山生产的车辆调度实时需求。
选型对比
MySQL
MySQL 是我们团队在各种应用开发领域使用最多的数据库,从复用技术经验的角度上考虑,最初考虑过 MySQL 的可行性。但是在经过分析和验证后,我们就排除了使用关系型数据库的方案。主要原因如下:
存储压力:在最初使用 MySQL 的论证分析中,由于在 MySQL 中的 InnoDB 存储引擎最小存储单元页的大小是 16 kb 左右, 而 MySQL 以页为基础的查询数据加载时,数据的加载量会带来极大的系统负担。并且,MySQL 作为关系型数据库,采用的是 B+ 树存储结构,初步估算,深度为 3 的 B+ 树预计能支撑 2000 万条左右的数据,这个数据量级是远远满足不了我们的业务场景的。 性能存在瓶颈:在实际验证中,伴随着数据量的增加,MySQL 性能急剧下降。
InfluxDB
其次,我们进行了 InfluxDB 的调研。验证的初级阶段,从查询效率的 QPS 维度看,InfluxDB 的查询问题不大,效率可以满足。但是,在测试智慧矿山的物联网模型查询时,很快遇到了 InfluxDB 对于此类查询实时效率低下的问题,而且设计复杂度也很高。在 1000 台设备的情况下,需要查所有设备的平均速度,查询实时性要求高。
但 InfluxDB 没有明确的基于设备的建表方式,如果用一张表存所有设备数据,数据量就会很大,查询性能也会下降。比较明显的是,在百万数据量级以内,这种建表方式查询时间在 1 秒左右,而当数据到了千万量级的时候,查询效率下降十分明显。
在我们真实的智慧矿山中、所有设备产生的数据量级条件下,这个查询效率的下降是明显不符合我们要求的。
TDengine
技术成本低:网上学习资料多,而且 TDengine 具有安装方便、对运维要求低、支持 SQL 所以学习成本低等特性,极大缩短了项目研发周期和开发难度。 数据模型契合:TDengine 与智慧矿山比较契合的是, TDengine 有一个超级表概念,其超级表类似于物联网的物模型,子表类似于具体设备。这一数据模型与智慧矿山的业务系统也比较吻合。 国产化:目前在矿山应用方面,对国产化要求是很高的。让我们比较欣喜的是,即使在非国产化产品的对比中,TDengine 的读写速度和压缩率也是比较领先的。
性能表现
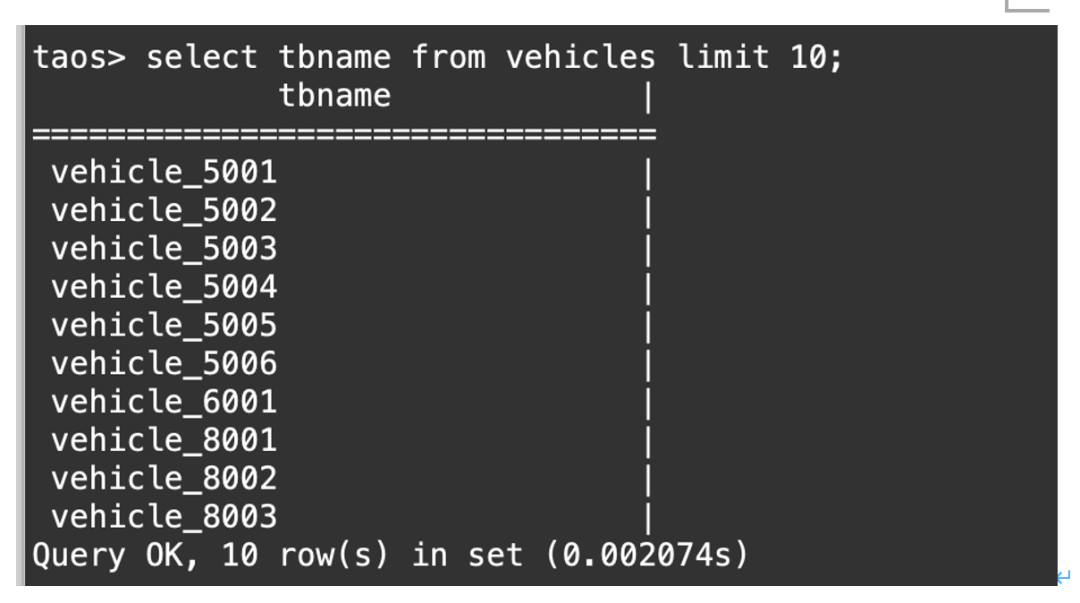
我们以智慧矿山业务中的 5000 设备、每天 1000 万采集点的数据量级下,在以车建模和以位置建模结合的数据模型下,TDengine 的性能远没有达到极限,目前系统对于车和位置的查询速度都在毫秒级。
方案落地
建模思路
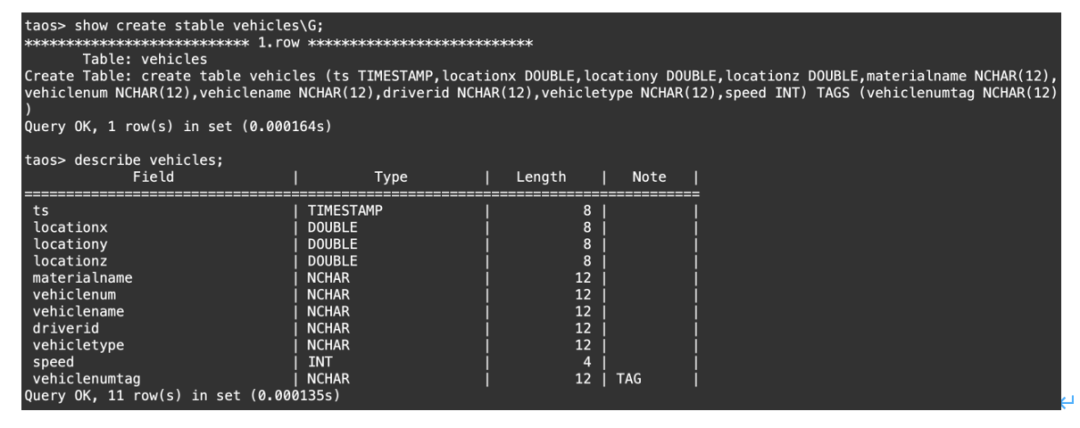
在智慧矿山的实际应用场景中,模型是一个关键设计,在我们使用 TDengine 的查询场景中,数据模型的设计跟查询是关联在一起的。
以车建模:这种建模以车为目标统计,可以很好地解决系统中涉及车和各种设备的运行情况的统计查询问题。
以位置建模:采用了基于固定位置建模的方式。以工艺和流程位置建模,可以解决设备经过某些点的统计问题,查询效率明显提高。
方案创新
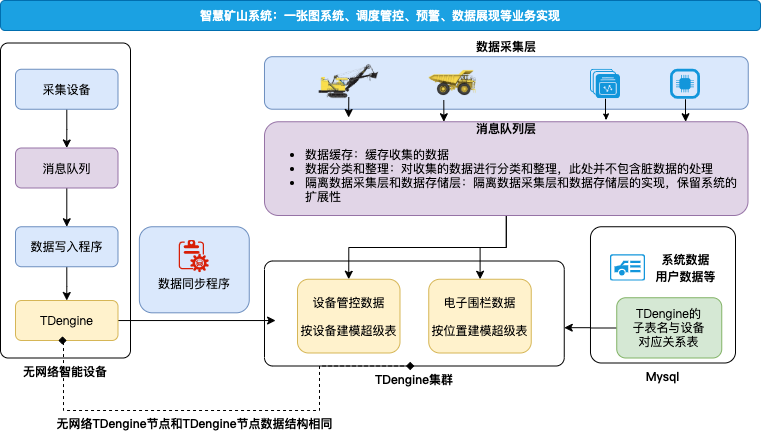
在涛思数据的工程师的建议下,我们在 MySQL 数据库里把所有的设备表的名字(TDengine 中的 tbname)进行了存储。我们在去 TDengine 中进行设备查询的时候,子表名从关系数据库中直接读取,然后在 TDengine 中针对子表进行查询。这个设计,在系统中针对单个设备进行快速数据回放的时候,也明显提高了查询效率。
技术架构图
最终效果展示
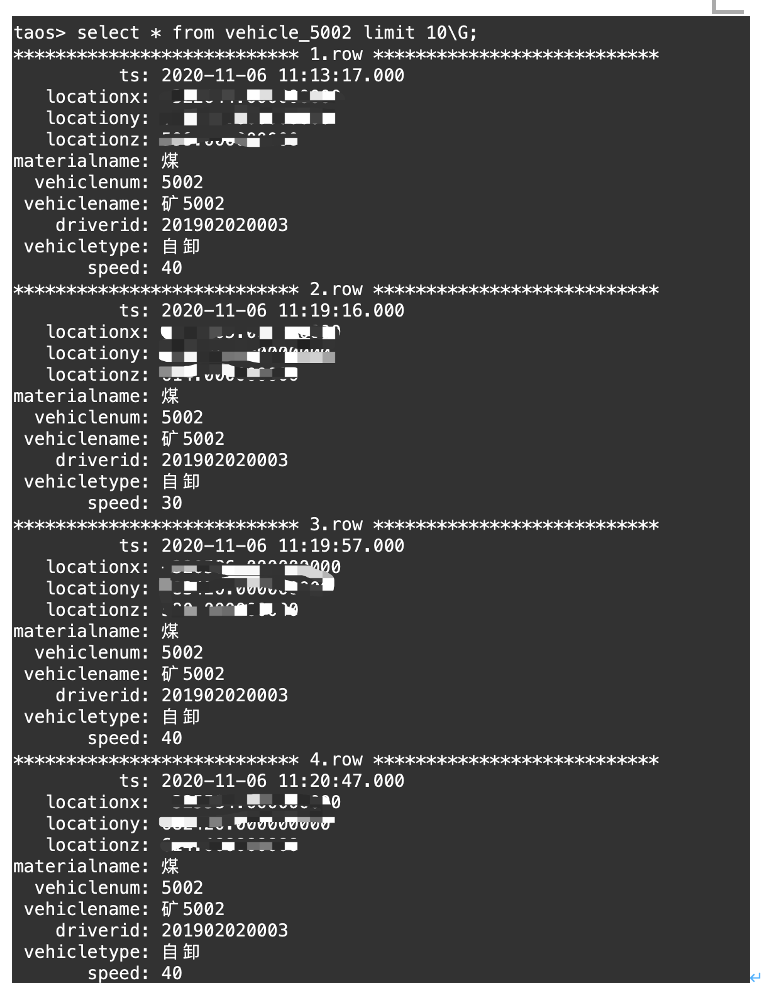
目前,像我们的智慧矿山系统中,TDengine 的应用查询用于监控性能指标,主要查询内容:
位置信息:位置信息包括系统中每一个车辆,或者对每一个现场的坐标位置,以及现场的电子围栏的位置信息等。 车辆速度:矿山的安全生产作业对卡车驾驶速度作出限制,速度不能超过 40 km/h,超速数据需要实时提醒,对超速车辆进行确认并响应。
写在最后
对 TDengine 的长远规划
环保监测:矿山对环保的要求越来越高,主要集中在环保监测这部分业务。一般情况下,整个矿山基本上是 30 台到 50 台环保监测设备。这部分数据数据更新频率不是太大,采集频率 20 秒即可,数据量很适合用 TDengine 来进行处理。
生产集控设备:TDengine 的数据模型比较适合做这部分业务。传统意义上,在整个生产集控设备上,控制设备都是使用实时数据库来存储的。时间序列属性也比较适合时序数据的特征——查询为主,更新和删除很少。TDengine 对时序数据的查询优势,可以在卡车调度系统中更快的对设备进行调度。我们正在调研 TDengine 中的数据订阅,这种方式应该可以很好地适配这些场景。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3160119/ ,如需转载,请注明出处,否则将追究法律责任。

