Presto 多主问题探索
Presto 采用 "主从 (master-slave)" 架构设计, 主节点称为 Coordinator, 从节点称为 Worker. Coordinator 接收用户提交的查询请求, 将查询分解为若干分布式任务, 并调度这些任务在 Worker 上的执行.
一直以来, Presto 主节点 Coordinator 只能单实例部署, 这存在以下问题:
- 可用性: Coordinator 是服务入口, 当它故障时, 整个集群将不可用;
- 可伸缩性: Coordinator 承担太多职责, 随着 Worker 增加和作业请求量增加, Coordiantor 负荷持续增加, 终将成为整个集群的性能瓶颈.
可以通过把一个集群拆分为两个集群来应对上述两个问题: 两个集群之间互备提升可用性, 拆分工作负载和集群容量来缓解每个 Coordinator 的工作负荷. 但拆集群的做法有以下不足: (1) 单集群能力受限, 不能承接更大的查询请求 (需要 50%+ 原集群资源的查询将无法执行); (2) 集群数量增加, 运维成本随之增加; (3) 集群拆分也存在一定的资源浪费 (为了稳定性, 集群资源会留一定 buffer, 拆成两个集群, 就有了两倍 buffer).
为此, 需要探索如何支持 Presto 多主节点部署. 在分布式系统中, 如果一个组件难以水平拓展, 很可能是因为它是有状态的. Presto Coordinator 也是如此, 它维护的状态包括:
- Worker 列表: Coordinator 在调度任务时依赖它来为每个任务分配节点;
- 查询列表: Coordinator 依赖它来做查询管理, 比如限制集群最大并发数和排队数等;
- 资源组统计: Coordinator 依赖它来支持多租户, 比如限制某个资源组所有查询的最大内存使用量等;
有状态服务如何水平拓展? 最简单的做法是把卸载 (unloading), 比如把状态转移给外部存储. 另一种做法是切片 (sharding), 每个服务实例负责一部分状态, 服务消费方通过一定方法 (例如一致性哈希) 去访问特定的实例. 还有一种做法是共享 (sharing), 每个实例都维护全部状态, 并通过一些机制通过同步每个实例上发生的状态变更.
对于 Presto 多主问题. 状态卸载的做法的代码改动量大, 实现成本比较高; 而且在系统中引入新的重量级组件或依赖, 架构复杂度上升. (Presto 社区解决多主问题的基本思路便是这个, 目前进展缓慢.) 状态切片的做法不适合本问题, 因为上述状态在使用时都需要是集群全局状态. 状态共享的做法的难点在于状态变更同步如何权衡性能和一致性.
结合实际使用场景, Worker 列表和查询列表以及资源组统计, 这三类状态信息能容忍一定程度的不一致, 且不影响查询的正常执行,. 因此, 我们采用的是弱一致性状态共享的做法. 每个 Coordinator 实例状态处理逻辑如下 (相关类名仅作示意, 不一定和源码中的类名一致):
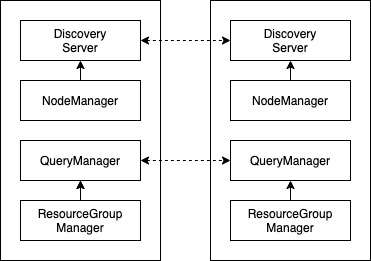
- Worker 列表. 常规部署方式下, Coordinator 启动内置的 DiscoveryServer 功能组件 (详见 airlift), Worker 通过配置的 Coordinator 服务地址把自己注册到 DiscoveryServer. 通过配置合适的
service-inventory.uri, 多个 DiscoveryServer 实例可以组成服务集群, 每个实例通过复制与合并其他实例状态来同步集群状态. Worker 只要向其中任意一个 DiscoveryServer 实例注册, 所有DiscoveryServer 最终都能感知到. 于是, Coordinator 节点管理节点的组件 NodeManager 就能通过 DiscoveryServer 获取到全部 Worker 列表. - Query 列表. 类似 DiscoveryServer 的状态同步机制, 每个 Coordinator 定时抓取其他 Coordiantor 的 Query 列表并与自己本地的 Query 列表合并, 就能获得集群的全局 Query 列表视图.
- 资源组统计. 资源组统计本质是 Query 若干具体属性的统计, 因此可以 "借道" (Piggybacking) Query 列表同步过程, 把需要的字段塞进 Query 同步消息中, 再合并本地 Query 列表的资源组统计信息, 便最终建立全局资源组统计视图.
显然, 通过上述方式获得的全局状态是弱一致的 (最终一致), 因此查询并发控制等功能在某些条件下可能损失一定的精度. 不过这对于我们来说是可以接受的. 基于负载特征和架构模式的考虑, 在实现中(暂时)也没有特别考虑如何处理作业排队的问题.
以上内容给出了多主架构的一种思路, 在实际开发过程中, 有不少细节需要注意. 例如 API 协议的适配. Presto Coordinator 和 Client 之间的会话是通过 HTTP 短链接建立. 使用域名访问时, 多主模式下需要进行一定的改造: (a) 如果没有防火墙限制的话, 可以把 Coordinator 返回 nextUrl 中的域名改成 Coordiantor 实例 IP; (b) 否则, 可以让收到请求的 Coordinator 做个判断, 如果是不是自己调度中的查询, 就反向代理给实际调度该查询的 Coordinator 实例. 其他暴露集群状态信息的 REST API 接口也需要进行相应修改. 小提示: 通过灵活使用 javax.servlet.Filter 等接口, 可以有效复用现有代码, 同时减少代码侵入. 更多细枝末节, 篇幅所限, 就不再赘述了.
来源 https://zhuanlan.zhihu.com/p/432905886
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3150058/ ,如需转载,请注明出处,否则将追究法律责任。

