如何在BigQueryML中使用K-均值聚类来更好地理解和描述数据
目前,BigQueryML支持无监督学习-可以利用K均值算法对数据进行分组。与预测分析的有监督的机器学习不同,无监督学习侧重于描述性分析-在理解数据的基础之上做出数据驱动的决策。
聚类什么内容?
首先,需要确定聚类的内容,为什么要这样做?假设你是一个拥有客户交易数据的零售商,有多种方法可以对此数据集进行聚类,这取决于你想要对聚类做什么操作。
- 可以将顾客定义为自然群体,这就是所谓的客户细分。用于客户细分的数据可能包括客户访问的商店、他们购买的商品、支付的费用等等。首先将尝试了解这些客户组的喜好(这些人称为人物角色),这样便可以设计出针对其中一个组的成员有吸引力的项目。
- 也可以将购买的物品定义为自然群体,这可以称为产品组。可以根据购买对象、购买时间、购买地点等对项目进行聚类。同时可以尝试学习产品组的特征,以便学习如何减少调拨或改进交叉销售。
这两种情况下,均使用聚类作为一种启发式方法来帮助做出决策-设计个性化产品或理解产品交互并不容易,可以从客户组或产品项目组两种维度进行设计。
请注意,对于产品推荐的特定用例(向客户推荐产品或特定产品的目标客户),最好使用WALS之类的协作方法训练ML模型来实现。但是对于其他没有现成的预测分析方法的决策,聚类会提供一种做出数据驱动决策的方法。
建立聚类问题
为更好地使用聚类,需要做以下四件事:
- 确定对哪些字段进行聚类。是客户ID?还是产品项目Id? 然后,将数据集中在该字段的属性上。
- 找出给定客户/项目/其他属于的哪个聚类。
- 理解聚类属性的内容。
- 利用这一理解做出决策。
在本文中,我将演示对伦敦自行车共享数据的聚类方法。假设我们围绕自行车共享站的设计和仓储做出很多决策,我们希望了解系统中的不同类型的站点,这样便可以数据驱动的方式做出这些决策。
需要做到以下四件事:
- 聚类自行车租赁站。我们需要聚类的字段是Station_name,为此还需要找到站点的属性。
- 找出每个站点属于哪个聚类。
- 理解每个聚类的特征。
- 利用这种理解来做出由数据驱动的决策。
在此之前,首先需要收集数据。
.收集数据
我们将用到的数据包括伦敦的自行车租赁,它是欧盟地区的公共数据集,因此,如果想要跟踪我的查询,应确保在欧盟地区创建一个名为demos_eu的数据集。
需要根据下面这些因子对车站进行聚类:
- ·租用时间
- ·每天出行次数
- ·自行车架数量
- ·距市中心的距离
我们通常需要做出一些决策,诸如:在工作日和周末不同的时间安排车站的存货(即确保车站有自行车出租)。为此,需要对这些实例进行聚类,其“主键”是Station_name和isworkday的组合。
以下是对收集到的相关数据的查询:
WITH hs AS (
SELECT
h.start_station_name as station_name,
IF(EXTRACT(DAYOFWEEK FROM h.start_date) = 1 OR
EXTRACT(DAYOFWEEK FROM h.start_date) = 7, "weekend", "weekday") as isweekday,
h.duration,
s.bikes_count,
ST_DISTANCE(ST_GEOGPOINT(s.longitude, s.latitude),
ST_GEOGPOINT(-0.1, 51.5))/1000 as distance_from_city_center
FROM `bigquery-public-data.london_bicycles.cycle_hire` as h
JOIN `bigquery-public-data.london_bicycles.cycle_stations` as s
ON h.start_station_id = s.id
WHERE h.start_date BETWEEN CAST('2015-01-01 00:00:00' AS TIMESTAMP) AND CAST('2016-01-01 00:00:00' AS TIMESTAMP)
),
stationstats AS (
SELECT
station_name,
isweekday,
AVG(duration) as duration,
COUNT(duration) as num_trips,
MAX(bikes_count) as bikes_count,
MAX(distance_from_city_center) as distance_from_city_center
FROM hs
GROUP BY station_name, isweekday
)
SELECT *
from stationstats
ORDER BY distance_from_city_center ASC
我们提取了2015年(见WHERE条款)的租用数据(Start_Station_name,周末/工作日,持续时间),并根据站点信息(自行车数量、距市中心的距离)加入该数据。
然后,贯通自行车计数、距市中心的距离等车站属性,计算出平均骑乘时间、出行次数等车站属性。数据集如下所示:
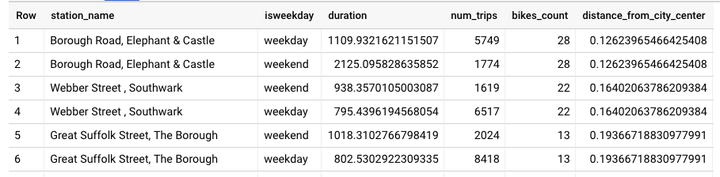
用于聚类的数据集;数据的主键是Station_name和isworkday的组合。
BigQueryML聚类
进行聚类时仅需向上述SELECT查询中添加一条CREATE MODEL语句,并删除数据中的“id”字段:
CREATE OR REPLACE MODEL demos_eu.london_station_clusters
OPTIONS(model_type='kmeans', num_clusters=4, standardize_features = true) AS
WITH hs AS (
SELECT
h.start_station_name as station_name,
IF(EXTRACT(DAYOFWEEK FROM h.start_date) = 1 OR
EXTRACT(DAYOFWEEK FROM h.start_date) = 7, "weekend", "weekday") as isweekday,
h.duration,
s.bikes_count,
ST_DISTANCE(ST_GEOGPOINT(s.longitude, s.latitude),
ST_GEOGPOINT(-0.1, 51.5))/1000 as distance_from_city_center
FROM `bigquery-public-data.london_bicycles.cycle_hire` as h
JOIN `bigquery-public-data.london_bicycles.cycle_stations` as s
ON h.start_station_id = s.id
WHERE h.start_date BETWEEN CAST('2015-01-01 00:00:00' AS TIMESTAMP) AND CAST('2016-01-01 00:00:00' AS TIMESTAMP)
),
stationstats AS (
SELECT
station_name,
isweekday,
AVG(duration) as duration,
COUNT(duration) as num_trips,
MAX(bikes_count) as bikes_count,
MAX(distance_from_city_center) as distance_from_city_center
FROM hs
GROUP BY station_name, isweekday
)
SELECT * except(station_name, isweekday)
from stationstats
此查询处理1.2GB,耗时54秒。模型中列出了聚类用到的4个因子:
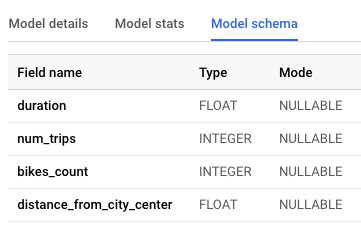
K-均值模型
请注意,在创建模型过程中指定了所需的聚类数量(num_clusters=4),并删除了不需要对其进行聚类的因子 (Station_name和isweekday)。如果特性有不同的动态范围(bikes_count在10-50范围内,而num_trips在数千个范围内),那么,标准化特性会是一个不错的选择,而我正在这样做的。
如果忽略聚类的数量,BigQueryML将根据训练数据集中的总行数选择一个合理的缺省值,还可以通过超参数调优来找到一个更优的数字。本质上,可以对num_clusters的不同值运行聚类,找出误差,并选择图形平稳的点。可以通过以下方法获得误差:
SELECT davies_bouldin_index
FROM ML.EVALUATE(MODEL demos_eu.london_station_clusters)
num_clusters数目越少,聚类越好。
车站属于哪个聚类?
特定的车站到底属于哪个聚类?利用ML.PREDICT便可以找到答案。以下便是对名称中包含“Kenningtons”的站点的聚类的查询:
WITH hs AS ...,
stationstats AS ...,
SELECT * except(nearest_centroids_distance)
FROM ML.PREDICT(MODEL demos_eu.london_station_clusters,
(SELECT * FROM stationstats WHERE REGEXP_CONTAINS(station_name, 'Kennington')))
输出是:
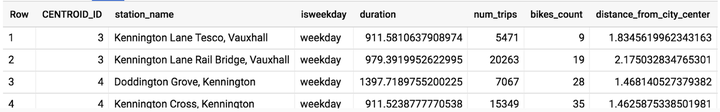
肯宁顿站(Kennington)属于哪个聚类?
检查聚类
可以使用以下方法查看聚类图心-基本上是模型中4个因子的值:
SELECT * FROM ML.CENTROIDS(MODEL demos_eu.london_station_clusters)
ORDER BY centroid_id
只要稍微做一点SQL操作,便可以获得上表的主元:
WITH T AS (
SELECT
centroid_id,
ARRAY_AGG(STRUCT(numerical_feature AS name, ROUND(feature_value,1) AS value) ORDER BY centroid_id) AS cluster
FROM ML.CENTROIDS(MODEL demos_eu.london_station_clusters)
GROUP BY centroid_id
)
SELECT
CONCAT('Cluster#', CAST(centroid_id AS STRING)) AS centroid,
(SELECT value from unnest(cluster) WHERE name = 'duration') AS duration,
(SELECT value from unnest(cluster) WHERE name = 'num_trips') AS num_trips,
(SELECT value from unnest(cluster) WHERE name = 'bikes_count') AS bikes_count,
(SELECT value from unnest(cluster) WHERE name = 'distance_from_city_center') AS distance_from_city_center
FROM T
ORDER BY centroid_id ASC
输出是:
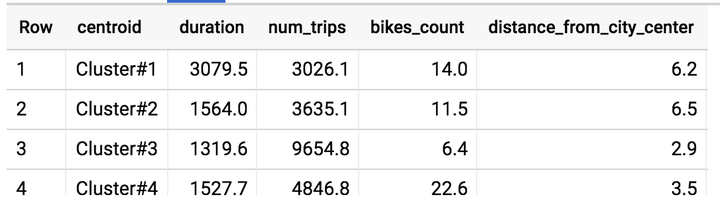
聚类属性
若要可视化此表,单击“在DataStudio中导出”并选择“条状表”。将质心列设为“度量”,其余列为尺寸。然后会得到:
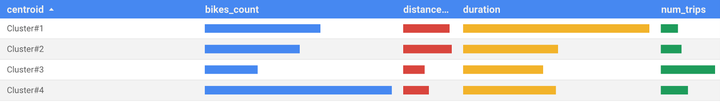
在DataStudio中可视化后的聚类属性
这样,便能够解释这些聚类了。从本质上说,第一组由郊外车站组成,人们可以在其中长途旅行;第二组由其他郊区车站组成;第三组由繁忙的城市站组成;第四组由不那么繁忙的城市站组成。
根据这些特性和对伦敦的一些了解,可以给出这些聚类的描述性名称。第一组可能是“日间旅行”, 第二组是“卧室社区”, 第三组是“旅游区”, 第四组是“商业区”。
做出由数据驱动的决策
利用这些聚类做出不同的决策。
- 如果刚刚获得资金,可以扩建自行车架,那应该增加哪些车站的容量?在没有聚类数据的情况下,我们或许会倾向于使用第三组中有很多次行程而没有足够的自行车的站点。但是做了聚类之后,发现这组站主要为游客服务,他们没有投票权,所以我们会把额外的容量放在第二组(卧室社区)。
- 如果需要试验一种新型锁,应该在哪一组车站上做这个实验?商业区的车站似乎更合乎逻辑的,当然,这些车站有很多自行车,而且非常繁忙,足以支持A/B测试。
- 如果需要储备一些有赛车的车站。哪一个?当然是第一组,服务于每天往返于城市的人。
显然,虽然可以通过自定义数据分析来单独做出这些决策,但是,将站点进行聚类分析,提出描述性的名称,并使用这些名称来做出决策,要简单得多,也更容易解释。
来源 https://zhuanlan.zhihu.com/p/62804396
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3142841/ ,如需转载,请注明出处,否则将追究法律责任。

