BigQuery:如何查询数据
在之前的BigQuery教程中,我们介绍了BigQuery体系结构,存储管理,以及将数据提取到BigQuery中。在本文中,我们将介绍使用SQL在BigQuery中查询数据,保存和共享查询,创建视图和实例化视图。
标准SQL
BigQuery支持两种SQL方言:标准SQL和旧式SQL。标准SQL是查询BigQuery中存储的数据的首选,因为它符合ANSI SQL 2011标准。与旧版SQL相比,它还有其他优点,例如JOIN操作的自动谓词下推以及对相关子查询的支持。有关更多信息,请参见标准SQL优点。
在BigQuery中运行SQL查询时,它会自动创建,安排和运行查询作业。BigQuery以两种模式运行查询作业: 交互(默认)和批量。
- 交互式查询将尽快执行,并且这些查询将计入并发速率限制和每日限制。
- 只要BigQuery共享资源池中有可用的空闲资源,批处理查询就会排队并开始,这通常在几分钟之内发生。如果BigQuery在24小时内仍未启动查询,则作业优先级将更改为“交互式”。批量查询不计入您的并发速率限制。它们使用与交互式查询相同的资源。
除非另有说明,否则本文中的查询均遵循标准SQL方言并以交互模式运行。
BigQuery表类型
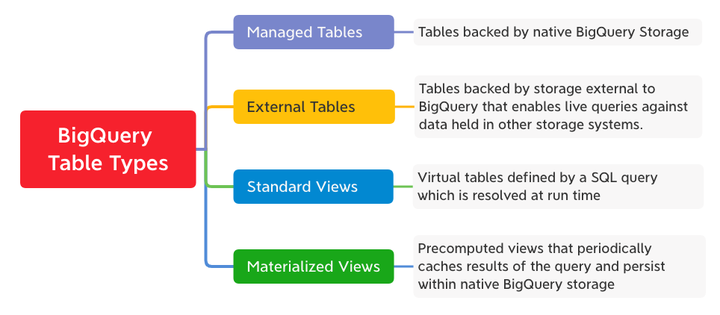
BigQuery中的每个表格均由列名称,数据类型和其他元数据定义。BigQuery支持以下表格类型:
BigQuery架构
在BigQuery中,架构是在表级别定义的,并为数据提供结构。架构描述列定义及其名称,数据类型,描述和模式。
- 数据类型可以是简单的数据类型(例如整数),也可以是更复杂的数据类型,例如
ARRAY和STRUCT - 列模式可以为
NULLABLE,REQUIRED或REPEATED。
在将数据加载到表中或创建空表时,可以指定表架构。或者,在加载数据时,您可以使用自动检测来识别源数据格式,也可以在JSON文件中定义架构,如图所示。
[
 {
   "description": "[DESCRIPTION]",
   "name": "[NAME]",
   "type": "[TYPE]",
   "mode": "[MODE]"
 },
 {
   "description": "[DESCRIPTION]",
   "name": "[NAME]",
   "type": "[TYPE]",
   "mode": "[MODE]"
 }
]
使用SQL进行分析
现在,让我们分析与NCAA篮球比赛相关的公共BigQuery数据集。比赛数据涵盖了从2009年至今的每场比赛得分。我们将查看2014赛季肯塔基州野猫队和巴黎圣母院爱尔兰人之间的特定比赛。
在BigQuery控制台中,搜索NCAA Basketball数据集,点击“查看数据集”按钮,然后在BigQuery Web UI中打开数据集。
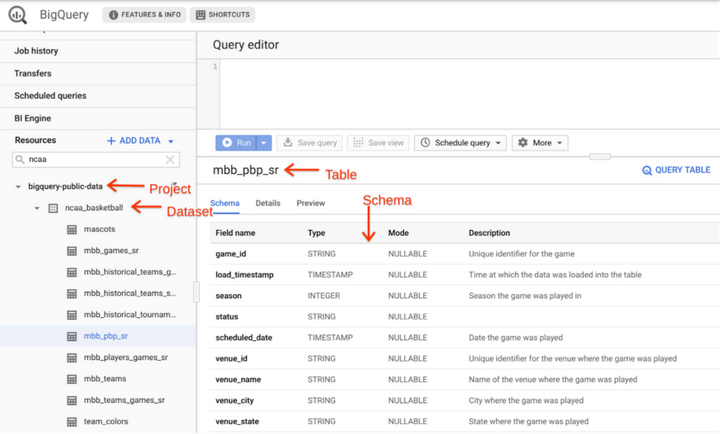
导航到ncaa_basketball数据集下的mbb_pbp_sr ,查看模式。该表具有2013-2014赛季所有男篮比赛的逐项比赛信息,该表中的每一行代表一场比赛中的单个事件。
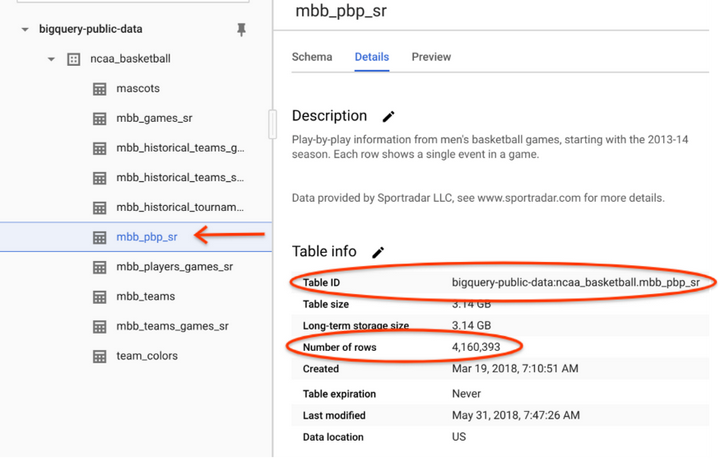
mbb_pbp_sr表详情页面显示,表包含约400万个比赛事件,总容量约为3GB。
让我们运行一个查询来过滤我们感兴趣的比赛事件。该查询从mbb_pbp_sr表中选择以下列:
game_clock:比赛剩余时间points_scored:得分team_name:得分的球队名称event_description:有关事件的描述timestamp:事件发生的时间
SELECT
  game_clock,
  points_scored,
  team_name,
  event_description
FROM
  `bigquery-public-data.ncaa_basketball.mbb_pbp_sr`
WHERE
  season = 2014
  AND home_name = 'Wildcats'
  AND away_name = 'Fighting Irish'
  AND points_scored IS NOT NULL
ORDER BY
  timestamp DESC
LIMIT 10;
查询结果如下:
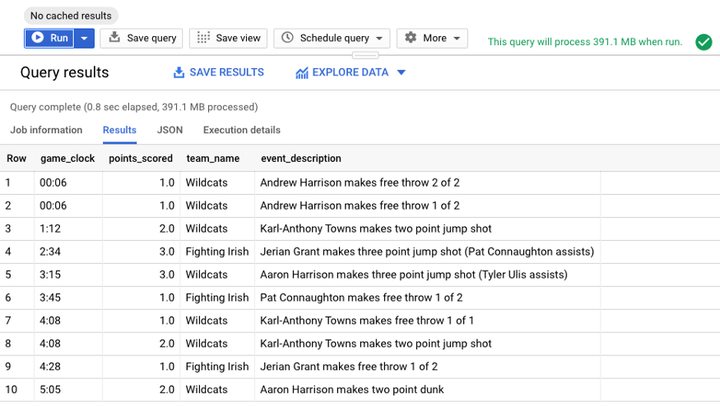
从结果看,球员安德鲁·哈里森(Andrew Harrison)罚球两次,得到2分,比赛还剩6秒。除了在比赛结束时获得分数以外,这并不能告诉我们太多。
提示:避免在查询中SELECT * ,而是仅查询所需的列。
让我们使用分析函数修改查询,获取截止至到比赛结束前每只队伍的累计得分。
SELECT
  game_clock,
  SUM(
    CASE
      WHEN team_name = 'Wildcats' THEN points_scored
    END
  ) OVER(ORDER BY timestamp ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS wildcats_score,
  SUM(
    CASE
      WHEN team_name = 'Fighting Irish' THEN points_scored
    END
  ) OVER(ORDER BY timestamp ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS fighting_irish_score,
  team_name,
  event_description
FROM
  `bigquery-public-data.ncaa_basketball.mbb_pbp_sr`
WHERE
  season = 2014
  AND home_name = 'Wildcats'
  AND away_name = 'Fighting Irish'
  AND points_scored IS NOT NULL
ORDER BY
  timestamp DESC
LIMIT 10;
查询结果如下:
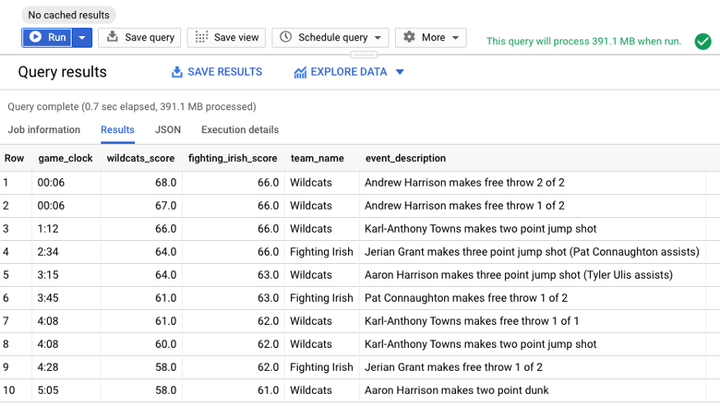
我们可以看到比赛是如何结束的,比赛还剩04:28时,爱尔兰格斗队以4分优势领先,随后野猫队的Karl-Anthony Towns在最后的01:12扳平比分,而安德鲁·哈里森在终场前6秒罚中两球,为野猫队的获胜奠定基础。这的确是一个振奋人心的结局。
如图所示,除了聚合和分析函数外,BigQuery还支持函数和运算符,例如字符串操作,日期/时间,数学函数,JSON提取等。
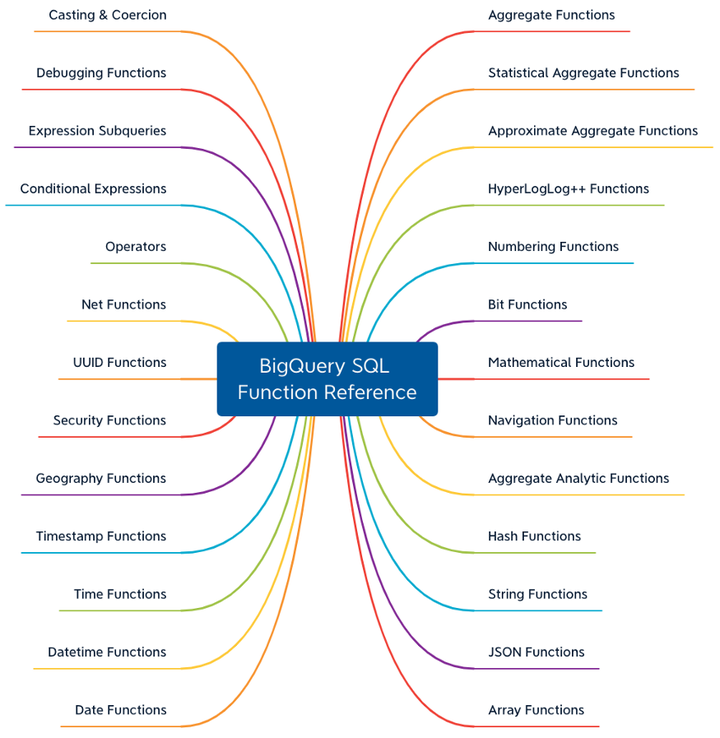
有关函数的完整列表,可以参阅BigQuery SQL函数。
BigQuery SQL查询的生命周期
在后台运行SQL查询时,它会执行以下操作:
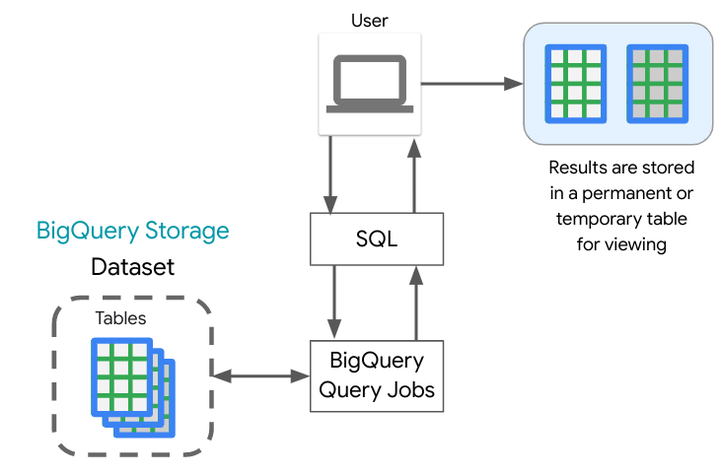
- QueryJob提交到BigQuery服务,如BigQuery体系结构中所述,BigQuery计算与BigQuery存储是分离的,它们被设计为一起工作以组织数据以提高对庞大数据集的查询效率。
- 每个执行的查询都分为几个阶段,然后由工作程序(插槽)进行处理,并写回到Shuffle中。 Shuffle提供了对工作人员自身内部故障的恢复能力,例如,工作人员在查询处理期间会遇到问题。
BigQuery SQL查询的生命周期 * BigQuery引擎利用BigQuery的列存储格式来仅扫描运行查询所需的列。控制成本的最佳实践之一是仅查询所需的列。 * 查询执行完成后,查询服务会将结果保存到临时表中,然后Web UI会显示该数据。您还可以请求将结果写入永久表。
保存和共享查询
保存查询
既然您已经运行了SQL查询来执行分析,那么如何保存这些结果? BigQuery将所有查询结果写入表。用户将该表明确标识为目标表或临时缓存的结果表。该临时表将存储24小时,因此,如果您再次运行完全相同的查询(完全匹配字符串),并且结果不会有所不同,则BigQuery只会返回指向缓存结果的指针。可以从缓存中提供的查询不会产生任何费用。
您可以从BigQuery UI的“查询历史记录”选项卡中查看缓存的查询结果。此历史记录包括您向服务提交的所有查询,而不仅仅是通过Web UI提交的查询。
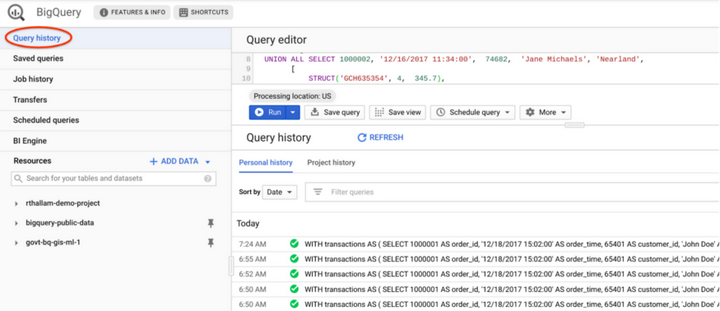
执行查询时,可以从查询设置中禁用检索缓存的结果。这需要BigQuery计算查询结果,这将导致查询产生费用。这通常用于基准测试方案中,例如在上一篇文章中比较了分区表和群集表与未分区表的性能。
您还可以请求将查询写入目标表。您可以控制何时删除表。由于目标表是永久性的,因此需要为存储结果付费。
共享查询
BigQuery允许您与他人共享查询。保存查询时,查询可以是私有的(仅对您可见),在项目级别共享(对项目成员可见)或公共(任何人都可以查看)。
标准视图
视图是由SQL查询定义的虚拟表。视图的属性类似于表,可以作为表查询。视图的架构是运行查询所产生的架构。该视图的查询结果仅包含来自定义该视图的查询中指定的表和字段的数据。
你可以通过使用“保存视图”按钮或使用BigQuery的DDL创建视图。将查询另存为视图不会保留结果,除了将数据缓存到临时表(该表在24小时窗口内到期)之外。该行为类似于在表上执行的查询。
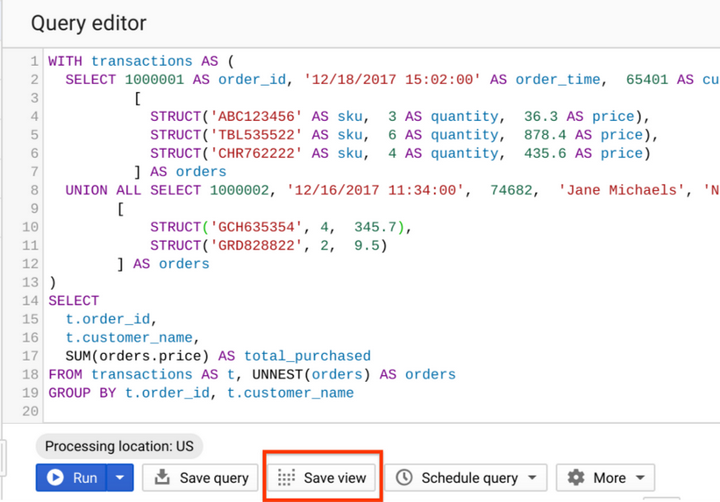
何时使用标准视图?
- 假设您要向用户公开具有复杂逻辑的查询,并且希望避免用户记住所有逻辑,那么可以将这些查询滚动到视图中。
- 另一个用例是可以将视图放入数据集中,并提供细粒度的访问控制,以与特定用户和组共享数据集,而无需授予他们访问基础表的权限。这些视图称为授权视图。在以后的文章中,我们将详细研究如何保护和访问数据集。
物化视图
BigQuery支持实体化视图(Materialized Views)。MV是预先计算的视图,可定期缓存查询结果以提高性能和效率。与仅从基表检索相同数据的查询相比,使用MV的查询通常更快,消耗的资源更少。通过常见和重复的查询,它们可以显着提高工作负载的性能。
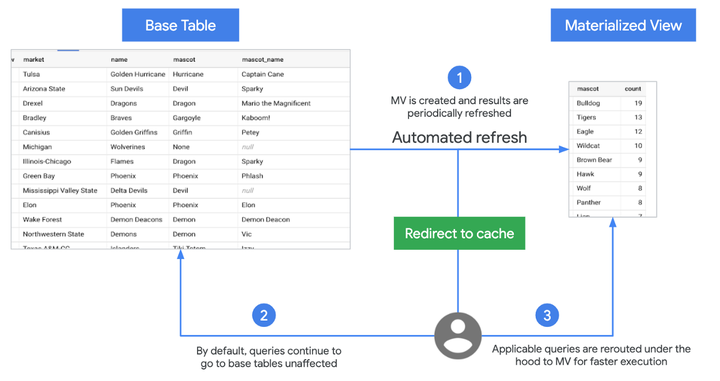
以下是实例化视图的主要功能:
零维护
BigQuery利用MV预先计算的结果,并尽可能从基表中读取增量变化以计算最新结果。它会自动将数据刷新与基表中的数据更改同步,无需用户输入。您还可以选择触发手动刷新视图以控制刷新作业的成本。
自动更新
MV始终与源表一致,可以直接查询它们,也可以由BigQuery优化器使用它们来处理对基表的查询。
智能调优
MV支持查询重写。如果可以通过查询MV来解决针对源表的查询,则BigQuery会将查询重写(重新路由)到MV,以提高性能和/或效率。
何时使用物化视图?
- MV适用于需要查询最新数据,同时通过重用先前计算的结果来减少延迟和成本的情况。 MV充当伪索引 ,可在不更新任何现有工作流程的情况下加速对基表的查询。
物化视图的局限性
- 在撰写本文时,MV还不支持合并(joins)。但是,您可以在查询中利用MV进行查询,该查询在合并(joins)之上进行聚合,这减少了查询的成本和等待时间。
- MV支持一组有限的聚合函数和受限制的SQL。
接下来是什么?
在本文中,我们回顾了BigQuery中SQL查询的生命周期,使用窗口函数,创建标准视图和实例化视图,保存和共享查询。
参考
Codelab
- 使用该代码示例来查询基于Github档案的大型公共数据集。
- 来源
https://zhuanlan.zhihu.com/p/366532868
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3138484/ ,如需转载,请注明出处,否则将追究法律责任。

