TDEngine 数据库实现解析
TDEngine 是一款开源的时序数据库引擎,针对物联网业务场景优化,适合存储物联网设备持续产生的大量时序指标;本文基于 TDEngine Server 1.6.5 版本源码实现,分析 TDEngine 单机存储的实现原理。
TDEngine 组件
taosd:TDEngine Server 服务程序,主要有 MGMT 元数据管理、DNODE 数据管理2个模块组成。- MGMT 模块维护 TDEngine Database、Table、User、Vnode 等元数据信息
- DNODE 模块实现数据存储、访问逻辑,DNODE 有多个 vnode 组成,每个 vnode 是一个独立的 LSM Tree,彼此间数据通过目录隔离。
taos:TDEngine 客户端工具,通过 taos 可以连接到 TDEngine Server,并进行 DDL、DML 等数据库查询操作。taosdemo:快速往 TDEngine Server 导入 Demo 数据的工具,用于测试非常方便 。taosdump:从 TDEngine Server 导出数据库数据。
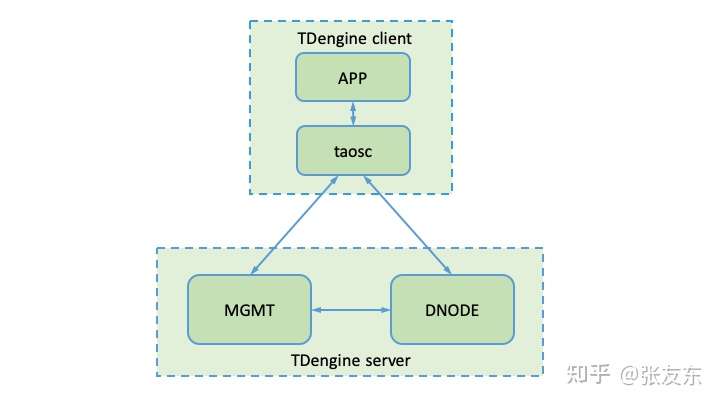
备注:图片转自参考资料 TDengine架构设计与存储结构
元数据管理
TDEngine Server 启动后,其数据组织结构类似如下结构,其中 $root/mgmt 目录存储数据库的元数据。
db.db: 存储所有 database 的元数据信息,包括数据保留策略,压缩算法等; 一个 database 包含多个 table。meters.db: 存储所有 table 的元数据信息,包括 table 对应的 ID 标识等;建模时,一个设备对应一个 table,table 的多个列存储设备的指标信息。user.db: 存储所有 user 的元数据信息,包括用户名、鉴权信息等。vgroups.db:存储所有 vnode 的元数据信息,包括 vnode 的缓存大小、所属的 database 等信息。一个 database 的数据会分散存储到多个 vnode 里,默认每个 vnode 存储 1000 个 table 的数据,当 database 里table 数量增加时,会跟着动态创建新的 vnode。
├── data
│   ├── vnode0
│   │   ├── v0f1865.data
│   │   ├── v0f1865.head0
│   │   └── v0f1865.last0
│   └── vnode1
│       ├── v1f1736.data
│       ├── v1f1736.head0
│       └── v1f1736.last0
├── mgmt
│   ├── db.db
│   ├── meters.db
│   ├── user.db
│   └── vgroups.db
├── output.txt
└── tsdb
    ├── vnode0
    │   ├── db
    │   │   ├── submit0.log
    │   │   ├── v0f1865.data -> /var/lib/taos/data/vnode0/v0f1865.data
    │   │   ├── v0f1865.head -> /var/lib/taos/data/vnode0/v0f1865.head0
    │   │   └── v0f1865.last -> /var/lib/taos/data/vnode0/v0f1865.last0
    │   └── meterObj.v0
    └── vnode1
        ├── db
        │   ├── submit1.log
        │   ├── v1f1736.data -> /var/lib/taos/data/vnode1/v1f1736.data
        │   ├── v1f1736.head -> /var/lib/taos/data/vnode1/v1f1736.head0
        │   └── v1f1736.last -> /var/lib/taos/data/vnode1/v1f1736.last0
        └── meterObj.v1
所有 *.db 的文件采用统一的存储结构,是 TDEngine 内部专门用来存储元数据设计的,其结构比较简单;所有条目按序排列,启动时会全量加载到内存,并建立内存索引,方便快速访问。
Header
Item1 Header (定长, 包含后续 Payload 长度)
Item1 Payload (变长)
Item2 Header(定长, 包含后续 Payload 长度)
Item2 Payload(变长)
...
数据管理
TDEngine 可创建多个 Database,每个 Database 包含多个 Table,通常每个 Table 存储一个物联网设备的数据。Database 的数据会被分散存储到多个 vnode,每个 vnode 是一个独立的 LSM Tree,数据存储在一个单独的目录。vnode 目录下,主要包含如下文件 (其中*为 vnode id 表示,编号从0开始)
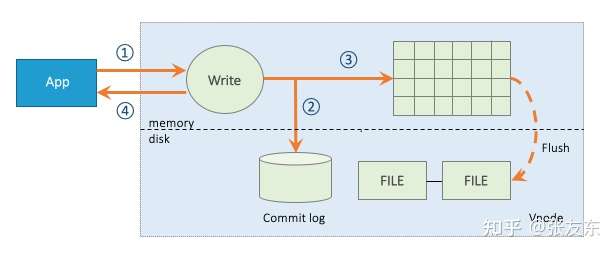
备注:图片转自参考资料 TDengine架构设计与存储结构
meterObj.v*:存储 vnode 下所有 Table 的元信息,启动后加载该文件,就能知道 Table 存储在哪个 vnode 里。summit*.log: 所有针对 vnode 的数据写入,会先提交到 WAL 日志文件。v*f1736.data:v*f1736.head:v*f1736.last:
meterObj 文件
meterObj 文件存储 vnode 下所有 Table 的元数据信息
- 创建 Table 时,会将 Table 对应的元数据。
- Table 结构变化时,会更新 meterObj 文件,如果新元数据比现有更长,则重新在末尾追加,并修改 Table offset+length 索引内容。
- 删除 Table 时,将 Table 对应的 offset+length 索引置为无效。
File Header
Table1 offset+length (定长,指向 Table 1 Meta 的文件内偏移位置)
Table2 offset+length
Table3 offset+length
...
Table N offset
Tabel 1 Meta
Table 2 Meta
...
Table N Meta
sumbit*.log
每个 vnode 是一个 LSM Tree 结构的存储,数据写入时,会写到 sumbit*.log 文件,然后写入内存 Buffer。
- WAL 文件通过 mmap 方式管理
- 数据累积到内存 Buffer,周期性或累积到一定大小触发内存 Buffer 刷到磁盘数据文件。
- WAL 根据配置周期性刷盘,默认 10ms 间隔。
File Header
Log Header1 (定长,包含 PayLoad 长度)
Log PayLoad1
Log Header2
Log Payload2
...
Log HeaderN
Log PaylaodN
head 文件
HEAD 文件存储 vnode 下各个数据文件 Block 数据的索引信息,其格式如下
File Header
Table1 offset (定长,指向 Table index)
Table2 offset
...
TableN offset
Table1 index
    Block1 position in data File
  Block2 position in data File
  ....
Table2 index
...
TableN index
data 文件
DATA 文件存储一系列的 Block,每个 Block 代表每个设备一段时间内所有数据列的数据(默认存储1个设备连续4096个数据点),其格式如下
File Header
Block1 data
    Block Meta (minTime, maxTime, shcema ...)
    Column1 series data
    Column2 series data
    ...

Block2 data
...
BlockN data
Block Meta (minTime, maxTime, schema ...)
last 文件
last 文件存储格式与 data 文件类似,当最后部分数据不足一个 Block 时,数据会单独写到 last 文件,下次有数据需要刷盘时,会与 last 文件数据进行合并,避免产生小的 Block 碎片。
基于超级表的建模
在 TDEngine 的模型设计里,一个物联网设备对应一张表,假设要某生产线,要存储一系列温度传感器设备的运行指标,其对应的关系模型视图如下,其中 DeviceId、Region 为设备的描述信息,在运行过程中基本不变,在时序里称为 Tag、Timestamp 描述设备产生数据的时间戳,Temperature、Humidity 产生的指标数据,随时间不断变化。
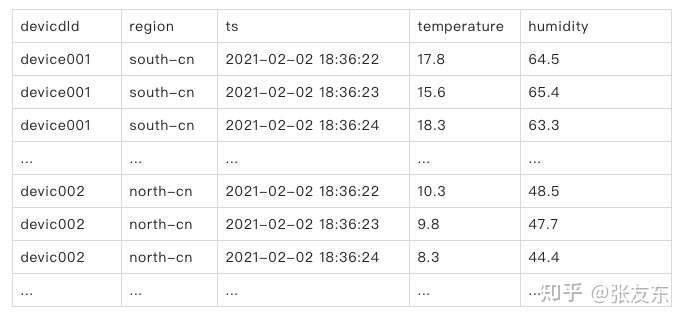
在 TDEngine 里,建模方式如下,先根据所有的列,建立超级表,区分 tag、timestamp 和 指标列;然后根据设备 Tag 的取值来创建各个设备表。
// 创建超级表
CREATE TABLE weather-sensors (ts timestamp, temperature double,humidity double)
tags (deviceId binary(20), region varchar(64));

// 创建设备表,做为唯一标识的 Tag,也可以不单独做为 Tag 列,直接做为表名
CREATE TABLE device001 using thermometer tags ('device001', 'south-cn');
CREATE TABLE device002 using thermometer tags ('device002', 'north-cn');

// 往设备插入数据
INSERT INTO device001(ts, temperature, humidity) VALUES('2021-02-02 18:36:22', 17.8, 64.5);
INSERT INTO device001(ts, temperature, humidity) VALUES('2021-02-02 18:36:23', 15.6, 65.4);
INSERT INTO device001(ts, temperature, humidity) VALUES('2021-02-02 18:36:24', 18.3, 63.3);

// 查询单个设备表的时序数据
SELECT avg(temperature) FROM device001 WHERE ts > t1 AND ts > t2;

// 查询多个设备表的时序数据,需要指定超级表的名字
SELECT * FROM weather-sensors WHERE region='south-cn';
SQL 处理逻辑
TDEngine 支持 SQL 方式访问数据库,与数据库通常的做法不同,TDEngine 的 SQL 是在客户端侧支持的,TDEngine Server 本身不感知 SQL 查询的存在。
TDEngine C 语言客户端实现了 SQL 处理的逻辑,但只做 SQL 语句词法、语法解析部分工作,将解析的SQL结果,通过 RPC 方式发送到 Server 端执行。
SQL 在客户端实现的有利有弊
- Server 端处理逻辑简单,不涉及特别负载的优化器执行器逻辑,缺点是扩展能力也有限。
- SQL 解析的资源开销放到 Client 端,Server 在性能表现上会更好,但从全局来看,整体资源开销是没变的;对于一些性能评测的场景,通常只关注 Server 端的性能指标,就比较有优势。
- 需要针对不同语言各自实现客户端逻辑,为了避免写多套 SQL 解析逻辑,TDEngine 的 Java、Go、Python 都是通过调用 C 客户端实现来完成 SQL 解析的。
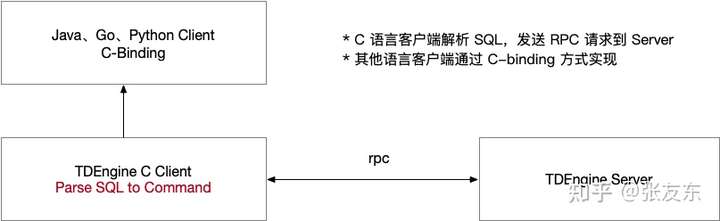
TDEngine 客户端针对 SQL 的主要处理逻辑就是解析 SQL 语句,首先其将 SQL 语句做分词,解析为一个个 Token,分词器的工作相对简单, tSQLGetToken 是 TDEngine 实现的一个简单的分词器。
有了 Token 序列,TDEngine 复用了 SQLite 内部的 lemon 语法解析器,能根据预定义的规则,解析出匹配的语法,并触发相关的动作。TDEngine 的语法文件在 src/inc/sql.y 中描述,通过 lemon 工具生成 src/client/src/sql.c , tSQLParse 根据定义好的语法,逐个解析 Token,完成 SQL 解析动作,将 SQL 语句关键信息提取出来结构化存储,最终将请求按协议进行编码发送到 TDEngine Server 进行处理。
总结
优势
- 针对物联网场景的存储优化,一个设备一张表,建模起来比较方便。
- 数据存储上,采用行列混存方式,设备数据先按时间范围分成多个 Block,每个 Block 内各个设备指标连续存储,提升按时间及设备指标的访问效率。
- 为避免 Block 形成碎片,每次刷盘时最后一部分数据写到单独的 last file,下次刷盘时,会先将 last 文件的数据与新数据进行合并,避免后台再去做 Compaction 来消除碎片。
- 引入 Super Table,将时序数据的 Tag 列 与指标列分离存储,使得在时序存储层专注于时序指标的处理。
问题
- 大规模设备存储的场景,会导致 vnode 数量特别多,每个 vnode 有独立的 WAL 日志,大量日志的并行写入队形能并不友好。同时在 TDEngine 启动时,需要加载每个 vnode 的 WAL 日志恢复到内存。
- 大量数据持久化存储时,直接将内存 struct 内存结构拷贝到 buffer 往文件持久化,导致数据存储格式是平台相关的。
- Super Table 的易理解性仍有不足,容易误用, 另外与外部数据源/生态对接时,都需要有一层转换,不够直接。
参考资料
- TDengine架构设计与存储结构
- https://github.com/taosdata/TDengine/
- 来源
https://zhuanlan.zhihu.com/p/348864141
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3136789/ ,如需转载,请注明出处,否则将追究法律责任。

