TimescaleDB的简单使用
官方资料
For more information on TimescaleDB, please visit the following links:
Getting started: TimescaleDB Developer Docs
API reference documentation: TimescaleDB Developer Docs
How TimescaleDB is designed: TimescaleDB Developer Docs
Note: TimescaleDB collects anonymous reports to better understand and assist our users.
For more information and how to disable, please see our docs TimescaleDB Developer Docs.
TimescaleDB 具有以下特点
1. 基于时序优化
2. 自动分片(自动按时间、空间分片(chunk))
3. 全 SQL 接口
4. 支持垂直于横向扩展
5. 支持时间维度、空间维度自动分区。空间维度指属性字段(例如传感器 ID,用户 ID 等)
6. 支持多个 SERVER,多个 CHUNK 的并行查询。分区在 TimescaleDB 中被称为 chunk。
7. 自动调整 CHUNK 的大小
8. 内部写优化(批量提交、内存索引、事务支持、数据倒灌)。
内存索引,因为 chunk size 比较适中,所以索引基本上都不会被交换出去,写性能比较好。
数据倒灌,因为有些传感器的数据可能写入延迟,导致需要写以前的 chunk,timescaleDB 允许这样的事情发生(可配置)。
9. 复杂查询优化(根据查询条件自动选择 chunk,最近值获取优化(最小化的扫描,类似递归收敛),limit 子句 pushdown 到不同的 server,chunks,并行的聚合操作)
10. 利用已有的 PostgreSQL 特性(支持 GIS,JOIN 等),方便的管理(流复制、PITR)
11. 支持自动的按时间保留策略(自动删除过旧数据)
使用TimescaleDB
建表时,最好将非超表字段默认设为null
警告:如果将任何其他列的默认值设置为NULL,则更改表的架构将非常有效。如果默认值设置为非null值,则TimescaleDB将需要为属于该超表的所有行(所有块)填充该值。
创建超表
1.创建标准表
CREATE TABLE conditions (
  time        TIMESTAMPTZ       NOT NULL,
  location    TEXT              NOT NULL,
  temperature DOUBLE PRECISION  NULL,
  humidity    DOUBLE PRECISION  NULL
);
2.将标准表转换成超表,将时间字段作为分片字段
SELECT create_hypertable('conditions', 'time');3.操作超表,跟普通数据库操作一样
插入与查询
INSERT INTO conditions(time, location, temperature, humidity)
  VALUES (NOW(), 'office', 70.0, 50.0);

SELECT * FROM conditions ORDER BY time DESC LIMIT 100;
修改超级表
ALTER TABLE conditions
  ADD COLUMN humidity DOUBLE PRECISION NULL;
删除超表
DROP TABLE conditions;最佳实践
TimescaleDB的用户经常有两个常见问题:
我应该为时间分割配置多长时间?
我应该使用空间分区吗?应该使用多少个空间分区?
时间间隔:超表默认时间间隔是,从v0.11.0开始的7天和v0.11.0之前的1个月。
设置时间间隔原则:所有超表时间间隔总块的大小不超过主内存的25%。比如电脑内存是16G,总共10台设备,每50ms存一条数据,1秒钟存20条数据,一天存的数据条数为:2036002410约等于1千700万条,大小大概约为1G,一天存1G数据,电脑内存为16G,总块大小不超过4G,所以时间间隔设为小于4天。
虽然通常将块做成较小而不是太大是比较安全的,但是将间隔设置得太小会导致很多块,这对应于某些类型的查询的计划等待时间的增加,所以将时间间隔设为3天比较合适。
设置时间间隔:1.通过chunk_time_interval在创建超表时进行设置来显式配置时间间隔
chunk_time_interval:块覆盖时间精确到纳秒,一天是100010006060*24
实例:
SELECT create_hypertable(‘conditions’, ‘time’, chunk_time_interval => 86400000000);
SELECT create_hypertable(‘conditions’, ‘time’, chunk_time_interval => interval ‘1 day’):指定块的覆盖时间是1天
2.创建超表之后,可以通过调用更改用于新块的间隔set_chunk_time_interval
例子:
SELECT set_chunk_time_interval(‘conditions’, interval ‘24 hours’);
SELECT set_chunk_time_interval(‘conditions’, 86400000000);
模式管理
创建索引
CREATE INDEX ON conditions (location, time DESC);
**创建索引的好处:**创建索引之后,能有效地提高查询数据效率。
**创建索引和使用查询语句的原则:**查询语句的筛选条件顺序根据创建索引的规则来排序。
按时间分区建超表时,timescaledb会自动在表数据上创建时间索引。
建议:一个表建一个复合索引,然后查询语句按照创建的索引字段顺序来查询语句
创建触发器
TimescaleDB支持触发器的全域(也即是触发器触发的时刻):BEFORE INSERT,AFTER INSERT,BEFORE UPDATE,AFTER UPDATE,BEFORE DELETE,AFTER DELETE
创建触发器:创建一个触发器,只要在超表中插入新行,该触发器便会调用此函数
CREATE TRIGGER record_error
  BEFORE INSERT ON conditions
  FOR EACH ROW
  EXECUTE PROCEDURE record_error();
创建触发器函数:
好处,减少程序执行的代码,让数据库来执行。更加好的来分配任务。
添加约束
1.约束某个字段值得范围
2.某个字段外键约束
3.将两个字段设为主键
CREATE TABLE conditions (
    time       TIMESTAMPTZ
    temp       FLOAT NOT NULL,
    device_id  INTEGER CHECK (device_id > 0),
    location   INTEGER REFERENCES locations (id),
    PRIMARY KEY(time, device_id)
    ///UNIQUE(time, device_id, location)
);
SELECT create_hypertable('conditions', 'time');
创建Json类型表字段
CREATE TABLE metrics (
  time TIMESTAMPTZ,
  user_id INT,
  device_id INT,
  data JSONB
);
创建Json类型表字段慎用,最好别用。
插入数据
在插入语句时使用ON CONFLICT不执行任何操作:
INSERT INTO conditions
  VALUES ('2017-07-28 11:42:42.846621+00', 'office', 70.1, 50.0)
  ON CONFLICT DO NOTHING;
在插入语句时更新现有数据:
INSERT INTO conditions
  VALUES ('2017-07-28 11:42:42.846621+00', 'office', 70.2, 50.1)
  ON CONFLICT (time, location) DO UPDATE
    SET temperature = excluded.temperature,
        humidity = excluded.humidity;
使用ON CONFLICT的好处,当批量插入数据时,使用ON CONFLICT,整个事务不会失败,仅仅只是跳过有冲突的行。
INSERT INTO conditions
  VALUES
    (NOW(), 'office', 70.0, 50.0),
    (NOW(), 'basement', 66.5, 60.0),
    (NOW(), 'garage', 77.0, 65.2);
提醒:在后面着重的去看看读取数据,可视化数据,提取数据,超表管理,分析工具,实用程序/统计。
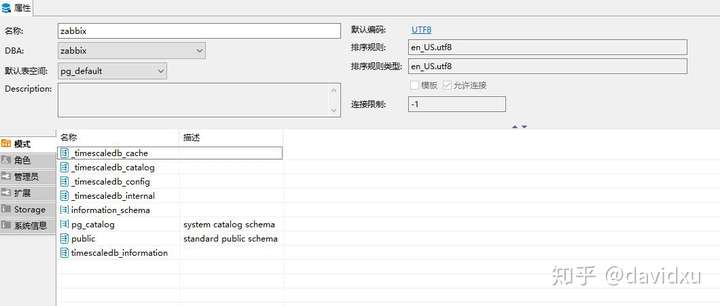
DBeaver的连接示例,图形界面操作和postgresql一模一样
来源 https://zhuanlan.zhihu.com/p/269523773
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3133785/ ,如需转载,请注明出处,否则将追究法律责任。

