使用VictoriaMetrics监控大规模Kubernetes集群
目前大多数关于Kubernetes集群监控的文章主要介绍如何使用Prometheus在Kubernetes集群上设置监控和报警系统,以及如何使用Grafana在其上建立出色的可视化系统。这本身就是一个很棒的系统,但是确实有一些问题,例如:
- 如果Prometheus异常怎么办?如果那是在关键阶段发生的呢?现在,可以通过部署多个Prometheus实例来解决此问题,但是仍然需要全局视图
- 如果您需要分析旧的监控数据怎么办? Prometheus默认情况下仅将数据保留15天。因此,需要维护用于保持历史数据的数据库和查询系统。
- 如果您的架构可扩展到数百个集群/环境,该怎么办?在这种情况下,将有多个Prometheus部署,并且同样需要全局视图。
在扩展和创建高度可用的监控系统方面,存在很多问题。通过VictoriaMetrics解决所有问题。
可以将其无缝添加到现有Prometheus部署之上。而且,它提供了与Prometheus非常相似的仪表板,因此学习曲线很平。
本文主要介绍如何使用victoriametrics监控大规模Kubernetes 集群,并提供高可用,可扩展,全局视图等优势。
整体架构
下图是整体架构图,主要包括4大块:
- 采集
- 存储
- 查询
- 报警
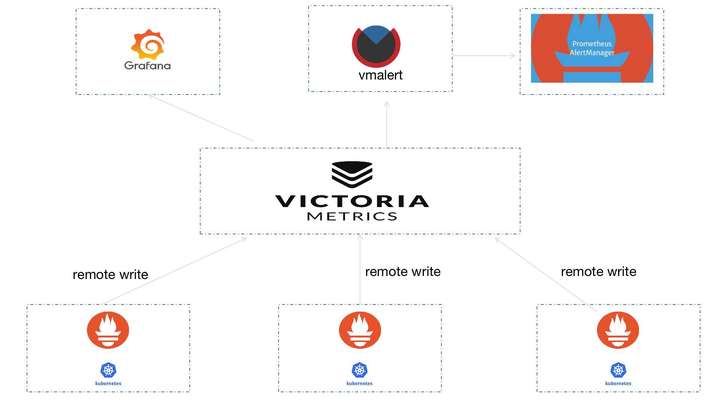
整体架构图,可以让大家一目了然我们如何使用victoriametrics扩展Prometheus功能,从而完成对大规模集群的监控。
下面我们将对这4块一一解读。
采集
Prometheus正在迅速成为Docker和Kubernetes监控工具之一。本节介绍包括Prometheus server,kube-state-metrics,各种用到的exporter,以及监控目标自动发现。
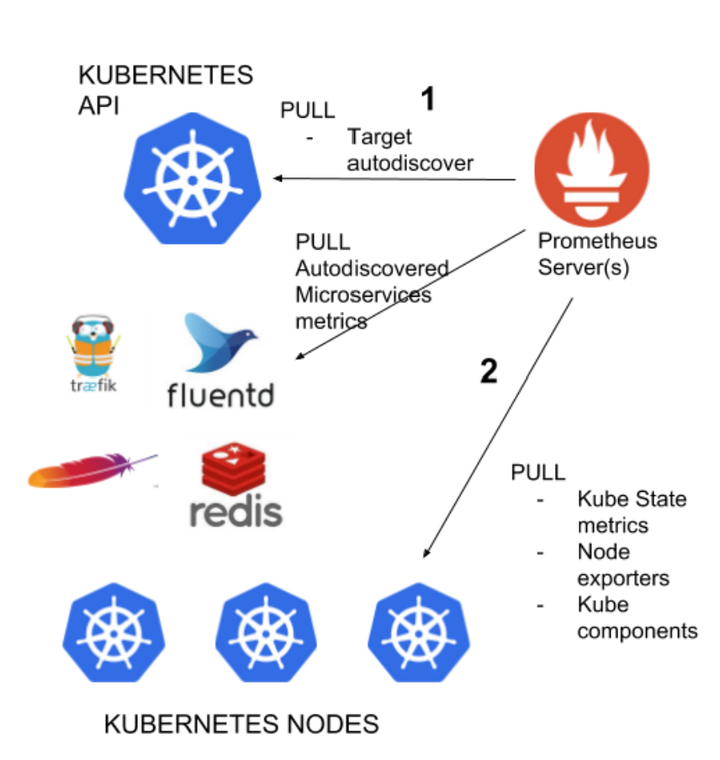
- 1 – Prometheus server 需要尽可能多的服务发现.
- 有几种方法可以实现此目的::
- Consul
- Prometheus Kubernetes SD 插件
- Prometheus operator 和 Custom Resource Definitions
- 2 – 除了应用程序指标,我们还希望Prometheus收集与Kubernetes服务,节点和业务流程状态相关的指标。
- Node exporter, 收集与主机相关的经典指标:cpu,mem,网络等
- Kube-state-metrics 收集架构和集群维度的指标: deployments, pod 指标, resource reservation等
- 来自内部组件的Kube-system指标: kubelet, etcd, dns, scheduler等等
关于该部分组件的安装和Promethues的配置相关,我们不做详细介绍。
更加云原生的话,可以使用 prometheus-operator 。Prometheus Operator能够帮助用户自动化的创建以及管理Prometheus Server以及其相应的配置。
当你的单个集群非常大的时候,我们可以考虑使用Prometheus relabel 中 hashmod 功能,实现采集对象的分片。
不过必须为Prometheus配置remote_write才能将数据发送到VictoriaMetrics。将以下行添加到Prometheus配置文件(通常位于/etc/prometheus/prometheus.yml中):
remote_write:
  - url: http://<victoriametrics-addr>:8428/api/v1/write
Prometheus将传入的数据写入本地存储,并将其并行复制到远程存储。这意味着即使--storage.tsdb.retention.time持续时间内,数据在本地存储中仍然可用,即使远程存储不可用。
因为我们的VictoriaMetrics集群将服务多个Kubernetes集群的metrics,所以将以下行添加到Prometheus config的global部分中:
global:
  external_labels:
    datacenter: k8s-cluster-01
存储
VictoriaMetrics是快速,经济高效且可扩展的时间序列数据库。可处理来自Kubernetes,IoT传感器,联网汽车,工业遥测,财务数据和各种企业工作负载的大量时间序列数据。可用作Prometheus的长期远程存储。
VictoriaMetrics 包括了如下的组件:
vmstorage-- 存储数据。vminsert-- 通过remote_write API接收来自Prometheus的数据并将其分布在可用的vmstorage节点上。vmselect-- 通过从vmstorage节点获取并合并所需数据,通过Prometheus查询API执行传入查询。
每个组件可以使用最合适的硬件配置独立扩展到多个节点。
整体架构图如下:
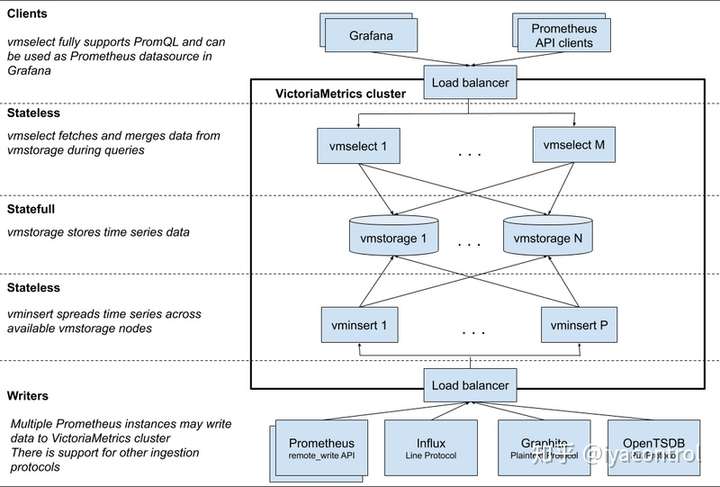
VictoriaMetrics 作为Prometheus的长期持久存储,具备伸缩性和高可用的特点。此外,相对比influxdb,承载同样的metrics,只使用不到1/10的内存。
查询
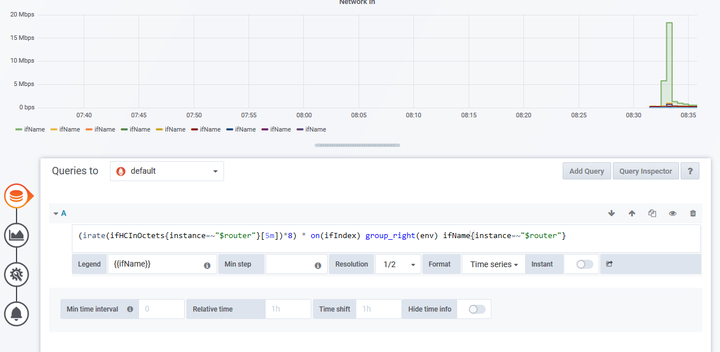
VictoriaMetrics 支持Prometheus查询API,因此可以在Grafana中用作Prometheus的替代产品。
使用以下网址在Grafana中创建Prometheus数据源:
http://<victoriametrics-addr>:8428用VictoriaMetrics的主机名或IP地址替换<victoriametrics-addr>。
报警
出于性能的考虑,VictoriaMetrics 并没有支持Prometheus 远程读api。但是提供了VM Alert组件。vmalert执行给定MetricsQL表达式(规则)的列表,并将警报发送到Alert Manager。
该组件具备以下特点:
- 与VictoriaMetrics TSDB集成;
- VictoriaMetrics MetricsQL表达式验证;
- Prometheus警报规则定义格式支持;
- 与Alertmanager集成;
- 轻巧,没有额外的依赖关系。
要开始使用vmalert,需要满足以下条件:
- 警报规则列表-要执行的PromQL / MetricsQL表达式;
- 数据源地址-可访问的VictoriaMetrics实例,用于规则执行;
- 通知程序地址-可到达的Alertmanager实例,用于处理,汇总警报和发送通知。
然后相应地配置vmalert:
./bin/vmalert -rule=alert.rules \
		-datasource.url=http://localhost:8428 \
        -notifier.url=http://localhost:9093
示例的rules文件如下:
groups:
  - name: groupGorSingleAlert
    rules:
      - alert: VMRows
        for: 10s
        expr: vm_rows > 0
        labels:
          label: bar
          host: "{{ $labels.instance }}"
        annotations:
          summary: "{{ $value|humanize }}"
          description: "{{$labels}}"

  - name: TestGroup
    rules:
      - alert: Conns
        expr: sum(vm_tcplistener_conns) by(instance) > 1
        annotations:
          summary: "Too high connection number for {{$labels.instance}}"
          description: "It is {{ $value }} connections for {{$labels.instance}}"
      - alert: ExampleAlertAlwaysFiring
        expr: sum by(job)
          (up == 1)
vmalert在单独的goroutine中为每个组运行评估。组中的规则按顺序一对一评估。
结论
本文介绍了如何利用VictoriaMetrics作为Prometheus的长期存储,来实现大规模k8s集群的监控。满足高可用,易扩展等特性。基本上涵盖了数据的采集,指标存储,查询,和报警主要方面。
来源 https://zhuanlan.zhihu.com/p/144764703
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3131170/ ,如需转载,请注明出处,否则将追究法律责任。

