利用Prometheus 打造企业分布式监控平台(7)--Thanos和VictoriaMetric
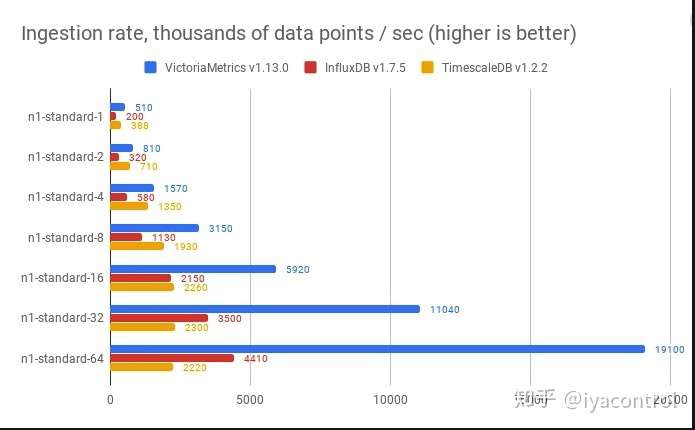
本文主要从数据写入和数据查询作为切入点,对比Thanos和VictoriaMetrics,包括以下几个维度:
- 安装和运维复杂性
- 可靠性和可用性
- 一致性
- 性能表现
- 可扩展性
关于Thanos和VictoriaMetrics的架构,大家可以参考利用Prometheus 打造企业分布式监控平台(3)--远程读写之战。这里就不再重复讲述了。
数据写入
安装和运维复杂性
Thanos需要以下步骤来在Prometheus中设置数据写入的链路:
- 禁用每个Prometheus实例的本地数据压缩:
必须将--storage.tsdb.min-block-duration和--storage.tsdb.max-block-duration设置为相等的值,才能禁用局部压缩,才能使用Thanos Sidecar上传
在Prometheus中启用本地数据压缩后,Thanos可能无法将数据块上传到对象存储中。有关更多详细信息,请参阅此问题。如果--storage.tsdb.retention.time远远高于2小时,则禁用数据压缩可能会损害Prometheus查询性能。 - 在每个Prometheus实例旁边安装Sidecars,以便他们将Prometheus数据上传到对象存储。
- 设置Sidecars监控。
- 为每个对象存储桶安装压缩器。
VictoriaMetrics需要在Prometheus配置中设置remote_write部分,因此Prometheus会将所有已抓取的数据复制到VictoriaMetrics远程存储中。
可靠性和可用性
Thanos Sidecar以2小时为单位上传本地Prometheus数据,这意味着如果本地磁盘损坏或意外删除数据,则可能会丢失每个Prometheus实例上最近添加的数据最多2个小时。
从查询组件到Sidecar的传入查询可能会对数据上载过程产生负面影响,因为这些任务是在单个Sidecar进程中执行的。理论上,可以运行单独的Sidecar来将数据上载到对象存储和查询。
VictoriaMetrics:每个Prometheus实例都会通过remote_write API立即将所有已抓取的数据复制到远程存储(例如VictoriaMetrics),在将数据抓取和写入到远程存储之间可能会有几秒钟的延迟,这意味着Prometheus可能会丢失几秒钟的数据本地磁盘损坏或意外删除数据,因为其余数据已被复制到远程存储。
Prometheus v2.8.0 +从预写日志(WAL)将抓取的数据复制到远程存储中,这意味着它不会因与远程存储的临时连接错误或远程存储的临时不可用而丢失数据。
因此,如果端点出现问题,我们只需要停止在预写日志中的位置并尝试重新发送失败的样本批次,就不会丢失数据或引起内存问题,因为它不会继续读取写入数据-ahead log,直到成功发送数据为止。2.8更新有效地使用了恒定数量的内存,并且缓冲区实际上是不确定的,仅取决于磁盘的大小。一致性
Thanos。在Compactor和Store网关之间存在竞争,这可能导致数据不一致或查询失败。
VictoriaMetrics。借助存储体系结构,数据始终保持一致。
性能表现
Thanos。通常,插入性能良好,因为Sidecar只是将Prometheus创建的本地数据块上载到对象存储中。来自Query组件的大量查询可能会稍微减慢数据上载过程。Compactor可能是限制每个对象存储桶提取速度的因素如果新上载的块超过了Compactor的性能。
VictoriaMetrics。Prometheus使用额外的CPU将本地数据复制到远程存储中,与Prometheus执行的其他任务(例如数据抓取,本地存储整理和规则评估)所花费的CPU时间相比,该CPU时间非常小。每个CPU核心具有良好的提取性能。
可扩展性
Thanos Sidecars在上传数据块时依赖对象存储可扩展性。S3和GCS具有出色的可扩展性。
VictoriaMetrics:仅增加vminsert和vmstorage的容量,可以通过添加新节点或切换到功能更强大的硬件来增加容量。
数据查询
安装和运维复杂性
Thanos需要设置和监视以下组件在数据查询链路上:
- 每个Prometheus的Sidecar,都启用了适用于查询的Store API组件。
- 通过Sidecars上载的数据经过存储网关。
- 连接到所有Sidecar以及所有Store网关的查询组件,以提供带有Prometheus查询API的全局查询视图。在位于不同数据中心的Query组件与Sidecar之间建立安全可靠的连接可能非常困难。
VictoriaMetrics提供了开箱即用的Prometheus查询API,因此无需在VictoriaMetrics集群之外设置任何组件,只需将Grafana和其他Prometheus查询API客户端指向VictoriaMetrics。
可靠性和可用性
Thanos.Query组件需要与所有Sidecar以及所有Store网关的有效连接,以便为传入的查询计算出完整的有效响应。这对于在不同数据中心或可用性区域中具有许多Prometheus实例的大规模设置而言可能是个难题。
在使用大对象存储桶时,存储网关可能会启动缓慢,因为它需要在启动之前从存储桶中加载所有元数据。有关详细信息,请参阅此问题。这可能会成为升级过程中的痛点。
VictoriaMetrics的查询链路仅接触群集内vmselect和vmstorage节点之间的本地连接,与Thanos设置中的数据中心间连接相比,此类本地连接具有更高的可靠性和可用性。
所有VictoriaMetrics组件均针对短启动时间进行了优化,因此可以快速升级。
一致性
当某些Sidecars或Store网关不可用时,默认情况下,Thanos允许部分响应:
在QueryAPI或StoreAPI的查询中,部分响应可能是错过的结果。如果其中一个StoreAPI返回错误或超时派生了另外几个返回成功,则可能会发生部分响应。当某些vmstorage节点不可用时,VictoriaMetrics还通过返回部分响应来优先考虑可用性而不是一致性。可以通过设置-search.denyPartialResponse选项来禁用此行为。
总体而言,由于前一部分中所述的较高可用性,VictoriaMetrics返回的部分响应数量应比Thanos低得多。
性能表现
Thanos。由于最慢的Sidecar或Store网关限制了Query组件的选择性能,因为Query组件在返回结果之前会等待所有Sidecars和Store网关的所有响应。
通常,Sidecars和Store网关之间的选择性能并不均衡,因为它取决于许多因素:
- 每个Prometheus实例收集的数据量
- Store网关后面的每个对象存储桶中的数据量
- 每个Prometheus + Sidecar和Store网关的硬件配置
- 查询组件与Sidecar或Store网关之间的网络延迟。如果Query和Sidecar位于不同的数据中心(可用性区域),则延迟可能会很高。
- 通常,对象存储延迟(S3,GCS)比块存储延迟(GCE磁盘,EBS)高得多。
VictoriaMetrics的select性能受vmselect和vmstorage节点的数量及其硬件配置的限制,只需增加这些节点的数量或切换到功能更强大的硬件以扩展选择性能,vminsert即可在可用的vmstorage节点之间平均分配传入数据。 vmstorage节点之间的性能:VictoriaMetrics已针对速度进行了优化,因此与Thanos相比,它应提供更好的性能指标。
可扩展性
为了提高选择性能,可以在具有相同配置的多个查询组件之间分配负载。可以在同一对象存储桶的多个存储网关之间分配负载,以提高其性能。用于扩展Sidecar后面的单个Prometheus实例的性能。因此,Thanos的选择路径可伸缩性受到最慢的Sidecar + Prometheus对的限制。
与Thanos相比,VictoriaMetrics群集提供了更好的选择路径可扩展性,因为vmselect和vmstorage组件可以独立扩展到任意数量的节点。群集中的网络带宽可能成为可扩展性的限制因素.VictoriaMetrics针对低网络带宽使用进行了优化,以便减少这个限制因素。
高可用性安装
Thanos。在不同的可用性区域中运行多个查询组件。
如果单个区域不可用,则来自另一个区域的查询组件将继续提供查询服务,因为某些Sidecars或Store网关可能位于不可用区域中,所以它可能会返回部分结果。
VictoriaMetrics在不同的可用区中运行多个集群,配置每个Prometheus以将数据同时复制到所有集群。
如果您具有一对Prometheus HA对,并且每对中都具有复制副本1和复制副本2,则将复制副本1配置为将数据复制到第一个集群,而复制副本2应该将数据复制到第二个集群。
如果单个可用区域不可用,则来自另一个区域的VictoriaMetrics群集将继续接收新数据并为查询提供完整响应。
结论
Thanos和VictoriaMetrics使用不同的方法来提供长期存储,全局查询视图和水平可伸缩性:
- VictoriaMetrics通过标准remote_write API接受来自Prometheus实例的数据,并将其写入持久复制的持久卷中,例如Google Compute Engine HDD磁盘,Amazon EBS或任何其他持久性磁盘,而Thanos禁用对本地Prometheus数据的压缩,并使用非标准Sidecars进行上传数据存储到S3或GCS,还需要设置压缩器以将对象存储桶中的较小数据块合并为较大的数据块。
- VictoriaMetrics开箱即用地实现了全局查询视图的Prometheus查询API.Select路径不需要集群外部的任何外部连接,因为Prometheus实时将抓取的数据复制到远程存储中.Thanos需要设置Store网关,用于select路径的Sidecars和Query组件。必须将Query组件连接到所有Sidecars和Store网关才能获取全局查询视图。很难在位于不同数据中心的Query组件和Sidecars之间提供可靠和安全的连接(适用于大型Prometheus设置的区域。查询组件的选择性能受到最慢的Sidecar或Store网关的限制。
- 得益于简单的体系结构和Helm chart,VictoriaMetrics集群易于在Kubernetes中运行,而Thanos则由于活动部件数量和可能的配置较多而更难在K8S中进行配置和操作。
PS:
- 本文大量参考了Comparing Thanos to VictoriaMetrics cluster。
- 对于Thanos, 依赖的存储是对象存储,这就决定了该方案在公有云上比较合适,大多的公有云都提供了自己的对象存储服务。当然如果是自己私有部署的话,可以考虑使用minio,可以称为开源的S3。此外Thanos 架构的确是复杂的。
- VictoriaMetrics架构简单,性能也比较优秀,但是数据的副本这块实现的一般,存储存在部分数据丢失的风险。VictoriaMetrics把数据的副本实现寄托于提供存储的副本上,比如ceph,一般都是三个副本。
- 一切脱离场景的选型都是不切实际。
- 来源
https://zhuanlan.zhihu.com/p/135899052
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3130397/ ,如需转载,请注明出处,否则将追究法律责任。

