使用PostgreSQL和TimescaleDB加速数据分析
作者|Miranda Auhl
编译|VK
来源|Towards Data Science
原文链接:https://towardsdatascience.com/speeding-up->
- 通用数据分析工具和“问题”
- 数据分析问题#1:存储和访问数据
- 数据分析问题#2:最大限度地提高分析速度和计算效率(数据集越大,问题越大)
- 数据分析问题#3:存储和维护用于数据分析的脚本
- 数据分析问题#4:轻松利用新技术或附加技术
- 结尾
时间序列数据无处不在,它推动着每个行业的决策。
时间序列数据集中表示系统、流程或行为随时间的变化。了解这些变化有助于我们解决众多行业的复杂问题。
根据他们正在构建的应用程序的类型,开发人员最终会收集数百万行时间序列数据(有时每天甚至每小时收集数百万行数据!)。
要理解这些高容量、高保真的数据,需要一套特殊的数据分析技能,而这些技能通常不是经典开发人员技能的一部分。
为了执行时间序列分析,开发人员和数据分析师需要专门的工具,随着时间序列数据的显著增长,这些工具的效率变得更加重要。
通常,数据分析师的工作可以归结为评估、清理、转换和建模数据。根据我的经验,我发现这些行动对于我从数据中获得理解是必要的,我将在本文中将其称为“数据分析生命周期”。
“数据分析生命周期”:
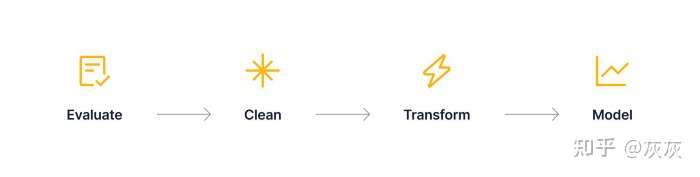
Excel、R和Python可以说是一些最常用的数据分析工具,尽管它们都是很棒的工具,但它们可能并不适合所有工作。
从经验上讲,这些工具在生命周期的早期阶段对于“数据搜索”来说效率尤其低下;具体来说,预建模工作中涉及的评估数据、清理数据和转换数据步骤。
当我处理更大、更复杂的数据集时,我开始相信为特定类型的数据(如时间序列数据)构建的数据库对于数据分析更有效。
在本系列博客中,我将深入讨论分析生命周期中的三个数据挖掘步骤,并演示如何使用TimescaleDB和PostgreSQL作为数据分析的强大工具。
在这篇介绍性文章中,我将探讨我在使用流行的数据分析工具时遇到的一些常见挫折,并从中深入了解我如何使用TimescaleDB和PostgreSQL来帮助缓解这些痛点。
在以后的帖子中,我们将关注:
- TimescaleDB和PostgreSQL数据分析功能如何取代Python和pandas中通常执行的数据搜索工作
- TimescaleDB和PostgreSQL与Python和pandas在数据搜索任务中的比较(标准数据分析工作流的基准测试)
- 如何使用TimescaleDB、PostgreSQL和Python,使用纽约市出租车数据,进行端到端的深入数据分析。
通用数据分析工具和“问题”
正如我们所讨论的,用于数据分析的三种最流行的工具是Excel、R和Python。虽然它们本身就是很好的工具,但它们并没有经过优化以有效地执行分析过程中的每个步骤。
特别是,大多数数据科学家(包括我自己!)随着数据量的增长,或者需要逐月重做相同的分析,你将面临类似的问题。
其中一些斗争包括:
- 数据存储和访问:哪里是存储和维护数据以供分析的最佳位置?
- 数据大小及其对分析的影响:如何提高数据挖掘任务的效率,尤其是在数据扩展时?
- 脚本存储和可访问性:我可以做些什么来改进脚本的存储和维护?
- 轻松利用新技术:我如何设置数据分析工具链,以便轻松过渡到新技术?
让我们开始研究这些问题!
数据分析问题#1:存储和访问数据
要进行数据分析,你需要访问…数据。
在分析过程中,管理数据的位置以及访问数据的方便程度是初步的(通常也是最重要的)步骤。
每次我开始一个新的数据分析项目时,这往往是我遇到的第一个难题。不管原始数据源是什么,我总是问“在我开始处理数据挖掘过程时,存储和维护数据的最佳位置在哪里?”
尽管数据分析师使用数据库存储和查询数据变得越来越普遍,但它仍然无处不在的。
通常,原始数据以CSV文件流或生成JSON的API流提供。虽然这对于较小的项目来说是可以管理的,但它很快就会变得难以维护,并且很难从一个项目管理到另一个项目。
例如,让我们考虑一下如何使用Python作为我们选择的数据分析工具。
在使用Python进行数据分析时,我可以选择通过文件/API或数据库连接接收数据。
如果我在分析过程中使用文件或API查询数据,我经常会遇到以下问题:
- 文件在哪里?如果API的URL或参数发生更改,会发生什么情况?
- 如果创建了重复的文件,会发生什么情况?如果对一个文件而不是另一个文件进行了更新怎么办?
- 如何最好地与同事共享这些文件?
- 如果多个文件相互依赖,会发生什么情况?
- 如何防止将不正确的数据添加到CSV的列中?
- 非常大的文件呢?10MB、100MB、1GB、1TB大小的文件?
在一个又一个项目地遇到这些初始问题后,我知道必须有更好的解决方案。而且很明显,一个专门的SQL数据库可能是我的答案!
现在,让我们考虑一下我是否连接到TimeSeldB。
通过将时间序列数据导入TimescaleDB,我可以为所有数据创建一个真实来源。因此,与他人协作变得像共享数据库访问权限一样简单。
对数据库中的数据搜索过程的任何修改都意味着所有用户都可以同时访问相同的更改,而不是通过CSV文件进行解析以验证我是否拥有正确的版本。
此外,数据库通常可以处理比用Python或R编写的脚本大得多的数据负载。TimescaleDB是为了高效、经济地存储、维护和查询TB级数据而构建的。存储和分析多年的时间序列数据变得高效,同时仍然易于访问。
简言之,随着时间的推移管理数据,特别是当数据来自不同的来源时,高效地维护和访问数据可能是一场噩梦。但是,利用一些工具可以避免这种情况。
数据分析问题#2:最大限度地提高分析速度和计算效率(数据集越大,问题越大)
Excel、R和Python都能够执行数据分析“生命周期”的前三个步骤:评估、清理和转换数据。然而,这些技术在处理过程中通常不会针对速度或计算效率进行优化。
多年来,在许多项目中,我发现随着数据集规模的增加,导入、清理和转换数据集的过程变得更加困难、耗时,有时甚至不可能。
对于Python和R,解析大量数据似乎要花很长时间,一旦碰到数百万行,Excel就会崩溃。
当我需要为聚合或数据转换之类的事情创建额外的表时,事情变得特别困难:根据数据的大小、我使用的计算机或分析的复杂性,某些代码行可能需要几秒钟或几分钟才能运行。
虽然几秒钟或几分钟看起来并不多,但当你执行每月需要运行数百次或数千次的分析时,这些时间加起来相当于几小时或几天的生产力损失!
为了举例说明,让我们再次看一个Python示例。
假设我正在使用从Kaggle获取的物联网数据集。该集合包含两个表格,一个用于指定德克萨斯州休斯顿一个家庭的能源消耗,另一个用于记录天气状况。
要使用Python运行分析,我分析的第一步是拉入数据并观察它。
当使用Python执行此操作时,我会运行如下代码
import psycopg2

import pandas as pd

import configparser

## 使用配置文件获取数据库连接信息

config = configparser.ConfigParser()

config.read('env.ini')

## 建立连接

conn = psycopg2.connect(database=config.get('USERINFO', 'DB_NAME'),

host=config.get('USERINFO', 'HOST'),

user=config.get('USERINFO', 'USER'),

password=config.get('USERINFO', 'PASS'),

port=config.get('USERINFO', 'PORT'))

## 定义用于从数据库中选择数据的查询

query_weather = 'select * from weather'

query_power = 'select * from power_usage'

## 创建游标以提取数据并将其放置到数据框中

cursor = conn.cursor()

cursor.execute(query_weather)

weather_data = cursor.fetchall()

cursor.execute(query_power)

power_data = cursor.fetchall()

## 你必须手动设置数据框的列名

weather_df = pd.DataFrame(weather_data, columns=['date','day','temp_max','temp_avg','temp_min','dew_max','dew_avg','dew_min','hum_max','hum_avg','hum_min','wind_max','wind_avg','wind_min','press_max','press_avg','press_min','precipit','day_of_week'])

power_df = pd.DataFrame(power_data, columns=['startdate', 'value_kwh', 'day_of_week', 'notes'])

cursor.close()

print(weather_df.head(20))

print(power_df.head(20))
总的来说,使用我的2019款MacBook Pro笔记本电脑和32GB内存运行这段代码需要2.718秒。
但是,如果我在数据库中使用SQL运行这个等价的脚本呢?
select * from weather

select * from power_usage
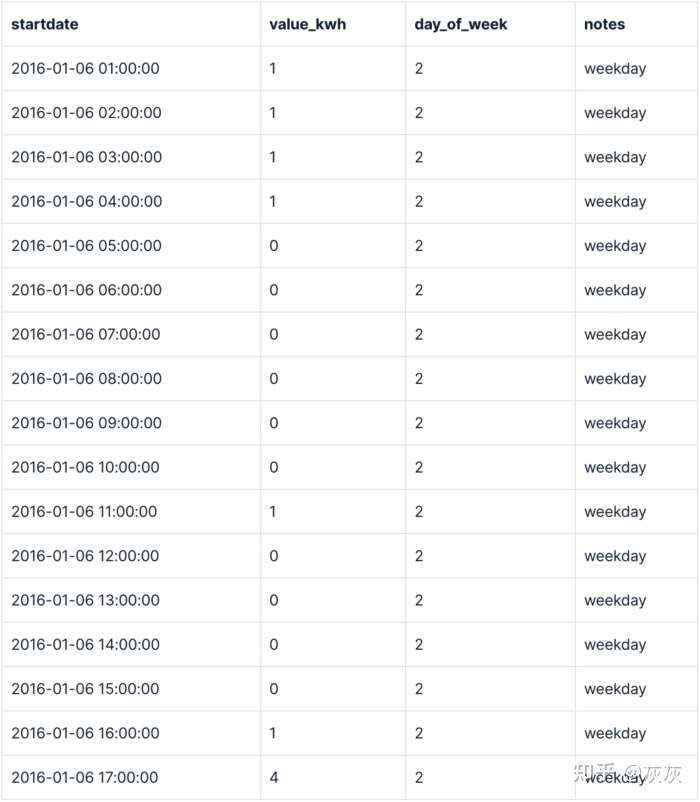
此查询只需0.342秒即可运行,与Python脚本相比几乎快了8倍。
拉入数据并观察它只是我分析的开始!当我需要执行转换任务(如聚合数据)时会发生什么?
对于该数据集,当我们查看power_usage表时(如上所示),每小时记录kWh读数。如果我想做日常分析,我必须将每小时的数据聚合到“day”中。
如果我使用Python进行聚合,我可以使用
# 按天计算的总用电量

## 创建当天的列

day_col = pd.to_datetime(power_df['startdate']).dt.strftime('%Y-%m-%d')

power_df.insert(0, 'date_day', day_col)

agg_power = power_df.groupby('date_day').agg({'value_kwh' : 'sum', 'day_of_week' : 'unique', 'notes' : 'unique' })

print(agg_power)
…运行时间为0.49秒(不包括导入数据的时间)。
或者,使用TimescaleDB time_bucket函数,我可以使用以下查询直接在数据库中进行聚合
select

time_bucket(interval '1 day', startdate ) as day,

sum(value_kwh),

day_of_week,

notes

from power_usage pu

group by day, day_of_week, notes

order by day
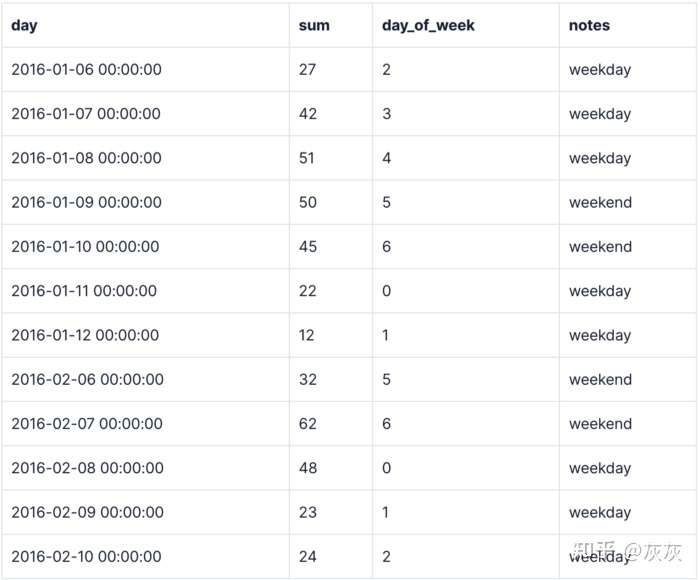
…只需0.087秒,比Python脚本快5倍以上。
你可以在这里看到一个模式。
创建TimescaleDB是为了高效地查询和存储时间序列数据。但简单地查询数据只触及TimescaleDB和PostgreSQL表面功能。
TimescaleDB和PostgreSQL提供了广泛的工具和功能,可以取代对其他工具的需求来评估、清理和转换数据。
TimescaleDB的一些功能包括连续聚合、压缩和其他功能;所有这些都允许你直接在数据库中执行几乎所有的数据挖掘任务。
当我直接在TimescaleDB中执行分析的评估、清理和转换步骤时,我不再需要使用其他工具(如Excel、R或Python)来执行数据挖掘任务。然后,我可以将经过清理和转换的数据直接拉入Excel、R或Python,为建模做好准备。
数据分析问题#3:存储和维护用于数据分析的脚本
在整个数据分析工作流中专门使用Excel、R或Python的另一个潜在缺点是,用于分析数据的所有逻辑都包含在脚本文件中。与拥有许多不同数据源的问题类似,维护脚本文件可能会带来不便和混乱。
我和许多数据分析师遇到的一些常见问题包括:
- 丢失文件
- 无意中创建重复文件
- 更改或更新某些文件,但不更新其他文件
- 需要编写和运行脚本来访问转换后的数据(参见下面的示例)
- 每当添加新的原始数据时,都要花费时间重新运行脚本(参见下面的示例)
虽然你可以使用代码存储库来克服其中一些问题,但它不会修复最后两个问题。
让我们再考虑一下Python场景。
假设我在所有数据分析任务中都专门使用了Python脚本。如果我需要导出转换后的数据以用于德克萨斯州的能源消耗报告,该怎么办?
很可能,我必须在脚本中添加一些代码以允许导出数据,然后再次运行脚本以实际导出数据。根据脚本的内容以及转换数据所需的时间,这可能非常不方便且效率低下。
如果我也得到一堆新能源使用和天气数据呢?对于我来说,要将这些新的原始数据合并到现有的可视化或报告中,我需要再次运行脚本,并确保我所有的数据挖掘任务都按预期运行。
数据库功能,如连续聚合和物化视图,可以创建转换后的数据,这些数据可以直接从数据库存储和查询,而无需运行脚本。
此外,我可以为连续聚合创建策略,以便在修改原始数据时定期更新转换后的数据。因为有了这些策略,我就不必担心运行脚本来重新转换数据以供使用,从而使对更新数据的访问变得高效。
数据分析问题#4:轻松利用新技术或附加技术
最后,是数据分析生命周期的最后一步:建模。如果我想使用一种新的工具或技术来创建可视化,那么很难轻松地将转换后的数据用于其他地方的建模或可视化。
Python、R和Excel的可视化和建模功能都非常出色。但是,当你的公司或团队想要采用新工具时会发生什么情况?
根据我的经验,这通常意味着要么在分析过程中增加另一个步骤,要么重新发现如何在新技术中执行评估、清理和转换步骤。
例如,在我以前的一份工作中,我被要求将我分析的一部分转换为Power BI,以用于业务分析。我的利益相关者想要的一些可视化要求我从Python脚本访问转换后的数据。当时,我可以选择从Python脚本中导出数据,也可以考虑如何直接在Power BI中转换数据。这两种选择都不理想,保证需要额外的时间。
当涉及到采用新的可视化或建模工具时,使用数据库来评估、清理和转换数据会再次对你有利。大多数可视化工具(如Grafana、Metabase或Power BI)允许用户直接从数据库导入数据。
由于我可以在TimescaleDB中完成大部分数据扫描任务,因此添加或切换工具(例如使用Power BI实现仪表板)变得非常简单,只需连接到数据库、提取扫描数据以及使用新工具进行可视化和建模。
结尾
总之,Excel、R和Python都是用于分析的优秀工具,但可能不是每项工作的最佳工具。举个例子:我在时间序列数据分析方面遇到了困难,尤其是在大数据集上。
借助TimescaleDB和PostgreSQL功能,你可以存储数据,并直接在数据库中执行数据分析的评估、清理和转换方面的工作,并解决过程中的许多常见数据分析难题(我希望在本文中已经演示了这一点)
在接下来的博客文章中,我将探讨TimescaleDB和PostgreSQL功能与Python的对比,以及TimescaleDB和PostgreSQL性能与Python和pandas在数据搜索任务中的对比,并深入探讨TimescaleDB(用于数据搜索)和Python(用于建模和可视化)的数据分析。
感谢阅读!
来源 https://zhuanlan.zhihu.com/p/453343833
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3124817/ ,如需转载,请注明出处,否则将追究法律责任。

