利用Prometheus 打造企业分布式监控平台(8)--VictoriaMetrics集群 iya
在之前的系列文章中,我们讲到了一个远程存储对于企业级Prometheus的重要性,以及Thanos和VictoriaMetrics的对比。今天我们主要讲VictoriaMetrics,包括集群部署和如何与Prometheus结合。
VictoriaMetrics是一个高性能,低成本,可扩展的时序数据库。可以用来做Prometheus的长期存储。分为单机版本和集群版本,均已开源。如果数据写入速率低于每秒一百万个数据点,官方建议使用单节点版本而不是集群版本。
当然单机版本配置简单,可以通过纵向扩展的方式来提升性能。不过作为一个企业级的监控系统,选择集群版本,也就是选择横向扩展。
架构预览
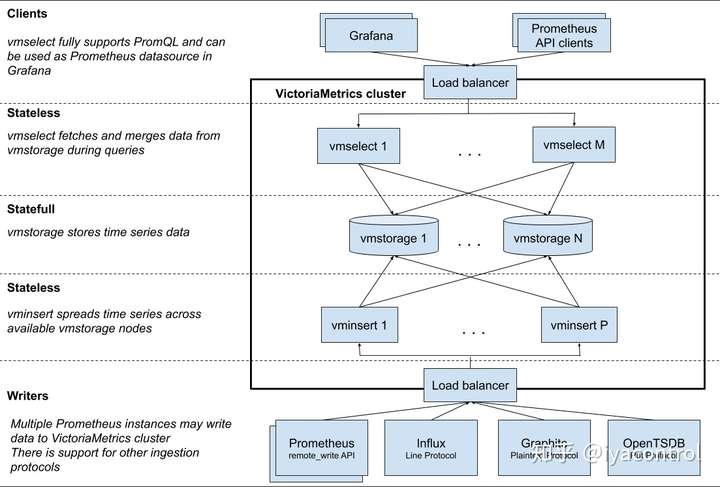
VictoriaMetrics集群包含下面三个组件:
vmstorage- 存储数据vminsert- 使用一致的哈希将获取的数据写入到vmstorage分片vmselect- 使用vmstorage中的数据执行查询
每个服务都可以独立扩展并可以在最合适的硬件上运行。vmstorage节点彼此之间不了解,不相互通信且不共享任何数据。这是不共享任何体系结构的。它提高了群集的可用性,简化了群集维护和群集扩展。
集群运维
集群安装
一个最小化的集群包含三个部分:
- 单个
vmstorage节点。-retentionPeriod和-storageDataPath命令行参数指定metrics保留时间和数据存储路径。 - 单个
vminsert节点。通过-storageNode = <vmstorage_host>:8400建立与vmstorage的关系。 - 单个vmselect节点。通过
-storageNode = <vmstorage_host>:8401建立与vmstorage的关系。
当然出于高可用的考虑,每个部分需要包含2+的节点。此时vminsert和vmselect前端各自需要一个负载均衡器。
- 以/insert 开头的请求必须路由到vminsert节点上的端口8480。
- 以/select开头的请求必须路由到vmselect节点上的端口8481。
监控
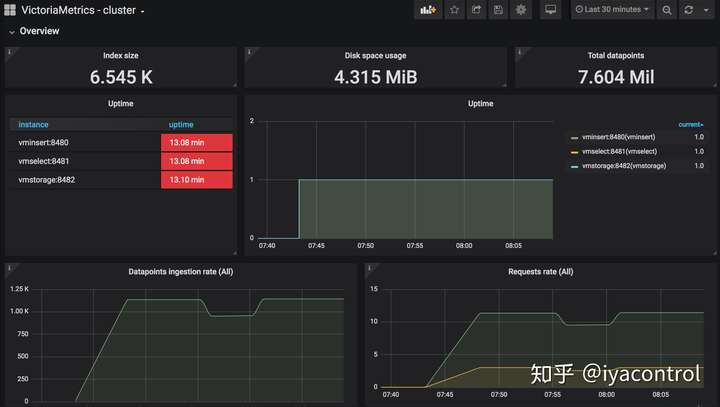
监控必不可少了。所有集群组件通过-httpListenAddr命令行参数指定暴露Prometheus兼容格式公开各种度量标准的端口。默认情况下,使用以下TCP端口:
vminsert- 8480vmselect- 8481vmstorage- 8482
官方也提供了相应的grafana监控大图。
集群扩缩容
群集性能和容量可通过添加新节点来扩展。
vminsert和vmselect节点是无状态的,可以随时添加/删除。别忘了在http负载均衡器上更新这些节点的列表。添加更多的vminsert节点可以提高数据的写入速率。添加更多的vmselect节点可以提高数据查询速率。
vmstorage节点承载写入的数据,因此无法删除它们而不会丢失数据。添加更多的vmstorage节点可扩展群集容量。
增加vmstorage节点的步骤:
- 使用与集群中现有节点相同的-retentionPeriod启动新的
vmstorage节点。 - 更改
-storageNode命令行参数,增加<new_vmstorage_host>:8401,然后逐步重新启动所有vmselect节点:。 - 更改
-storageNode命令行参数,增加<new_vmstorage_host>:8400,然后逐步重新启动所有vminsert节点。
重新变更节点
可以通过正常关闭来更新所有节点类型-vminsert,vmselect和vmstorage-将SIGINT信号发送到相应的进程,等待其完成,然后使用新的配置启动新版本。
如果在更新过程中每种类型的至少一个节点仍然可用,则集群保持工作状态。
容量规划
每个实例类型(vminsert,vmselect和vmstorage)都可以在最合适的硬件上运行。
vminsert
- 可以根据写入数据速率计算所有
vminsert实例的建议vCPU内核总数:vCPU =写入速率/150K。 - 每个
vminsert实例的建议vCPU核心数应等于集群中的vmstorage实例数。 - 每个
vminsert实例的RAM量应为1GB或更多。RAM用作缓冲区,以应对峰值速率。 - 有时,
vminsert实例上的-rpc.disableCompression命令行标志可能会增加数据写入容量,但代价是vminsert和vmstorage之间的网络带宽使用率更高。
vmstorage
- 可以根据数据写入速率计算所有
vmstorage实例的建议vCPU内核总数:vCPU =写入速率/ 150K。 - 可以从活跃时间序列数中计算出所有
vmstorage实例的建议RAM总量:RAM = active_time_series * 1KB。如果时间序列在最后一个小时内至少收到一个数据点,或者已经接收到一个时间点,则该时间序列是活跃的在最后一个小时查询。 - 可以根据写入速率和保留时间来计算所有
vmstorage实例的建议存储空间总量:storage_space =ingestion_rate * retention_seconds。
vmselect
vmselect实例的推荐硬件在很大程度上取决于查询的类型。少量时间序列上的轻量级查询通常需要vmselect上的vCPU内核数量少和RAM量少,而大量时间序列上的重量查询(> 10K)通常需要更多数量的vCPU内核和更大数量的RAM。
副本和数据安全
VictoriaMetrics将副本放到-storageDataPath所指向的基础存储上。建议将数据存储在Google Compute Engine永久磁盘上,因为它们可以防止数据丢失和数据损坏,还可以提供一致的高性能,并且可以调整大小而不会停机。对于大多数用例来说,基于持久性磁盘就足够了。
部署
官方提供了Helm包。可以快速安装。
当然官方也提供了docker镜像和可执行文件。
与Prometheus结合
配置Prometheus远程写,如下:
remote_write:
- url: http://vminsert:8480/insert/0/prometheusPS:
VictoriaMetrics集群版本数据写入的URL为 http://<vminsert>:8480/insert/<accountID>/<suffix>。
accountID代表租户IDsuffix可能有下面的值:prometheus-用于使用Prometheus远程写入API插入数据influx/write或influx/api/v2/write-使用Influx协议写入数据opentsdb/api/put-用于接受OpenTSDB HTTP请求。prometheus/api/v1/import-用于导入通过api/v1/export 导出的vmselect中数据。
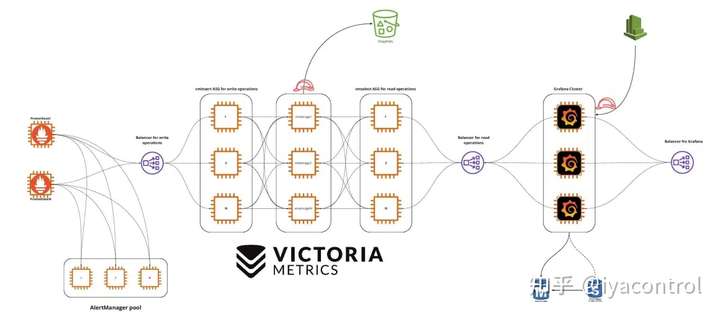
然后,如果只是单纯的grafana展示,那么可以参考上面的架构图,在grafana中增加Prometheus数据源,地址为vmselect的负载均衡器的VIP即可,如下:
http://vmselect:8481/select/0/prometheus/但是在实际场景下,我们往往需要报警,对接alertmanager。因为我们在查询端需要配置Prometheus的rules,来实现报警。但是出于性能的考虑,VictoriaMetrics并不支持prometheus remote-read。此时有两种方式:
第一种,我们fork 了vmselect 组件,增加了对remote-read支持(remote-read的支持比较简单,大家可以参考任意的adapter,我曾经写过一个prometheus使用clickhouse作为长期存储的adapter,是否能实现的关键点在于对应的存储是否支持正则查询),那么我们的架构应该如下:
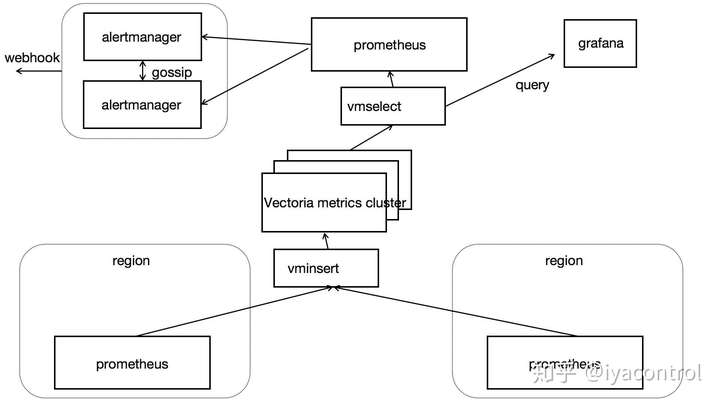
如果不愿意fork代码,此时官方推荐的是使用promxy组件来解决。
我们将查询端的Prometheus 替换成Promxy组件。promxy中配置promethues数据源(由于VictoriaMetrics本身支持Prometheus的API,这里直接对接VictoriaMetrics即可),promxy对外提供唯一的访问入口。
Promxy的配置文件,包含了prometheus的配置文件(可以配置alert rule和record rule)和自己的配置文件。示例如下:
  config.yaml: |
    ##
    ## Regular prometheus configuration
    ##
    global:
      evaluation_interval: 5s
      external_labels:
        source: promxy
    # remote_write configuration is used by promxy as its local Appender, meaning all
    # metrics promxy would "write" (not export) would be sent to this. Examples
    # of this include: recording rules, metrics on alerting rules, etc.
    remote_write:
      - url: http://localhost:8083/receive
    ##
    ### Promxy configuration
    ##
    promxy:
      server_groups:
      - kubernetes_sd_configs:
        - role: pod
第三种方案是直接使用vmalert组件,在写本文的时候,该组件没有提供,现在补上。应该说使用vmalert是最好的解决方案。
结论
本文简单介绍了VictoriaMetrics的架构和运维。并给出了VictoriaMetrics+prometheus的解决方案。
来源 https://zhuanlan.zhihu.com/p/135931181
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999831/viewspace-3121062/ ,如需转载,请注明出处,否则将追究法律责任。

