如何不改变 PostgreSQL 列类型
开发应用程序并在其背后操作数据库集群时,会遇到一个意想不到的问题是实践与理论、开发环境与生产之间的差异。这种不匹配的一个完美例子就是更改列类型。

关于如何在 PostgreSQL(以及其他符合 SQL 标准的系统)中更改列类型的常规知识是:

这显然是语义上正确的方式,但是在适当的情况下,您可能会遇到相当不愉快的意外。
问题
让我们创建一个示例表并演示您可能观察到的孤立行为。让我们从 1000 万行开始(这实际上只是整个数据世界中的一小部分)。
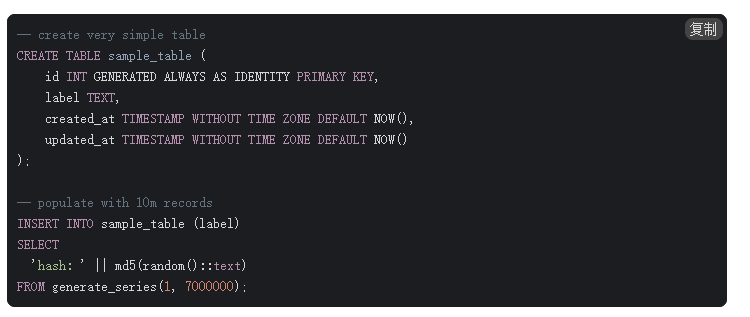
我们将 id 类型从 INT 改为 BIGINT。
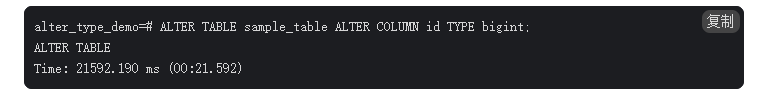
然后... 21 秒后,您就得到了更改。请注意,这是一个小表,其中大约有 600 MB 的数据。如果您要面对 100 倍于这个数量的情况怎么办?让我们看看幕后发生了什么。
PostgreSQL 必须做的事情
更改数据类型(以及您可能会遇到的许多其他操作)并非易事,PostgreSQL 引擎必须执行多项任务:
- 重写表 是最明显的罪魁祸首。将列从 INT 更改为 BIGINT 需要为每个元组(嗯,想想行)分配 4 个额外的字节。由于原始表模式需要固定数量的字节,因此集群以最有效的方式存储它们。也就是说,必须使用正确的元组大小读取和重写每一行(在我们的示例中为 1000 万行)。
- 在我们的综合示例中,锁 可能不是问题,但如果您在生产中使用数百或数千个并发查询执行 ALTER 命令,则您必须等待所有查询释放锁。
- 索引和约束 - 如果要更改的列已编入索引或有约束,则需要重建/重新验证它们。这是额外的开销。
- 事务和预写日志 是问题的另一个重要部分。为了保证持久性(ACID 中的“D”),PostgreSQL 必须在 WAL 文件中记录每个更改。这样,如果数据库崩溃,系统可以重放 WAL 文件以重建自上次检查点以来丢失的修改。
如您所见,执行一些可能被理解为常规表维护的操作涉及很多内容。修改的数据的大小、磁盘 I/O 和容量以及一般系统拥塞都会发挥作用。
但真正的问题并没有就此结束。如果我们谈论的是任何类型的严肃生产部署,你必须考虑更多的事情:
- 实时 复制 (包括物理和逻辑复制):这增加了额外的复杂性。对于只读副本,默认行为可确保维护同步提交以实现整个数据库集群的一致性。此设置可保证只有在所有备用副本都确认收到更改后,事务才会完成。然而,这带来了新的挑战,因为性能现在还取决于网络吞吐量(包括潜在的拥塞)以及备用节点的延迟和 I/O 性能。
- 恢复和备份 是另一个需要考虑的重要领域。虽然常规备份的大小可能不会受到太大影响,但您必须考虑更改前的最后一次备份与下一次备份之间发生的所有事情,并确保时间点一致性。
- 不太常见但并非闻所未闻的可能是 异步副本 或 逻辑复制 的保留槽。生成大量更改(以及 WAL 文件)可能会使性能较差(或不频繁)的复制系统落后相当长的时间。虽然这可能是可以接受的,但您需要确保源系统有足够的磁盘空间来保存 WAL 文件足够长的时间
如您所见,更改列数据类型并不像看起来那么简单。当前的 CI/CD 实践通常使软件开发人员能够非常轻松地提交数据库迁移并将其推广到生产环境,但几分钟后他们就会发现自己处于生产事件之中。虽然暂存部署可能会有所帮助,但它不能保证与生产具有相同的特征(无论是由于负载水平还是资金限制)。
因此,问题在于(我会重复一遍),修改的数据量的规模、系统的整体拥塞程度、 I/O 容量以及目标表在应用程序设计中的重要性。
归根结底,这转化为完成迁移所需的 总时间 ,以及您的企业可以或可能无法承受的独特限制。解决该问题最简单的方法是将计划维护安排在流量较低的时段并完成它。
如何安全地更改 PostgreSQL 列类型
如果您需要重写数百 GB 甚至 TB 的数据,并且无法承受超过最低限度的停机时间,该怎么办?让我们探索如何正确更改列类型。
让我们先从 坏消息 开始——你无法避免重写整个表,这将在此过程中生成大量 WAL 文件。这是必然的,你必须计划如何管理它。
好消息: 您可以将潜在的停机时间分散到比处理数据所需的更长的时间段。具体要求和限制将根据各个业务需求而有所不同,因此仔细规划至关重要。
完整的迁移可以概括为以下一系列步骤:
-
向目标表添加具有正确类型的新列
。确保该列可以为 NULL 且没有默认值,以避免强制重写整个表
1
。例如,如果您需要增加 ID,则
order_id最终会得到新列new_order_id。 - 设置一个触发器 ,在有新数据进入时更新新列。这可确保迁移期间的所有新数据都将填充新列。
- 实现一个函数或逻辑,以便随着时间的 推移批量将 值从旧列迁移到新列。批次的大小和时间应与您的业务/环境的运营约束相一致。
- 迁移旧值: 根据您的约束、数据大小和 I/O 功能,此过程可能需要数小时到数周甚至更长时间。虽然在终端会话中运行的 SQL 或 PL/pgSQL 函数(考虑使用 tmux)可能足以完成较短的迁移,但更长的迁移可能需要更复杂的方法。仅此主题就可以成为单独的博客文章或指南的好主题。
- 迁移完成后, 创建反映新列的约束和索引 。注意潜在的锁定问题,尤其是当该字段是任何外键的一部分时。
此时,您已准备好执行切换本身。如果您可以验证所有行都已正确填充新列,那么是时候接受最困难的部分了。如果可能的话,在一个事务中或更短的计划停机时间内完成
- 删除旧列 。此操作通常只会短暂锁定表。
- 删除旧列后, 重命名新列 。此步骤完成了大部分迁移过程。
考虑重新启动所有依赖于更改的表的应用程序是一种很好的做法,因为某些工具(ORM......我正在看你)可能会缓存 OID 并且不能很好地处理更改。
就是这样 - 但事实并非如此。删除列只会删除引用,数据本身将物理保留在磁盘上。这是您可能需要执行的场景
VACUUM FULL
- 这可能会锁定表并完全重写它 - 可能会破坏并发迁移的目的。这让我们回到了促使我撰写本指南的原始文章 - [[The Bloat Busters:pg_repack vs pg_squeeze]] 是必经之路。强烈建议提前准备并熟悉这些工具。
结论
虽然更改 PostgreSQL 中的列类型可能像发出 ALTER TABLE 命令一样简单,但对于所有参与其中的人来说,了解与之相关的复杂性非常重要。无论您是请求更改的软件开发人员、审核人员,还是在没有仔细规划的情况下将此类更改部署到生产环境时负责解决事件的个人,深入了解此过程都至关重要。此外,掌握这一特定变化使您能够轻松地将洞察力投射到其他可能代价高昂的操作上。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69998444/viewspace-3020328/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- PostgreSQL Certified Master 专访 | 第三期 李洋
- 【PGCCC】在 Postgres 中构建复制安全的 LSM 树
- 【PGCCC】PostgreSQL 18 Beta 1发布,有哪些亮点?
- 【PGCCC】Redash:一个开源的数据查询与可视化工具
- 【PGCCC】PostgreSQL Certified Master 个人专访 | 第一期 王丁丁
- 【PGCCC】PostgreSQL 的弊端(第一部分):临时表
- 【PGCCC】pg_squeeze 1.8:自动表膨胀清理的扩展
- 【PGCCC】commit_delay 对性能的提升:PostgreSQL 基准测试
- 【PGCCC】在 PostgreSQL 上使用 pg_hint_plan替换 Oracle Hints 的最佳实践
- 【PGCCC】表级锁剖析:减少锁定影响
