ITPub博客

首页 > 人工智能 > 人工智能 > 达观OCR首创无锚点文字提取算法,攻克行业难点

达观OCR首创无锚点文字提取算法,攻克行业难点

原创 人工智能 作者:达观数据DataGrand 时间:2022-02-18 11:05:24 0 删除 编辑
lQLPDhspQpU0cCbNAczNBDiwZp7WMcaK88sCFEYSWwCXAA_1080_460

达观OCR平台基于自主研发的视觉技术,结合知识增强的跨模态语义理解关键技术,提供 图像矫正、图像分割、版面标签分类、文字识别、信息扣取、文档比对、表格识别、文字过滤、信息审核、文字二次加工等一整套全流程OCR模型定制与应用能力。

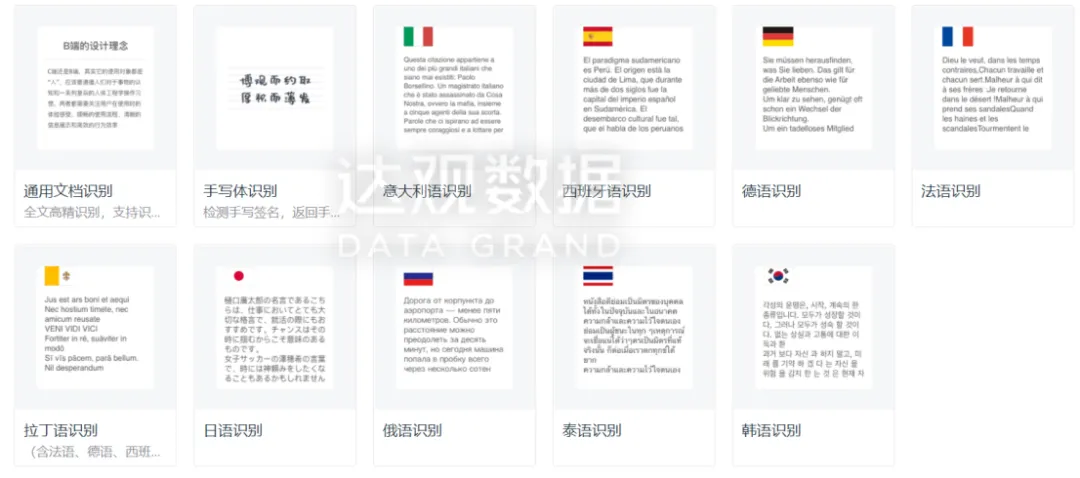
多语言识别

达观自研OCR支持包括中文、英文、繁体中文、日语、韩语、德语、法语、西班牙语在内的 数十种语言识别。

lQLPDhspQpjH94fNAd7NBDiwV1TD_5Bv0i0CFEYYkkDiAA_1080_478

文档理解

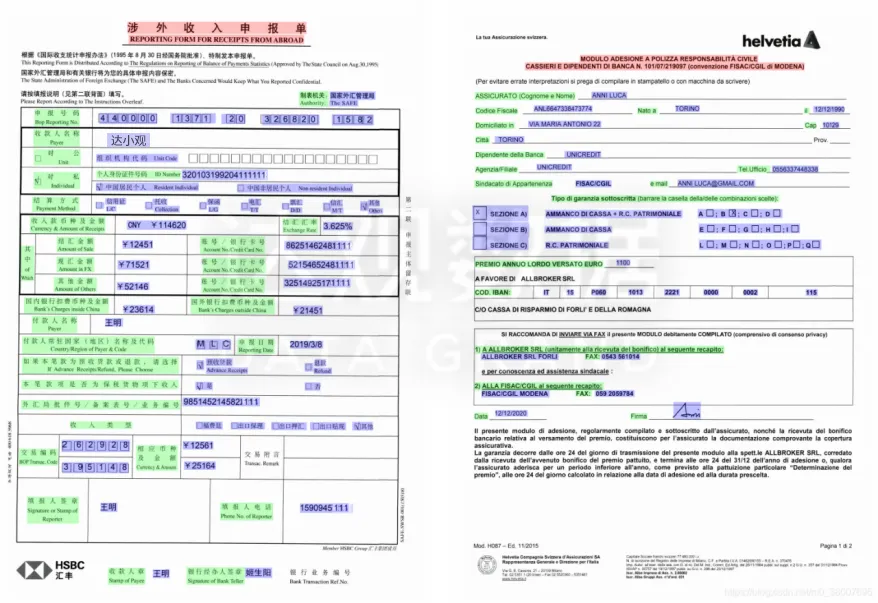
文档智能是文档信息识别与处理最重要的环节。达观OCR基于百万级文档数据预训练跨模态理解模型,借鉴人类阅读理解方式,综合文本、布局和图像信息、 让计算机像人一样理解文档版面布局、语义信息。

lQLPDhspQpvC6C3NAlvNA26wpeGscw163nACFEYdZACaAA_878_603

信息抽取

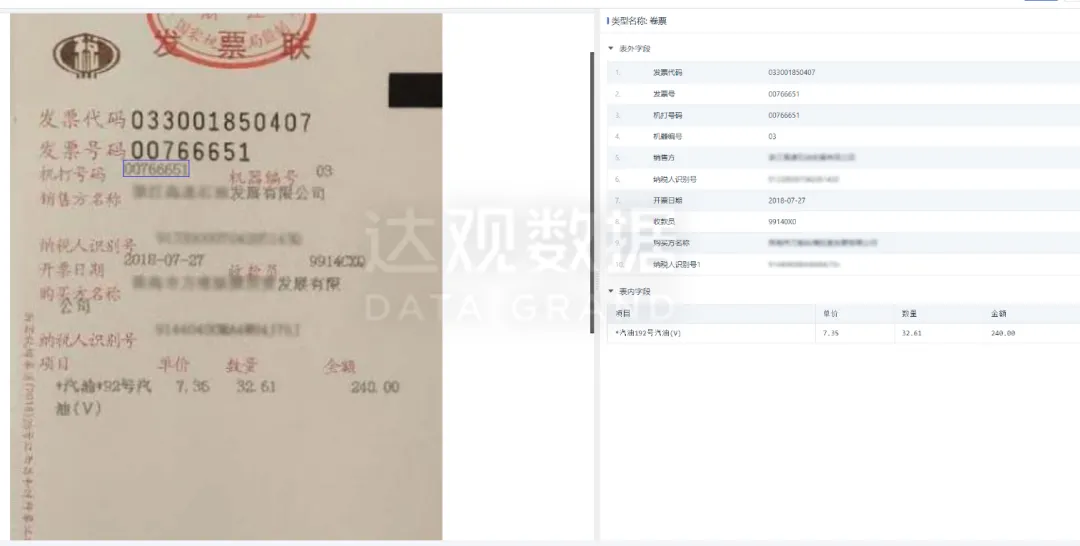
达观OCR采用机器学习来读取和处理任何类型的文档,可以精确地提取文本、手写字、表格和其他数据,无需人工干预,快速自动处理文档。无论是自动信贷审批单还是财务报销发票,都可在 数秒内完成关键信息提取,此外还可以添加人工审核,对模型提供监督,并对敏感数据执行审核。

lQLPDhspQp691ivNAiLNBDiwGi74YOfOAIoCFEYiXoCXAA_1080_546

表格识别

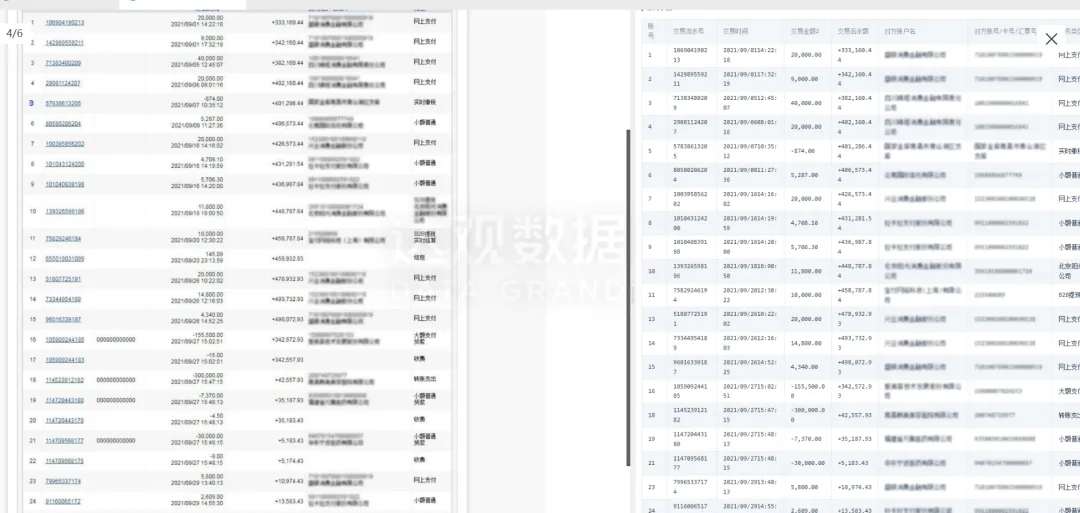
复杂表格识别一直是行业难点。各种文档表格样式不一、排版极为复杂。为此,达观OCR表格识别算法采用空间位置关系特征结合语义信息,快速定位表格位置、还原表格结构、循环抽取重要信息、输出结构化表格数据。

lQLPDhspQqG4x6jNAgHNBDiwSj_nKhVyW4YCFEYnSMDiAA_1080_513

手写文字识别

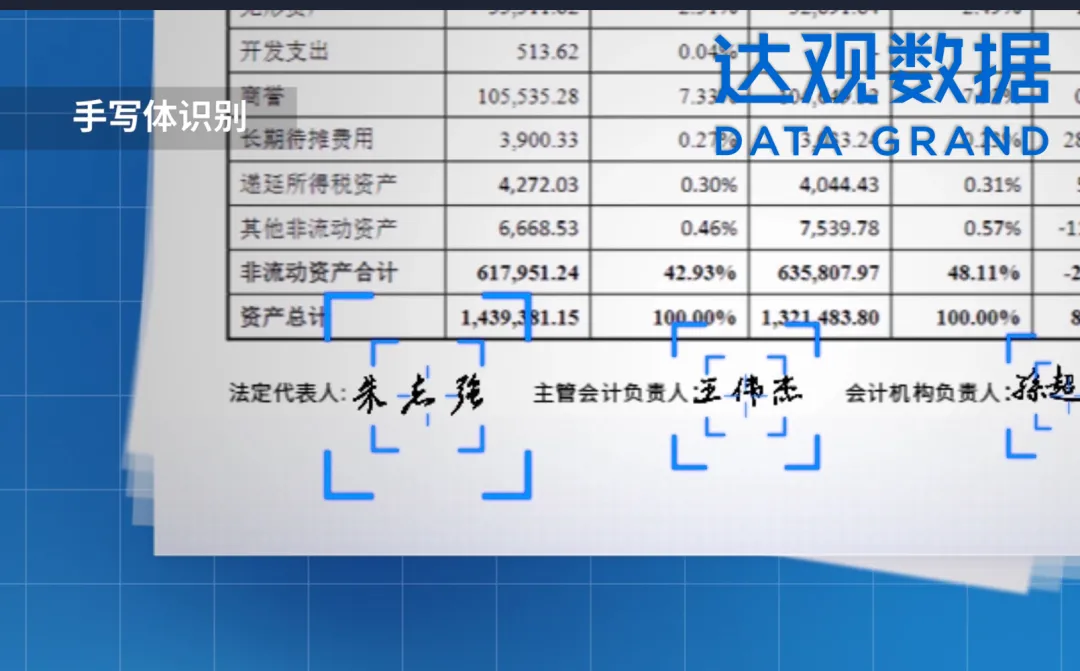
达观自研OCR支持对图片中的手写中文、手写数字进行检测和识别,针对 不规则的手写字体进行专项优化识别,确保识别精度。

lQLPDhspQqQbIr3NAp_NBDiwXqPdDwFh9CQCFEYreQCaAA_1080_671

零门槛自主建模

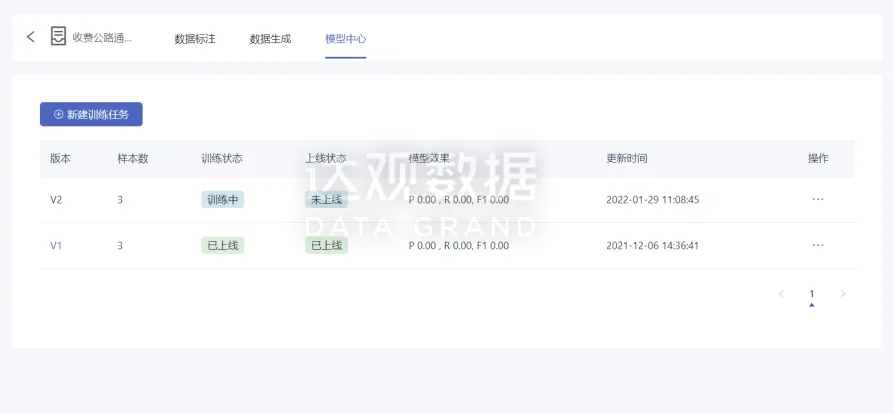
达观OCR 首创 无锚点文字提取算法,支持 可视化拖拽建模,无需人工版式配置或代码开发,鼠标拖拽即可训练模型。模型可自动对图像拍照扭曲透视、二次打印偏移等情形进行矫正识别,自适应 多种变化样式,1个模型即可覆盖,无需考虑同种票 据的多种变化。

lQLPDhspQqcWEHLNAZ7NA36w8xBYWMd4RMQCFEYv1cCXAA_894_414

OCR将图像文档上的数据转变成可由计算机识别理解的结构化数据,有效搭建知识桥梁,构建业务应用。达观OCR已服务于银行、证券、保险、汽车制造、医药等众多头部客户,每年产生数以亿级有效数据,为客户有效降本增效、防范风险、创造多元业务价值。


来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69997703/viewspace-2856301/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论 登录
全部评论

注册时间:2021-04-02

  • 博文量
    127
  • 访问量
    57396