提问:作为DBA运维的你是否遇到过这些烦恼
1、集群会话出现了大量的waiting for table flush,这是怎么产生的?
2、如何快速将数据库集群业务恢复到正常状态?
心中有章,遇事不慌
#包拯秘籍#
一整套故障排错及应对策略送给你,让你像包拯一样断案如神:
#首先
遇到此类问题后,我们要做到心中有章(章程),遇事不慌。一定要冷静,仔细了解故障现象(与研发/用户仔细沟通其反馈的问题,了解故障现象、操作流程、数据库架构等信息)
#其次
我们要根据故障现象进行初步分析。心中要想: 是什么原因 导致会话等待刷新锁大量出现?例如: 是SQL语句有错误,还是计算节点出了问题?
#然后
针对上述思考,我们需要逐步验证并排除,确定问题排查方向。
#接着
确定了问题方向,进行具体分析。通过现象得出部分结论,通过部分结论继续排查并论证。
#最后
针对问题有了具体分析后,再进行线下复现,最终梳理故障报告。
真刀实战,我们能赢
说了这么多理论,想必实战更让你心动。那我们就拿一个真实案例进行分析---某运营商项目要搭建一套数据库集群binlog server环境,需要dump一份集群元数据,因dump操作导致集群出现大量会话等待刷新锁,这种问题该如何快速分析处理:
1、故障发生场景
在项目现场兢兢业业准备搭建数据库环境的你,花了几分钟想dump一份元数据,几分钟都没导出来,就手动中断了dump操作,几分钟后收到运维反馈: 前台访问数据库报错can’t lock file了,DBA心中警铃大作,立马着手排查。
2、故障排查分析
DBA人员首先查询数据库集群状态,发现集群状态都是正常的。接着查询集群活跃会话,发现存在大量waiting for table flush的会话。

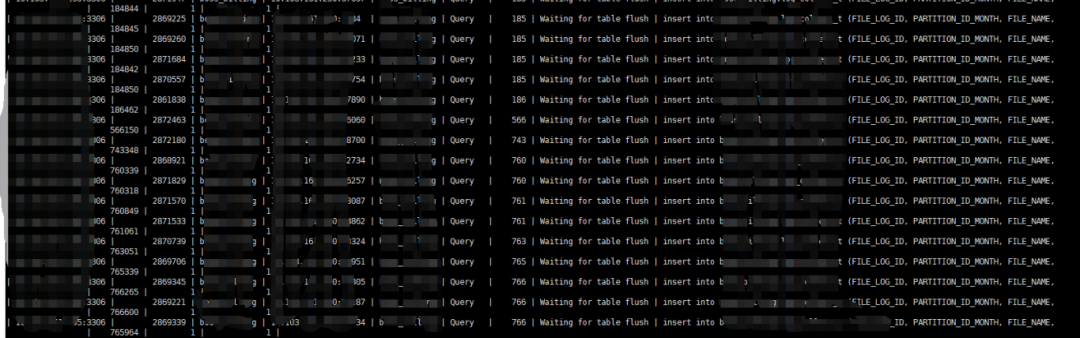
Waiting for table flush出现,一定是有会话发出flush tables或flush table with read lock命令。DBA人员浏览了全部会话,并未发现flush tables相关命令,因此联想到刚刚那个未成功备份的操作,怀疑是备份惹的祸。但备份操作已经中止, 为什么仍有那么多会话在waiting for table flush 呢? 一时间没有搞清原因,但解决问题是首要的,当务之急是先处理故障。
3、故障处理
查询全局会话,执行下面语句:
select * from information_schema.greatdb_global_processlists where command!='sleep' order by time;

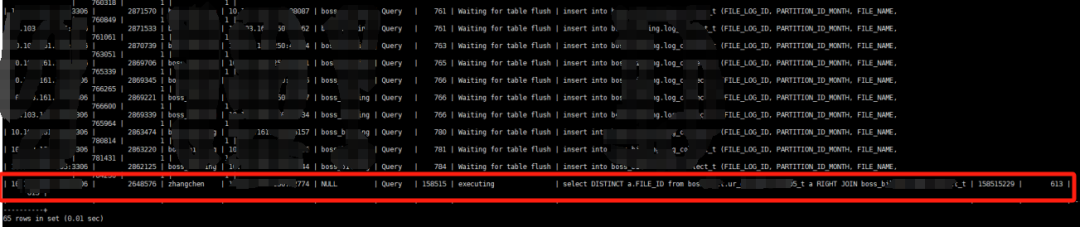
通过排查,找到比waiting for table flush会话耗时长的语句,发现有一条个人账户执行的SQL语句已经执行了15万秒。根据显示的计算节点IP信息,登录对应计算节点,将此会话kill掉,问题就迎刃而解了,再去查询其他全局会话视图,会发现那些waiting for table flush的语句已经全部消失,数据库集群业务恢复正常,因此 主要原因是刚才那个SQL语句执行了长查询,才会导致大量会话等待刷新锁的出现。
复盘总结
对于DBA而言,一是尽量不要在业务高峰期进行备份操作,二是要明确自己发出的备份命令是否会触发flush tables命令。如使用greatsqldump进行备份,--flush logs --single-transaction一起使用时,或者带选项--source-data而不带选项--single-transaction时,都会发出flush tables命令;
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69997641/viewspace-3018067/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 包拯断案 | 数据库从库GTID在变化 为何没有数据写入@还故障一个真相
- GreatSQL 8.0.32-26全新发布 增强诸多新特性
- 包拯断案 | 数据库CPU突然飙升 怎么破@还故障一个真相
- 包拯断案 | 数据库从库复制延迟引发高可用风险 怎么破@还故障一个真相
- 项目纪实 | 业务不停机、升级0感知!万里数据库生产环境助力操作系统升级 获客户点赞
- 包拯断案 | 数据库集群主从节点GTID不一致怎么破@还故障一个真相
- 包拯断案 | MySQL5.7替换路上踩过的坑 一键get解决办法@还故障一个真相
- 项目纪实 | 版本升级操作get!GreatDB分布式升级过程详解
- 项目纪实 | MySQL核心源码分析 & 定位解决 万里数据库凭实力征服客户
- 包拯断案 | 数据库连接突然中断?别慌@还故障一个真相
