坏块是如何产生的, SSD 又是通过什么样的手段来发现和管理坏块,厂商建议的坏块管理策略存在什么样的问题,什么样的管理方法会更优,格式化硬盘会不对导致坏块表丢失, SSD 返修后产生哪些安全隐患,本文逐一进行阐述。
概述
坏块管理设计理念,关系到 SSD 可靠性和效率。 Nand Flash 厂商给出的坏块管理做法未必非常合理,在进行产品设计时,如果对一些异常条件考虑的不周的话,常常会导致一些预料之外的坏块产生。
例如,在测试多家不同主控 SSD 后发现因异常掉电而产生新增坏块的问题非常普遍,用搜索引擎搜索 “ 异常掉电产生坏块 ” 或者类似的关键词,会发现这个问题不仅仅存在于测试过程中,实际发生在终端用户身上的问题也非常之多。
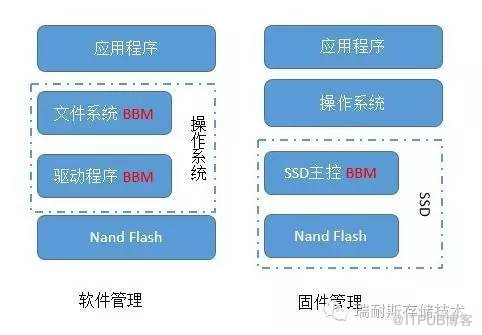
谁来管理坏块
对于没有专门闪存文件系统的主控来说,坏块可以通过 SSD controller 的固件来管理,对于专门的闪存文件系统来说,通过专门的闪存文件系统来或 Driver 来管理坏块。
坏块( Bad Block )分为三种:
1 、出厂坏块,或初始坏块,即出厂时因不符合厂商标准或厂商抽测过无法达到厂商公布标准的块,在出厂时已经被厂商标识为坏块;有些出厂坏块可以被 Erase ,有些不可以被 Erase ;
2 、使用过程中因为磨损造成的新增坏块或使用坏块;
3 、因异常掉电等原因被主控误判的假性坏块;
新增坏块并非全部是因磨损造成的,如果 SSD 没有异常掉电保护功能,因异常掉电可能会导致主控误判坏块或者真正的新增坏块产生。在没有异常掉电保护的情况下,如果 Lower page 已经编程成功,而在 Upper page 编程过程中突然掉电,必然会导致 Lower page 中的数据发送错误,如果数据错误数量超过 SSD ECC 纠错能力,那么就会在读取时出现错误, Block 会被主控判为 “Bad Block” 并标识到 bad block table 中。
新增的坏块有些是可以被 Erase 的,而且,新增坏块被 Erase 后重新进行数据读写擦操作未必会再次出错,因为出错与否与写入数据的 pattern 也有关系,使用某种 pattern 出错,更换另一种 pattern 有可能不会出错。
出厂坏块在整个 Device 中所占的比率
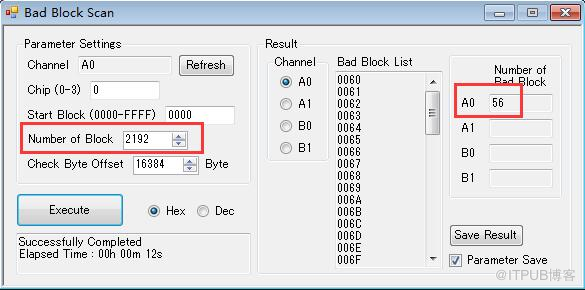
咨询过几家 Nand Flash 原厂,给出比较通用的说法是:出厂坏块的比率不超过 2% ,并且厂商会留一部分的余量,确保即使在达到厂商承诺的 P/E 次数最大限度时,仍然有不超过 2% 的坏块比率,好像保证 2% 并非一件很容易的事情,拿到某家新样品时的坏块比率超过了 2% ,实际测试为 2.55%
坏块的判定方法
1 、出厂坏块的判断方法
坏块的扫描基本都是扫描厂商指定地址所对应的 byte 是否有 FFh 标志,没有 FFh 则为坏块。
坏块标识的位置每个厂商大致相同,对于 SLC 和 MLC 来说,位置不同,以 Micron 为例:
1.1 对于小页( 528Byte )的 SLC 来说,每个 Block 的第一个 page 的 spare area 中的第六个 Byte 是否有 FFh 标志,如果没有就是坏块;
1.2 对于大页(大于等于 2112Byte )的 SLC 来说,每个 Block 的第一个 page 的 spare area 的第一个和第六个 Byte 是否有 FFh 标志,如果没有就是坏块;
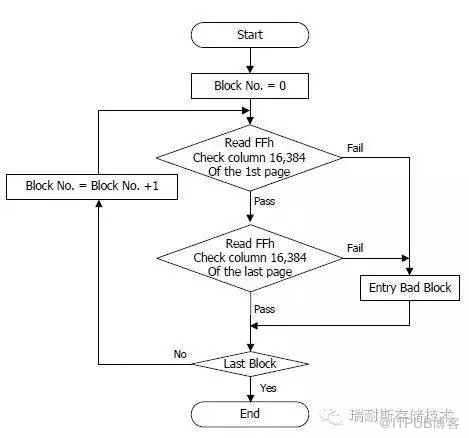
1.3 对于 MLC 来说,出厂坏块是通过扫描每个 Block 的第一个 page 和最后一个 page 的 spare area 区域的第一个或第二个 Byte 是否为 0xFF 标志,是 0xFF ,就是好快,没有 0xFF 就是坏块。
借用 Hynix datasheet 中的一张图来说明:
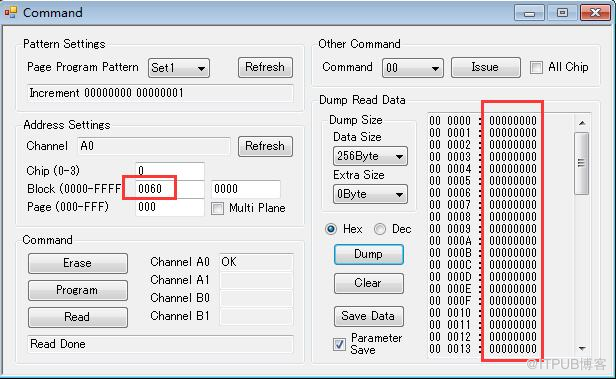
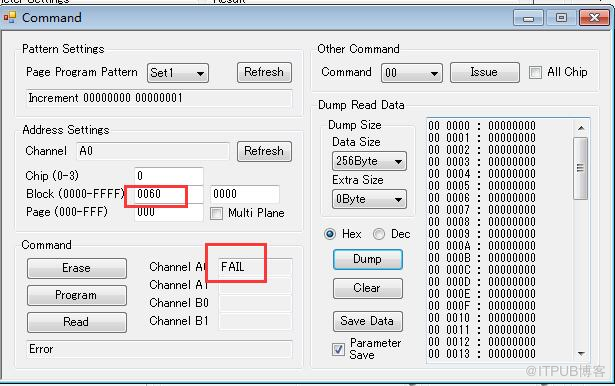
坏块里面是什么数据?全 0 还是全 1 ?测试看到的结果如下图示,当然,这未必是真相,出厂坏块可能真实如此,但新增坏块就未必了,否则通过 “ 坏块 ” 做数据隐藏岂不是无法实现:
出厂坏块能否擦除掉?
有些是 “ 可以 ” 擦除掉,有些则被厂商禁止擦除,所谓的 “ 可以 ” 擦除仅仅是指可以通过发送擦除命令将坏块标识改掉,而不是建议可以使用坏块。
厂商强烈建议是不要擦除坏块,坏块标志一旦被擦除,是无法 “ 恢复 ” 回来的,在坏块上写入数据是有风险的。
2 、使用过程中,新增坏块的判定方法
新增坏块是通过状态寄存器的反馈结果来判断对 Nand Flash 的操作是否成功,当 Program 或者 Erase 时,如果状态寄存器反馈为 fail ,则 SSD 主控会将此 Block 列为坏块。
具体来说:
2.1 、当执行擦除指令时出错;
2.2 、当执行写命令时出错;
2.3 、当执行读取命令时出错;当执行读取命令时,如果 bit 的错误数超过了 ECC 的纠错能力,该 Block 将被判为坏块。
坏块管理的方法
坏块是通过建立和更新坏块表( Bad Block Table : BBT )来进行管理的。坏块表的做法并没有统一的规范和做法,有些工程师用一个表来管理出厂坏块和新增坏块,有些工程师则会把两个表分开管理,有些工程师则把初始坏块作为单独的表,出厂坏块加新增坏块作为另外一个表。
对于坏块表的内容,表达方式也不尽一致,有些会表达的比较粗略,例如:使用 0 表示好快,用 1 表示坏块或者反之。而有些工程师则会使用更详细的描述方式,如:使用 00 表示出厂坏块, 01 表示 Program 失败时的坏块, 10 表示 Read 失败时产生的坏块, 11 表示 Erase 失败时产生的坏块。
坏块表一般会在独立的区域进行保存(如: Block0 , page0 和 Block1 , page1 ),每次通电后直接读取 BBT ,效率比较高,考虑到 Nand Flash 本身也会损坏,有可能导致 BBT 的丢失,因此,通常会将 BBT 做备份处理,备份多少份每家也不同,有人备份 2 份,也有人备份 8 份,通常情况下,可以借助概率论的表决系统进行计算,不管怎样,最起码也要 2 份以上吧。
坏块管理策略一般包括:坏块跳过策略和坏块替换策略;
坏块跳过策略
1 、对于初始坏块,坏块跳过会通过 BBT 将对应的坏块跳过,直接将数据存入下一个好块。
2 、对于新增的坏块,将此坏块更新到 BBT 中,将坏块中的有效数据转存到下一个好块中,以后每次再做相应的 Read 、 Program 或者 Erse 时直接跳过此坏块。
坏块替换策略(某 Nand Flash 厂商建议的做法)
坏块替换,是指使用预留区中的好块来替换使用过程中产生的坏块。假设,在 program 时,第 n 个 page 出现错误,那么在坏块替换策略下,会将 page0 到 page ( n-1 )中的数据拷贝到预留区的空闲 Block (例如 Block D )的相同位置,然后将数据寄存器中第 n 个 page 的数据写入 Block D 中的 page n 。
厂商的建议的做法是将整个数据区域划分为两部分,一部分是用户可见区域,用于用户正常的数据操作,另一部分为替换坏块专门准备的备用区域,用于存储替换坏块的数据以及保存坏块表,备用区域的比例为整个容量的 2% 。
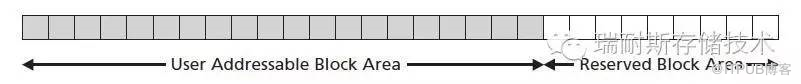
当有坏块产生时, FTL 会将 Bad Block 地址重新映射到保留区好块地址,而不是直接跳过坏块到下一个好块,在每次对逻辑地址写操作之前,都会先计算哪些物理地址可以写,哪些地址是坏块,如果是坏块,就将数据写入对应保留区的地址。
兵哥没有看到关于 2% 的预留区域是否需要包含在 OP 区域之内还是额外的区域之类的建议,也没有看到 2% 的保留区域是动态还是静态的描述,加入是独立的区域且是静态区域,那么这种做法会有如下弊端:
1 、直接保留 2% 的区域留作坏块替换,会造成可用容量的减少,浪费了空间,同时,由于可用块数量少,加快了可用坏的平均磨损次数; 2 、假设可用区域坏块超过 2% 时,也就是说预留替换的区域全部被替换完,再产生的坏块将无法处理, SSD 将因此而面临寿命终结。
坏块替换策略(部分 SSD 厂商的做法)
事实上,在真正的产品设计中,很少见到有单独预留 2% 比率作为坏块替换区域的做法,一般情况下,会使用 OP ( Over Provison )区 free block 来替代在使用过程中新增的坏块,以垃圾回收为例,当垃圾回收机制运行时,先将需要回收的 Block 中的有效 page 数据搬迁到 free Block 中,然后对此 Block 进行 Erase 操作,假设此时 Erase 状态寄存器反馈 Erase 失败,则坏块管理机制会将此 Block 地址更新到新增坏块列表中,同时,将坏块中的有效数据页写入到 OP 区的 Free Block 中,更新坏块管理表,下次写入数据时,直接跳过坏块到下一个可用块。
OP 大小不同厂商的设定是不同的,应用场景不同,对可靠性要求不同, OP 大小也会不同, OP 和稳定性之间存在取舍关系, OP 越大,在持续写入的过程中,垃圾回收可用空间越大,性能就越稳定,表现出的性能曲线就越平滑,反之, OP 越小,性能稳定性就越差,当然,用户可用空间就越大,可用空间大就意味着成本更低。
一般而言, OP 可以设定为 5%-50% , 7% 的 OP 是常见的比例,与厂商建议的 2% 固定的区块不同的是, 7% 并不是固定的某些 Block 做 OP ,而是动态分布于所有的 Block 中,这样更加有利于磨损平衡策略。
SSD 维修的后患
对于大多数没有拥有主控技术的 SSD 厂商而言,如果产品返修,通常的做法是更换故障器件后进行重新量产操作,此时,新增坏块列表将会丢失,丢失新增坏块表就意味着没有更换的 Nand Flash 中其实已经存在坏块,操作系统或者敏感数据有可能会被写入到坏块区域,很有可能造成用户操作系统崩溃。即使对于有主控的厂商而言,是否会替用户保存已经存在的坏块列表,要看厂商面对的用户的态度了。
坏块产是否会影响 SSD 的读写速度和稳定性
出厂坏块在 bitline 上会被独立出来,因此不会影响其他 Block 的擦写速度,但是,如果整个 SSD 的新增坏块足够多的话,整盘可用 Block 减少,会导致垃圾回收次数增加,同时, OP 容量减少,会严重影响垃圾回收效率,因此,坏块增加到一定级别会对 SSD 的性能稳定性产生影响,尤其是在持续对 SSD 进行写入操作时,因为系统进行垃圾回收,会导致性能下降, SSD 性能曲线会出现较大幅度波动。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69997038/viewspace-2766589/ ,如需转载,请注明出处,否则将追究法律责任。

