一、HBase概述
Apache HBase 是 Hadoop 数据库,一个分布式、可伸缩的 大数据存储。
HBase是依赖Hadoop的。为什么HBase能存储海量的数据? 因为HBase是在HDFS的基础之上构建的,HDFS是分布式文件系统。
二、为什么要用HBase
HBase在HDFS之上提供了 高并发的随机写和支持实时查询, 存储数据的”结构“可以地非常灵活,这是HDFS不具备的。把数据存储在如下介质中带来的弊端:
- MySQL?MySQL数据库我们是算用得最多了的吧?但众所周知,MySQL是 单机的。MySQL能存储多少数据,取决于那台服务器的硬盘大小。以现在互联网的数据量,很多时候MySQL是没法存储那么多数据的。比如我这边有个系统,一天就能产生1TB的数据,这数据是不可能存MySQL的。(如此大的量数据,我们现在的做法是先写到Kafka,然后落到Hive中)
- Kafka?Kafka我们主要用来处理消息的(解耦异步削峰)。数据到Kafka,Kafka会将数据持久化到硬盘中,并且Kafka是分布式的(很方便的扩展),理论上Kafka可以存储很大的数据。但是Kafka的数据我们 不会「单独」取出来。持久化了的数据,最常见的用法就是重新设置offset,做「回溯」操作
- Redis?Redis是缓存数据库,所有的读写都在内存中,速度贼快。AOF/RDB存储的数据都会加载到内存中,Redis不适合存大量的数据(因为内存太贵了!)。
- Elasticsearch?Elasticsearch是一个分布式的搜索引擎,主要用于检索。理论上Elasticsearch也是可以存储海量的数据(毕竟分布式),我们也可以将数据用『索引』来取出来,似乎已经是非常完美的中间件了。但是如果我们的数据 没有经常「检索」的需求,其实不必放到Elasticsearch,数据写入Elasticsearch需要分词,无疑会浪费资源。
-
HDFS?显然HDFS是可以存储海量的数据的,它就是为海量数据而生的。它也有明显的缺点:不支持随机修改,查询效率低,对小文件支持不友好。
三、入门HBase
听过HBase的同学可能都听过「列式存储」这个词。我最开始的时候觉得HBase很难理解,就因为它这个「列式存储」我一直理解不了它为什么是「列式」的。
在网上也有很多的博客去讲解什么是「列式」存储,它们会举我们现有的数据库,比如MySQL。存储的结构我们很容易看懂,就是一行一行数据嘛。
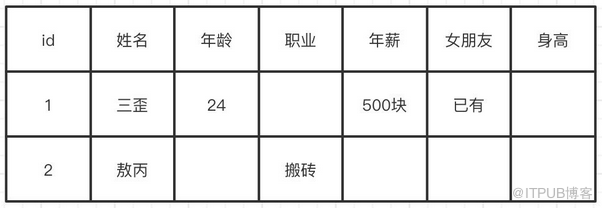
转换成所谓的列式存储是什么样的呢?
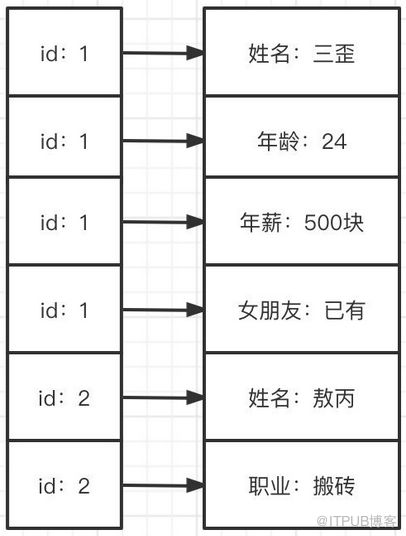
HBase里边也有表、行和列的概念。
- 表没什么好说的,就是一张表
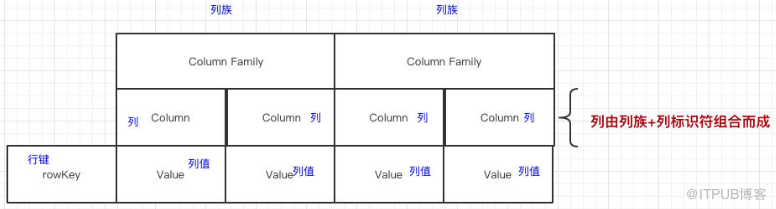
- 一行数据由 一个行键和 一个或多个相关的列以及它的值所组成
好了,现在比较抽象了。在HBase里边,定位一行数据会有一个唯一的值,这个叫做行键( RowKey)。而在HBase的列不是我们在关系型数据库所想象中的列。
HBase的列( Column)都得归属到列族( Column Family)中。在HBase中用列修饰符( Column Qualifier)来标识每个列。
在HBase里边,先有列族,后有列。
什么是列族?可以简单理解为:列的属性 类别
什么是列修饰符? 先有列族后有列,在列族下用列修饰符来标识一列。
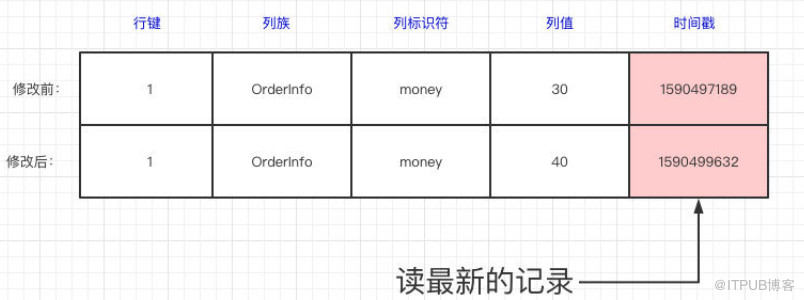
数据写到HBase的时候都会被记录一个 时间戳,这个时间戳被我们当做一个 版本。比如说,我们 修改或者删除某一条的时候,本质上是往里边 新增一条数据,记录的版本加一了而已。
比如现在我们有一条记录:
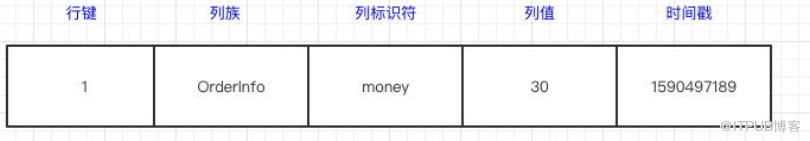
现在要把这条记录的值改为40,实际上就是多添加一条记录,在读的时候按照时间戳 读最新的记录。在外界「看起来」就是把这条记录改了。
HBase 的Key-Value
HBase本质上其实就是
Key-Value的数据库,上一次我们学
Key-Value数据库还是Redis呢。那在HBase里边,Key是什么?Value是什么?
我们看一下下面的HBase
Key-Value结构图:
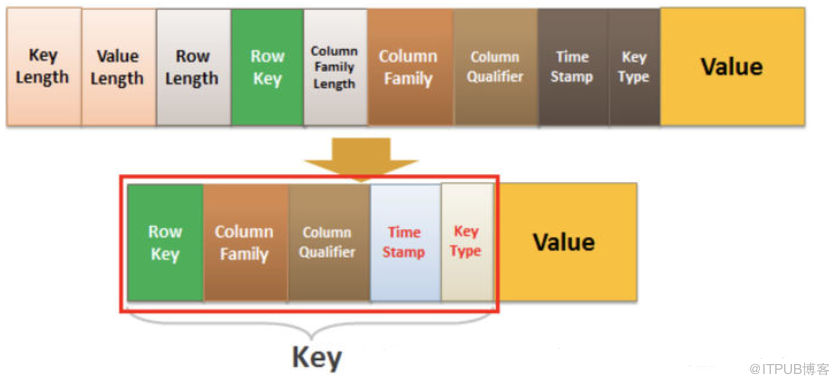
Key由RowKey(行键)+ColumnFamily(列族)+Column Qualifier(列修饰符)+TimeStamp(时间戳--版本)+KeyType(类型)组成,而Value就是实际上的值。
对比上面的例子,其实很好理解,因为我们修改一条数据其实上是在原来的基础上增加一个版本的,那我们要 准确定位一条数据,那就得(RowKey+Column+时间戳)。
KeyType是什么?我们上面只说了「修改」的情况,你们有没有想过,如果要删除一条数据怎么做?实际上也是增加一条记录,只不过我们在KeyType里边设置为“Delete”就可以了。
HBase架构
扯了这么一大堆,已经说了HBase的数据模型和Key-Value了,我们还有一个问题:「为什么经常会有人说HBase是列式存储呢?」
其实HBase更多的是「 列族存储」,要谈列族存储,就得先了解了解HBase的架构是怎么样的。
我们先来看看HBase的架构图:
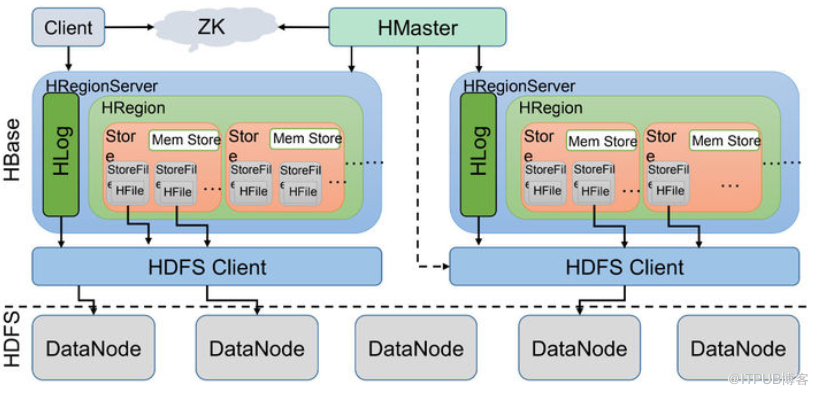
1、 Client客户端,它提供了访问HBase的接口,并且维护了对应的cache来加速HBase的访问。
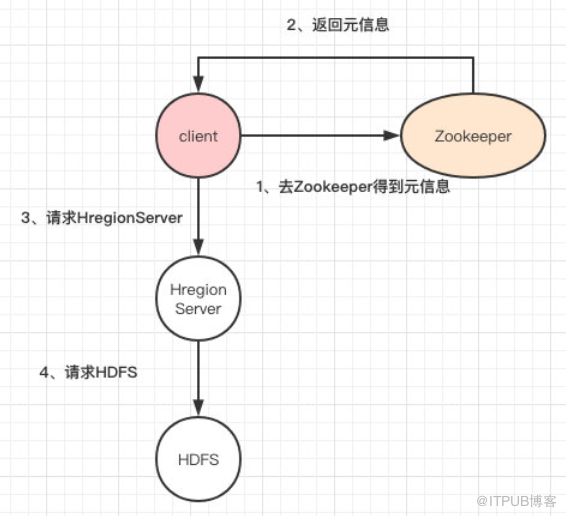
2、 Zookeeper存储HBase的元数据(meta表),无论是读还是写数据,都是去Zookeeper里边拿到meta元数据 告诉给客户端去哪台机器读写数据
3、 HRegionServer它是处理客户端的读写请求,负责与HDFS底层交互,是真正干活的节点。
总结大致的流程就是:client请求到Zookeeper,然后Zookeeper返回HRegionServer地址给client,client得到Zookeeper返回的地址去请求HRegionServer,HRegionServer读写数据后返回给client。
HRegionServer内部
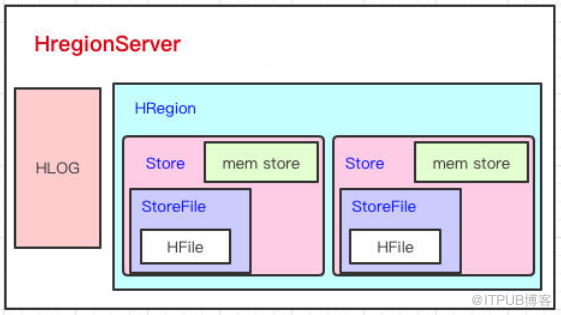
前面也提到了,HBase可以存储海量的数据,HBase是分布式的。所以我们可以断定: HBase一张表的数据会分到多台机器上的。那HBase是怎么切割一张表的数据的呢?用的就是 RowKey来切分,其实就是表的 横向切割。
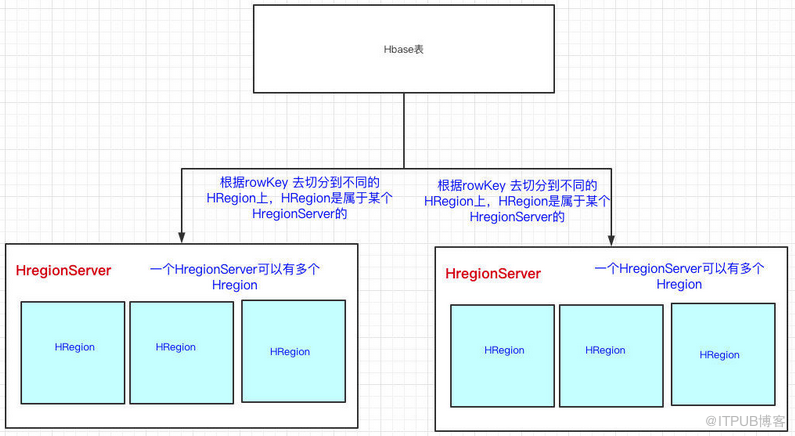
说白了就是一个 HRegion上,存储HBase表的一部分数据。
HRegion下面有 Store,那Store是什么呢?我们前面也说过,一个HBase表首先要定义 列族,然后列是在列族之下的,列可以随意添加。
一个列族的数据是存储在一起的,所以一个列族的数据是存储在一个Store里边的。
看到这里,其实我们可以认为HBase是基于列族存储的(毕竟物理存储,一个列族是存储到同一个Store里的)
HBase在写数据的时候,会先写到
Mem Store,当
MemStore超过一定阈值,就会将内存中的数据刷写到硬盘上,形成
StoreFile,而
StoreFile底层是以
HFile的格式保存,
HFile是HBase中
KeyValue数据的存储格式。
所以说:
Mem Store我们可以理解为内存 buffer,
HFile是HBase实际存储的数据格式,而
StoreFile只是HBase里的一个名字。
稍微总结一把:
- HRegionServer是真正干活的机器(用于与hdfs交互),我们HBase表用RowKey来横向切分表
- HRegion里边会有多个Store,每个Store其实就是一个列族的数据(所以我们可以说HBase是基于列族存储的)
- Store里边有Men Store和StoreFile(HFile),其实就是先走一层内存,然后再刷到磁盘的结构
四、RowKey的设计
到这里,我们已经知道RowKey是什么了。不难理解的是,我们肯定是要保证RowKey是 唯一的,毕竟它是行键,有了它我们才可以唯一标识一条数据的。
在HBase里边提供了三种的查询方式:
- 全局扫描
- 根据一个RowKey进行查询
- 根据RowKey过滤的 范围查询
4.1 根据一个RowKey查询
首先我们要知道的是RowKey是会按 字典序排序的,我们HBase表会用RowKey来横向切分表。
无论是读和写我们都是用RowKey去定位到HRegion,然后找到HRegionServer。这里有一个很关键的问题: 那我怎么知道这个RowKey是在这个HRegion上的?
HRegion上有两个很重要的属性:
start-key和
end-key。
我们在定位HRegionServer的时候,实际上就是定位我们这个RowKey在不在这个HRegion的
start-key和
end-key范围之内,如果在,说明我们就找到了。
这个时候会带来一个问题:由于我们的RowKey是以字典序排序的,如果我们对RowKey没有做任何处理,那就有可能存在 热点数据的问题。
4.2根据RowKey范围查询
上面的情况是针对通过RowKey单个查询的业务的,如果我们是根据RowKey范围查询的,那没必要上面那样做。
HBase将RowKey设计为字典序排序,如果不做限制,那很可能类似的RowKey存储在同一个HRegion中。那我正好有这个场景上的业务,那我查询的时候不是快多了吗? 在同一个HRegion就可以拿到我想要的数据了。
举个例子:我们会间隔几秒就采集直播间热度,将这份数据写到HBase中,然后业务方经常要把主播的一段时间内的热度给查询出来。
我设计好的RowKey,将该主播的一段时间内的热度都写到同一个HRegion上,拉取的时候只要访问一个HRegionServer就可以得到全部我想要的数据了,那查询的速度就快很多。
最后
回顾一下这篇文章写了什么:
- HBase是一个NoSQL数据库,一般我们用它来存储海量的数据(因为它基于HDFS分布式文件系统上构建的)
- HBase的一行记录由一个RowKey和一个或多个的列以及它的值所组成。先有列族后有列,列可以随意添加。
- HBase的增删改记录都有「版本」,默认以时间戳的方式实现。
- RowKey的设计如果没有特殊的业务性,最好设计为散列的,这样避免热点数据分布在同一个HRegionServer中。
- HBase的读写都经过Zookeeper去拉取meta数据,定位到对应的HRegion,然后找到HRegionServer
注:内容整理自公众号Java3y,文章【我终于看懂了HBase,太不容易了...】
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69994536/viewspace-2763216/ ,如需转载,请注明出处,否则将追究法律责任。

