「TiDB 查询优化及调优」系列文章将通过一些具体的案例,向大家介绍 TiDB 查询及优化相关的原理和应用,在 上一篇文章 中我们简要介绍了 TiDB 查询优化器的优化流程。
查询计划(execution plan)展现了数据库执行 SQL 语句的具体步骤,例如通过索引还是全表扫描访问表中的数据,连接查询的实现方式和连接的顺序等。查阅及理解 TiDB 的查询计划是查询调优的基础。本文为系列文章的第二篇,将着重介绍 TiDB 查询计划以及如何查看。
算子及 Task
在上文的 TiDB 查询优化流程简介中有提到过,TiDB 的查询计划是由一系列的执行算子构成,这些算子是为返回查询结果而执行的特定步骤,例如表扫描算子,聚合算子,Join 算子等,下面以表扫描算子为例,其它算子的具体解释可以参看下文查看执行计划的小结。
执行表扫描(读盘或者读 TiKV Block Cache)操作的算子有如下几类:
- TableFullScan:全表扫描。
- TableRangeScan:带有范围的表数据扫描。
- TableRowIDScan:根据上层传递下来的 RowID 扫描表数据。时常在索引读操作后检索符合条件的行。
- IndexFullScan:另一种“全表扫描”,扫的是索引数据,不是表数据。
目前 TiDB 的计算任务分为两种不同的 task:cop task 和 root task。Cop task 是指使用 TiKV 中的 Coprocessor 执行的计算任务,root task 是指在 TiDB 中执行的计算任务。
SQL 优化的目标之一是将计算尽可能地下推到 TiKV 中执行。TiKV 中的 Coprocessor 能支持大部分 SQL 内建函数(包括聚合函数和标量函数)、SQL
LIMIT操作、索引扫描和表扫描。但是,所有的 Join 操作都只能作为 root task 在 TiDB 上执行。
利用 EXPLAIN 查看分析查询计划
与其它主流商业数据库一样,TiDB 中可以通过 EXPLAIN 语句返回的结果查看某条 SQL 的执行计划。
EXPLAIN 语句
目前 TiDB 的 EXPLAIN 主要输出 5 列,分别是:
id,
estRows,
task,
access object,
operator info。执行计划中每个算子都由这 5 列属性来描述,
EXPLAIN结果中每一行描述一个算子。每个属性的具体含义如下:
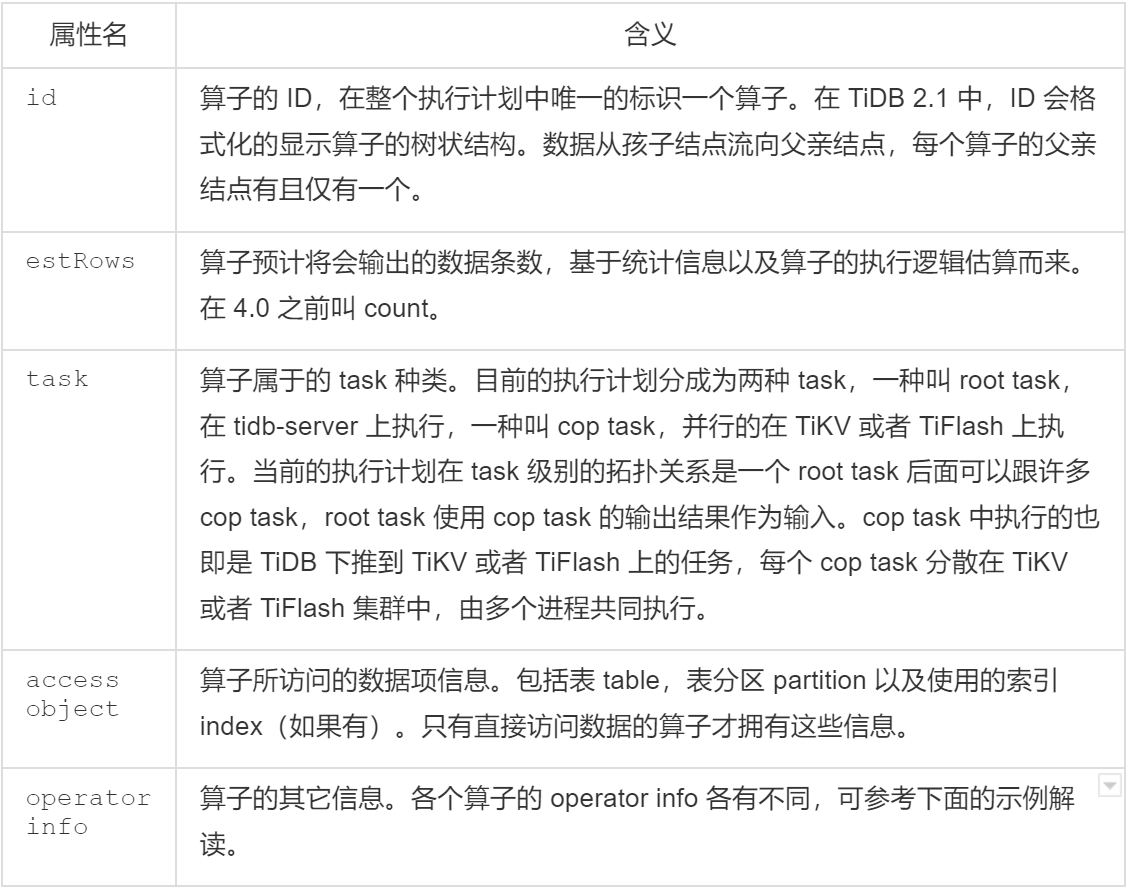
EXPLAIN ANALYZE 语句
和
EXPLAIN不同,
EXPLAIN ANALYZE会执行对应的 SQL 语句,记录其运行时信息,和执行计划一并返回出来,可以视为
EXPLAIN语句的扩展。
EXPLAIN ANALYZE语句的返回结果中增加了
actRows,
execution info,
memory,
disk这几列信息:
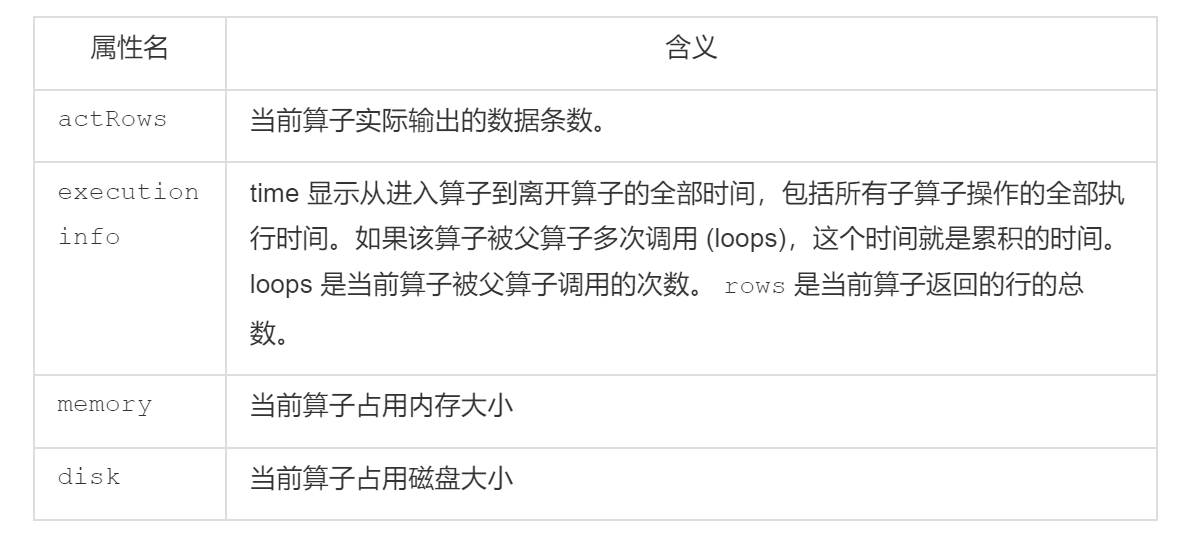
例如在下例中,优化器估算的
estRows和实际执行中统计得到的
actRows几乎是相等的,说明优化器估算的行数与实际行数的误差很小。同时
IndexLookUp_10算子在实际执行过程中使用了约 9 KB 的内存,该 SQL 在执行过程中,没有触发过任何算子的落盘操作。
mysql> explain analyze select * from t where a < 10;+-------------------------------+---------+---------+-----------+-------------------------+------------------------------------------------------------------------+-----------------------------------------------------+---------------+------+| id | estRows | actRows | task | access object | execution info | operator info | memory | disk |+-------------------------------+---------+---------+-----------+-------------------------+------------------------------------------------------------------------+-----------------------------------------------------+---------------+------+| IndexLookUp_10 | 9.00 | 9 | root | | time:641.245µs, loops:2, rpc num: 1, rpc time:242.648µs, proc keys:0 | | 9.23046875 KB | N/A || ├─IndexRangeScan_8(Build) | 9.00 | 9 | cop[tikv] | table:t, index:idx_a(a) | time:142.94µs, loops:10, | range:[-inf,10), keep order:false | N/A | N/A || └─TableRowIDScan_9(Probe) | 9.00 | 9 | cop[tikv] | table:t | time:141.128µs, loops:10 | keep order:false | N/A | N/A |+-------------------------------+---------+---------+-----------+-------------------------+------------------------------------------------------------------------+-----------------------------------------------------+---------------+------+3 rows in set (0.00 sec)
查看计划中算子的执行顺序
TiDB 的执行计划是一个树形结构,树中每个节点即是算子。考虑到每个算子内多线程并发执行的情况,在一条 SQL 执行的过程中,如果能够有一个手术刀把这棵树切开看看,大家可能会发现所有的算子都正在消耗 CPU 和内存处理数据,从这个角度来看,算子是没有执行顺序的。
但是如果从一行数据先后被哪些算子处理的角度来看,一条数据在算子上的执行是有顺序的。这个顺序可以通过下面这个规则简单总结出来:
Build总是先于
Probe执行,并且
Build总是出现
Probe前面
这个原则的前半句是说:如果一个算子有多个子节点,子节点 ID 后面有
Build关键字的算子总是先于有
Probe关键字的算子执行。后半句是说:TiDB 在展现执行计划的时候,
Build端总是第一个出现,接着才是
Probe端。例如:
TiDB(root@127.0.0.1:test) > explain select * from t use index(idx_a) where a = 1;+-------------------------------+---------+-----------+-------------------------+---------------------------------------------+| id | estRows | task | access object | operator info |+-------------------------------+---------+-----------+-------------------------+---------------------------------------------+| IndexLookUp_7 | 10.00 | root | | || ├─IndexRangeScan_5(Build) | 10.00 | cop[tikv] | table:t, index:idx_a(a) | range:[1,1], keep order:false, stats:pseudo || └─TableRowIDScan_6(Probe) | 10.00 | cop[tikv] | table:t | keep order:false, stats:pseudo |+-------------------------------+---------+-----------+-------------------------+---------------------------------------------+3 rows in set (0.00 sec)
这里
IndexLookUp_7算子有两个孩子节点:
IndexRangeScan_5(Build)和
TableRowIDScan_6(Probe)。可以看到,
IndexRangeScan_5(Build)是第一个出现的,并且基于上面这条规则,要得到一条数据,需要先执行它得到一个
RowID以后,再由
TableRowIDScan_6(Probe)根据前者读上来的
RowID去获取完整的一行数据。
这种规则隐含的另一个信息是: 在同一层级的节点中,出现在最前面的算子可能是最先被执行的,而出现在最末尾的算子可能是最后被执行的。
例如下面这个例子:
TiDB(root@127.0.0.1:test) > explain select * from t t1 use index(idx_a) join t t2 use index() where t1.a = t2.a;+----------------------------------+----------+-----------+--------------------------+------------------------------------------------------------------+| id | estRows | task | access object | operator info |+----------------------------------+----------+-----------+--------------------------+------------------------------------------------------------------+| HashJoin_22 | 12487.50 | root | | inner join, inner:TableReader_26, equal:[eq(test.t.a, test.t.a)] || ├─TableReader_26(Build) | 9990.00 | root | | data:Selection_25 || │ └─Selection_25 | 9990.00 | cop[tikv] | | not(isnull(test.t.a)) || │ └─TableFullScan_24 | 10000.00 | cop[tikv] | table:t2 | keep order:false, stats:pseudo || └─IndexLookUp_29(Probe) | 9990.00 | root | | || ├─IndexFullScan_27(Build) | 9990.00 | cop[tikv] | table:t1, index:idx_a(a) | keep order:false, stats:pseudo || └─TableRowIDScan_28(Probe) | 9990.00 | cop[tikv] | table:t1 | keep order:false, stats:pseudo |+----------------------------------+----------+-----------+--------------------------+------------------------------------------------------------------+7 rows in set (0.00 sec)
要完成
HashJoin_22,需要先执行
TableReader_26(Build)再执行
IndexLookUp_29(Probe)。而在执行
IndexLookUp_29(Probe)的时候,又需要先执行
IndexFullScan_27(Build)再执行
TableRowIDScan_28(Probe)。所以从整条执行链路来看,
TableRowIDScan_28(Probe)是最后被唤起执行的。
查看表扫描的执行计划
在上文介绍算子和任务时已经提到过表扫描算子,这里再稍微重复介绍一下,分为执行表扫描操作的算子和对扫描数据进行汇聚和计算的算子:
执行表扫描(读盘或者读 TiKV Block Cache)操作的算子有如下几类:
- TableFullScan:全表扫描。
- TableRangeScan:带有范围的表数据扫描。
- TableRowIDScan:根据上层传递下来的 RowID 扫描表数据。时常在索引读操作后检索符合条件的行。
- IndexFullScan:另一种“全表扫描”,扫的是索引数据,不是表数据。
- IndexRangeScan:带有范围的索引数据扫描操作。
TiDB 会汇聚 TiKV/TiFlash 上扫描的数据或者计算结果,这种“数据汇聚”算子目前有如下几类:
- TableReader:将 TiKV 上底层扫表算子 TableFullScan 或 TableRangeScan 得到的数据进行汇总。
- IndexReader:将 TiKV 上底层扫表算子 IndexFullScan 或 IndexRangeScan 得到的数据进行汇总。
- IndexLookUp:先汇总 Build 端 TiKV 扫描上来的 RowID,再去 Probe 端上根据这些
RowID精确地读取 TiKV 上的数据。Build 端是IndexFullScan或IndexRangeScan类型的算子,Probe 端是TableRowIDScan类型的算子。 - IndexMerge:和
IndexLookupReader类似,可以看做是它的扩展,可以同时读取多个索引的数据,有多个 Build 端,一个 Probe 端。执行过程也很类似,先汇总所有 Build 端 TiKV 扫描上来的 RowID,再去 Probe 端上根据这些 RowID 精确地读取 TiKV 上的数据。Build 端是IndexFullScan或IndexRangeScan类型的算子,Probe 端是TableRowIDScan类型的算子。
IndexLookUp 示例:
mysql> explain select * from t use index(idx_a);+-------------------------------+----------+-----------+-------------------------+--------------------------------+| id | estRows | task | access object | operator info |+-------------------------------+----------+-----------+-------------------------+--------------------------------+| IndexLookUp_6 | 10000.00 | root | | || ├─IndexFullScan_4(Build) | 10000.00 | cop[tikv] | table:t, index:idx_a(a) | keep order:false, stats:pseudo || └─TableRowIDScan_5(Probe) | 10000.00 | cop[tikv] | table:t | keep order:false, stats:pseudo |+-------------------------------+----------+-----------+-------------------------+--------------------------------+3 rows in set (0.00 sec)
这里
IndexLookUp_6算子有两个孩子节点:
IndexFullScan_4(Build)和
TableRowIDScan_5(Probe)。可以看到,
IndexFullScan_4(Build)执行索引全表扫,扫描索引
a的所有数据,因为是全范围扫,这个操作将获得表中所有数据的
RowID,之后再由
TableRowIDScan_5(Probe)去根据这些
RowID去扫描所有的表数据。可以预见的是,这个执行计划不如直接使用 TableReader 进行全表扫,因为同样都是全表扫,这里的
IndexLookUp多扫了一次索引,带来了额外的开销。
TableReader 示例:
mysql> explain select * from t where a > 1 or b >100;+-------------------------+----------+-----------+---------------+----------------------------------------+| id | estRows | task | access object | operator info |+-------------------------+----------+-----------+---------------+----------------------------------------+| TableReader_7 | 8000.00 | root | | data:Selection_6 || └─Selection_6 | 8000.00 | cop[tikv] | | or(gt(test.t.a, 1), gt(test.t.b, 100)) || └─TableFullScan_5 | 10000.00 | cop[tikv] | table:t | keep order:false, stats:pseudo |+-------------------------+----------+-----------+---------------+----------------------------------------+3 rows in set (0.00 sec)
在上面例子中
TableReader_7算子的孩子节点是 Selection_6。以这个孩子节点为根的子树被当做了一个
Cop Task下发给了相应的 TiKV,这个
Cop Task使用
TableFullScan_5算子执行扫表操作。Selection 表示 SQL 语句中的选择条件,可能来自 SQL 语句中的
WHERE/
HAVING/
ON子句。由
TableFullScan_5可以看到,这个执行计划使用了一个全表扫描的操作,集群的负载将因此而上升,可能会影响到集群中正在运行的其他查询。这时候如果能够建立合适的索引,并且使用
IndexMerge算子,将能够极大的提升查询的性能,降低集群的负载。
IndexMerge 示例:
注意:目前 TIDB 的
Index Merge为实验特性在 5.3 及以前版本中默认关闭,同时 5.0 中的
Index Merge目前支持的场景仅限于析取范式(or 连接的表达式),对合取范式(and 连接的表达式)将在之后的版本中支持。 开启
Index Merge特性,可通过在客户端中设置 session 或者 global 变量完成:
set @@tidb_enable_index_merge = 1;
mysql> set @@tidb_enable_index_merge = 1;
mysql> explain select * from t use index(idx_a, idx_b) where a > 1 or b > 1;+------------------------------+---------+-----------+-------------------------+------------------------------------------------+| id                           | estRows | task      | access object           | operator info                                  |+------------------------------+---------+-----------+-------------------------+------------------------------------------------+| IndexMerge_16                | 6666.67 | root      |                         |                                                || ├─IndexRangeScan_13(Build)   | 3333.33 | cop[tikv] | table:t, index:idx_a(a) | range:(1,+inf], keep order:false, stats:pseudo || ├─IndexRangeScan_14(Build)   | 3333.33 | cop[tikv] | table:t, index:idx_b(b) | range:(1,+inf], keep order:false, stats:pseudo || └─TableRowIDScan_15(Probe)   | 6666.67 | cop[tikv] | table:t                 | keep order:false, stats:pseudo                 |+------------------------------+---------+-----------+-------------------------+------------------------------------------------+4 rows in set (0.00 sec)
IndexMerge使得数据库在扫描表数据时可以使用多个索引。这里
IndexMerge_16算子有三个孩子节点,其中
IndexRangeScan_13和
IndexRangeScan_14根据范围扫描得到符合条件的所有
RowID,再由
TableRowIDScan_15算子根据这些
RowID精确的读取所有满足条件的数据。
查看聚合计算的执行计划
Hash Aggregate 示例:
TiDB 上的 Hash Aggregation 算子采用多线程并发优化,执行速度快,但会消耗较多内存。下面是一个 Hash Aggregate 的例子:
TiDB(root@127.0.0.1:test) > explain select /*+ HASH_AGG() */ count(*) from t;+---------------------------+----------+-----------+---------------+---------------------------------+| id | estRows | task | access object | operator info |+---------------------------+----------+-----------+---------------+---------------------------------+| HashAgg_11 | 1.00 | root | | funcs:count(Column#7)->Column#4 || └─TableReader_12 | 1.00 | root | | data:HashAgg_5 || └─HashAgg_5 | 1.00 | cop[tikv] | | funcs:count(1)->Column#7 || └─TableFullScan_8 | 10000.00 | cop[tikv] | table:t | keep order:false, stats:pseudo |+---------------------------+----------+-----------+---------------+---------------------------------+4 rows in set (0.00 sec)
一般而言 TiDB 的
Hash Aggregate会分成两个阶段执行,一个在 TiKV/TiFlash 的
Coprocessor上,计算聚合函数的中间结果。另一个在 TiDB 层,汇总所有
Coprocessor Task的中间结果后,得到最终结果。
Stream Aggregate 示例:
TiDB
Stream Aggregation算子通常会比
Hash Aggregate占用更少的内存,有些场景中也会比
Hash Aggregate执行的更快。当数据量太大或者系统内存不足时,可以试试
Stream Aggregate算子。一个
Stream Aggregate的例子如下:
TiDB(root@127.0.0.1:test) > explain select /*+ STREAM_AGG() */ count(*) from t;+----------------------------+----------+-----------+---------------+---------------------------------+| id | estRows | task | access object | operator info |+----------------------------+----------+-----------+---------------+---------------------------------+| StreamAgg_16 | 1.00 | root | | funcs:count(Column#7)->Column#4 || └─TableReader_17 | 1.00 | root | | data:StreamAgg_8 || └─StreamAgg_8 | 1.00 | cop[tikv] | | funcs:count(1)->Column#7 || └─TableFullScan_13 | 10000.00 | cop[tikv] | table:t | keep order:false, stats:pseudo |+----------------------------+----------+-----------+---------------+---------------------------------+4 rows in set (0.00 sec)
和
Hash Aggregate类似,一般而言 TiDB 的
Stream Aggregate也会分成两个阶段执行,一个在 TiKV/TiFlash 的
Coprocessor上,计算聚合函数的中间结果。另一个在 TiDB 层,汇总所有
Coprocessor Task的中间结果后,得到最终结果。
查看 Join 的执行计划
TiDB 的 Join 算法包括如下几类:
- Hash Join
- Merge Join
- Index Hash Join
- Index Merge Join
Apply
下面分别通过一些例子来解释这些 Join 算法的执行过程
Hash Join 示例:
TiDB 的 Hash Join 算子采用了多线程优化,执行速度较快,但会消耗较多内存。一个 Hash Join 的例子如下:
mysql> explain select /*+ HASH_JOIN(t1, t2) */ * from t t1 join t2 on t1.a = t2.a;+------------------------------+----------+-----------+---------------+-------------------------------------------------------------------+| id | estRows | task | access object | operator info |+------------------------------+----------+-----------+---------------+-------------------------------------------------------------------+| HashJoin_33 | 10000.00 | root | | inner join, inner:TableReader_43, equal:[eq(test.t.a, test.t2.a)] || ├─TableReader_43(Build) | 10000.00 | root | | data:Selection_42 || │ └─Selection_42 | 10000.00 | cop[tikv] | | not(isnull(test.t2.a)) || │ └─TableFullScan_41 | 10000.00 | cop[tikv] | table:t2 | keep order:false || └─TableReader_37(Probe) | 10000.00 | root | | data:Selection_36 || └─Selection_36 | 10000.00 | cop[tikv] | | not(isnull(test.t.a)) || └─TableFullScan_35 | 10000.00 | cop[tikv] | table:t1 | keep order:false |+------------------------------+----------+-----------+---------------+-------------------------------------------------------------------+7 rows in set (0.00 sec)
Hash Join会将
Build端的数据缓存在内存中,根据这些数据构造出一个
Hash Table,然后读取
Probe端的数据,用
Probe端的数据去探测
(Probe)Build端构造出来的
Hash Table,将符合条件的数据返回给用户。
Merge Join示例: TiDB 的
Merge Join算子相比于
Hash Join通常会占用更少的内存,但可能执行时间会更久。当数据量太大,或系统内存不足时,建议尝试使用。下面是一个
Merge Join的例子:
mysql> explain select /*+ SM_JOIN(t1) */ * from t t1 join t t2 on t1.a = t2.a;+------------------------------------+----------+-----------+--------------------------+---------------------------------------------------+| id | estRows | task | access object | operator info |+------------------------------------+----------+-----------+--------------------------+---------------------------------------------------+| MergeJoin_6 | 10000.00 | root | | inner join, left key:test.t.a, right key:test.t.a || ├─IndexLookUp_13(Build) | 10000.00 | root | | || │ ├─IndexFullScan_11(Build) | 10000.00 | cop[tikv] | table:t2, index:idx_a(a) | keep order:true || │ └─TableRowIDScan_12(Probe) | 10000.00 | cop[tikv] | table:t2 | keep order:false || └─IndexLookUp_10(Probe) | 10000.00 | root | | || ├─IndexFullScan_8(Build) | 10000.00 | cop[tikv] | table:t1, index:idx_a(a) | keep order:true || └─TableRowIDScan_9(Probe) | 10000.00 | cop[tikv] | table:t1 | keep order:false |+------------------------------------+----------+-----------+--------------------------+---------------------------------------------------+7 rows in set (0.00 sec)
Merge Join算子在执行时,会从
Build端把一个
Join Group的数据全部读取到内存中,接着再去读
Probe端的数据,用
Probe端的每行数据去和
Build端的完整的一个
Join Group依次去看是否匹配(除了满足等值条件以外,还有其他非等值条件,这里的 “匹配” 主要是指查看是否满足非等值职条件)。
Join Group指的是所有
Join Key上值相同的数据。
Index Hash Join 示例:
INL_HASH_JOIN(t1_name [, tl_name])提示优化器使用
Index Nested Loop Hash Join算法。该算法与
Index Nested Loop Join使用条件完全一样,但在某些场景下会更为节省内存资源。
mysql> explain select /*+ INL_HASH_JOIN(t1) */ * from t t1 join t t2 on t1.a = t2.a;+----------------------------------+----------+-----------+--------------------------+--------------------------------------------------------------------------+| id | estRows | task | access object | operator info |+----------------------------------+----------+-----------+--------------------------+--------------------------------------------------------------------------+| IndexHashJoin_32 | 10000.00 | root | | inner join, inner:IndexLookUp_23, outer key:test.t.a, inner key:test.t.a || ├─TableReader_35(Build) | 10000.00 | root | | data:Selection_34 || │ └─Selection_34 | 10000.00 | cop[tikv] | | not(isnull(test.t.a)) || │ └─TableFullScan_33 | 10000.00 | cop[tikv] | table:t2 | keep order:false || └─IndexLookUp_23(Probe) | 1.00 | root | | || ├─Selection_22(Build) | 1.00 | cop[tikv] | | not(isnull(test.t.a)) || │ └─IndexRangeScan_20 | 1.00 | cop[tikv] | table:t1, index:idx_a(a) | range: decided by [eq(test.t.a, test.t.a)], keep order:false || └─TableRowIDScan_21(Probe) | 1.00 | cop[tikv] | table:t1 | keep order:false |+----------------------------------+----------+-----------+--------------------------+--------------------------------------------------------------------------+8 rows in set (0.00 sec)
Index Merge Join 示例:
INL_MERGE_JOIN(t1_name [, tl_name])提示优化器使用
Index Nested Loop Merge Join算法。该算法相比于
INL_JOIN会更节省内存。该算法使用条件包含
INL_JOIN的所有使用条件,但还需要添加一条:
join keys中的内表列集合是内表使用的
index的前缀,或内表使用的
index是
join keys中的内表列集合的前缀。
mysql> explain select /*+ INL_MERGE_JOIN(t2@sel_2) */ * from t t1 where  t1.a  in ( select t2.a from t t2 where t2.b < t1.b);+---------------------------------+---------+-----------+--------------------------+-----------------------------------------------------------------------------------------------------------+| id                              | estRows | task      | access object            | operator info                                                                                             |+---------------------------------+---------+-----------+--------------------------+-----------------------------------------------------------------------------------------------------------+| IndexMergeJoin_23               | 6.39    | root      |                          | semi join, inner:Projection_21, outer key:test.t.a, inner key:test.t.a, other cond:lt(test.t.b, test.t.b) || ├─TableReader_28(Build)         | 7.98    | root      |                          | data:Selection_27                                                                                         || │ └─Selection_27                | 7.98    | cop[tikv] |                          | not(isnull(test.t.a)), not(isnull(test.t.b))                                                              || │   └─TableFullScan_26          | 8.00    | cop[tikv] | table:t1                 | keep order:false, stats:pseudo                                                                            || └─Projection_21(Probe)          | 1.25    | root      |                          | test.t.a, test.t.b                                                                                        ||   └─IndexLookUp_20              | 1.25    | root      |                          |                                                                                                           ||     ├─Selection_18(Build)       | 1.25    | cop[tikv] |                          | not(isnull(test.t.a))                                                                                     ||     │ └─IndexRangeScan_16       | 1.25    | cop[tikv] | table:t2, index:idx_a(a) | range: decided by [eq(test.t.a, test.t.a)], keep order:true, stats:pseudo                                 ||     └─Selection_19(Probe)       | 1.25    | cop[tikv] |                          | not(isnull(test.t.b))                                                                                     ||       └─TableRowIDScan_17       | 1.25    | cop[tikv] | table:t2                 | keep order:false, stats:pseudo                                                                            |+---------------------------------+---------+-----------+--------------------------+-----------------------------------------------------------------------------------------------------------+10 rows in set (0.01 sec)
```sqlApply 示例:
```sqlmysql> explain select * from t t1 where  t1.a  in ( select avg(t2.a) from t2 where t2.b < t1.b);+----------------------------------+----------+-----------+---------------+-------------------------------------------------------------------------------+| id                               | estRows  | task      | access object | operator info                                                                 |+----------------------------------+----------+-----------+---------------+-------------------------------------------------------------------------------+| Projection_10                    | 10000.00 | root      |               | test.t.id, test.t.a, test.t.b                                                 || └─Apply_12                       | 10000.00 | root      |               | semi join, inner:StreamAgg_30, equal:[eq(Column#8, Column#7)]                 ||   ├─Projection_13(Build)         | 10000.00 | root      |               | test.t.id, test.t.a, test.t.b, cast(test.t.a, decimal(20,0) BINARY)->Column#8 ||   │ └─TableReader_15             | 10000.00 | root      |               | data:TableFullScan_14                                                         ||   │   └─TableFullScan_14         | 10000.00 | cop[tikv] | table:t1      | keep order:false                                                              ||   └─StreamAgg_30(Probe)          | 1.00     | root      |               | funcs:avg(Column#12, Column#13)->Column#7                                     ||     └─TableReader_31             | 1.00     | root      |               | data:StreamAgg_19                                                             ||       └─StreamAgg_19             | 1.00     | cop[tikv] |               | funcs:count(test.t2.a)->Column#12, funcs:sum(test.t2.a)->Column#13            ||         └─Selection_29           | 8000.00  | cop[tikv] |               | lt(test.t2.b, test.t.b)                                                       ||           └─TableFullScan_28     | 10000.00 | cop[tikv] | table:t2      | keep order:false                                                              |+----------------------------------+----------+-----------+-----------------------------------------------------------------------------------------------+10 rows in set, 1 warning (0.00 sec)
其它关于 EXPLAIN 的说明
EXPLAIN FOR CONNECTION用于获得一个连接中最后执行的查询的执行计划,其输出格式与
EXPLAIN完全一致。但 TiDB 中的实现与 MySQL 不同,除了输出格式之外,还有以下区别:
MySQL 返回的是正在执行的查询计划,而 TiDB 返回的是最后执行的查询计划。
MySQL 的文档中指出,MySQL 要求登录用户与被查询的连接相同,或者拥有
PROCESS权限,而 TiDB 则要求登录用户与被查询的连接相同,或者拥有
SUPER权限。
本文为「TiDB 查询优化及调优」系列文章的第二篇,后续将继续对 TiDB 慢查询诊断监控及排查、调整及优化查询执行计划以及其他优化器开发或规划中的诊断调优功能等进行介绍。如果您对 TiDB 的产品有任何建议,欢迎来到 https://internals.tidb.io 与我们交流。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69994146/viewspace-2888960/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从企业数智化四阶段解读 TiDB 场景价值
- PingCAP“一号员工”唐刘:回顾我与 TiDB 的十年成长之旅
- APTSell x TiDB AutoFlow:AI 数字员工,助力销售业绩持续增长
- 从单一到多活,麦当劳中国的数据库架构迁移实战
- Dify 基于 TiDB 的数据架构重构实践
- TiDB 亮相宜昌“医院‘云数智’技术实践研讨及成果展示交流会”
- TiDB 可观测性解读(二)丨算子执行信息性能诊断案例分享
- TiDB × AI :DeepSeek 时代你需要什么样的数据基座
- 架构师必看!现代应用架构发展趋势与数据库选型建议丨TiDB vs MySQL 专题(一)
- TiDB 观测性解读(一)丨索引观测:快速识别无用索引与低效索引
