前言
Relay log 类似 binary log,是指一组包含数据库变更事件的文件,加上相关的 index 和 mata 文件,具体细节参考 官方文档 。在 DM 中针对某个上游开启 relay log 后,相比不开启,有如下优势:
- 不开启 relay log 时,每个 subtask 都会连接上游数据库拉取 binlog 数据,会对上游数据库造成较大压力,而开启后,只需创建一个连接拉取 binlog 数据到本地,各个 subtask 可读取本地的 relay log 数据。
- 上游数据库对 binlog 一般会有一个失效时间,或者会主动 purge binlog,以清理空间。在不开启 relay log 时,如果 DM 同步进度较为落后,一旦 binlog 被清理,会导致同步失败,只能重新进行全量迁移;开启 relay log 后,binlog 数据会被实时拉取并写入到本地,与当前同步进度无关,可有效避免前面的问题。
但在 DM 版本 <= v2.0.7 中,开启 relay log 后有如下问题:
- 数据同步延迟相比不开启 relay log 有明显上升,下面的表格是一个单 task 的 benchmark 的测试结果,可看出平均 latency 有明显的增长。下表中以“.”开头的是延迟的百分位数据。
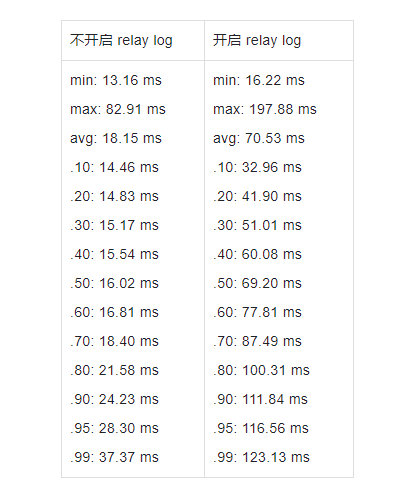
- 开启 relay 后 CPU 消耗增加。(由于 latency 的增长,在一些简单场景下(比如只有 1 个 task)相比不开启 relay log,资源使用率反而是下降的。但当 task 增多时,开启 relay 的 CPU 消耗就增加了)。
由于以上问题,在新的版本中,我们对 DM 的 relay log 做了一些性能优化。
当前 relay 实现
在开始介绍具体的优化之前,首先简单介绍下当前 DM 中 relay 的实现,详细实现,详情可参阅 DM 源码阅读系列文章(六)relay log 的实现 ,本文在此不做过多描述。
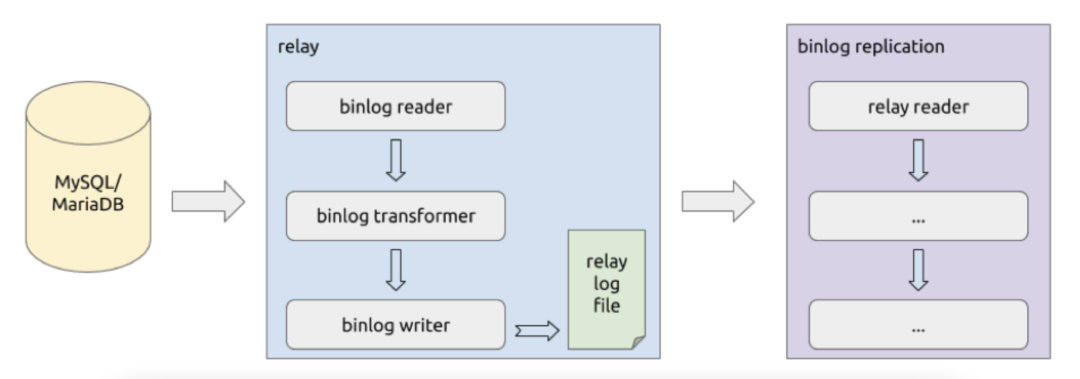
当前 relay 模块可以分为两个部分,relay writer 和 relay reader 部分,其结构如下所示:
Relay writer
relay writer 依次做了下述 3 个事情:
-
使用 binlog reader 从上游 MySQL/MariaDB 读取 binlog event;
-
将读取到的 binlog event 使用 binlog transformer 进行转换;
-
将转换后的 binlog event 使用 binlog writer 以 relay log file 的形式存储在本地的 relay directory 中。
Relay reader
开启 relay 后,Syncer 会通过 relay reader 获取 binlog event,relay reader 主要是做了如下工作:
- 读取 realy directory 中的 binlog 文件,发送给 syncer;
- 当读取到文件尾时,定时(目前是每隔 100ms)检查当前 binlog 文件大小和 meta 文件内容是否存在变化,如果改变则继续读取(binlog 文件变化)或者切换到新的文件(meta 文件变化)。
从上面的介绍可以看出,relay reader 跟 relay writer 是相互独立的,彼此通过 relay directory 中的 binlog、meta 和 index 文件进行交互。
测试环境说明
在开始介绍优化内容前,先介绍下优化时使用的环境情况
-
上游为 MySQL,版本为
5.7.35-log; -
下游为单实例的 TiDB,版本为
5.7.25-TiDB-v5.2.1; -
DM 使用了 1 个 master 和 1 个 worker
- Latency 基准测试版本为 2021-10-14 号的 master 分支(commit hash 为 d2dc22d)
- CPU 基准测试版本为 2021-11-01 号的 relay 重构分支(commit hash 为9f7ce1d6)
-
在小规模测试(<= 4 task)下 MySQL/TiDB/DM 运行在同一主机,方便测试,主机环境为 8 核 16G;
-
较大规模测试(> 4 task)下 MySQL/TiDB/DM 分别运行在一台主机上,主机都是 8 核 16G
-
测量迁移延迟采用下游自更新时间列的方式,详细参考 多种方式告诉你如何计算DM同步数据到 TiDB 的延时时间 中的第三种方式。
Latency 优化
从上面的“ 当前 relay 实现”部分可以看出,有两个可能影响 latency 的点:
- 当前 relay reader 的定时 check 的实现方式本身就会对 latency 有一定影响,在最坏情况下一个 binlog event 至少要延迟 100ms 才能同步到下游;
- relay writer 会写到磁盘,之后 relay reader 从磁盘读取,这一读一写是否会对 latency 有较大影响?
- 调研发现 linux 系统(Mac OS 系统下也有类似机制)下存在 page cache 的机制,读取最近写入的文件并非通过磁盘,而是读取 OS 内存中的缓存,因此理论上影响有限。
经过调研以及对上述问题的测试,我们总结了两个方案:
- 在内存中缓存 relay writer 在最近一段时间内预备写入的 binlog,如果 relay reader 请求这段 binlog,relay reader 直接从内存读取;
- relay reader 仍然采用读取文件的方式,relay writer 在写入新的 event 时,通知 relay reader。
方案 1 需要根据下游的写入速度在读内存和读文件之间进行切换,实现起来相对复杂,而且由于 OS 层 page cache 的存在,应用本身再增加一层缓存对 latency 的影响有限。
方案 2,我们做了一些初步的测试,在增加 relay reader check 的频率时,开启 relay 基本能达到不开启 relay 时的latency,调研了下 MySQL 的 relay log,发现也是通过读取文件的方式,因此我们选择了方案 2。
实现相对较简单,在 relay writer 增加了 Listener,在有新 binlog event 时通知该 Listener(往 channel 中发送一个消息),然后在 relay reader 中,将 定时 check 改为监听 channel 中的消息。
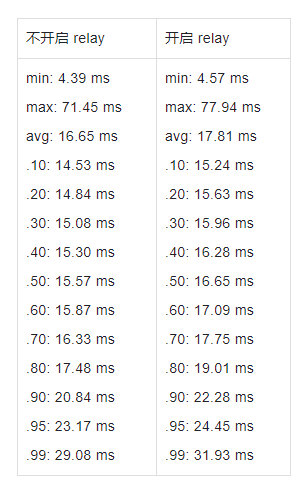
下图是在 4 table 4 task 测试下的 latency 结果,可以看出开启 relay 后的 latency 跟不开启很接近:
CPU 优化
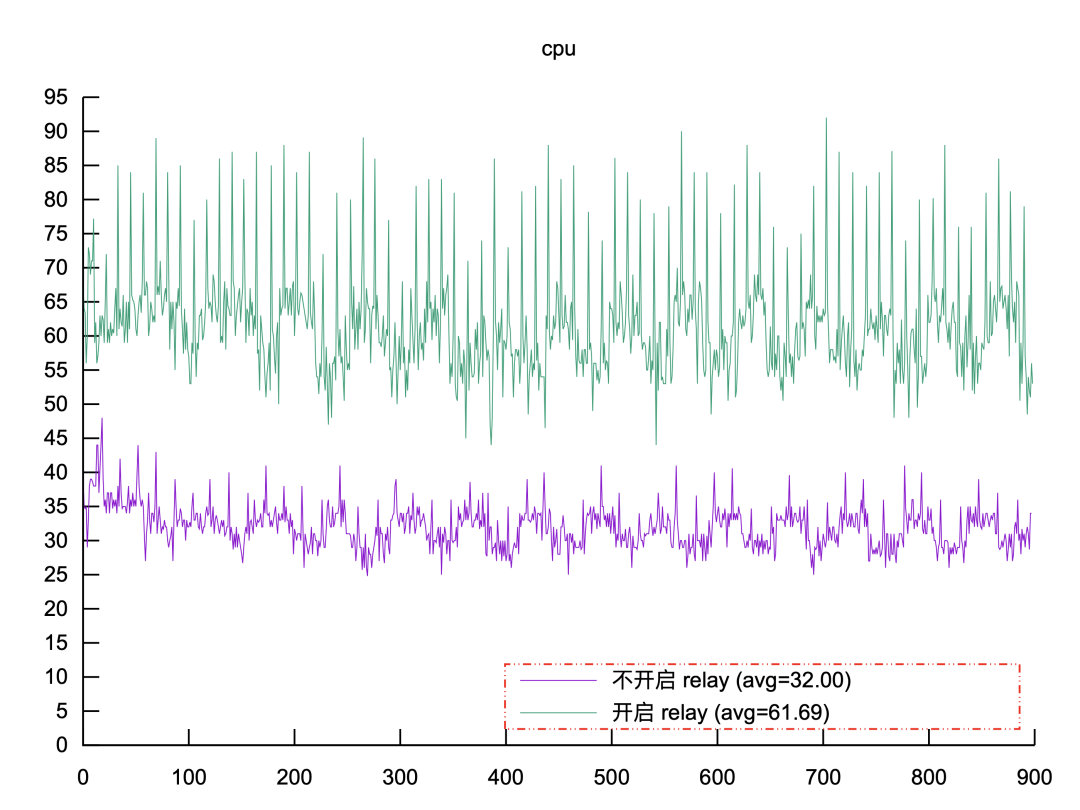
Latency 优化完后,我们也对开启 relay log 后的 CPU 占用情况做了测试,发现开启后 CPU 占用率也较高,下图是在 4 table 4 task 下测试结果( 注:后续没有特殊说明的话,都是在该场景下的测试结果),可以看出开启 relay 后 CPU 消耗有明显增长,而且尖刺变得更大:
使用 golang 自带的 pprof 做了一个 CPU profile,从下图可以看出占比较大的主要是 syncer/relay reader/relay writer 等部分,对比代码逻辑后,发现:
- Relay reader 使用了 go-mysql 的 ParseFile 接口,该接口每次调用都会重新打开文件,并读取第一个 FORMAT_DESCRIPTION 事件,也就是下图中第一个蓝色标注的位置;
- 在优化 latency 时,由于 relay reader 和 writer 是相互独立的,为了简化实现,仅通过 channel 通知是否存在新的 binlog 写入,而新写入的 binlog 可能在上次读取的时候已经读取过了,这导致了很多无效的 meta、index 文件的检查。

针对上面的问题,我们做了如下优化:
- 使用 go-mysql 的 ParseReader 来消除重复打开和读取的消耗;
- 重构 relay 模块,将 relay writer 和 reader 整合在一起,方便两者间通信。relay reader 在通过 channel 收到通知后,检查当前 relay writer 正在写入的文件是否跟正在读取的文件相同,即该文件是否为 active 写入状态,并获取当前文件写入的位置,通过这些信息,可以避免无效的 meta、index 文件的检查。
从下图可以看出优化后 CPU 有较大幅度的降低,但是尖刺仍然较大:

由于我们测试用的 sysbench 产生 write 事件的速率是比较平稳的,DM 中也没有特别的执行代码,而 Golang 是一个编译型带 GC 的语言,因此我们猜测尖刺主要来自于 GC,但是这一点从 CPU profile 并不明显,见下图:

使用
GODEBUG=gctrace=1开启 GC 日志,见下图,可以发现:
- 开启 relay 后,驻留内存大了接近一倍(239 MB -> 449 MB),Heap 总空间也大了近一倍。
- 经过调研该问题是由于 DM 内嵌的 tidb 导致的内存泄漏,暂时未处理。
- 开启 relay 后,GC 占用的 CPU 大幅增加,特别是 background GC time 和 idle GC time。

下图是上面优化后做的 heap profile 中 alloc_space 部分的火焰图:
说明:pprof 的 heap profile 是程序运行至今的一个剖析,并不是某一段时间内,所以从下图中也可以看到一些驻留内存的申请。

通过 heap profile 并对比代码,发现了以下可优化的点:
- Go-mysql 在从文件解析 binlog event 时,每个 event 都会重新申请一个 bytes.Buffer,并在读取过程中不断扩容。优化后改为使用一个 buffer pool,减少不断扩容带来的开销;
- Local streamer 中 heatbeat event 使用了 time.After ,使用该接口代码会更简洁,但是该接口创建的 channel 只在触发 timer 时才会释放,另外 Local streamer 读取事件是一个高频调用,每次调用都创建一个 timer channel 开销也较大。优化后改为复用 timer;
- Relay 从上游读取事件时使用了一个 timeout context,每次读取都会创建一个额外的 channel,而在当前场景下,该 timeout context 并没必要。优化后去掉了该 timeout context;
- Relay reader、relay writer 写入 debug 日志未检测 log level,每次都会创建一些 Field 对象,虽然不大,但是由于这些操作调用频率较高,也会带来一些开销。优化后,对高频调用的 debug 日志,增加 log level 判断。
- 说明:DM 写入日志使用的 zap logger ,该 logger 性能较好,在非高频调用下,直接调用 log.Debug 一般是没问题的。
优化后的结果如下,可以看出 CPU 又降低了不少,尖刺也少了很多:
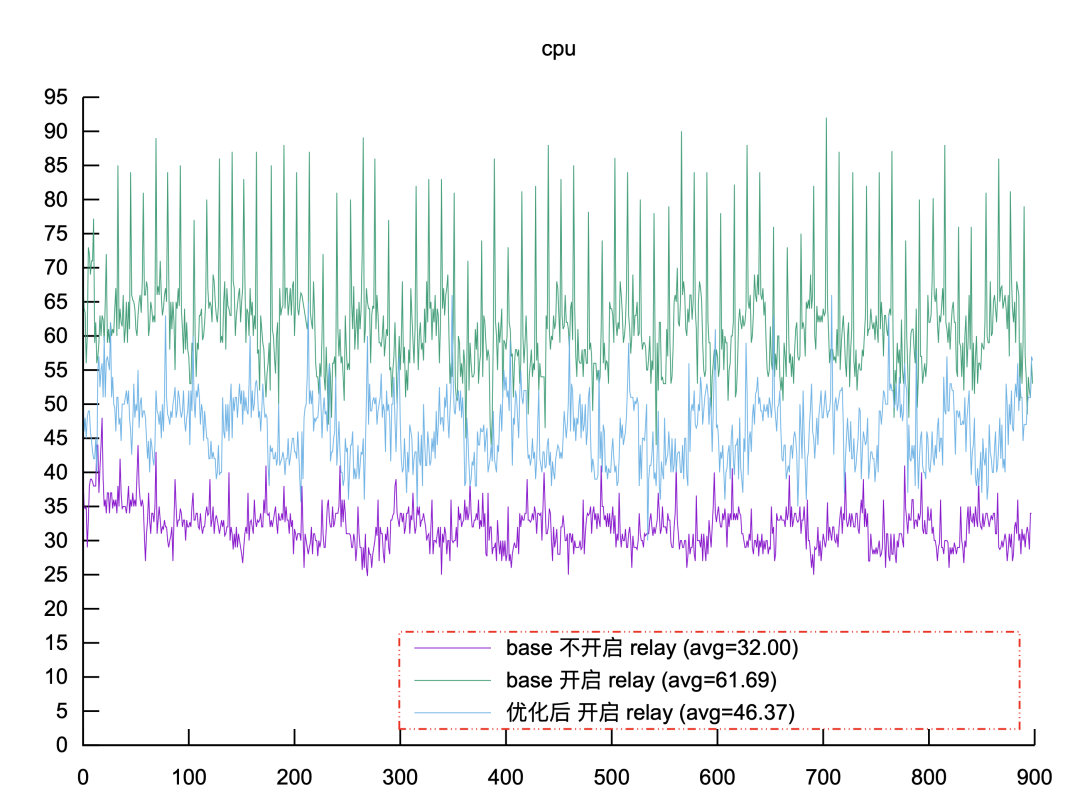
下图为在 20 table 20 task 场景下的测试结果:
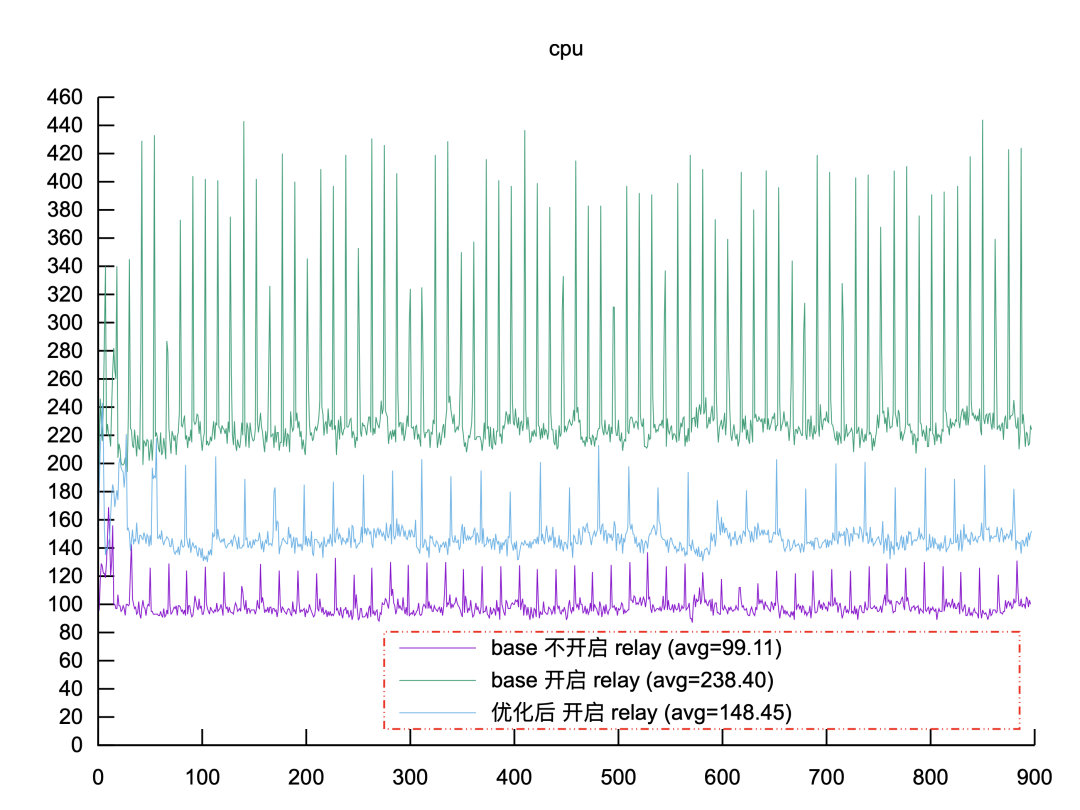
遗留问题 & 未来工作
经过上面的优化,开启 relay 相比不开 relay,在 latency 上的差距已经很小, CPU 的增长也在一个相对低的水平,但是仍有一些点是可以继续优化的,预期会在后续版本中逐步添加,如下:
-
go-mysql读文件使用的io.CopyN,这个函数内部会申请一个小对象,高频使用情况下还是对 GC 有一些影响的,但不大,这次暂时没改; - 有些对
no relay和relay同时生效的优化这次没做,比如 streamer 读取 event 时创建的 timeout context; - 目前看多个 reader 读同一个文件还是有不少开销的,再优化的可能方案:
- 减少读的次数,比如一个 reader 读完、其他的 reader 读内存之类的,或者像之前设想的增加内存缓存的方式;
- 合并相同下游的 task,减少 task 数量。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69994146/viewspace-2861801/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 从企业数智化四阶段解读 TiDB 场景价值
- PingCAP“一号员工”唐刘:回顾我与 TiDB 的十年成长之旅
- APTSell x TiDB AutoFlow:AI 数字员工,助力销售业绩持续增长
- 从单一到多活,麦当劳中国的数据库架构迁移实战
- Dify 基于 TiDB 的数据架构重构实践
- TiDB 亮相宜昌“医院‘云数智’技术实践研讨及成果展示交流会”
- TiDB 可观测性解读(二)丨算子执行信息性能诊断案例分享
- TiDB × AI :DeepSeek 时代你需要什么样的数据基座
- 架构师必看!现代应用架构发展趋势与数据库选型建议丨TiDB vs MySQL 专题(一)
- TiDB 观测性解读(一)丨索引观测:快速识别无用索引与低效索引
