记一次高负载Aerospike集群不可用问题分析定位和解决
Aerospikes是一个大数据量下的、高可用的、自由扩展的分布式数据库,本文结合最近遇到的一个集群问题进行分析、定位和解决。
一、问题现场
1、收到集群可用低于一半和集群节点不可用
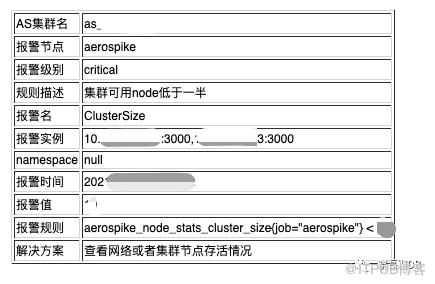
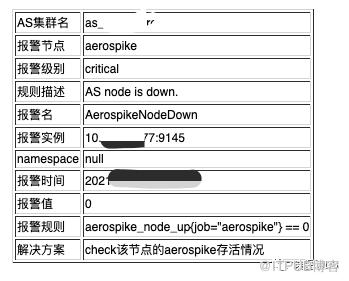
2、登陆一台AS节点,执行asadm查看,5个节点的AS集群只有2个节点存活。目前集群是不可用的情况。
3、业务也反馈读写出现问题。
二、问题分析
网络问题导致的集群不可用。下面的日志行意味着来自另一个节点的paxos集群信息被忽略了。这可能是网络稳定性问题造成的。
Aug 20 2021 16:35:04 GMT+0800: WARNING (clustering): (clustering.c:4313) ignoring paxos accepted from node bb9dde810bf926c - it is not in acceptor list
Aug 20 2021 16:35:04 GMT+0800: WARNING (clustering): (clustering.c:4313) ignoring paxos accepted from node bb9658411bf926c - it is not in acceptor list
Aug 20 2021 16:35:04 GMT+0800: WARNING (clustering): (clustering.c:4313) ignoring paxos accepted from node bb9658411bf926c - it is not in acceptor list
Aug 20 2021 16:35:04 GMT+0800: WARNING (clustering): (clustering.c:4313) ignoring paxos accepted from node bb9dde810bf926c - it is not in acceptor list
下面是官方的对上面报警解释,基本的意思就是说:网络不稳定导致各个节点的集群paxos消息被忽略。

从日志中也可以定位到是网络问题导致的:
Aug 20 2021 16:35:06 GMT+0800: INFO (clustering): (clustering.c:7242) ignoring stale join request from node bb9d9e710bf926c - delay estimate 366(ms)
Aug 20 2021 16:35:06 GMT+0800: INFO (hb): (hb.c:8572) node arrived bb9e9022cbf926c
Aug 20 2021 16:35:06 GMT+0800: INFO (clustering): (clustering.c:7242) ignoring stale join request from node bb9d9e710bf926c - delay estimate 619(ms)
Aug 20 2021 16:35:06 GMT+0800: INFO (clustering): (clustering.c:5794) applied new cluster key 3ab9485062eb
Aug 20 2021 16:35:06 GMT+0800: INFO (clustering): (clustering.c:5796) applied new succession list bb9dde810bf926c bb9d9e710bf926c bb989052cbf926c bb9658411bf926c
Aug 20 2021 16:35:06 GMT+0800: INFO (clustering): (clustering.c:5798) applied cluster size 4
Aug 20 2021 16:35:06 GMT+0800: INFO (clustering): (clustering.c:7242) ignoring stale join request from node bb9d9e710bf926c - delay estimate 525(ms)
Aug 20 2021 16:35:06 GMT+0800: INFO (clustering): (clustering.c:7242) ignoring stale join request from node bb9d9e710bf926c - delay estimate 375(ms)
下面是官方的对上面相关解释,基本的意思就是说:网络不稳定导致节点的心跳数据包延迟。

然后看了网络割接群,发现不少业务线也在同样的时间段出现了网络问题。
三、解决
1、重启挂掉的AS服务。
为了尽快恢复业务,我重启了所有挂掉的Aerospike进程,因为集群数据量较大,并且AS进程也挂了,相当于冷启动,AS的冷启动需要从硬盘load数据然后在内存创建主键索引。需要一定的时间,等待数据索引加载完毕后才算真正接入集群并且接受请求。
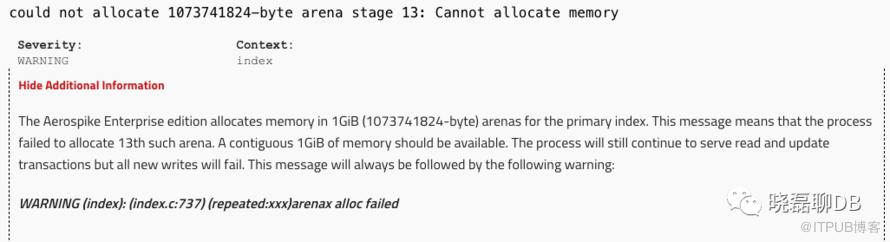
结论:重启并没有真正解决集群问题,重启加入集群的节点又不断的脱离集群,并且对应的AS服务也挂了,整个集群还是无法提供服务。排查了下相关的日志,发现AS服务挂掉的原因是:could not allocate 1073741824-byte arena stage 58: Cannot allocate memory,为啥连1G的连续内存都申请不到?
日志如下:
Aug 20 2021 16:35:04 GMT+0800: INFO (info): (ticker.c:271)    system: total-cpu-pct 1214 user-cpu-pct 848 kernel-cpu-pct 366 free-mem-kbytes 3424928 free-mem-pct 2
Aug 20 2021 16:35:04 GMT+0800: WARNING (arenax): (arenax_ee.c:436) (repeated:216446) could not allocate 1073741824-byte arena stage 58: Cannot allocate memory
Aug 20 2021 16:35:04 GMT+0800: WARNING (index): (index.c:748) (repeated:216446) arenax alloc failed
Aug 20 2021 16:35:12 GMT+0800: INFO (drv_ssd): (drv_ssd.c:1829) {mediav} /dev/sdd: used-bytes 13229786832 free-wblocks 2235718 write-q 0 write (53156615,15.2) defrag-q 0 defrag-read (53103067,15.5) defrag-write (46737037,13.6)
Aug 20 2021 16:35:12 GMT+0800: INFO (drv_ssd): (drv_ssd.c:1829) {mediav} /dev/sdg: used-bytes 13234647472 free-wblocks 2235685 write-q 0 write (53157251,14.9) defrag-q 0 defrag-read (53103672,15.2) defrag-write (46738877,13.3)
Aug 20 2021 17:09:13 GMT+0800: INFO (as): (as.c:306) <><><><><><><><><><>  Aerospike Enterprise Edition build 5.4.0.5  <><><><><><><><><><>
冷重启后各个AS节点刚加入集群时内存使用情况:发现free的内存确实不多,只有2G,其实还是比较少的。
free -g
              total        used        free      shared  buff/cache   available
Mem:      125           2          2         119         120          0
Swap:        0           0           0
现在就来解释下内存不够的原因。一旦脱离集群的节点加载完自己的数据重新加入集群后就会触发其他节点的数据迁移操作,数据迁移操作至少需要1G的连续内存,只能从free memory内拿,2G的内存给用户链接+AS监控等使用后已经没有连续的1G内存供迁移使用了。导致了AS脱离集群。下面是官方对内存分配的解释:
2、真正的解决
单靠重启旧节点频繁重启带来的集群节点加入又脱离,没有真正的解决集群的可用性问题,说明:
AS集群的使用负载较高,没有足够的free memory
AS集群老节点启动后只向外迁移数据,不接受其他节点的迁移数据。
(1)首先解决第一个AS集群负载的问题。
通过新扩容节点来增加集群的吞吐
我一下子给集群又扩了5个新节点,相当于就算我老集群不可用,新5个节点也能扛起读写。这里涉及到2个情况。
我可以接受数据丢失,那么新增5个节点进入后,可以完全抹除老集群的数据,集群可以立刻恢复。
我的老集群节点的历史数据不可丢,所以需要将老集群的数据平滑的迁移到新节点。
另外就是查看了AS节点启动后的内存使用情况,调整memory-size 和 high-water-memory-pct,通过观察AS集群监控,发现内存相关的参数配置的不太合理,并且集群的负载也偏高。之前是128G的内存,最大可用内存(memory-size)配置100G,内存可用水位线(high-water-memory-pct:默认50%)配置到90%,其实这样AS存数据最大能用到90G。但是结合AS链接请求+系统+AS监控其实内存使用已经属于高位水平。目前已经根据具体的内存使用调低了memory-size 和 high-water-memory-pct。另外配置高的high-water-memory-pct可能导致写放大问题。
迁移设置
对所有节点,降低迁移线程,相当于给迁移降速。
asadm -e 'asinfo -v "set-config:context=service;migrate-threads=1"对于新增节点,只接受迁移数据,不往外输出数据。
asadm -e 'asinfo -v "set-config:context=service;migrate-max-num-incoming=4"'对于老节点,只往外迁移数据,不接受迁移数据。
asadm -e 'asinfo -v "set-config:context=service;migrate-max-num-incoming=0"'
这样老集群节点的数据就逐渐的迁移到新集群,并且老集群节点随着数据的迁移,内存使用会逐渐的降低,free memory会越来越多,因为不涉及接受迁移的数据,所以负载肯定会越来越低。
PS:集群数据rebalance后,记得恢复迁移配置,并且调整到合适的值。默认AS参数配置如下:
asinfo -v 'set-config:context=namespace;id=mediav;migrate-sleep=1'
asinfo -v 'set-config:context=service;migrate-threads=6'
asinfo -v 'set-config:context=service;migrate-max-num-incoming=8'
asinfo -v 'set-config:context=network;fabric.channel-bulk-recv-threads=8'
四、总结
总的来说,这个是网络问题(出问题的时间段在网络割接)导致的集群不可用,再加上集群的负载较高,没有足够的可用内存,一旦AS进程由于网络问题或者被OOM kill而脱离集群节点,一旦不可用的AS节点超过集群的半数以上,集群就不可以提供外部服务。通过扩容+修改参数配置,完成的集群的恢复。
官方相关的链接:
https://discuss.aerospike.com/t/how-to-add-a-new-node-to-a-cluster-approaching-utilisation-limits-hwm-or-stop-writes/7460
https://discuss.aerospike.com/t/faq-why-is-high-water-disk-pct-set-to-50/3054 https://docs.aerospike.com/docs/reference/serverlogmessages/index.html
原文作者:晓磊聊DB;如有侵权,请联系管理员删除。

