ITPub博客

首页 > 数据库 > 国内数据库 > Python 爬虫进阶篇-利用beautifulsoup库爬取网页文章内容实战演示

Python 爬虫进阶篇-利用beautifulsoup库爬取网页文章内容实战演示

国内数据库 作者:zmy爱吃炸鸡 时间:2020-09-14 15:00:25 0 删除 编辑

我们以  fox新闻 网的文章来举例子,把整篇文章爬取出来。

首先是标题,通过结构可以看出来  class 为  article-header 的节点下的  h1 里的内容即是标题,通过  string 可以获取  dom 节点里的文本内容。
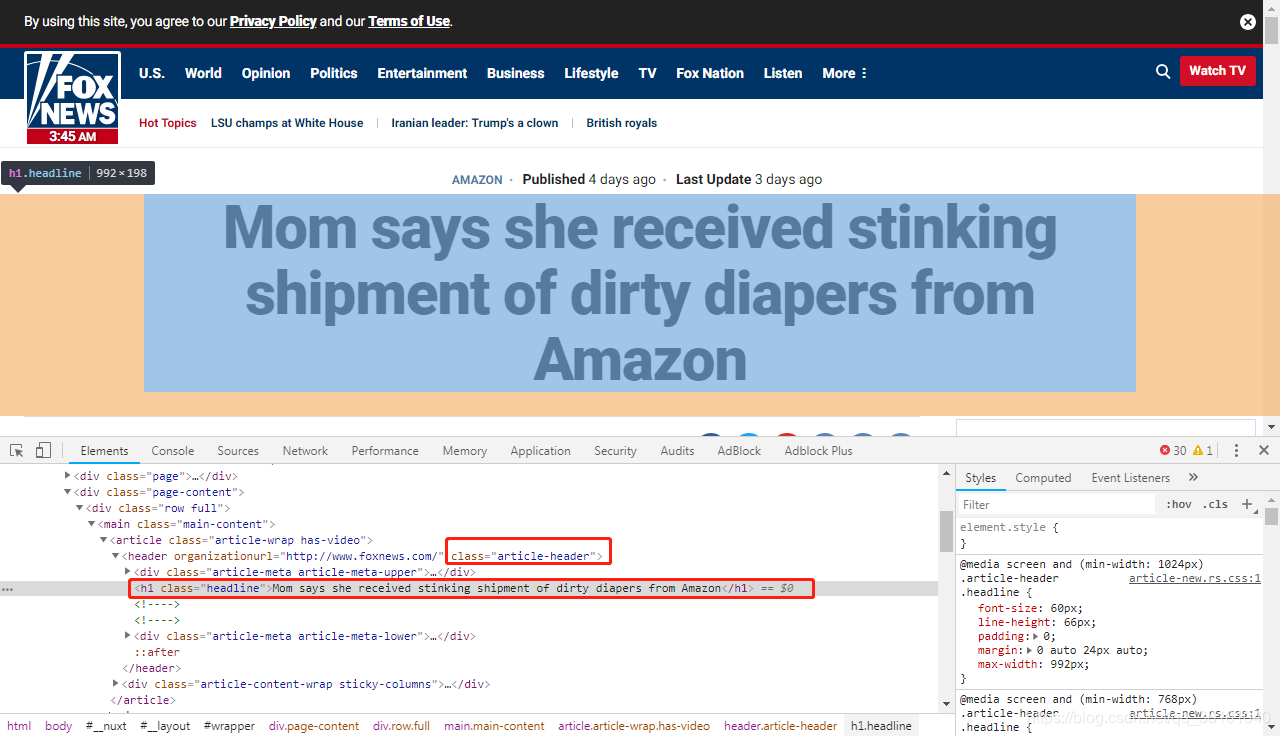
# 获取文章标题alert_header = soup.find('header', class_="article-header").find('h1')print(alert_header.string)123

在这里插入图片描述
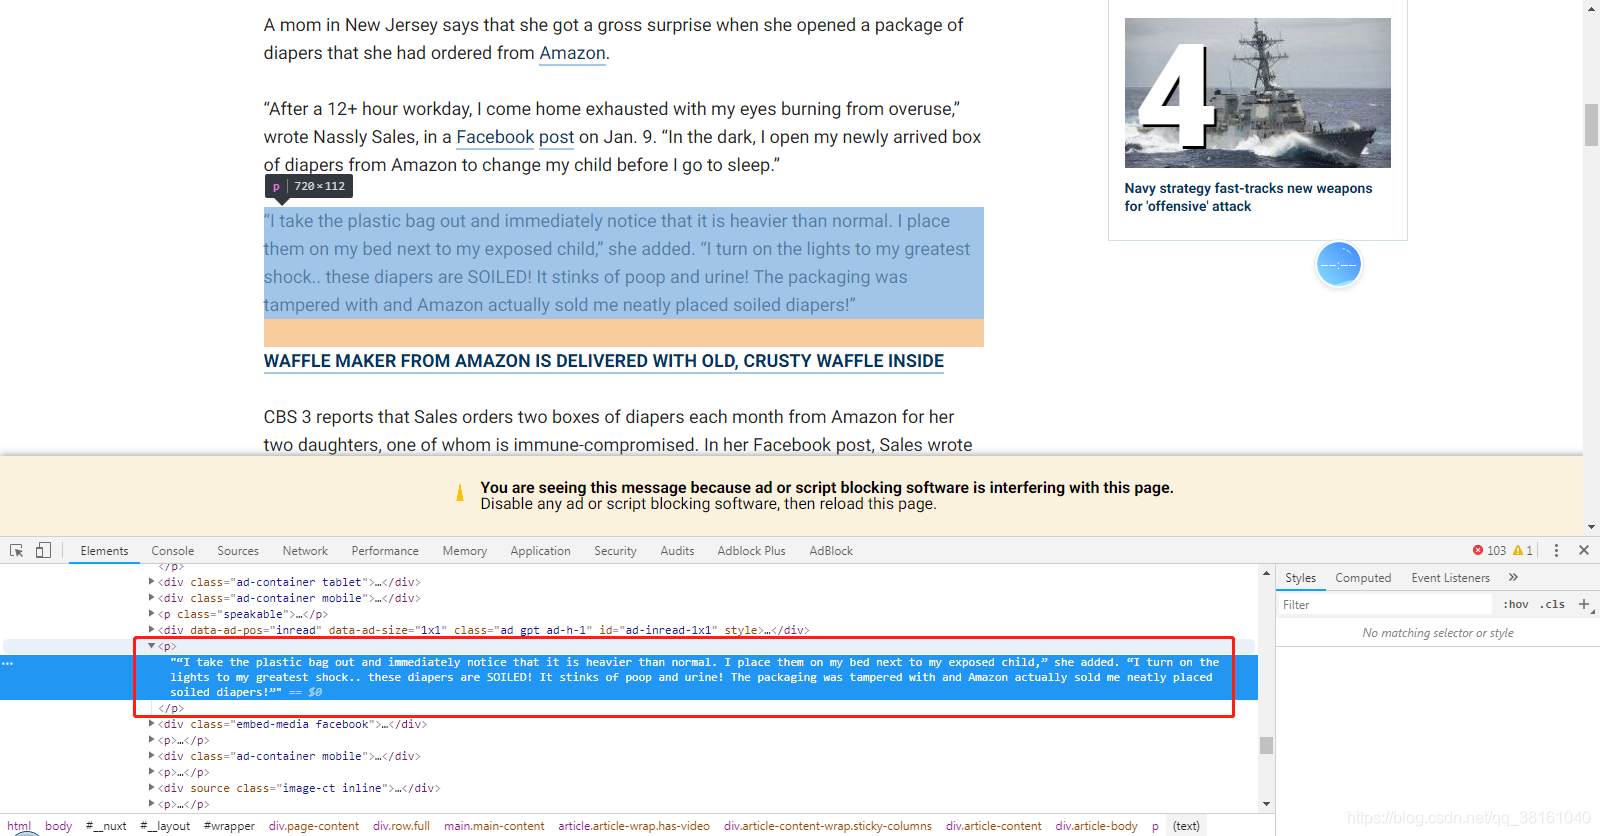
然后是正文,通过结构可以看出来  class 为  article-body 的节点下的  p 元素组成了正文内容,通过  contents 可以获取  body 下所有的节点。再遍历所有的节点,把所有  p 元素的下的内容打印出来。
在这里插入图片描述

from urllib.request import urlopenfrom bs4 import BeautifulSoup
url = urlopen('https://www.foxnews.com/tech/mom-received-dirty-diapers-amazon')soup = BeautifulSoup(url, 'html.parser')   # parser 解析# 获取文章标题alert_header = soup.find('header', class_="article-header").find('h1')print("标题如下:")print(alert_header.string)# 获取文章正文alert_body = soup.find('div', class_="article-body").contents   # 所有body里的p节点# 打印文章正文print("正文如下:")for i in alert_body:
    if(i.name == "p"):
        print(i.getText())
        print()1234567891011121314151617181920

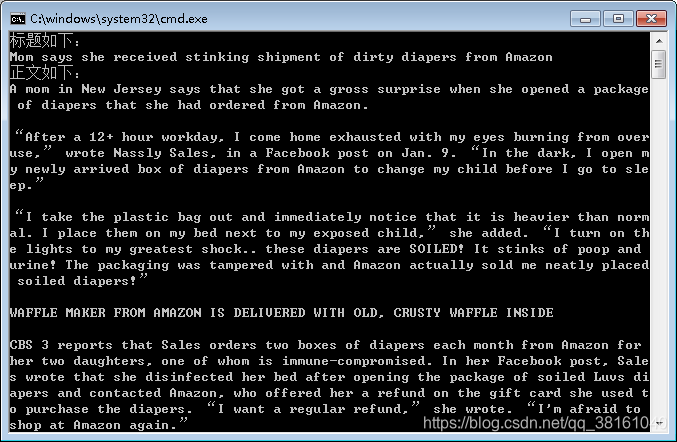
运行效果图:
如果中间夹杂了广告,可以看看文章正文跟广告在结构上有什么区别,然后进一步把广告剔除。
在这里插入图片描述

转自 https://blog.csdn.net/qq_38161040/article/details/104021581?

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69983768/viewspace-2719408/ ,如需转载,请注明出处,否则将追究法律责任。

上一篇: 没有了~
请登录后发表评论 登录
全部评论

注册时间:2020-09-14

  • 博文量
    32
  • 访问量
    23820