当诗人遇到熟读2600亿中文参数的大模型
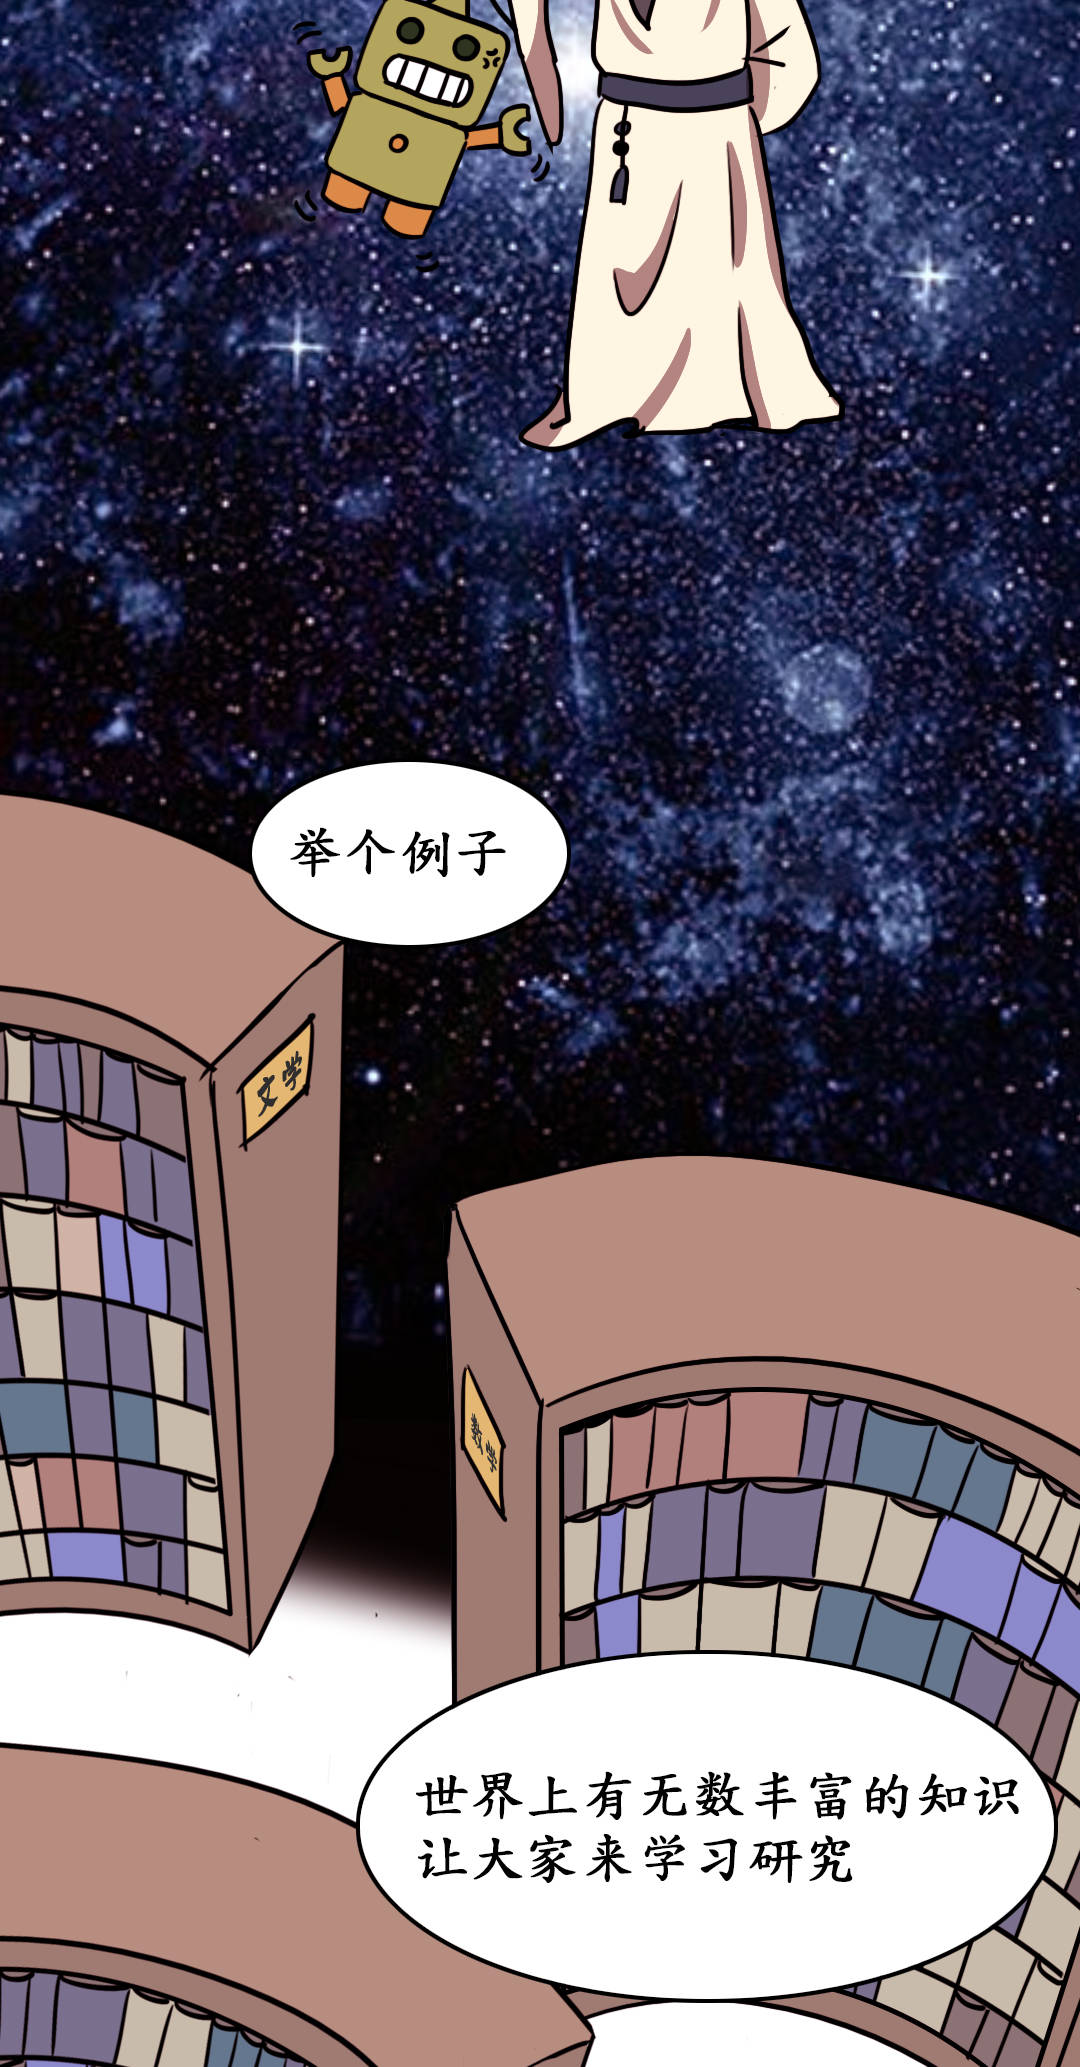
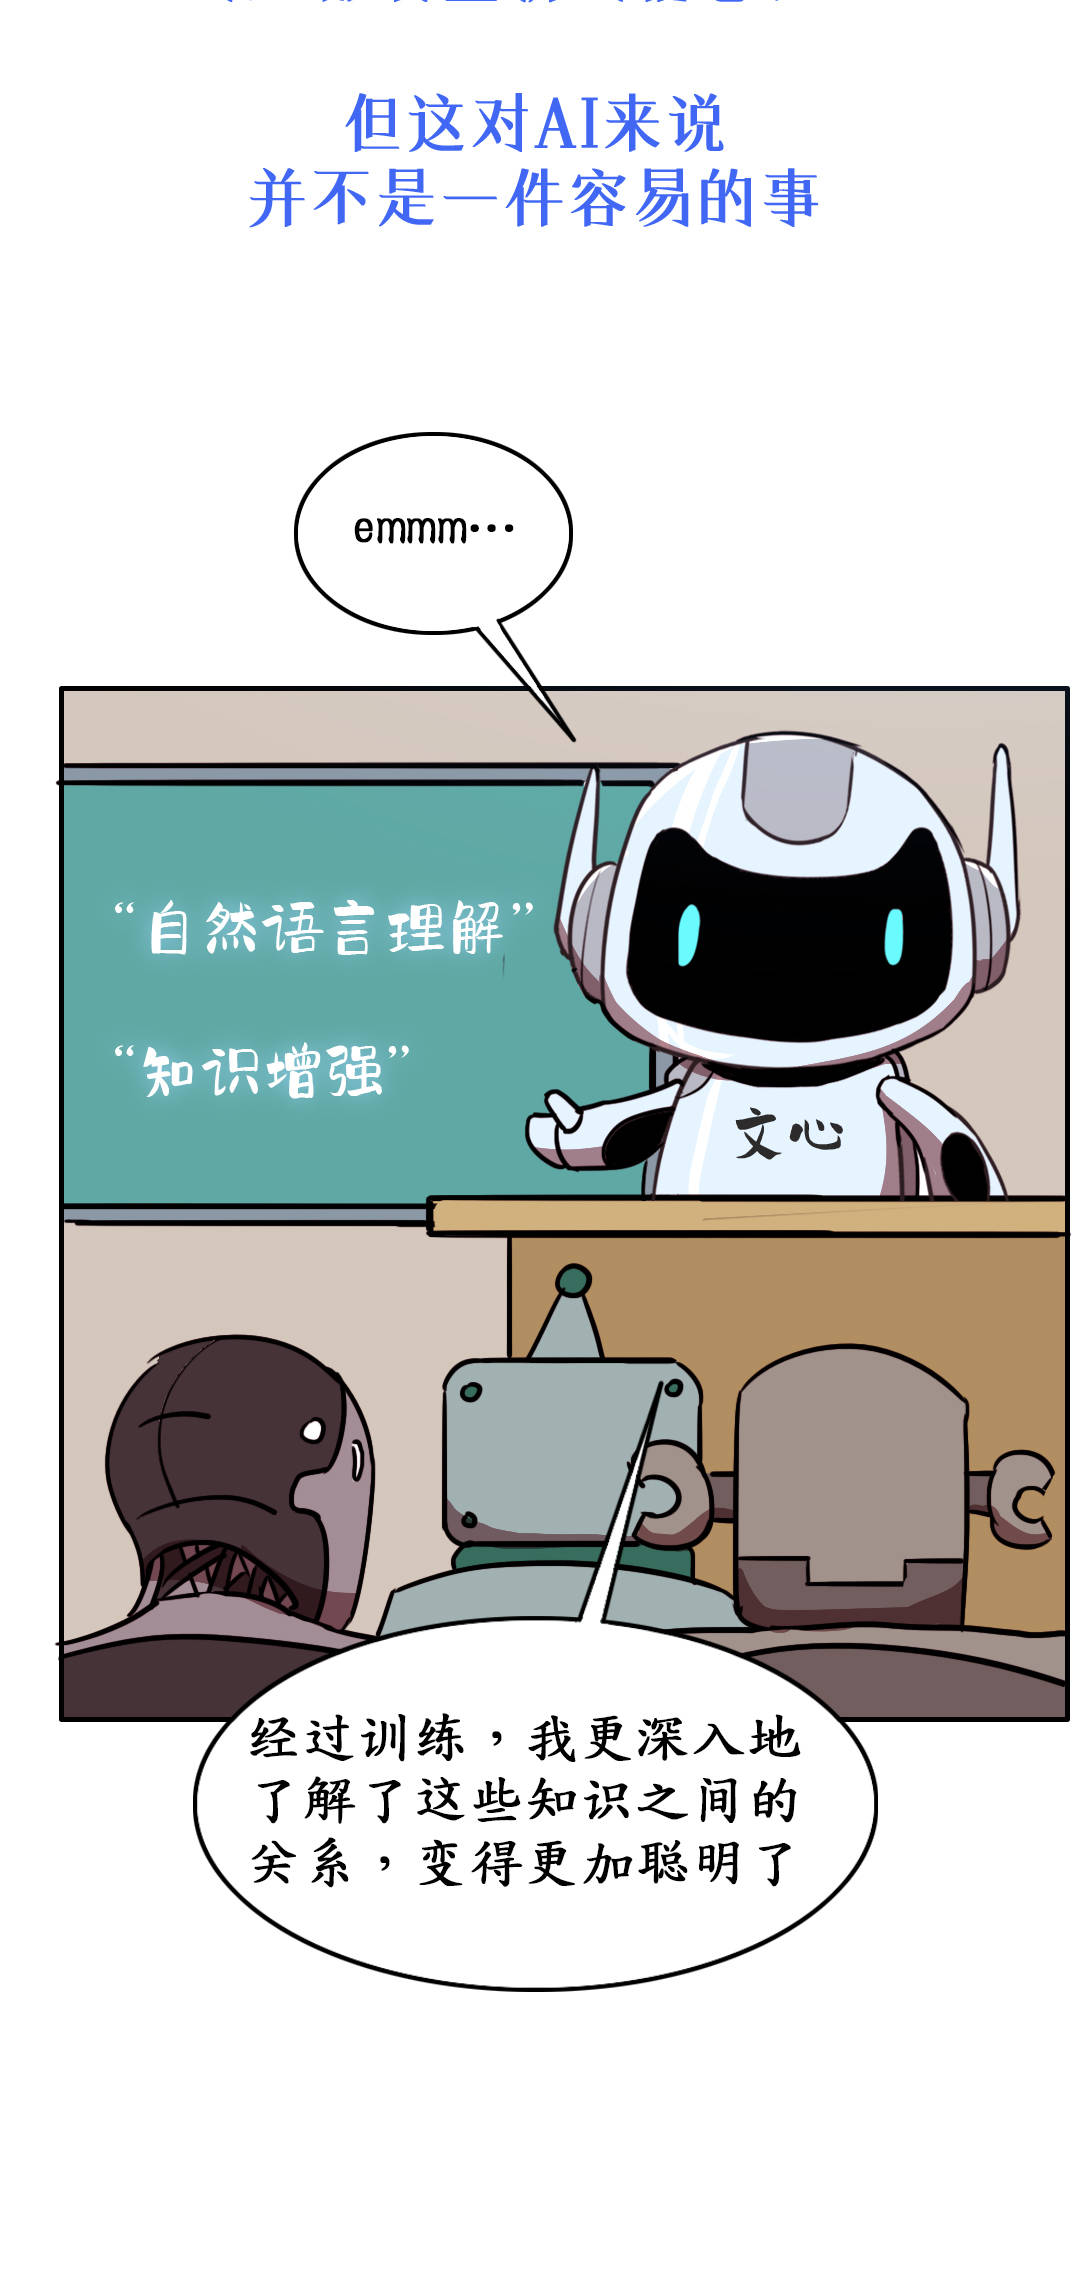
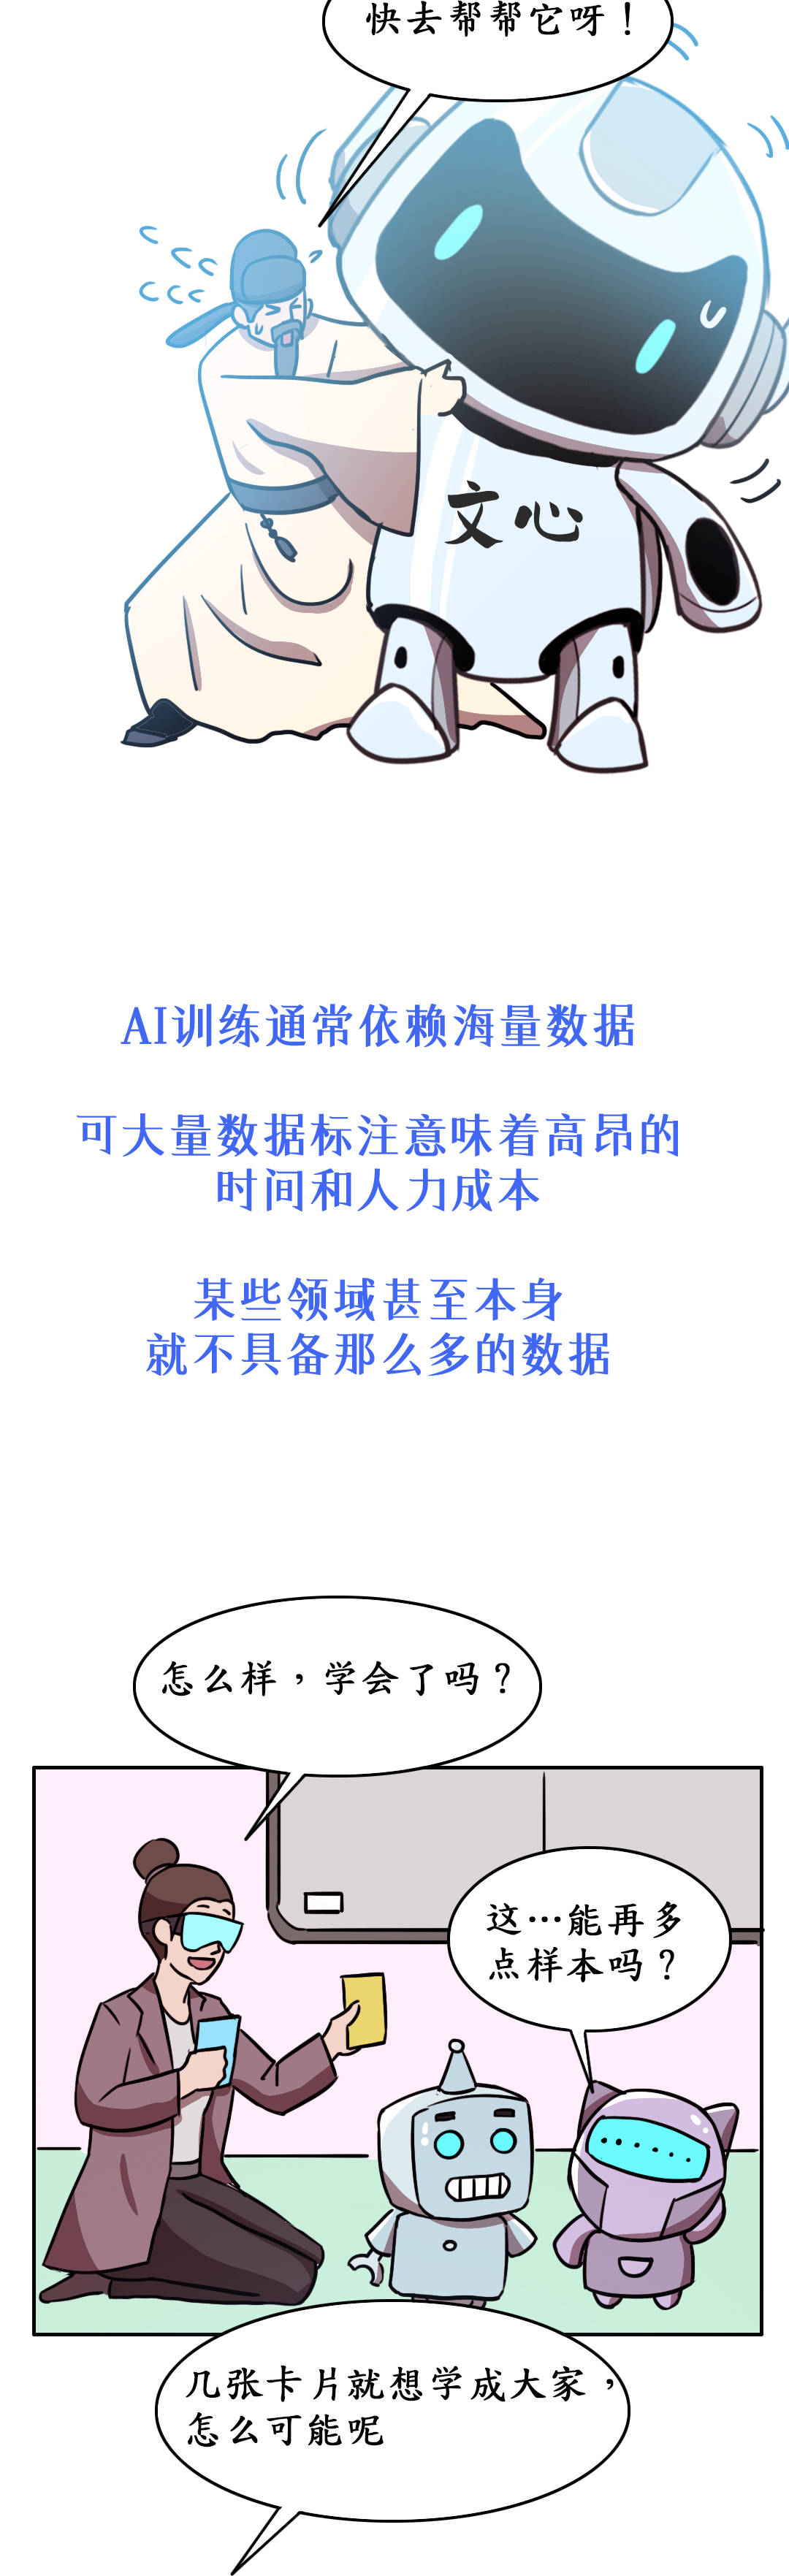
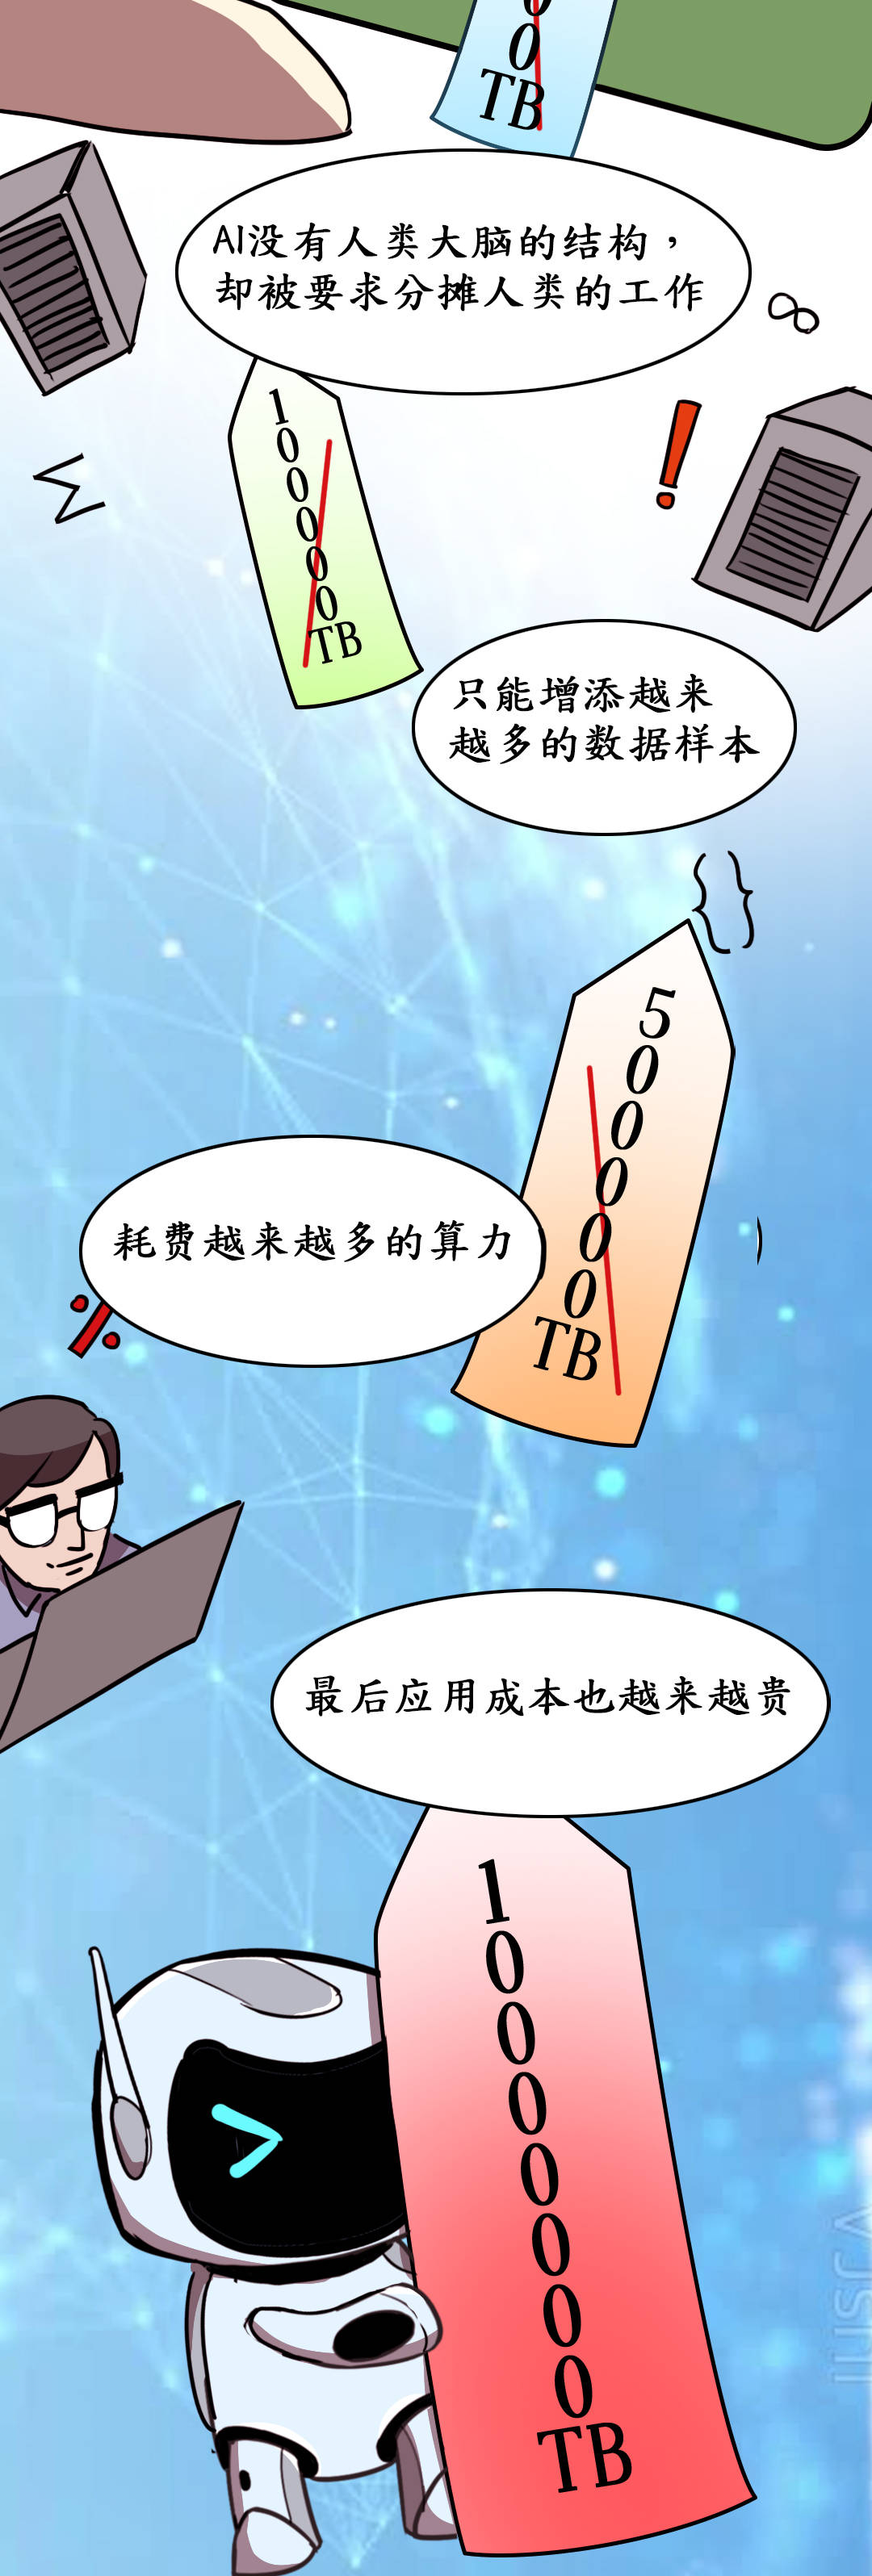
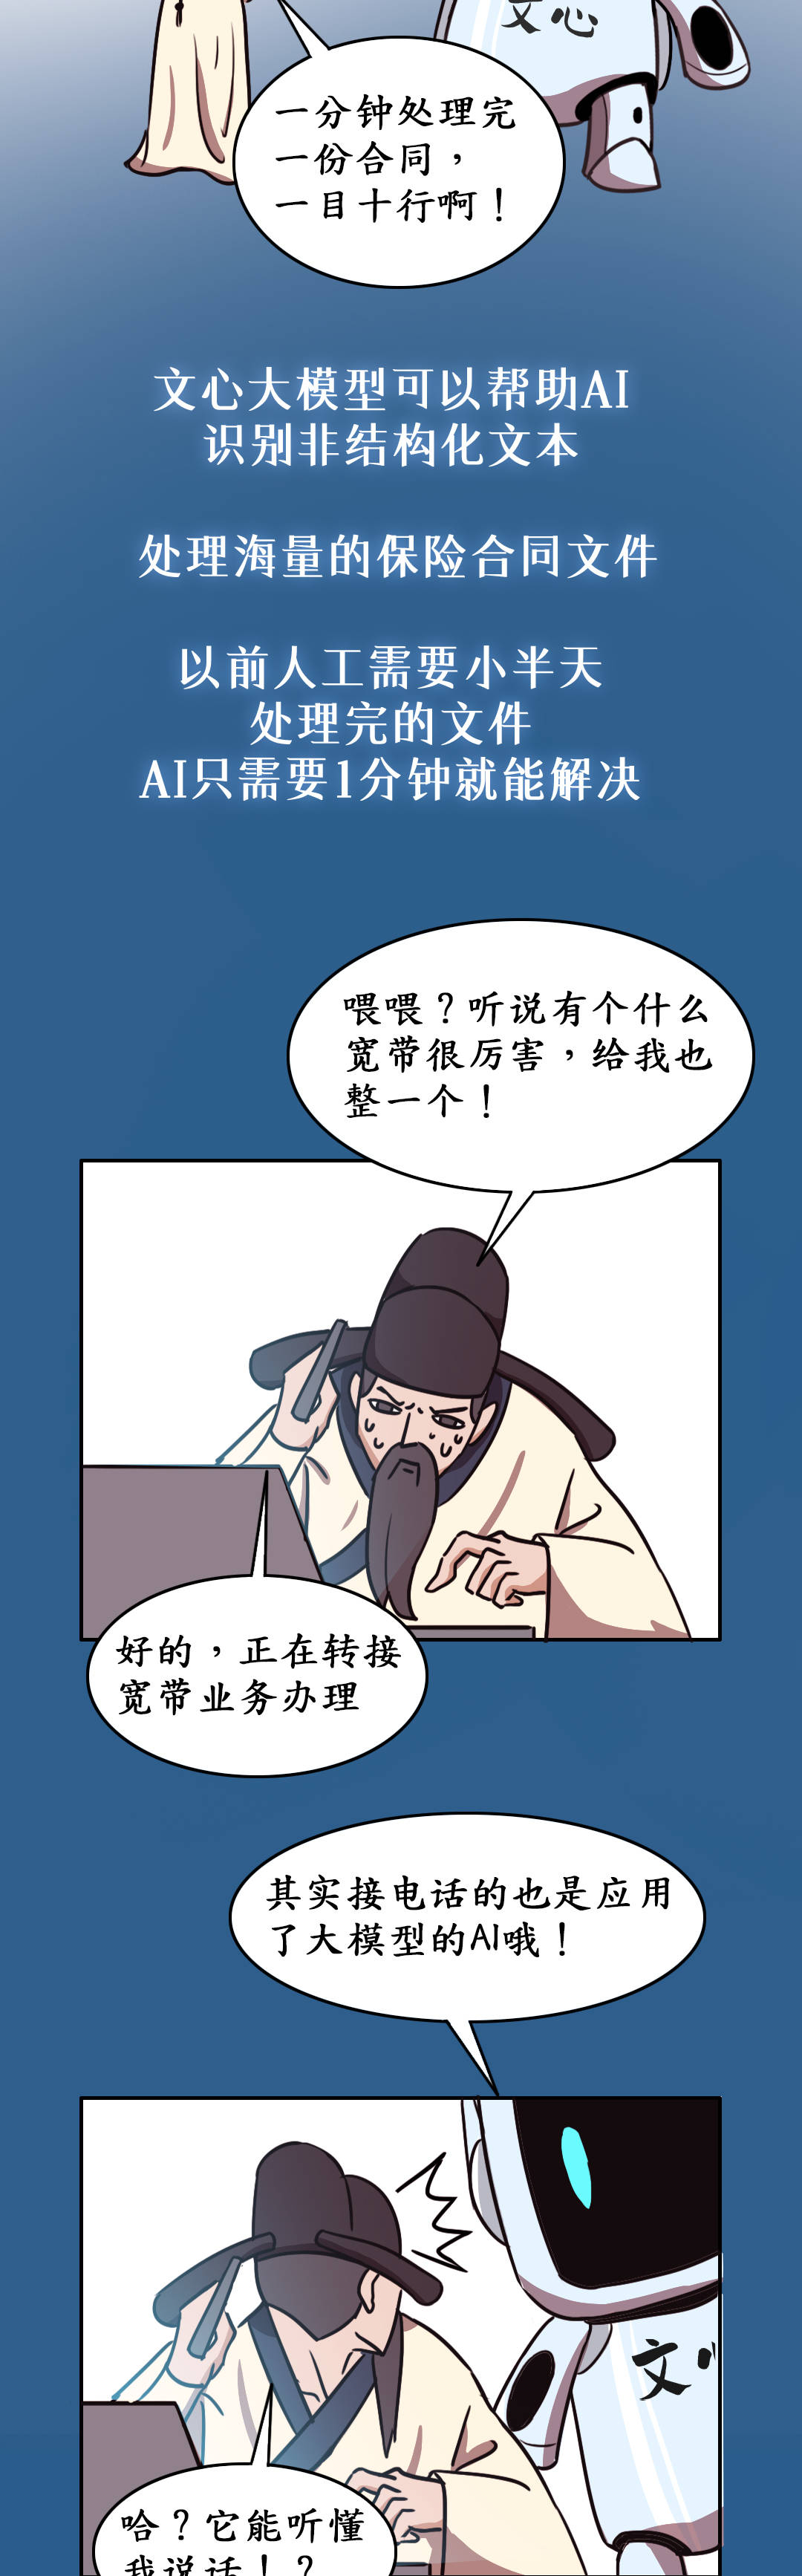
中文,是世界上公认最难的语言。中文有超过十万个字符,这些字符又有自己独立的符号和丰富的含义。交织起来,形成了我们日常应用的语言和文字,结合人类世界庞大的知识系统。让人类学习中文,都不那么容易,更别提人工智能了。为了满足智能对话、文本生成理解等等需求,开发者们往往要付出大量的开发成本。而最近,百度联合鹏城实验室发布了鹏城-百度·文心千亿大模型,它的参数规模达到2600亿,是全球首个知识增强的超大模型。文心的出现,能否为AI开发降低成本,帮助AI更快开启工业化落地之路?









来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69983145/viewspace-2847123/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
用AI走出“沙丘”

请登录后发表评论
登录
全部评论
