南大通用GBase 8a MPP Cluster(gbase database)作为国内领先的分析型分布式数据库,已经在金融、电信、政务等关键行业的核心分析系统中广泛部署。本文将深入浅出地为你解析 GBase 8a数据库的产品架构原理,帮助技术团队快速理解其设计思想和技术优势。
GBase 8a 在数据存储方面做了大量的优化设计,这也是它能够在分析型场景中表现优异的关键所在。
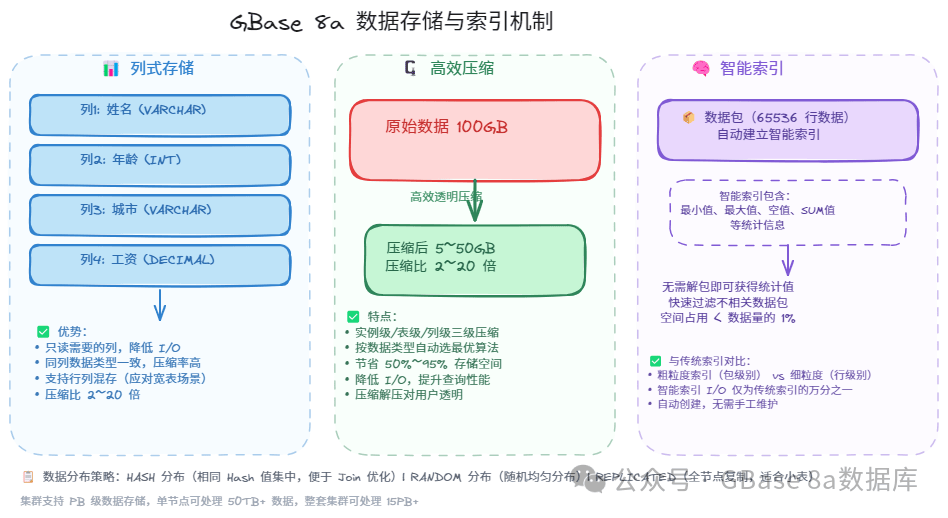
1、 列式存储:只读需要的列
与传统行式数据库不同,GBase 8a 采用列式存储。数据在磁盘上按照列(字段)来组织和存储。
想象一下,你有一张包含 100 个字段的用户表,但你只需要查询"姓名"和"年龄"两列。在行式数据库中,即使只需要两列数据,系统也必须把整行数据(100个字段)都读出来;而在列式数据库中,系统只读取需要的两列,I/O 开销降低到原来的 1/50!
列式存储的优势:
降低I/O
只读需要的列,大幅减少磁盘读取
高压缩比
同列数据类型一致,压缩率更高(2~20 倍)
支持行列混存
应对宽表场景,兼顾查询灵活性和性能
2、 数据分布:三种策略各显神通
数据如何分布到不同的 GNode 节点上?GBase 8a 提供了三种策略:
HASH分布
原理:按指定列的哈希值将数据分配到不同节点。
适用场景:常用于 JOIN 频繁的列,相同哈希值的数据集中在同一节点。
RANDOM分布
原理:数据随机均匀分布到各个节点。
适用场景:对分布无特殊要求的通用场景。
REPICATED分布
原理:每个节点都保存完整的数据副本。
适用场景:适合数据量小但查询频繁的维度表。
3、 高效压缩:100GB变5GB
GBase 8a 支持实例级、表级、列级三级压缩策略,能够按照数据类型和数据分布规律自动选择最优压缩算法。
- 压缩比可达到2~20 倍,远高于行存储。
- 节省50%~95%的存储空间。
- 降低 I/O 消耗,数据加载和查询性能明显提升。
- 压缩和解压缩过程对用户完全透明。
4、 智能索引:万亿级加速
GBase 8a 的智能索引是一种粗粒度索引技术,它有这样几个突出特点:
- 每65536行数据自动生成一个数据包,并建立智能索引。
- 智能索引包含最小值、最大值、空值、SUM 值等统计信息。
- 无需解包即可获得统计值,快速过滤不相关的数据包。
- 索引空间仅占数据量的 1%(传统索引占 20%~50%)。
- 自动创建,无需手工维护。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69979120/viewspace-3172864/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 南大通用GBase 8s数据库TPC-H仅21.34秒,跑出列存真实力(下)
- GBase 8s数据库TPC-H仅21.34秒,跑出列存真实力(上)
- 南大通用GBase 8a GCDW多租户数据共享标杆场景适配简析
- 南大通用GBase 8a GCDW多租户数据共享实用价值解析
- GBase 8s数据库root dbspace 存储结构分析
- GBase 8s数据库root dbspace保留页浅析
- DB-Engines榜单10月发布,部分国产数据库排名下滑
- 南大通用GBase 8a数据库压缩算法新老版本对照
- 南大通用GBase 8a数据库压缩算法类型简析
- G术时刻 |南大通用GBase 8c分布式数据库客户端工具 gsql
