本文继续说明为什么列存不依赖传统 B-Tree 索引,南大通用GBase 8a数据库(gbase database) 实际使用了哪些替代机制,以及怎样在列存环境下做到真正有效的查询加速。
跳跃扫描是列存引擎在 Zone Map 基础上实现的一种高级优化技术。当 WHERE 条件无法命中分区裁剪(比如过滤条件针对的是非分区键列),但该列的数据有一定的局部有序性时,引擎可以利用 Zone Map 在列块级别做跳跃:遇到 Min-Max 范围与过滤条件不相交的列块,整块跳过(Skip),只扫描可能包含满足条件数据的列块。
跳跃扫描的效率与数据的局部有序性密切相关。如果数据完全随机分布,每个列块的 Min-Max 范围都覆盖了整个值域,没有任何列块能被跳过,跳跃扫描退化为全列扫描。如果数据有良好的局部排序(如数据按 order_date 写入,同一天的数据集中在连续的列块里),对 order_date 的范围查询就能高效地跳过大量列块。
这也解释了在南大通用GBase 8a数据库(gbase database)上一个常见的现象:两张表结构完全相同,数据量也一样,但同一条 SQL 在一张表上很快、在另一张表上很慢。原因通常是数据的物理排列顺序不同——按时间顺序批量加载的表,时间相关的查询能大量利用跳跃扫描;打乱顺序加载的表则无法利用这个优化。
如何利用数据排序提升跳跃扫描效果
理解了跳跃扫描的原理,就能有意识地在数据写入环节为查询性能做准备。
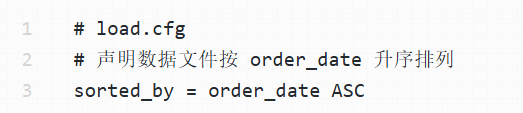
在 gload 配置中指定排序列:如果数据文件本身已经按某列有序(如日志数据通常按时间有序),在 gload 的配置文件中声明这一点,可以让 Express 引擎在写入时保留这个有序性,使后续的 Zone Map 过滤更有效:
批量加载的时间窗口设计:在 ETL 设计中,尽量让同一时间范围的数据在同一批次写入,而不是混合多个日期的数据一起写。按时间分批写入能保证同一天的数据在物理上聚集在相邻的列块里,对时间范围查询的 Zone Map 过滤效果最好。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69979120/viewspace-3171794/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 南大通用GBase 8c数据库不同部署形态的架构差异(上)
- 南大通用GBase 8s数据库TPC-H仅21.34秒,跑出列存真实力(下)
- GBase 8s数据库TPC-H仅21.34秒,跑出列存真实力(上)
- 南大通用GBase 8a GCDW多租户数据共享标杆场景适配简析
- 南大通用GBase 8a GCDW多租户数据共享实用价值解析
- GBase 8s数据库root dbspace 存储结构分析
- GBase 8s数据库root dbspace保留页浅析
- DB-Engines榜单10月发布,部分国产数据库排名下滑
- 南大通用GBase 8a数据库压缩算法新老版本对照
- 南大通用GBase 8a数据库压缩算法类型简析
