本文分享如下10个小案例:
如何确定PostGIS依赖组件的版本
如何使用大小写不敏感的数据类型
表函数及数组元素动态引用
function、procedure、routine
Java如何映射bit类型
Java使用Double存储varchar精度问题
巧用分区键表达式导数据
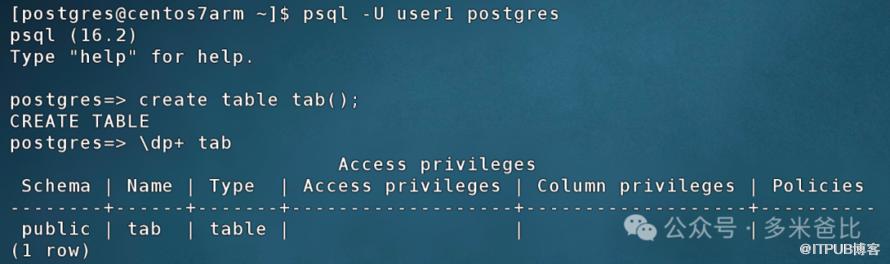
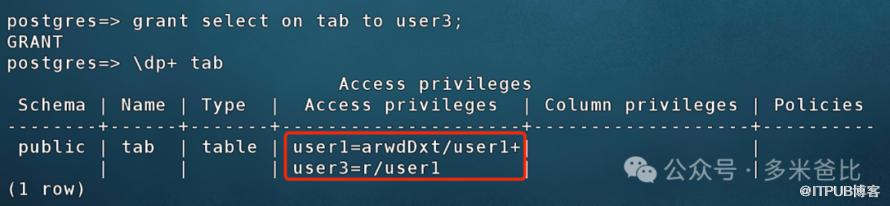
ACL默认显示问题
Drop Table后空间未释放问题
如何追踪服务端错误堆栈
如何确定PostGIS依赖组件的版本
例如使用PG 16版本安装PostGIS,应该如何选择PostGIS的版本,同时PostGIS依赖的第三方组件Geos、PROJ、GDAL应该使用什么版本?
从PostGIS的wiki网站可以找到最佳搭配: https://trac.osgeo.org/postgis/wiki/UsersWikiPostgreSQLPostGIS
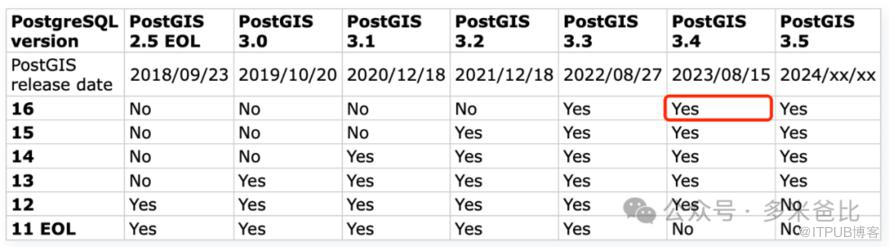
从上面的矩阵可以看出,在PG 16里PostGIS需要使用3.3~3.5版本,支持PostGIS的第三方组件版本也有相应的版本矩阵。
如何使用大小写不敏感的数据类型
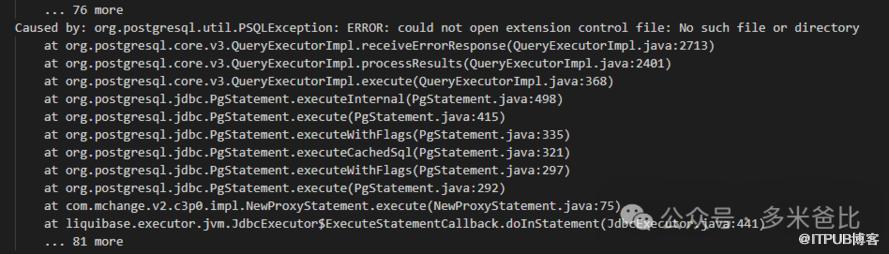
详细查看发现应用框架使用了citext扩展插件,在服务端手工编译这个插件即可正常。
使用citext插件可以创建citext数据类型,citext数据类型是一个不区分大小写的文本类型,允许在进行文本比较时忽略大小写,进行文本比较时更加方便和快速。据了解,这个插件在各大云厂商的服务里是标配。
关于citext的详细介绍请参考官网附录:额外的扩展插件。
表函数及数组元素动态引用
select * from table(array);select unnest(array); postgres=# select array(values('one'), ('two') );array-----------{one,two}(1 row)
postgres=# select unnest(array(values('one'), ('two') ));unnest--------onetwo(2 rows)
select (array_agg(pid))[:2] from pg_stat_activity;select (array_agg(pid))[2:] from pg_stat_activity;
function、procedure、routine
postgres=# grant execute on all routines in schema pg_catalog to admin;ERROR: syntax error at or near "routines"...grant execute on all functions in schema pg_catalog to admin;grant execute on all procedures in schema pg_catalog to admin;
grant execute on all routines in schema pg_catalog to admin;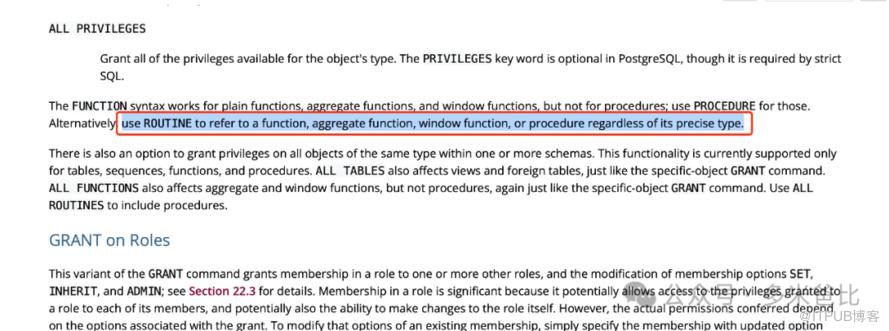
Java如何映射bit类型
postgres=> create table tab_bit(bt bit(3));CREATE TABLEpostgres=> insert into tab_bit values(B'001'),(B'010'),(B'100');INSERT 0 3
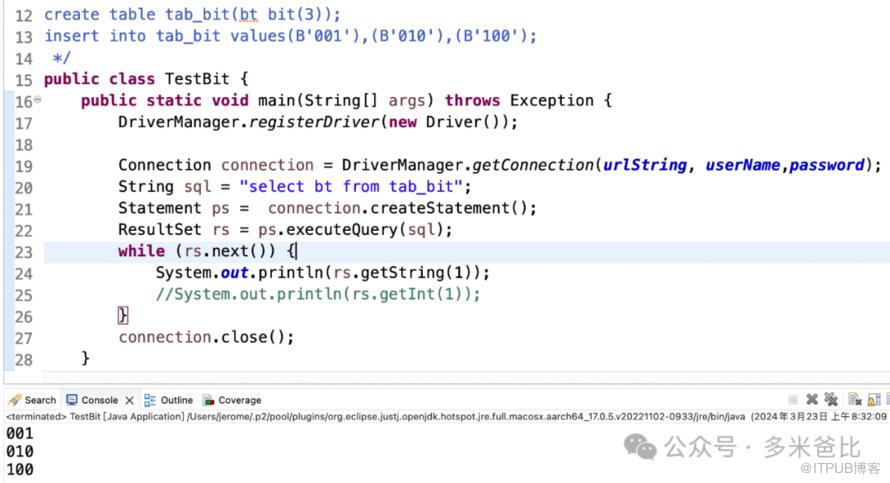
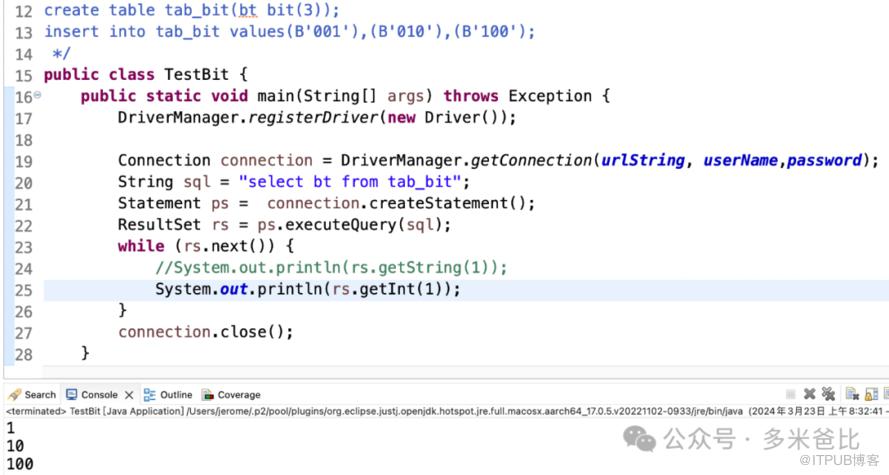
Java使用Double类型存储varchar精度丢失问题
CREATE TABLE t1(a varchar);String sql = "insert into t1 values(?)";PreparedStatement ps = connection.prepareStatement(sql);ps.setObject(1, new Double(48)); ps.execute();ps.setObject(1, new Double(48.1)); ps.execute();ps.setObject(1, new Double(48.9)); ps.execute();
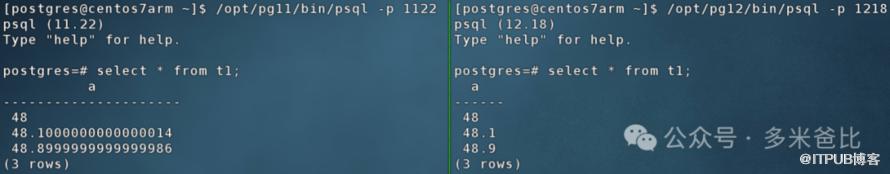
Now, whenever extra_float_digits is more than zero (as it now is by default), only the minimum number of digits required to preserve the exact binary value are output. The behavior is the same as before when extra_float_digits is set to zero or less. https://www.postgresql.org/docs/12/release.html
从12版本开始,不管extra_float_digits参数如何设置,浮点数都使用准确的精度输出。
巧用分区键表达式导数据
$ cat data.csva,b,c1,aa1001,data2,bb1002,data
CREATE TABLE tab(a varchar,b varchar,c varchar) PARTITION BY LIST(substr(b,1,2));
CREATE TABLE tab_aa PARTITION OF tab FOR VALUES IN('aa');CREATE TABLE tab_bb PARTITION OF tab FOR VALUES IN('bb');
postgres=# \copy tab from data.csv with (format 'csv',header true)COPY 2
postgres=# select * from tab;a | b | c---+--------+------1 | aa1001 | data2 | bb1002 | datarows)postgres=# select * from tab_aa;a | b | c---+--------+------1 | aa1001 | datarow)postgres=# select * from tab_bb;a | b | c---+--------+------2 | bb1002 | datarow)
ACL默认显示问题
Drop Table后空间未释放问题
PostgreSQL中drop table后磁盘空间未及时释放问题
https:///db/1767100886471512064
Previously, if the dropped relation spanned multiple 1GB segments, only the first segment was truncated immediately. Other segments were simply unlinked, which doesn't authorize the kernel to release the storage so long as any other backends still have the files open.
https://www.postgresql.org/docs/12/release-12-6.html
如何追踪服务端错误堆栈
backtrace_min_messages='error'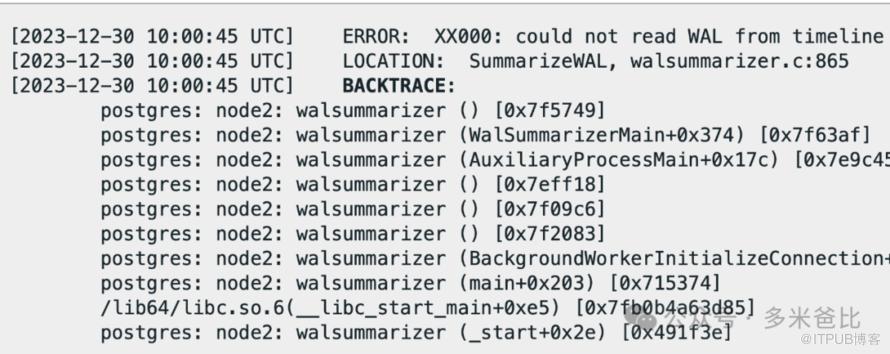
原文作者:象楚之行;如有侵权,请联系管理员删除。

