PGer应知十技
一、准确理解tuple(元组)的概念
我们经常可以看到tuple这个术语,tuple是指数据行的一个物理版本,可以通过表的隐藏系统列ctid、xmin、 xmax来进行观察。
tuple = row version
在PG里,update相当于delete + insert,但也有差异,可以参考文章 PostgreSQL(update ≈ delete + insert)
二、初始化时打开checksums
数据完整性是任何数据库必须首要保证的,PG里可以使用-k或者–data-checksums打开数据校验和。
$ initdb -D pgdata -k
还可以使用pg_checksums工具(12版本引入)进行开关控制:开启(-e,–enable)和关闭(-d,–disable)
如果备份的数据有损坏,还可以使用pg_verifybackup工具进行检测。
三、跨库访问需重新连接
PG里可以创建多个database,每个连接同一时刻只能连一个database,访问不同的数据库需要切换连接。
当我们安装扩展插件时,如果需要多个database都可以使用,那每个database下都需要创建一遍。
四、xlog不能删除
xlog不是普通log,不能删除!
xlog不是普通log,不能删除!
xlog不是普通log,不能删除!
总有客户询问pg_xlog目录下的文件是否可以删除,xlog从版本10开始正式重命名为wal,不需要我们手工干预。
如果该目录占用磁盘空间较大,需要检查wal配置参数是否合理或者复制槽状态是否正常、归档是否正常。
五、按需设置日志项并合理输出
log_destination参数可设置多种输出源
log_destination='stderr,csvlog,jsonlog'
如果需要对日志内容精简条目,需要注意log_destination与log_line_prefix同时设置
log_destination='stderr'
log_line_prefix = '%m %u %d %p'
- %m是带毫秒的时间戳
- %u是用户名
- %d是数据库名
- %p是进程ID
日志文件的覆盖策略以及一些开关项我们也需要平衡观测性与负载压力。
六、truncate操作应按DML进行配置
PG里配置log_statement日志参数、触发器和逻辑复制时都需要按照DML分类进行配置。
七、使用tmux工具高效搭配psql
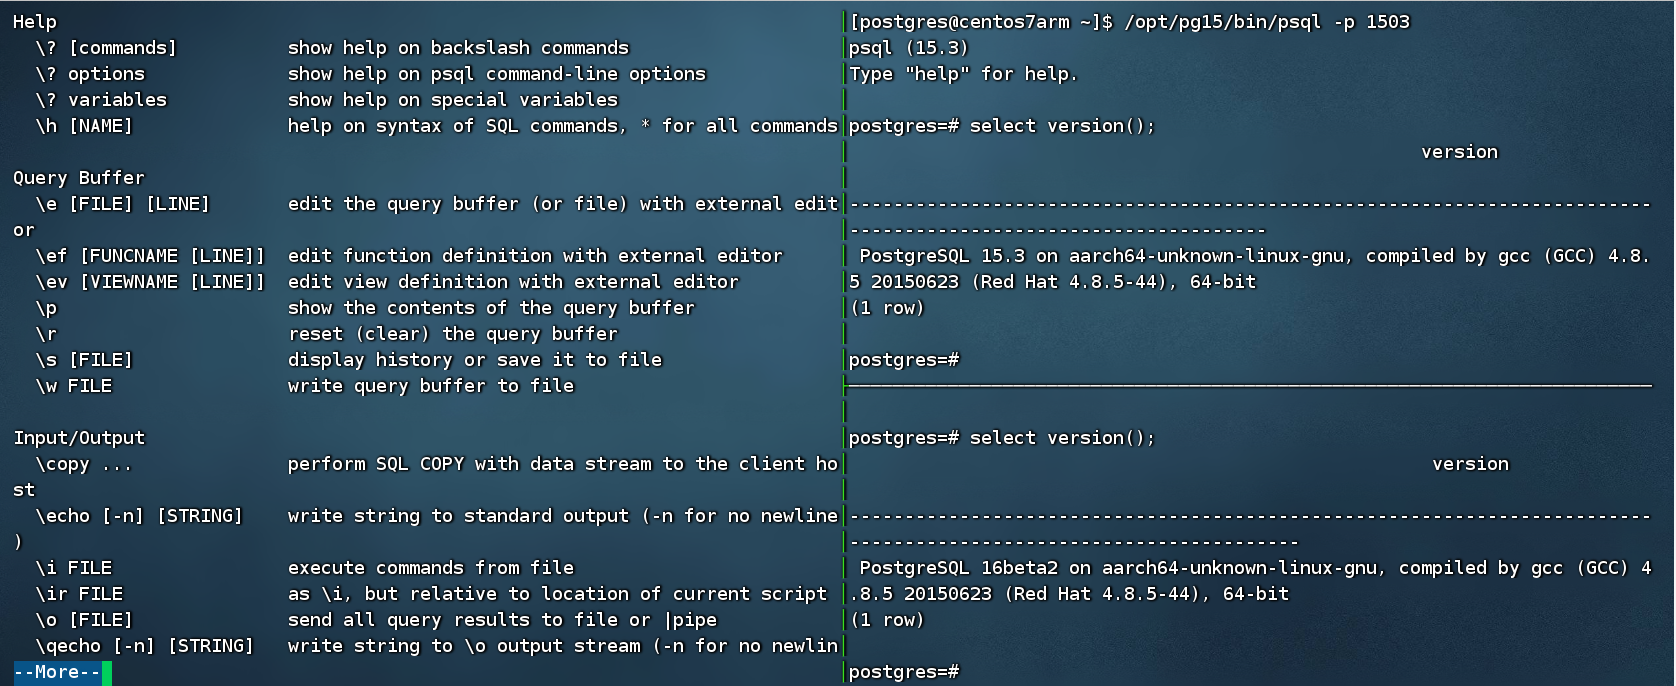
linux环境下使用tmux工具搭配psql可以方便的进行多窗口及分屏,提高工作效率。
八、autovacuum调优
autovacuum进程在后台帮我们清理旧数据以便空间重用,还包括更新表的统计信息以及防止事物ID回卷的工作。
当数据库的负载较高时,可以进行如下调优:
- 使其资源充沛:例如活跃的db较多,则增大autovacuum_max_workers,同时需要注意调小autovacuum_work_mem,不然直接使用maintenance_work_mem,内存可能会占用过大。
- 使其触发更频繁:例如大表vacuum触发参数autovacuum_vacuum_scale_factor,默认值为20%,可以调低为2%
九、定期维护索引
随着DML操作表数据的不断变化,索引分裂及检索低效问题变得突出,查询性能逐渐变差,此时对索引需要做两方面的工作:
- 需要重建索引:reindex concurrently
- 移除不用或者很少使用的索引:监控pg_stat_user_indexes视图的idx_scan以及last_idx_scan(16版本)
十、善用PG关键字
using关键字
当我们做多张表的join连接时,如果join字段的名称相同可以使用using关键字来简化语句
select ...
  from  t1
  join  t2
    on  t1.id = t2.id;
可以改写为:
select ...
  from  t1
  join  t2
 using  (id);
多个字段还可以使用逗号进行分隔:
on t1.a = t2.a and t1.b = t2.b
改写为
using (a,b);
returning关键字
使用returning关键字可以改变数据操作的行为。
例如我们可以插入新数据,并在一次会话连接中取回值。
insert into tasks (
  status, owner, name
) values (
  'open', 'tpetry', 'Create Example'
)
returning *;
当我们更新完数据行后还需要继续处理这些数据行时,可以使用returning更改工作流程返:在所有数据行更新完成后再返回它们,然后我们可以继续对返回的数据进行处理。
update tasks
set owner = NULL
where owner = 'tpetry' and status = 'open'
returning *;
大多数应用程序都允许用户请求删除数据记录,但系统也需要对删除记录进行一些跟踪处理。
delete FROM tasks
where status = 'finished'
returning *;
参考链接
https://postgres.ai/blog/20230722-10-postgres-tips-for-beginners
https://www.modb.pro/db/100292
https://www.modb.pro/db/610845
保持联系
本人组建了一个技术交流群:PG乐知乐享交流群。欢迎关注文章的小伙伴随缘加入,进群请加本人微信skypkmoon并备注PG乐知乐享。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69978456/viewspace-3011569/ ,如需转载,请注明出处,否则将追究法律责任。

