如何查看单条SQL耗费了多少cpu及io
前言
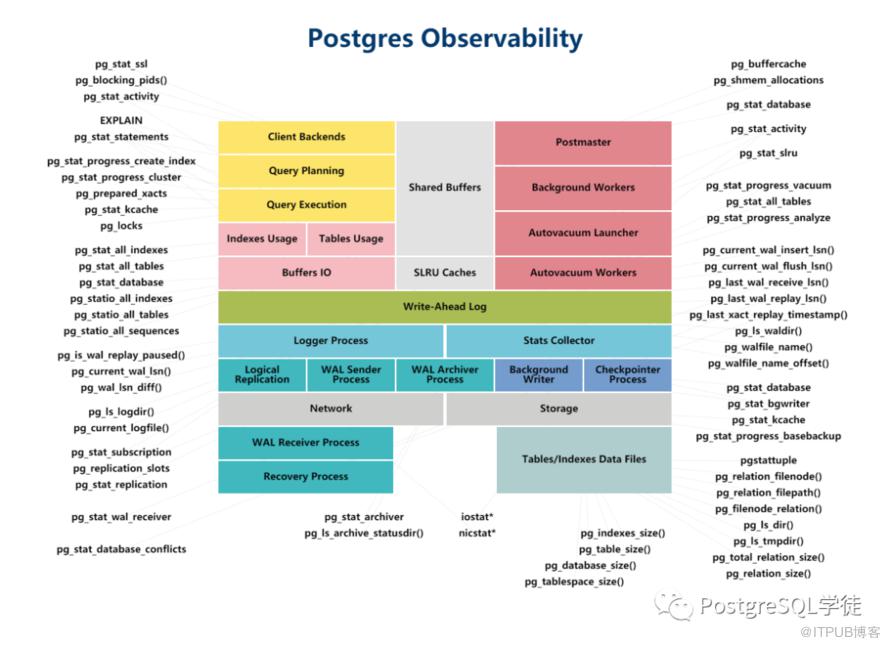
但是,有过很多次实际场景中,业务出现了性能问题,开发人员或架构让我把最消耗cpu的语句抓出来,遗憾的是PostgreSQL并没有直接这样的视图或表记录这些,只能在运行时通过操作系统层面的top等工具,然后结合pg_stat_activity去抓现场,对于后续分析或者追本溯源就只能干瞪眼了。(之前分享的ASH可以做到类似效果)。另外EDB开源的system_stats插件有点类似,但仍不能满足我们的需求,pg_sys_cpu_usage_info()函数看到的是针对所有操作的cpu统计:
hrdb=> select * from pg_sys_cpu_usage_info();
-[ RECORD 1 ]-------------------+----
usermode_normal_process_percent | 0
usermode_niced_process_percent  | 0
kernelmode_process_percent      | 0
idle_mode_percent               | 100
io_completion_percent           | 0
servicing_irq_percent           | 0
servicing_softirq_percent       | 0
user_time_percent               |
processor_time_percent          |
privileged_time_percent         |
interrupt_time_percent          |
pg_sys_cpu_memory_by_process()可以提供每个进程使用的CPU和内存信息,但是也很简陋,若想看跑的什么SQL,还需要去进行join pg_stat_activity,另外还是那个老问题,历史SQL是看不到的,看到的是进行时的状态,历史pid早变了,而且还会显示其他操作系统级的进程,显然不是我关心的。
postgres=# select * from pg_sys_cpu_memory_by_process();
-[ RECORD 1 ]---------+------------------
pid                   | 1
name                  | (systemd)
running_since_seconds | 1319722
cpu_usage             | 0
memory_usage          | 0.13
memory_bytes          | 2433024
-[ RECORD 2 ]---------+------------------
pid                   | 2
name                  | (kthreadd)
running_since_seconds | 1319722
cpu_usage             | 0
memory_usage          | 0
memory_bytes          | 0
-[ RECORD 3 ]---------+------------------
pid                   | 3
name                  | (ksoftirqd/0)
running_since_seconds | 1319722
cpu_usage             | 0
memory_usage          | 0
memory_bytes          | 0
-[ RECORD 4 ]---------+------------------
pid                   | 3004
name                  | (postgres)
running_since_seconds | 7281
cpu_usage             | 0
memory_usage          | 0.93
memory_bytes          | 17154048
先卖个关子,且听下文分析。
实战
有需求,就有解决方案,pg_stat_kcache,该插件支持从文件系统级收集读写等信息。通过这个extension,我们可以查看到每个查询,用户或数据库消耗了多少系统资源。包括:
CPU(user and system)
Pyhsical disk access(read and write)
Pyhsical disk access对于计算真实命中率(cached_reads / all_reads)是必不可少的。没有这个,我们只能计算shared_buffers的命中率,而我们知道,PostgreSQL是十分倚靠page cache的,某些读取可以由操作的系统缓存来处理。
限制:PostgreSQL Version ≥ 9.4,同时需配合pg_stat_statements插件,另外需要在任何Posix的操作系统之上,所以windows暂不支持
安装很简单,在环境变量里要有pg_config
git clone https://github.com/powa-team/pg_stat_kcache.git
cd pg_stat_kcache
make
make install
需要加载动态库
# postgresql.conf
shared_preload_libraries = 'pg_stat_statements,pg_stat_kcache'
pg_stat_kcache总共提供了三个GUC参数:
postgres=# select * from pg_stat_kcache limit 1;
-[ RECORD 1 ]----+-------------------
datname          | postgres
plan_user_time   | 89.38311000000175
plan_system_time | 5.264853999999873
plan_minflts     | 8934
plan_majflts     | 1
plan_nswaps      | 0
plan_reads       | 1478656
plan_reads_blks  | 180
plan_writes      | 16384
plan_writes_blks | 2
plan_msgsnds     | 0
plan_msgrcvs     | 0
plan_nsignals     | 0
plan_nvcsws      | 60
plan_nivcsws     | 8030
exec_user_time   | 149.69108300000414
exec_system_time | 8.492406999999911
exec_minflts     | 736853
exec_majflts     | 1
exec_nswaps      | 0
exec_reads       | 52867072
exec_reads_blks  | 6452
exec_writes      | 232456192
exec_writes_blks | 28376
exec_msgsnds     | 0
exec_msgrcvs     | 0
exec_nsignals    | 0
exec_nvcsws      | 182028
exec_nivcsws     | 9904
要理解pg_stat_kcache里面的字段内容,需要一些知识储备。
虚拟地址和物理地址
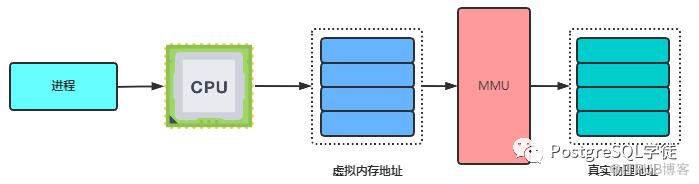
进程和进程之间使用的地址是隔离开的,相互不影响,使用的是虚拟地址。
进程持有的虚拟地址会通过 CPU 芯片中的内存管理单元(MMU,它是一种负责处理中央处理器(CPU)的内存访问请求的计算机硬件。它的功能包括虚拟地址到物理地址的转换(即虚拟内存管理)、内存保护、中央处理器高速缓存的控制,)的映射关系,来转换变成物理地址,然后再通过物理地址访问内存。
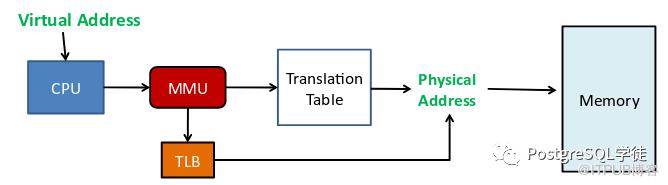
此外还有TLB,属于CPU内部的一个模块,TLB是MMU的一部分,实质是cache,它所缓存的是最近使用的数据的页表项(虚拟地址到物理地址的映射)。他的出现是为了加快访问数据(内存)的速度,减少重复的页表查找。
何为Page Fault
当进程访问它的虚拟地址空间中的PAGE时,如果这个PAGE目前还不在物理内存中,此时CPU是不能干活的,Linux会产生一个hard page fault中断。系统需要从慢速设备(如磁盘)将对应的数据PAGE读入物理内存,并建立物理内存地址与虚拟地址空间PAGE的映射关系。然后进程才能访问这部分虚拟地址空间的内存。
page fault 又分为几种,major page fault、 minor page fault、 invalid(segment fault)。
major page fault也称为hard page fault, 指需要访问的内存不在虚拟地址空间,也不在物理内存中,需要从慢速设备载入。从swap回到物理内存也是hard page fault。
minor page fault也称为soft page fault, 指需要访问的内存不在虚拟地址空间,但是在物理内存中,只需要MMU建立物理内存和虚拟地址空间的映射关系即可。(通常是多个进程访问同一个共享内存中的数据,可能某些进程还没有建立起映射关系,所以访问时会出现soft page fault)。
invalid fault也称为segment fault, 指进程需要访问的内存地址不在它的虚拟地址空间范围内,属于越界访问,内核会报segment fault错误。
有了这些知识储备,下面的表格就好理解了。
pg_stat_kcache是针对整库的,对于我们用户不是很大,需要关心的是pg_stat_kcache_detail,如下可以看到响应SQL,soft page faults的次数很多,user cpu execute花费了0.001006ms,planning花费了0.0033799999999999998ms。
postgres=# select * from pg_stat_kcache_detail limit 1;
-[ RECORD 1 ]----+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
query            | select o.n, p.partstrat, pg_catalog.count(i.inhparent) from pg_catalog.pg_class as c join pg_catalog.pg_namespace as n on (n.oid = c.relnamespace) cross join lateral (select pg_catalog.array_position(pg_catalog.current_schemas($1), n.nspname)) as o(n) left join pg_catalog.pg_partitioned_table as p on (p.partrelid = c.oid) left join pg_catalog.pg_inherits as i on (c.oid = i.inhparent) where c.relname = $2 and o.n is not null group by 1, 2 order by 1 asc limit $3
top              | t
datname          | postgres
rolname          | postgres
plan_user_time   | 0.0033799999999999998
plan_system_time | 0
plan_minflts     | 318
plan_majflts     | 0
plan_nswaps      | 0
plan_reads       | 106496
plan_reads_blks  | 13
plan_writes      | 0
plan_writes_blks | 0
plan_msgsnds     | 0
plan_msgrcvs     | 0
plan_nsignals    | 0
plan_nvcsws      | 7
plan_nivcsws     | 0
exec_user_time   | 0.001006
exec_system_time | 0.0008350000000000001
exec_minflts     | 262
exec_majflts     | 0
exec_nswaps      | 0
exec_reads       | 0
exec_reads_blks  | 0
exec_writes      | 0
exec_writes_blks | 0
exec_msgsnds     | 0
exec_msgrcvs     | 0
exec_nsignals    | 0
exec_nvcsws      | 0
exec_nivcsws     | 0
那么,我就可以统计出最耗费CPU资源的SQL了:
postgres=# select * from pg_stat_kcache_detail order by exec_user_time desc limit 1;
-[ RECORD 1 ]----+-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
--
query            | UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE aid = $2
top              | t
datname          | postgres
rolname          | postgres
plan_user_time   | 16.279118000001443
plan_system_time | 1.1130680000001076
plan_minflts     | 4838
plan_majflts     | 0
plan_nswaps      | 0
plan_reads       | 32768
plan_reads_blks  | 4
plan_writes      | 0
plan_writes_blks | 0
plan_msgsnds     | 0
plan_msgrcvs     | 0
plan_nsignals    | 0
plan_nvcsws      | 17
plan_nivcsws     | 1933
exec_user_time   | 43.67870800000011
exec_system_time | 3.1570279999997624
exec_minflts     | 711708
exec_majflts     | 0
exec_nswaps      | 0
exec_reads       | 52416512
exec_reads_blks  | 6398
exec_writes      | 186580992
exec_writes_blks | 22776
exec_msgsnds     | 0
exec_msgrcvs     | 0
exec_nsignals    | 0
exec_nvcsws      | 658
exec_nivcsws     | 3140
其他类似,就不过多展开了。
小结
pg_stat_kcache给我们提供了一个可以分析具体某某SQL到底耗费了多少系统资源的手段,结合plan_minflts、plan_majflts、plan_nswaps可以进一步分析到底是内存太小了,还是shared buffers不合理等可能的原因;结合plan_nvcsws和plan_nivcsws分析,若非自愿上下文切换次数过多,那么可以分析是否遇到CPU瓶颈了,比如大量进程争抢CPU时间片。而自愿上下文切换次数过多的话,指进程无法获取所需资源导致的,比如 I/O、内存等系统资源不足。
总之pg_stat_kcache是一个不错的性能分析插件👍
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

