一文搞懂Postgres中的计划节点
Part I
Various Scan Methods
在任何一个关系数据库引擎中,都要求以最少的时间和资源生成与查询相对应的最佳执行计划。通常情况下,所有数据库以树结构的形式生成查询计划,其中每棵树的叶子节点称为表扫描节点——table scan node。这种特定的树节点,也即算法,对应着如何从基表中获取数据。假设现在有一个简单的查询,并且假定计划树如下:
SELECT * FROM TBL1, TBL2 where TBL2.ID>1000;
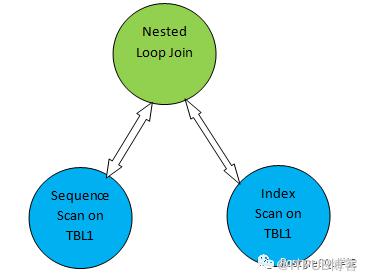
对于上面这个计划树, “Sequential Scan on TBL1” and “Index Scan on TBL2”分别对应着扫描TBL1和TBL2的扫描方法。因此按着这个计划,表TBL1会被顺序的从对应页上数据,表TBL2则通过索引扫描。
在计划中选择一个正确的扫描方法,对于整体性能而言至关重要。
在深入了解PostgreSQL支持的所有类型的扫描方法之前,让我们先温故一些要点,这些会在后文经常被提及。
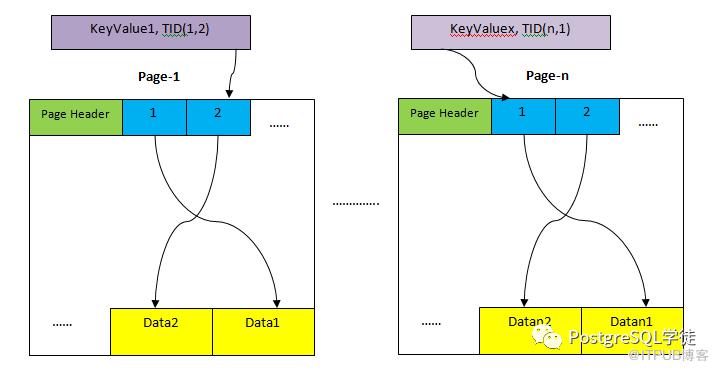
Heap:存储表中所有行的存储区域。Heap被划分为多个页面(如上图所示),每个页面的默认大小为8KB。在每个页面中,每个项目指针(例如1、2、..)分别指向页面中实际的数据。
Index Storage:这种存储只存储键值,即索引所包含的列值。这也被划分为多个页面,每个页面的默认大小为8KB。
Tuple Identifier (TID):TID是一个由两部分组成的6字节数字。第一部分是4字节的页号,剩余2字节是元组索引。这两个数字的组合可以唯一指向一个特定元组的存储位置。
目前,PostgreSQL支持如下这些以从表中取出所需数据的扫描方法:
Sequential Scan
Index Scan
Index Only Scan
Bitmap Scan
TID Scan
每一个扫描方法都同样有用,这取决于查询本身,和一些其他的参数,如表的基数、表的选择率、磁盘随机IO的成本、顺序IO的成本等等。让我们先创建一些表,并填充一些数据,这会方便解释这些扫描方法。
postgres=# CREATE TABLE demotable (num numeric, id int);
CREATE TABLE
postgres=# CREATE INDEX demoidx ON demotable(num);
CREATE INDEX
postgres=# INSERT INTO demotable SELECT random() * 1000,  generate_series(1, 1000000);
INSERT 0 1000000
postgres=# analyze;
ANALYZE
在这个例子,插入了1千万数据,并且进行了analyze,以确保所有的统计信息是最新的。
顺序扫描
顾名思义,对某表的顺序扫描是通过顺序扫描对应表所有页面的所有项目指针来完成的。因此,如果某个表有100页,然后每页中有1000条记录,那么作为顺序扫描的一部分,它会获取100 * 1000条记录,并根据隔离级别和谓词子句检查是否匹配。因此,即使在整个表扫描中只选择了1条记录,也必须扫描100K条记录才能根据条件找到合格的记录。
根据上面的表和数据,由于选择了大多数数据,因此以下查询将导致顺序扫描。
postgres=# explain SELECT * FROM demotable WHERE num < 21000;
                             QUERY PLAN
--------------------------------------------------------------------
 Seq Scan on demotable  (cost=0.00..17989.00 rows=1000000 width=15)
   Filter: (num < '21000'::numeric)
(2 rows)
尽管没有计算和比较计划成本,也几乎无法确定将使用哪种扫描。但至少为了可以使用顺序扫描,应该满足如下条件:
谓词键上没有可用的索引
SQL查询将获取大多数行
如果只需要获取很少的行,并且谓词在一个(或多个)列上,那么请尝试评估一下有或没有索引的性能。
索引扫描
与顺序扫描不同,索引扫描不会按顺序获取所有记录。相反,它使用的是与查询中涉及到的索引所对应的不同种类的数据结构(取决于索引的类型),并通过非常小的扫描定位到所需的数据(根据谓词子句)。
然后,使用索引扫描找到的条目,这些条目直接指向Heap区域中的数据(如上图所示),然后根据隔离级别检查可见性以获取这些数据。索引扫描有两个步骤:
现在我们可能会疑惑,既然索引如此高效,为何不总是使用索引扫描。正如我们所知,每件事都是有代价的。这里涉及的成本与我们正在执行的I / O类型有关。对于索引扫描,涉及到随机I / O,就像在索引中找到的每个记录一样,它必须从HEAP存储中获取相应的数据,而对于顺序扫描,则涉及到顺序I / O,顺序I / O大约只需要花费25% 随机I / O的时间。
因此,由于有随机IO的存在,只有整体的增益超过开销时,才应选择索引扫描。
根据前面的表和数据,以下查询将使用索引扫描,因为仅选择了一条记录。因此,随机I / O更少,并且搜索相对应的记录也很快。
postgres=# explain SELECT * FROM demotable WHERE num = 21000;
                                QUERY PLAN
--------------------------------------------------------------------------
 Index Scan using demoidx on demotable  (cost=0.42..8.44 rows=1 width=15)
   Index Cond: (num = '21000'::numeric)
(2 rows)
仅索引扫描
仅索引扫描类似于索引扫描,除了第二步,顾名思义,它只扫描索引数据结构。为了选择仅索引扫描而不是索引扫描,还有两个附加的前提条件:
查询只获取索引中所包含的列。
对应堆页上的所有元组(记录)都应该可见。如前一节所述,索引数据结构并不会维护可见性信息,因此,为了仅从索引中获取数据,我们应避免检查可见性,如果认为该页面上的所有数据都认为是可见的,则可能会发生这种情况。
下面的查询将使用仅扫描索引。即使这个查询在选择记录的数量方面几乎和前一节的索引扫描是类似的,但因为只有字段(即num)被选择,所以它会选择Index only Scan。
postgres=# explain SELECT num FROM demotable WHERE num = 21000;
                                  QUERY PLAN
-----------------------------------------------------------------------------
Index Only Scan using demoidx on demotable  (cost=0.42..8.44 rows=1 Width=11)
   Index Cond: (num = '21000'::numeric)
(2 rows)
位图扫描
位图扫描是索引扫描和顺序扫描的结合。它试图解决索引扫描的缺点,但仍会保持其优点。如上文所述,每一条在索引数据结构中找到的数据,都需要在Heap页中找到对应的数据。因此,它还需要先获取索引页,然后再获取堆页,这会导致大量的随机I / O。因此,位图扫描利用了索引扫描的优势,而无需使用随机I / O。位图扫描使用到了两种方式,如下所示:
Bitmap Index Scan:首先,它从索引数据结构中获取所有索引数据,并创建所有TID的位图映射。为了简单理解,可以将此位图看作包含所有页面的散列(基于页号的散列),并且每个页面条目包含一个包含该页的页内所有偏移量的数组。
Bitmap Heap Scan:顾名思义,它通过读取页面的位图,然后从堆中扫描对应的页和偏移量。最后,它检查可见性和谓词等,并根据所有这些检查的结果返回元组。
下面的查询将使用位图扫描,因为该查询并没有获取很少的记录(对于索引扫描来说太多),同时又没有获取大量的记录(对于顺序扫描来说又太少)。
postgres=# explain SELECT * FROM demotable WHERE num < 210;
                                  QUERY PLAN
-----------------------------------------------------------------------------
 Bitmap Heap Scan on demotable  (cost=5883.50..14035.53 rows=213042 width=15)
   Recheck Cond: (num < '210'::numeric)
   ->  Bitmap Index Scan on demoidx  (cost=0.00..5830.24 rows=213042 width=0)
      Index Cond: (num < '210'::numeric)
(4 rows)
现在考虑下面的查询,该查询获取相同数量的记录,但仅选择关键字段(即仅索引列)。由于它仅获取索引列,因此不需要为其他部分数据而去引用堆页面,因此不会涉及到随机I / O。因此,此查询将选择“仅索引扫描”而不是“位图扫描”。
postgres=# explain SELECT num FROM demotable WHERE num < 210;
                                   QUERY PLAN
---------------------------------------------------------------------------------------
 Index Only Scan using demoidx on demotable  (cost=0.42..7784.87 rows=208254 width=11)
   Index Cond: (num < '210'::numeric)
(2 rows)
TID扫描
如上所述,TID是一个6字节的数字,由4字节的页号和2字节页内元组索引组成。TID扫描是PostgreSQL中一种非常特殊的扫描,只有在查询谓词中有TID时才会被选中。见如下样例:
postgres=# select ctid from demotable where id=21000;
  ctid
----------
 (115,42)
(1 row)

postgres=# explain select * from demotable where ctid='(115,42)';
                        QUERY PLAN
----------------------------------------------------------
 Tid Scan on demotable  (cost=0.00..4.01 rows=1 width=15)
   TID Cond: (ctid = '(115,42)'::tid)
(2 rows)
因此,在谓词中,不是将列的准确值作为条件,而是提供了TID。这类似于Oracle中基于ROWID的检索。
小结
所有的扫描方法都被广泛使用并出名。同样,这些扫描方法在几乎所有的关系数据库中都可用。但是,最近在PostgreSQL社区中正在讨论另一种扫描方法,并且最近在其他关系数据库中也添加了这种扫描方法。它在MySQL中被称为“Loose IndexScan”,在Oracle中被称为“Index Skip Scan”,在DB2中被称为“Jump Scan”。
此扫描方法用于特定场景,在该场景中,B树索引的前导列的不同值很少。作为此扫描的一部分,它避免遍历所有相等的列,而只是遍历第一个唯一值,然后跳转到下一个大值。
这项工作在PostgreSQL中仍在进行中,暂定名称为“Index Skip Scan”,我们可能希望在以后的版本中能够看到这一点。
译者著:
所以目前的版本中,PostgreSQL还不支持“跳跃索引”,我们暂时可以使用CTE的方式等价改写一下,详情参考:https://wiki.postgresql.org/wiki/Loose_indexscan
除此之外,还支持其他类型的扫描节点:
Subquery Scan,扫描一个子查询
Function Scan,处理含有函数的扫描
TableFunc Scan,处理tablefunc 相关的扫描
Values Scan,用于扫描Values 链表的扫描
Cte Scan,用于扫描WITH 字句的结果集
NamedTuplestore Scan,用于某些命名的结果集的扫描
WorkTable Scan,用于扫描Recursive Union 的中间数据
Foreign Scan,用于外键扫描
Custom Scan,用于用户自定义的扫描
Part II
Various JOIN Methods
在我之前的博客中,我们讨论了从单个表中选择或扫描数据的各种方法。但在实际中,仅从单个表获取数据是不够的,往往需要从多个表中选择数据,然后在它们之间进行关联。这些数据在表之间的关联称为连接表,可以有多种方式实现。由于连接表需要有数据的输入(例如,从表扫描),因此在生成的计划中它永远不能是叶节点。
假设现在有如下查询,并且假设生成的计划如下:
SELECT * FROM TBL1, TBL2 where TBL1.ID > TBL2.ID;
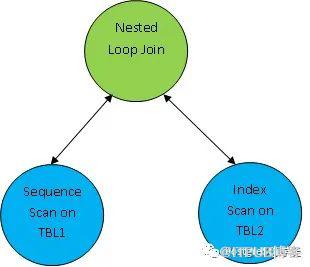
所以在这里,第一步,先扫描两个表,然后按照关联条件TBL.ID > TBL2.ID进行关联。除了连接方法之外,连接顺序也非常重要。考虑下面的例子:
SELECT * FROM TBL1, TBL2, TBL3 WHERE TBL1.ID=TBL2.ID AND TBL2.ID=TBL3.ID;
假设TBL1、TBL2和TBL3分别有10条、100条和1000条记录。
其中根据TBL1.ID = TBL2.ID的条件,只返回10条记录,而TBL2.ID=TBL3.ID则会返回100条记录,那么最好先对TBL1和TBL2进行连接,这样与TBL3连接的记录数量就会减少。计划如下所示:

PostgreSQL支持如下几种连接方式:
Nested Loop Join
Hash Join
Merge Join
每一个连接方法都是有用的,这取决于查询本身和其他参数(如查询、表数据、连接子句、选择性、内存等)。大多数关系型数据库实现了这些连接方法。
让我们先创建一些表,并填充一些数据,这会方便解释这些连接方法。
postgres=# create table blogtable1(id1 int, id2 int);
CREATE TABLE
postgres=# create table blogtable2(id1 int, id2 int);
CREATE TABLE
postgres=# insert into blogtable1 values(generate_series(1,10000),3);
INSERT 0 10000
postgres=# insert into blogtable2 values(generate_series(1,1000),3);
INSERT 0 1000
postgres=# analyze;
ANALYZE
在接下来的所有示例中,我们都考虑使用默认配置参数,除非特别指定。
Nested Loop Join
NLJ (Nested Loop Join)是一种最简单的连接算法,每条外部关系的记录与每条内部关系的记录相匹配。条件为A.ID < B.ID的A与B之间的连接可以表示为
For each tuple r in A
        For each tuple s in B
                If (r.ID < s.ID)
                    Emit output tuple (r,s)
Nested Loop Join(NLJ)是最常用的连接方法,它几乎可以用于任何类型、任何数据集的连接子句。由于该算法需要扫描外表和内表的所有元组,因此Nested Loop Join被认为是开销最大的连接操作。
根据上面的表和数据,下面的查询会使用Nested Loop Join,如下所示:
postgres=# explain select * from blogtable1 bt1, blogtable2 bt2 where bt1.id1 < bt2.id1;
                               QUERY PLAN
------------------------------------------------------------------------------
 Nested Loop  (cost=0.00..150162.50 rows=3333333 width=16)
   Join Filter: (bt1.id1 < bt2.id1)
   ->  Seq Scan on blogtable1 bt1  (cost=0.00..145.00 rows=10000 width=8)
   ->  Materialize  (cost=0.00..20.00 rows=1000 width=8)
         ->  Seq Scan on blogtable2 bt2  (cost=0.00..15.00 rows=1000 width=8)
(5 rows)
因为连接子句是“<”,所以这里唯一可能的连接方法即是Nested Loop Join。注意这里出现了一个新类型的节点:Materialize,该节点作为中间结果缓存,用于替代多次获取一个表中的所有元组,Materialize会将第一次获取的结果集存储在内存中,下一次请求获取元组时将直接从内存中获取,而不是再次从表中数据页内获取。
在某些情况下,Materialize对于Nested Loop Join很有用。对于Merge join,在某种程度上Materialize也很有用,因为会依赖对内表的重复扫描,Materialize节点并不仅限于缓存表的查询结果,还可以缓存计划树中下方任何节点的结果。
Tips:如果join子句为“=”,并且在表之间选择了Nested Loop Join,那么研究是否可以通过调整配置参数(例如work_mem但不仅限于work_mem)选择更有效的联接方法(例如Hash join或者Merge join)非常重要,除此之外也可以考虑添加索引等。
有些查询可能没有连接子句,在这种情况下,连接的唯一选择就是Nested Loop Join(NLJ)。例如,根据之前的数据考虑以下查询:
postgres=# explain select * from blogtable1, blogtable2;
                             QUERY PLAN
--------------------------------------------------------------------------
 Nested Loop  (cost=0.00..125162.50 rows=10000000 width=16)
   ->  Seq Scan on blogtable1  (cost=0.00..145.00 rows=10000 width=8)
   ->  Materialize  (cost=0.00..20.00 rows=1000 width=8)
      ->  Seq Scan on blogtable2  (cost=0.00..15.00 rows=1000 width=8)
(4 rows)
上面示例中的连接只是两个表的笛卡尔积。
Hash Join
该算法分两个阶段:
构建阶段:使用内表记录构建一个哈希表。散列键根据连接子句计算得到。
探测阶段:外表记录将基于连接子句键进行散列,以在散列表中找到匹配的条目。
若连接条件为A.ID = B.ID,那么A与B之间的连接可以表示为:
构建阶段:
遍历内表B的每一条元组 r
将r.ID插入到哈希表HashTab中
探测阶段:
遍历外表A的每一条元组s,进行散列
如果s.ID = r.ID,输出元组(r,s)
根据上面的表和数据,下面的查询会使用Hash join,如下所示:
postgres=# explain select * from blogtable1 bt1, blogtable2 bt2 where bt1.id1 = bt2.id1;
                               QUERY PLAN
------------------------------------------------------------------------------
 Hash Join  (cost=27.50..220.00 rows=1000 width=16)
   Hash Cond: (bt1.id1 = bt2.id1)
   ->  Seq Scan on blogtable1 bt1  (cost=0.00..145.00 rows=10000 width=8)
   ->  Hash  (cost=15.00..15.00 rows=1000 width=8)
         ->  Seq Scan on blogtable2 bt2  (cost=0.00..15.00 rows=1000 width=8)
(5 rows)
这里,基于表blogtable2创建了哈希表,因为它是一个较小的表,所以需要的内存也较少,这样整个哈希表页可以完全放入内存中。
Merge Join
Merje join是一种,每条外表的记录与每条内表的记录相匹配,直到有可能匹配到连接子句为止的算法。此连接算法仅在两个表都已排序并且连接子句操作符为“=”时才使用。连接条件为A.ID = B.ID,那么表A与B之间的连接可以表示为:
For each tuple r in A
    For each tuple s in B
         If (r.ID = s.ID)
              Emit output tuple (r,s)
              Break;
         If (r.ID > s.ID)
              Continue;
         Else
              Break;
如上所示,如果在两个表上都创建了索引,那么走Hash Join的示例查询可能会使用Merge Join。这是因为由于索引,表中数据可以按顺序检索,这也是Merge Join方法的主要条件之一:
postgres=# create index idx1 on blogtable1(id1);
CREATE INDEX
postgres=# create index idx2 on blogtable2(id1);
CREATE INDEX
postgres=# explain select * from blogtable1 bt1, blogtable2 bt2 where bt1.id1 = bt2.id1;
                                   QUERY PLAN
---------------------------------------------------------------------------------------
 Merge Join  (cost=0.56..90.36 rows=1000 width=16)
   Merge Cond: (bt1.id1 = bt2.id1)
   ->  Index Scan using idx1 on blogtable1 bt1  (cost=0.29..318.29 rows=10000 width=8)
   ->  Index Scan using idx2 on blogtable2 bt2  (cost=0.28..43.27 rows=1000 width=8)
(4 rows)
因此,正如我们所看到的,两个表都使用索引扫描而不是顺序扫描,因为这两个表都将返回已排序的记录。
配置
PostgreSQL支持多种与规划器相关的配置,这些配置可用于提示查询优化器不要选择某些特定类型的连接方法。如果优化器选择的连接方法不是最优的,那么可以关闭这些配置参数,以强制查询优化器选择不同类型的连接方法。默认情况下,所有这些配置参数都是开启的。下面是对于特定连接方法的规划器配置参数:
enable nestloop:对应Nested Loop Join
enable hashjoin:对应Hash Join
enable mergejoin:对应Merge Join
有许多与计划相关的配置参数,可以用于各种目的。在本博客中,仅讨论连接方式。
这些参数可以在特定会话中调整。因此,如果我们想在特定的会话中试验该计划,那么可以调整这些配置参数,而其他会话仍会继续正常工作。现在,考虑上面的Merge Join和Hash Join示例。在没有索引的情况下,查询优化器为下面的查询选择了Hash Join,如下所示,但是在调整配置后,它切换至Merge Join:
postgres=# explain select * from blogtable1, blogtable2 where blogtable1.id1 = blogtable2.id1;
                             QUERY PLAN
--------------------------------------------------------------------------
 Hash Join  (cost=27.50..220.00 rows=1000 width=16)
   Hash Cond: (blogtable1.id1 = blogtable2.id1)
   ->  Seq Scan on blogtable1  (cost=0.00..145.00 rows=10000 width=8)
   ->  Hash  (cost=15.00..15.00 rows=1000 width=8)
      ->  Seq Scan on blogtable2  (cost=0.00..15.00 rows=1000 width=8)
(5 rows)

postgres=# set enable_hashjoin to off;
SET

postgres=# explain select * from blogtable1, blogtable2 where blogtable1.id1 = blogtable2.id1;
                             QUERY PLAN
----------------------------------------------------------------------------
 Merge Join  (cost=874.21..894.21 rows=1000 width=16)
   Merge Cond: (blogtable1.id1 = blogtable2.id1)
   ->  Sort  (cost=809.39..834.39 rows=10000 width=8)
      Sort Key: blogtable1.id1
      ->  Seq Scan on blogtable1  (cost=0.00..145.00 rows=10000 width=8)
   ->  Sort  (cost=64.83..67.33 rows=1000 width=8)
      Sort Key: blogtable2.id1
      ->  Seq Scan on blogtable2  (cost=0.00..15.00 rows=1000 width=8)
(8 rows)
最初选择Hash Join是因为表中的数据没有排序。为了选择Merge Join ,它需要首先对从两个表中检索到的所有记录进行排序,然后再使用Merge Join。所以排序所带来的额外成本,会使得总成本增加。因此,在本例中,总代价(包括增加的代价)可能大于Hash Join的总代价,因此规划器选择了Hash Join。
一旦配置参数enable_hashjoin被设为off,这意味着查询优化器直接为Hash Join分配了一个成本作为“禁用成本”(=1.0e10,即10000000000.00)。任何其他可能的连接方式的成本都比这个要低。因此,当配置参数enable_hashjoin被设为off时,可以返回同样结果集的Merge Join会被选择,即使加上了排序的成本,Merge Join的总成本也要比“禁用成本”低。
现在参考如下示例:
postgres=# explain select * from blogtable1, blogtable2 where blogtable1.id1 < blogtable2.id1;
                             QUERY PLAN
--------------------------------------------------------------------------
 Nested Loop  (cost=0.00..150162.50 rows=3333333 width=16)
   Join Filter: (blogtable1.id1 < blogtable2.id1)
   ->  Seq Scan on blogtable1  (cost=0.00..145.00 rows=10000 width=8)
   ->  Materialize  (cost=0.00..20.00 rows=1000 width=8)
      ->  Seq Scan on blogtable2  (cost=0.00..15.00 rows=1000 width=8)
(5 rows)

postgres=# set enable_nestloop to off;
SET

postgres=# explain select * from blogtable1, blogtable2 where blogtable1.id1 < blogtable2.id1;
                             QUERY PLAN
--------------------------------------------------------------------------
 Nested Loop  (cost=10000000000.00..10000150162.50 rows=3333333 width=16)
   Join Filter: (blogtable1.id1 < blogtable2.id1)
   ->  Seq Scan on blogtable1  (cost=0.00..145.00 rows=10000 width=8)
   ->  Materialize  (cost=0.00..20.00 rows=1000 width=8)
      ->  Seq Scan on blogtable2  (cost=0.00..15.00 rows=1000 width=8)
(5 rows)
正如我们在上面看到的,即使Nested Loop Join相关的配置参数设为off,规划器也仍然选择了Nested Loop Join,因为没有任何其他可能性,去选择其他任何类型的连接方法。简单来说,由于Nested Loop Join是唯一可能的连接方式,那么无论代价是多少,它总是赢家(就好比独自跑100米时我是赢家一样,因为只有我一个人跑)。同时,注意第一计划和第二计划在成本上的差异。第一个计划显示了Nested Loop Join的实际成本,而第二个计划显示了相同的“禁用成本”。
小结
所有的PostgreSQL连接方法都是有用的,根据查询、数据、连接子句等的性质进行选择。如果查询没有按照预期执行,即没有按照预期选择连接方法,那么用户可以尝试使用不同的规划器配置参数,看看是否遗漏了什么。
译者著:
原来规划器参数会和“禁用成本”相关联,加深一下理解
Part III
Various Auxiliary Plan Nodes
所有的现代数据库系统都支持查询优化器,该模块能自动识别最有效的策略以执行SQL查询。高效的策略称为“Plan”,它以与“查询执行/响应时间”成正比的成本来评估与衡量。计划以查询优化器输出的树所呈现。计划树节点可以大致分为以下3类:
扫描节点:正如我在之前的博客“An Overview of the Various Scan Methods in PostgreSQL”中所解释的,它指出了获取基表数据的方式。
连接节点:正如我在之前的博客“An Overview of the JOIN Methods in PostgreSQL”中所解释的,它指出了如何将两个表连接在一起以获得两个表的结果。
物化节点:也被称之为辅助节点。前两种节点与如何从基表获取数据以及如何连接从两个表检索到的数据有关。而这个类别中的节点应用于检索到的数据之上,以便进一步分析或准备等,如数据排序、数据聚合等。
考虑如下简单的查询,并且假设生成的计划如下:
SELECT * FROM TBL1, TBL2 where TBL1.ID > TBL2.ID order by TBL.ID;
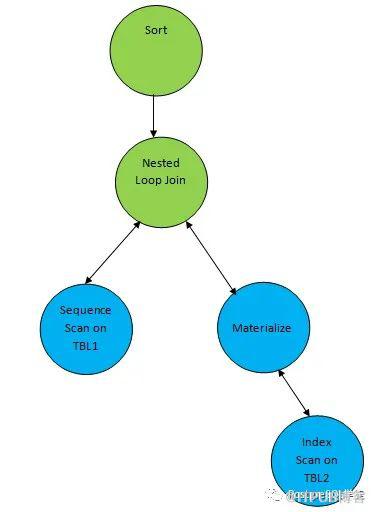
因此,这里在join的结果之上添加了一个辅助节点Sort,以按照所需的顺序对数据进行排序。PostgreSQL查询优化器生成的一些辅助节点如下:
Sort
Aggregate
Group By Aggregate
Limit
Unique
LockRows
SetOp
让我们分别理解这些节点。
Sort
顾名思义,每当需要排序数据时,这个节点就会作为计划树的一部分被添加。可以显式或隐式地要求排序数据,有如下两种情况:
用户场景要求将排序数据作为输出。在这种情况下,Sort节点可以位于整个数据检索(包括所有其他处理)之上。
postgres=# CREATE TABLE demotable (num numeric, id int);
CREATE TABLE
postgres=# INSERT INTO demotable SELECT random() * 1000, generate_series(1, 10000);
INSERT 0 10000
postgres=# analyze;
ANALYZE
postgres=# explain select * from demotable order by num;
                           QUERY PLAN
----------------------------------------------------------------------
 Sort  (cost=819.39..844.39 rows=10000 width=15)
   Sort Key: num
   ->  Seq Scan on demotable  (cost=0.00..155.00 rows=10000 width=15)
(3 rows)
注意:即使用户要求最终输出按已排序的顺序,如果对应的表和排序列上有索引,则可能不会在最终计划中添加Sort节点。在这种情况下,它可以选择索引扫描,这样数据会被隐式排序。例如,让我们在上面的例子上创建一个索引并查看结果:
postgres=# CREATE INDEX demoidx ON demotable(num);
CREATE INDEX
postgres=# explain select * from demotable order by num;
                                QUERY PLAN
--------------------------------------------------------------------------------
 Index Scan using demoidx on demotable  (cost=0.29..534.28 rows=10000 width=15)
(1 row)
正如我在之前的博客“An Overview of the JOIN Methods in PostgreSQL”中所解释的,Merge Join需要在连接之前对两个表数据进行排序。因此,可能会发现Merge Join比其他任何连接方法的成本都要低,即使需要额外的排序成本。因此,在本例中,Sort节点将添加到表的连接和扫描方法之间,以便将已排序的记录传递给连接方法。
postgres=# create table demo1(id int, id2 int);
CREATE TABLE
postgres=# insert into demo1 values(generate_series(1,1000), generate_series(1,1000));
INSERT 0 1000
postgres=# create table demo2(id int, id2 int);
CREATE TABLE
postgres=# create index demoidx2 on demo2(id);
CREATE INDEX
postgres=# insert into demo2 values(generate_series(1,100000), generate_series(1,100000));
INSERT 0 100000
postgres=# analyze;
ANALYZE
postgres=# explain select * from demo1, demo2 where demo1.id=demo2.id;
                                  QUERY PLAN
------------------------------------------------------------------------------------
 Merge Join  (cost=65.18..109.82 rows=1000 width=16)
   Merge Cond: (demo2.id = demo1.id)
   ->  Index Scan using demoidx2 on demo2  (cost=0.29..3050.29 rows=100000 width=8)
   ->  Sort  (cost=64.83..67.33 rows=1000 width=8)
      Sort Key: demo1.id
      ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=8)
(6 rows)
Aggregate
如果有某个聚合函数用于从多个输入元组中计算以得到单个结果,那么Aggregate节点就会作为规划树的一部分被添加。一些常用的聚合函数是COUNT, SUM, AVG (AVERAGE), MAX (MAXIMUM)和MIN (MINIMUM)。聚合节点可以位于基表扫描或(和)表连接之上。示例:
postgres=# explain select count(*) from demo1;
                       QUERY PLAN
---------------------------------------------------------------
 Aggregate  (cost=17.50..17.51 rows=1 width=8)
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=0)
(2 rows)

postgres=# explain select sum(demo1.id) from demo1, demo2 where demo1.id=demo2.id;
                                       QUERY PLAN
-----------------------------------------------------------------------------------------------
 Aggregate  (cost=112.32..112.33 rows=1 width=8)
   ->  Merge Join  (cost=65.18..109.82 rows=1000 width=4)
      Merge Cond: (demo2.id = demo1.id)
      ->  Index Only Scan using demoidx2 on demo2  (cost=0.29..3050.29 rows=100000 width=4)
      ->  Sort  (cost=64.83..67.33 rows=1000 width=4)
            Sort Key: demo1.id
            ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=4)
HashAggregate / GroupAggregate
这些类型的节点是Aggregate节点的扩展。如果使用聚合函数来按组分组组合多个输入行,那么这些类型的节点将被添加到规划树中。因此,如果查询使用了某个聚合函数,并且查询中还包含一个GROUP BY子句,那么HashAggregate或groupgregate节点都将被添加到规划树中。由于PostgreSQL使用基于成本的优化器生成最优规划树,几乎不可能猜测这些节点中的哪个会被使用。但是让我们来了解一下什么时候以及如何使用它。
HashAggregate
HashAggregate的工作方式是构建数据的哈希表,以便对它们进行分组。因此,如果聚合发生在未排序的数据集上,那么HashAggregate可以被组级聚合使用。
postgres=# explain select count(*) from demo1 group by id2;
                       QUERY PLAN
---------------------------------------------------------------
 HashAggregate  (cost=20.00..30.00 rows=1000 width=12)
   Group Key: id2
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=4)
(3 rows)
这里的demo1表模式数据与前一节中显示的示例相同。由于只需要对1000行进行分组,因此构建哈希表所需的资源要小于排序的成本。查询规划器决定选择HashAggregate。
GroupAggregate
GroupAggregate用于处理已经排好序的数据,因此不需要任何额外的数据结构。GroupAggregate可以被组级聚合使用,如果聚合是在排序数据集上。为了对已排序的数据进行分组,它可以显式排序(通过添加sort节点),也可以对通过索引获取的数据进行隐式排序。
postgres=# explain select count(*) from demo2 group by id2;
                            QUERY PLAN
-------------------------------------------------------------------------
 GroupAggregate  (cost=9747.82..11497.82 rows=100000 width=12)
   Group Key: id2
   ->  Sort  (cost=9747.82..9997.82 rows=100000 width=4)
      Sort Key: id2
      ->  Seq Scan on demo2  (cost=0.00..1443.00 rows=100000 width=4)
(5 rows)
这里的demo2表模式数据与前一节中显示的示例相同。因为这里要分组100000行,所以构建哈希表所需的资源可能比排序成本要高。因此,查询规划器决定选择GroupAggregate。在这里,从demo2表中选择的记录被显式排序,并且在规划树中添加了一个节点。
请参阅下面的另一个示例,在该示例中,由于使用了索引扫描,所以对已经检索到的数据进行了排序:
postgres=# create index idx1 on demo1(id);
CREATE INDEX
postgres=# explain select sum(id2), id from demo1 where id=1 group by id;
                            QUERY PLAN
------------------------------------------------------------------------
 GroupAggregate  (cost=0.28..8.31 rows=1 width=12)
   Group Key: id
   ->  Index Scan using idx1 on demo1  (cost=0.28..8.29 rows=1 width=8)
      Index Cond: (id = 1)
(4 rows)
请参见下面的另一个示例,尽管该示例使用了Index Scan,但它仍然需要显式地排序,因为索引所在的列和分组列不相同。所以它仍然需要按照分组列进行排序。
postgres=# explain select sum(id), id2 from demo1 where id=1 group by id2;
                               QUERY PLAN
------------------------------------------------------------------------------
 GroupAggregate  (cost=8.30..8.32 rows=1 width=12)
   Group Key: id2
   ->  Sort  (cost=8.30..8.31 rows=1 width=8)
      Sort Key: id2
      ->  Index Scan using idx1 on demo1  (cost=0.28..8.29 rows=1 width=8)
            Index Cond: (id = 1)
(6 rows)
注意:GroupAggregate / HashAggregate可以用于许多其它的间接查询,即使查询中不存在group by聚合。这取决于规划器如何解释查询。例如,假设我们需要从表中获取不同的值,然后可以将其视为对应列的一个组,然后分别从每个组中获取一个值。
postgres=# explain select distinct(id) from demo1;
                       QUERY PLAN
---------------------------------------------------------------
 HashAggregate  (cost=17.50..27.50 rows=1000 width=4)
   Group Key: id
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=4)
(3 rows)
所以这里使用了HashAggregate,尽管它没有聚合和分组。
Limit
如果在SELECT查询中使用了“ limit / offset”子句,则会把“Limit节点”添加到计划树中。该子句用于限制行数,并提供一个可选的偏移量以开始读取数据。示例:
postgres=# explain select * from demo1 offset 10;
                       QUERY PLAN
---------------------------------------------------------------
 Limit  (cost=0.15..15.00 rows=990 width=8)
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=8)
(2 rows)

postgres=# explain select * from demo1 limit 10;
                       QUERY PLAN
---------------------------------------------------------------
 Limit  (cost=0.00..0.15 rows=10 width=8)
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=8)
(2 rows)

postgres=# explain select * from demo1 offset 5 limit 10;
                       QUERY PLAN
---------------------------------------------------------------
 Limit  (cost=0.07..0.22 rows=10 width=8)
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=8)
(2 rows)
Unique
选择该节点是为了从基础结果中获得不同的值。请注意,根据查询自身、选择性和其他资源信息等,还可能会使用HashAggregate / GroupAggregate来检索不同的值,而无需使用“唯一节点”。示例:
postgres=# explain select distinct(id) from demo2 where id<100;
                                 QUERY PLAN
-----------------------------------------------------------------------------------
 Unique  (cost=0.29..10.27 rows=99 width=4)
   ->  Index Only Scan using demoidx2 on demo2  (cost=0.29..10.03 rows=99 width=4)
      Index Cond: (id < 100)
(3 rows)
LockRows
PostgreSQL提供了锁定所有选中行的功能。可以使用FOR SHARE和FOR UPDATE子句,分别以共享模式或独占模式选择相应行。为了实现这个操作,计划树中添加了一个新的节点LockRows。
postgres=# explain select * from demo1 for update;
                        QUERY PLAN
----------------------------------------------------------------
 LockRows  (cost=0.00..25.00 rows=1000 width=14)
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=14)
(2 rows)

postgres=# explain select * from demo1 for share;
                        QUERY PLAN
----------------------------------------------------------------
 LockRows  (cost=0.00..25.00 rows=1000 width=14)
   ->  Seq Scan on demo1  (cost=0.00..15.00 rows=1000 width=14)
(2 rows)
SetOp
PostgreSQL提供了组合两个或多个查询结果的功能。因此,当选择Join节点的类型来连接两个表时,类似类型的SetOp节点也会被使用来组合两个或多个查询的结果。例如,考虑如下所示的员工表,包括他们的id、姓名、年龄和工资:
postgres=# create table emp(id int, name char(20), age int, salary int);
CREATE TABLE
postgres=# insert into emp values(1,'a', 30,100);
INSERT 0 1
postgres=# insert into emp values(2,'b', 31,90);
INSERT 0 1
postgres=# insert into emp values(3,'c', 40,105);
INSERT 0 1
postgres=# insert into emp values(4,'d', 20,80);
INSERT 0 1
现在让我们获取年龄超过25岁的员工:
postgres=# select * from emp where age > 25;
 id |         name | age | salary
----+----------------------+-----+--------
  1 | a                |  30 |    100
  2 | b                |  31 |     90
  3 | c                |  40 |    105
(3 rows)
现在让我们获取工资超过95美元的员工:
postgres=# select * from emp where salary > 95;
 id |         name | age | salary
----+----------------------+-----+--------
  1 | a                |  30 |    100
  3 | c                |  40 |    105
(2 rows)
现在为了得到年龄在25岁以上、工资在95美元以上的员工,我们可以写下面的交叉查询获取交集:
postgres=# explain select * from emp where age>25 intersect select * from emp where salary > 95;
                                QUERY PLAN
---------------------------------------------------------------------------------
 HashSetOp Intersect  (cost=0.00..72.90 rows=185 width=40)
   ->  Append  (cost=0.00..64.44 rows=846 width=40)
      ->  Subquery Scan on "*SELECT* 1"  (cost=0.00..30.11 rows=423 width=40)
            ->  Seq Scan on emp  (cost=0.00..25.88 rows=423 width=36)
                  Filter: (age > 25)
      -> Subquery Scan on "*SELECT* 2"  (cost=0.00..30.11 rows=423 width=40)
            ->  Seq Scan on emp emp_1  (cost=0.00..25.88 rows=423 width=36)
                  Filter: (salary > 95)
(8 rows)
因此,这里添加了一种新的节点HashSetOp,以计算这两个单独查询的交集。注意,这里还添加了其他两种新节点:
Append
此节点可将多个结果集合并为一个。
Subquery Scan
此节点用以计算子查询。在上面的计划中,子查询用来计算一个额外的常量列,该列表明了是哪个输入集提供了特定的行。HashedSetop使用底层结果的哈希值工作,但是优化器也可能生成基于排序的Setop操作。基于排序的“SetOp节点”为“Setop”。
注意:可以通过单个查询获得与上述结果相同的结果,但这里使用intersect显示,只是为了简单演示。
小结
PostgreSQL的所有节点都是有用的,可以根据查询、数据等的性质进行选择。许多子句用节点进行一一映射。对于某些子句,节点可能有多个选项,这些选项是根据底层数据成本计算来决定的。
译者著:
以上种种,也即Postgres中的计划节点,下次看懂执行计划就easy了
原文链接:
https://severalnines.com/database-blog/overview-various-scan-methods-postgresql
https://severalnines.com/database-blog/overview-various-auxiliary-plan-nodes-postgresql
https://severalnines.com/database-blog/overview-join-methods-postgresql
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

