PostgreSQL流复制的方方面面
流复制简介
对于经常接触PostgreSQL的人来说,对流复制肯定再熟悉不过了。PostgreSQL支持物理复制(通常又称之为流复制)及逻辑复制两种。通过流复制技术,可以从实例级复制出一个与主库一模一样的实例级的从库,并且支持只读,这也就衍生出了读写分离、负载均衡等等方案。不同于基于文件的日志传送,因为在PostgreSQL 9.0之前的版本,如果想要做一个数据库主从,只能一个个拷贝WAL日志,所以备库至少落后一个WAL日志,
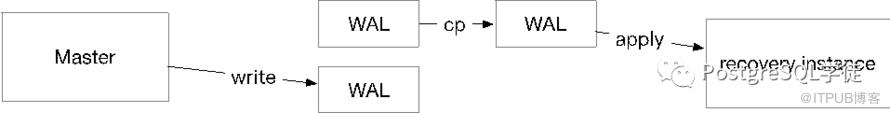
(以下来自https://www.codenong.com/cs106122610/,写的不错👍)
流复制的关键在于“流”,所谓流,就是没有界限的一串数据,类似于合理的水流,是连成一片的。因此流复制允许一台后备服务器比使用基于文件的日志传送更能保持为最新的状态。比如我们有一个大文件要从本地主机发送到远程主机,如果是按照“流”接收到的话,我们可以一边接收,一边将文本流存入文件系统。这样,等到“流”接收完了,硬盘写入操作也已经完成。
流复制历史
起源:pg9.0开始支持流式物理复制,用户可以通过流式复制,构建只读备库(主备物理复制,块级别一致)。流式物理复制可以做到极低的延迟(通常在1毫秒以内)。再也不需要繁琐的人肉copy的方式了
同步流复制:pg9.1开始支持同步复制,和MySQL中的“半同步复制”十分类似,同步流复制的出现,保证了数据的0丢失。
级联流复制:pg9.2支持级联流复制,即备库还可以再连备库,A -> B -> C,可以大幅降低主库的复制负载压力,不管是带宽还是IO等。
流式虚拟备库:pg9.2还支持虚拟备库,即就是只有WAL,没有数据文件的备库。pg_receivexlog,它以类似流式复制(streaming replication)的方式,获取主库的xlog文件。
逻辑复制:pg9.4开始可以实现逻辑复制,逻辑复制可以做到对主库的部分复制,例如表级复制,而不是整个集群的块级一致复制。
pg_rewind:pg9.5以后提供了pg_rewind,pg_rewind对于failover的场景特别有效果,不再需要麻烦的重建等步骤了。
增加多种同步级别:pg9.6版本开始可以通过synchronous_commit参数,来配置事务的同步级别。
具体详情可以参考:http://peter.eisentraut.org/blog/2015/03/03/the-history-of-replication-in-postgresql/,十分详尽
流复制特点
物理层面、逻辑层面完全一致:主备数据库的物理块完全一样,逻辑层面也完全一样,达到金融级需求。
延迟极低:不怕大事务,主库完成提交,备库能立即提交。事务过程中产生的每条record会实时同步到备库进行回放、
整个实例级别同步:物理复制针对整个实例进行同步,无法仅针对单个表或者数据库进行同步。
支持断点续传、支持只读,所以可以做到读写分离、负载均衡等等。
流复制入门
因为流复制是基于WAL日志的流式传输,WAL日志的基础得掌握牢靠。💪
WAL基础
WAL 的中心思想是先写日志,再写数据,数据文件的修改必须发生在这些修改已经记录在日志文件中之后。采用WAL日志的数据库系统在事务提交时,WAL机制可以从两个方面来提高性能:
同一个实例下各个数据库共用一个事务号系统,共用一份WAL日志,多个client写日志文件可以通过一次 fsync()来完成
日志文件是顺序写的,同步日志的开销要远比同步数据页的开销要小
当PostgreSQL进行事务提交(脏数据页需要刷新到磁盘)时,需要进行如下操作:
生成该事务提交的日志记录(唯一标示为LSN,Log sequence number)
将该LSN之前的xlog日志刷入到磁盘中
Logical sequence number是一个64位的数字,左边32位和右边32位,
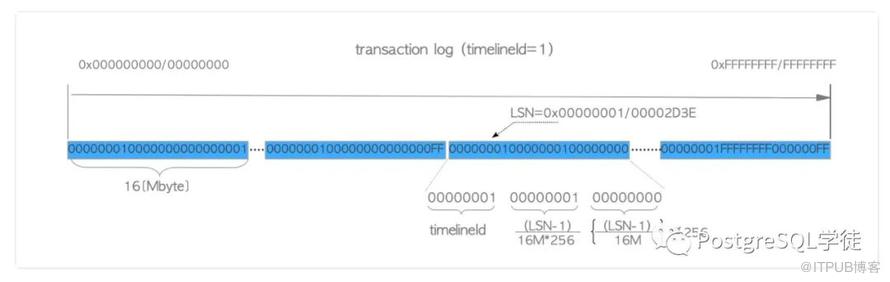
对于给定一个lsn,我们可以迅速算出对应的wal文件名,假设pg_current_wal_insert_lsn()返回0/9A80D10,如果当前timeline为1,那么logid就是"0/9A80D10"中的第一个数字,即0,logseg就是"0/9A80D10"中的第二个数字除以16m的大小,即9A80D10除以16m,而16m相当于2的24次方,相当于十六进制数"9A80D10"左移6位,即"9A80D10"中的最高两位,也就是09。那么根据wal文件的格式timeline+logid+logseg,则相当于:"00000001"+"00000000"+"00000009",即为:"000000010000000000000009" ,而写的位置的偏移量是上是"0/9A80D10"中第二个数字"9A80D10"后六位"A80D10"。
而对于WAL record,看个具体的例子,现在我进行了一条插入操作,就会产生一条wal日志,每条记录在WAL日志中都有一个唯一的编号叫LSN,可以通过LSN快速定位该日志记录在wal日志中的位置。如下:
[postgres@xiongcc log]$ psql
psql (13.2)
Type "help" for help.

postgres=# select pg_walfile_name(pg_current_wal_lsn());
     pg_walfile_name
--------------------------
 000000010000000000000015
(1 row)

postgres=# select pg_switch_wal();
 pg_switch_wal
---------------
 0/150011C8
(1 row)

postgres=# begin;
BEGIN
postgres=*# insert into t values(1,2);
INSERT 0 1
postgres=*# select pg_walfile_name('0/150011C8');
     pg_walfile_name
--------------------------
 000000010000000000000015
(1 row)

postgres=*# select pg_walfile_name(pg_current_wal_lsn());
     pg_walfile_name
--------------------------
 000000010000000000000016
(1 row)

postgres=*# \! pg_waldump /home/postgres/pgdata/pg_wal/000000010000000000000016
rmgr: Standby     len (rec/tot):     50/    50, tx:          0, lsn: 0/16000028, prev 0/150011B0, desc: RUNNING_XACTS nextXid 10966 latestCompletedXid 10965 oldestRunningXid 10966
rmgr: Heap        len (rec/tot):     68/   164, tx:      10966, lsn: 0/16000060, prev 0/16000028, desc: INSERT off 2 flags 0x08, blkref #0: rel 1663/13578/16559 blk 0 FPW
rmgr: Standby     len (rec/tot):     54/    54, tx:          0, lsn: 0/16000108, prev 0/16000060, desc: RUNNING_XACTS nextXid 10967 latestCompletedXid 10965 oldestRunningXid 10966; 1 xacts: 10966
rmgr: Standby     len (rec/tot):     54/    54, tx:          0, lsn: 0/16000140, prev 0/16000108, desc: RUNNING_XACTS nextXid 10967 latestCompletedXid 10965 oldestRunningXid 10966; 1 xacts: 10966
rmgr: XLOG        len (rec/tot):    114/   114, tx:          0, lsn: 0/16000178, prev 0/16000140, desc: CHECKPOINT_ONLINE redo 0/16000140; tli 1; prev tli 1; fpw true; xid 0:10967; oid 24808; multi 1; offset 0; oldest xid 478 in DB 1; oldest multi 1 in DB 1; oldest/newest commit timestamp xid: 0/0; oldest running xid 10966; online
rmgr: Standby     len (rec/tot):     54/    54, tx:          0, lsn: 0/160001F0, prev 0/16000178, desc: RUNNING_XACTS nextXid 10967 latestCompletedXid 10965 oldestRunningXid 10966; 1 xacts: 10966
pg_waldump: fatal: error in WAL record at 0/160001F0: invalid record length at 0/16000228: wanted 24, got 0
时间线
举个将数据库恢复到以前时间点的例子。假设在一个数据库的运行过程中,DBA在周三12:00AM删掉了一个关键的表,但是直到周五中午才发现这个问题。这个时候DBA拿出最初的数据库备份,加上存在归档目录的日志文件,将数据库恢复到周三11:00AM的时间点,这样就能正常启动和运行。但是,DBA后来意识到这样恢复是不对的,想恢复到周四8:00AM的数据,这时会发现无法做到:因为在数据库不断运行中,会产生与旧的WAL文件重名的文件,这些文件进入归档目录时,会覆盖原来的旧日志,导致恢复数据库需要的WAL文件丢失。为了避免这种情况,需要区分原始数据库历史生成的WAL文件和完成恢复之后继续运行产生的(重名的)新WAL文件。
见如下示例,若没有时间线,000000010000000000000018就重复了。
[postgres@xiongcc pg_wal]$ ls -lrt
total 131076
drwx------ 2 postgres postgres     4096 May 11 15:55 archive_status
-rw------- 1 postgres postgres 16777216 May 13 13:49 00000001000000000000001B
-rw------- 1 postgres postgres 16777216 May 13 13:49 000000010000000000000018
-rw------- 1 postgres postgres 16777216 May 13 13:49 000000010000000000000019
-rw------- 1 postgres postgres 16777216 May 13 13:49 000000010000000000000017
-rw------- 1 postgres postgres 16777216 May 13 13:49 00000001000000000000001A
-rw------- 1 postgres postgres 16777216 May 13 13:49 00000001000000000000001C
-rw------- 1 postgres postgres 16777216 May 13 13:49 00000001000000000000001D
-rw------- 1 postgres postgres 16777216 May 17 15:10 000000010000000000000016
-rw------- 1 postgres postgres 16777216 May 17 15:15 000000020000000000000018
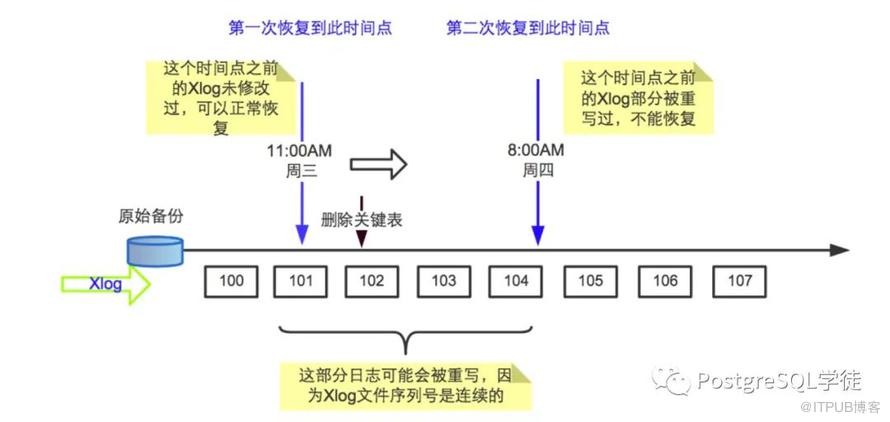
为了解决这个问题,PostgreSQL引入了时间线的概念。每当归档文件恢复完成后,创建一个新的时间线用来区别新生成的WAL记录。WAL文件名由时间线和日志序号组成。时间线ID号是WAL文件名组成之一,因此一个新的时间线不会覆盖由以前的时间线生成的WAL。如图2所示,每个时间线类似一个分支,在当前时间线的操作不会对其他时间线WAL造成影响,有了时间线,我们就可以恢复到之前的任何时间点。

来自阿里内核月报——时间线解析。更多细节可以参考:https://postgreshelp.com/postgresql-timelines/
复制角色
主库 backend 进程,它负责执行用户的 SQL,在修改数据前会先记录 WAL日志。
主库 WALsender 进程,负责把 WAL 日志发送给备库的 WALreceiver 进程。
备库 WALreceiver 进程,负责接收 WALsender 发送的 WAL日志,并持久化到存储。
备库 startup 进程,负责恢复 WALsender 写到磁盘上的 WAL日志,把数据 apply 到数据页面上。

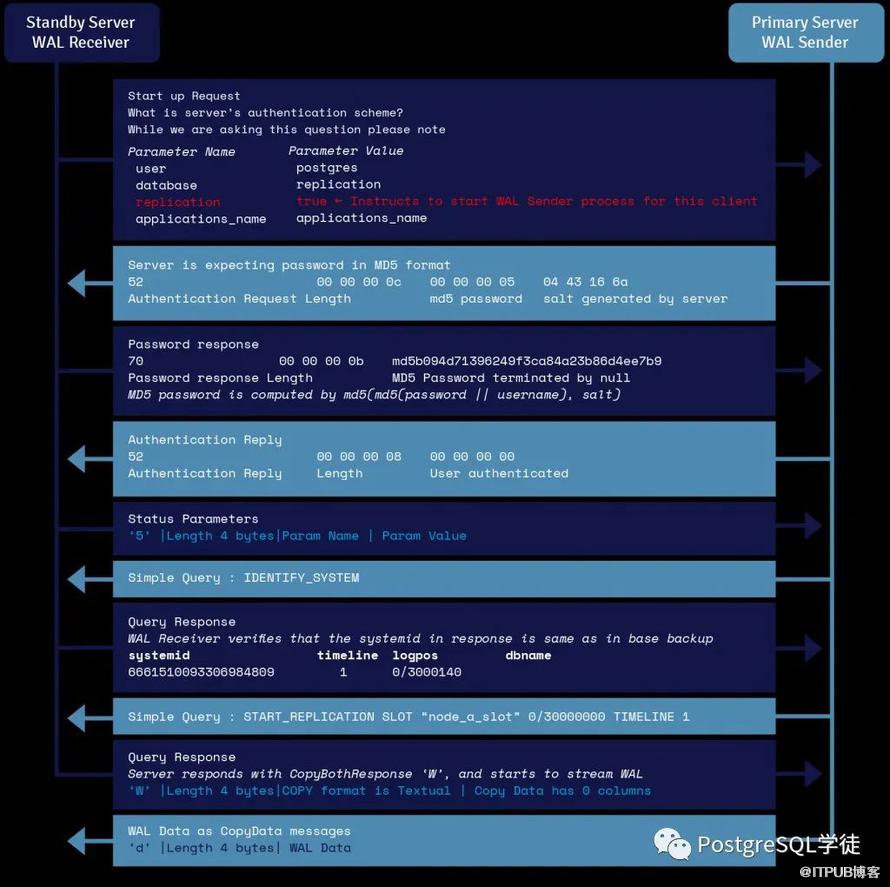
复制模式

由synchronous_commit参数控制,分为五个级别:
off:对于本机wal,不用写到磁盘,写到wal_buffers中就提交,是异步模式,存在数据丢失风险。
local:不管有没有备库只需要保证本机的wal日志刷到磁盘就行,这里已经保证了至少一份持久化的WAL日志。
remote_write:等待主库日志刷新到磁盘,同时日志传递到备库的操作系统缓存中,不需要刷盘就能提交,不能避免操作系统崩溃,因为还在page cache中,还没有真正落入到磁盘中。
on:如果没有备库,表示wal日志需要刷新到本地的磁盘中才能提交,如果存在同步备库时(synchronous_standby_name不为空),需要等待远程备库也刷新到磁盘主库才能提交,这里保证了至少两份持久化的WAL日志,这个也是默认参数。
remote_apply:高版本才出来的功能,备库刷盘并且回放成功,事务被标记为可见,可以做到主库提交从库立即可见的效果,你肯定遇到过开发问你为啥我主库都返回了备库查询不到?但是,这个参数虽然保证了严格的一致性,但是会大大降低TPS,据测试,大约30%左右的下降。
所以,这里又可以衍生一个很经典的问题,PostgreSQL的共享缓存的shared buffer真的一无是处吗?不支持Direct IO又何如?引用以下德哥的原话,PostgreSQL依赖于OS缓存来减少日志归档和流复制中的文件IO读取次数,可以看作是一个进程间通信的伪方式:
这对于XLOG来说,有好处也有坏处,如果你的文件在写入后要立即读取,那么无疑是写缓存更好。因此建议有流复制的主节点或上游节点不要使用DirectIO。同样对于standby节点来说,XLOG也是需要立即读取用来恢复的,因此standby节点也不需要开启DirectIO。
src/backend/access/transam/xlog.c
/*
 * Return the (possible) sync flag used for opening a file, depending on the
 * value of the GUC wal_sync_method.
 */
static int
get_sync_bit(int method)
{
        int                     o_direct_flag = 0;

        /* If fsync is disabled, never open in sync mode */
        if (!enableFsync)
                return 0;

        /*
         * Optimize writes by bypassing kernel cache with O_DIRECT when using
         * O_SYNC/O_FSYNC and O_DSYNC.  But only if archiving and streaming are
         * disabled, otherwise the archive command or walsender process will read
         * the WAL soon after writing it, which is guaranteed to cause a physical
         * read if we bypassed the kernel cache. We also skip the
         * posix_fadvise(POSIX_FADV_DONTNEED) call in XLogFileClose() for the same
         * reason.
         *
         * Never use O_DIRECT in walreceiver process for similar reasons; the WAL
         * written by walreceiver is normally read by the startup process soon
         * after its written. Also, walreceiver performs unaligned writes, which
         * don't work with O_DIRECT, so it is required for correctness too.
         */
        if (!XLogIsNeeded() && !AmWalReceiverProcess()) // 对于standby节点,不使用O_DIRECT
                o_direct_flag = PG_O_DIRECT;
注意事项
级联复制是异步的,异步的
只读事务和事务回滚无需等待备用服务器的答复。
子事务提交不等待备用服务器的响应,仅等待顶级提交。
所有两阶段提交操作都需要提交等待,包括准备和提交,所以在PostgreSQL里面,使用XA事务一定要小心,除了传统的占着茅坑不拉屎、膨胀等等,流复制环境下也很复杂,好在默认参数max_prepared_transactions为0,除非你知道自己在做什么
Read only transactions and transaction rollbacks need not wait for replies from standby servers. Subtransaction commits do not wait for responses from standby servers, only top-level commits. Long running actions such as data loading or index building do not wait until the very final commit message. All two-phase commit actions require commit waits, including both prepare and commit.

Cascading replication is currently asynchronous. Synchronous replication (see Section 26.2.8) settings have no effect on cascading replication at present.
其他可以参照官网注解。
流复制进阶
主从降级
在常见的PostgreSQL双节点高可用构架中,如果主库挂了且主备无延迟,高可用系统会提升老备库为新主库对外服务。而对于老主库,则可以有很多处理策略,例如:1、删掉,重搭新备库。2、降级为备库,继续服务。很显然,相比来说第一种不是个很好的方案。当数据量比较大时,重搭备库的时间成本太高,系统的可用性降低。但是因为老的主库挂掉的原因多种多样,甚至有可能是高可用系统的误判,而老主库也有可能是在挂掉之后又重新作为主库启动起来,这个时候降级并重搭流复制关系的操作就有可能失败(新的备库比新主库数据更超前)。比如异步场景下,异步从节点落后于主节点,作为主节点启动起来后,老的主节点又马上启起来,就会导致新的备库比新主库数据更超前,为了解决这种情况,PostgreSQL 引入了pg_rewind工具。
pg_rewind 工具主要实现了从源集群到目的集群的文件级别数据同步。但是和rsync的区别是,pg_rewind 不需要去读那些未变化的文件块,当数据量比较大而变化较小的时候,pg_rewind会更快。
具体步骤一句话概括,pg_rewind 通过文件的大小比较和目的集群的WAL 日志来确定哪些文件(目录)发生了变化,并使目的集群在pg_rewind 结束之后通过应用源集群的WAL 日志来完成所有的数据同步。这里需要注意的是,一定要保证目的集群从上文中两个集群的分叉点到现在的WAL日志是连续的,没有被移除,否则在找两个集群的分叉点时就会报错。
所以这是一个需要权衡的问题,和复制槽类似,pg_rewind需要你的WAL日志保留着,这取决于你想恢复到多久之前的。
具体可以参考阿里内核组文章:PgSQL · 特性分析 · 神奇的pg_rewind
流复制冲突
每当恢复进程无法在备用服务器上应用从主服务器传递过来的WAL日志时,就会发生复制冲突,因为WAL的回放会中断正在执行的查询。这些冲突不会在主服务器上的查询中发生,但会在流复制中的备用服务器上发生,因为主服务器对备用服务器上发生的事情知之甚少。
通常会将一些执行时间较长的分析任务、统计SQL跑在备库上。在备库上执行长时间的查询,由于涉及的记录有可能在主库上被更新或删除,主库上对更新或删除数据的老版本进行vacuum后,从库上也会执行这个操作,从而与从库上的当前查询产生冲突。除此之外,还有其他很多的冲突,
常见的如下:
快照复制冲突:这是最常见的复制冲突。如果VACUUM处理一个表并且删除了死元组,可能会发生快照冲突。这一删除的动作也会在备用服务器上重放。备用服务器上的查询可能已经在主服务器上的VACUUM发生之前启动(它有一个较早的快照),因此它仍然可以看到应该删除的元组。这变会构成快照冲突。
锁复制冲突:在备用服务器上,对正在执行查询的表上,获得了ACCESS EXCLUSIVE的排他锁。因此,必须在备用服务器上回放主服务器上的任何获取ACCESS EXCLUSIVE锁的操作(与ACCESS SHARE冲突),以防止发生表上不兼容的操作。PostgreSQL在诸如DROP TABLE,TRUNCATE和大多数ALTER TABLE等操作会获取与SELECT相冲突的锁,如果备用服务器在正在查询使用的表上回放这样的锁,就会发生锁冲突。
Buffer pin replication conflicts:
One way to reduce the need for VACUUM is to use HOT updates. Then any query on the primary that accesses a page with dead heap-only tuples and can get an exclusive lock on it will prune the HOT chains. PostgreSQL always holds such page locks for a short time, so there is no conflict with processing on the primary. There are other causes for page locks, but this is perhaps the most frequent one.When the standby server should replay such an exclusive page lock and a query is using the page (“has the page pinned” in PostgreSQL jargon), you get a buffer pin replication conflict. Pages can be pinned for a while, for example during a sequential scan of a table on the outer side of a nested loop join.HOT chain pruning can of course also lead to snapshot replication conflicts.
罕见的冲突如下:
死锁复制冲突:A query on the standby blocks while using the shared buffer that is needed to replay WAL from the primary. PostgreSQL will cancel such a query immediately.在备用数据库上的查询使用到了回放WAL所需的共享缓冲区。PostgreSQL将立即取消此类查询。
表空间复制冲突:表空间位于备用服务器上的temp_tablespaces中,并且查询中具有临时文件。当主数据库出现DROP TABLESPACE时,会发生冲突。在这种情况下,PostgreSQL会取消备用数据库上的所有查询。
数据库复制冲突:如果备用数据库在数据库上具有活动会话,则复制DROP DATABASE会导致冲突。在这种情况下,PostgreSQL会终止备用数据库上的的所有连接。
无法规避的冲突:VACUUM截断锁
当VACUUM完成对表的处理,并且表末尾的页面变为空时,它将尝试在表上获得一个简短的ACCESS EXCLUSIVE锁。如果成功,它将截断空白页并立即释放锁。尽管这样的锁不会扰乱主数据库上的处理,但会导致备用数据库上的复制冲突。从PostgreSQL v12开始,您可以针对单个表的禁用此功能ALTER TABLE some_table SET(vacuum_truncate = off);之前实际场景遇到过,可以参照之前的文章,具体如何调优,都是老生常谈的方法,fillfactor、HOT、分区等等:主从之间延迟过大如何优化?
/*
 * errdetail_recovery_conflict
 *
 * Add an errdetail() line showing conflict source.
 */
static int
errdetail_recovery_conflict(void)
{
    switch (RecoveryConflictReason)
    {
        case PROCSIG_RECOVERY_CONFLICT_BUFFERPIN:
            errdetail("User was holding shared buffer pin for too long.");
            break;
        case PROCSIG_RECOVERY_CONFLICT_LOCK:
            errdetail("User was holding a relation lock for too long.");
            break;
        case PROCSIG_RECOVERY_CONFLICT_TABLESPACE:
            errdetail("User was or might have been using tablespace that must be                 dropped.");
            break;
        case PROCSIG_RECOVERY_CONFLICT_SNAPSHOT:
            errdetail("User query might have needed to see row versions that must                 be removed.");
            break;
        case PROCSIG_RECOVERY_CONFLICT_STARTUP_DEADLOCK:
            errdetail("User transaction caused buffer deadlock with recovery.");
            break;
        case PROCSIG_RECOVERY_CONFLICT_DATABASE:
            errdetail("User was connected to a database that must be dropped.");
            break;
        default:
            break;
            /* no errdetail */
    }

    return 0;
}
假如真的遇到冲突或阻塞了,在备库是可以看到对应的进程,startup处于waiting的状态,如下:
postgres: startup process recovering 0000000100000000000000A6
1、原因是因为重放XLOG_HEAP2_CLEAN 类型的redo操作不允许有查询,如果有会等待,等待时间由max_standby_streaming_delay/max_standby_archive_delay控制。
2、解决这个问题可以控制slave端禁止执行查询操作,或者调整max_standby_streaming_delay/max_standby_archive_delay参数的值到可接受的范围。
3、max_standby_streaming_delay/max_standby_archive_delay参数默认值30秒。
复制槽
Replication slots provide an automated way to ensure that the master does not remove WAL segments until they have been received by all standbys, and that the master does not remove rows which could cause a recovery conflict even when the standby is disconnected.
In lieu of using replication slots, it is possible to prevent the removal of old WAL segments using wal_keep_segments, or by storing the segments in an archive using archive_command. However, these methods often result in retaining more WAL segments than required, whereas replication slots retain only the number of segments known to be needed. An advantage of these methods is that they bound the space requirement for pg_wal; there is currently no way to do this using replication slots.
Similarly, hot_standby_feedback and vacuum_defer_cleanup_age provide protection against relevant rows being removed by vacuum, but the former provides no protection during any time period when the standby is not connected, and the latter often needs to be set to a high value to provide adequate protection. Replication slots overcome these disadvantages.
Replication slots 是从postgresql 9.4引入的,主要是提供了一种自动化的方法来确保主库在所有的备库收到wal之前不会移除它们,并且主库也不会移除可能导致恢复冲突的行(需要配合hot_standby_feedback),即使备库断开也是如此。
在没有启用replication slots的环境中,如果碰到 ERROR: requested WAL segment xxxx has already been removed 的错误,解决办法是要么提前开启了归档,要么重做slave,另外还可以在主库上设置 wal_keep_segments 为更大的值。当然,如果备库停机时间太长,可能主库的WAL日志目录会被撑满,如果设置了复制槽,建议将WAL日志目录放在大容量硬盘上。复制槽虽然美好,但是有较大的风险:
如果收不到从库的reply,复制槽的状态restart lsn会保持不变,造成主库会一直保留本地日志,可能导致日志磁盘满。所以应该实时监控日志磁盘使用情况,并设置较小的wal_sender_timeout,默认为60s,及早发现从库断掉的情况。
将hot_standby_feedback设为on时,如果从库长时间有慢查询发生,可能导致发回到主库的xmin变化较慢,主库的vaccum操作停滞,造成主库被频繁更新的表大小暴增,导致严重的表膨胀。
定期监控pg_replication_slots视图
缺陷与痛点
流复制一直有个痛点就是在一主一从同步模式下,如果备库宕机,主库会卡在那里,同步模式不会自动降级,需要依靠第三方工具进行判断和监控,或者使用一主多备quorum的方式来防止备库异常对主库的影响。华为的openGauss中支持了最大可用模式,开启该参数后在主从连接正常的情况下处于同步模式,如果备机断连会立刻切为异步模式,如果备机再次启动会自动连接并切为同步模式。
这个也是PostgreSQL的一个老毛病,也是经常被Diss的地方,看看人家ADG,看看人家MySQL的rpl_semi_sync_master_timeout
openguass的这个降级切换时间非常快,切换过程甚至不会夯住,这里德哥提供了一个UDF以支持这个特性,需要借助到心跳表:PostgreSQL 如何让心跳永远不死,支持半同步自动同步、异步升降级 - udf 心跳
高可用软件
patroni,搭配vip-manager,可以实现虚拟ip的透明可用
pgpool-II
stolon
repmgr,假如要vip的话还得借助keepalived
pacemaker + corosync
PAF( PostgreSQL Automatic Failover )
pg_auto_failover
EcoX,基于zookeeper,类Raft
DRBD + LVM
复制新特性
Move recovery.conf settings into postgresql.conf
recovery.conf is no longer used, and the server will not start if that file exists.
recovery.signal and standby.signal files are now used to switch into non-primary mode.
The trigger_file setting has been renamed to promote_trigger_file.
The standby_mode setting has been removed.
从 12版本开始,不再有recovery.conf文件,recovery.conf配置的内容全部并入到postgesql.conf中。
新增了两个文件recovery.signal和standby.signal,分别代表处于recovery模式还是standby模式,如果两个文件都配置了,优先为standby模式,配置语法很简单,直接新建touch recovery.signal或者touch standby.signal即可
trigger_file参数更名为promote_trigger_file
standby_mode参数不再支持
流复制实操搭建
这里就不演示了,网上很多案例,照着做一遍就能明白了。
常见参数
-
max_standby_streaming_delay:通常会将一些执行时间较长的分析任务、统计SQL跑在备库上。在备库上执行长时间的查询,由于涉及的记录有可能在主库上被更新或删除,主库上对更新或删除数据的老版本进行vacuum后,从库上也会执行这个操作,从而与从库上的当前查询产生冲突。此参数默认为30s,当备库执行SQL时,有可能与正在应用的WAL发生冲突,此查询如果30s没有执行完就被中止,注意30s不是备库上单个查询允许的最大执行时间,是指当备库上应用WAL时允许的最大WAL延迟应用时间,因此备库上查询的执行时间有可能不到这个值就被中止了,此参数可以设置为-1,表示当从库上的WAL应用进程与从库上执行的查询冲突时,WAL应用进程一直等待直到从库查询执行完成。错误如下:
ERROR:canceling statement due to confilct with recovery
DETAIL:User query might have needed to see row versions that must be removed.
hot_standby_feedback:默认情况下从库执行查询时并不会通知主库,设置此参数为on后,从库执行查询时会通知主库,当从库执行查询过程中,主库不会清理从库需要的数据行老版本,因此,从库上的查询不会被中止,这种方法也会带来弊端,主库上的表可能会出现膨胀,主库表的膨胀程度与表上的写事务和从库上大查询的执行时间有关,默认为off。
recovery_min_apply_delay:延迟备库设置备库延迟重做WAL的时间,而备库依然及时接收主库发送的WAL日志流,只是不是一接收到WAL后就立即应用,而是等待此参数设置的值再应用。
wal_keep_segments:设置为较大值,保证pg_wal目录下保留较多的WAL日志,主库上WAL日志留存越多,允许备库宕机的时间越长,设置此参数需要注意不要将pg_wal目录撑满。或者在主库上开启归档,如果没有足够的硬盘空间保留WAL归档,至少在备库停机维护时临时开启主库归档。
old_snapshot_threshold:设置old_snapshot_threshold参数,强制删除为过老的事务快照保留的dead元组。这会导致长事务读取已被删除tuple时出错。用过oracle的人应该都见过如下的错误:snapshot too old,在oracle中,这种消息表示一个事务持续太久,因此必须被中断,这个参数表示允许一定时间后中止事务。
多主方案(题外话)

BDR
BDR[2]是多主复制解决方案,并且具有不同的版本。BDR 的早期版本是开源的,但其最新版本是封源的。该解决方案由2ndQuadrant[3]开发。BDR 提供异步多主逻辑复制。由于 BDR 应用实质上在其他节点上重播事务,因此如果所应用的事务与在接收节点上提交的事务之间存在冲突,则重播操作可能会失败。
xDB
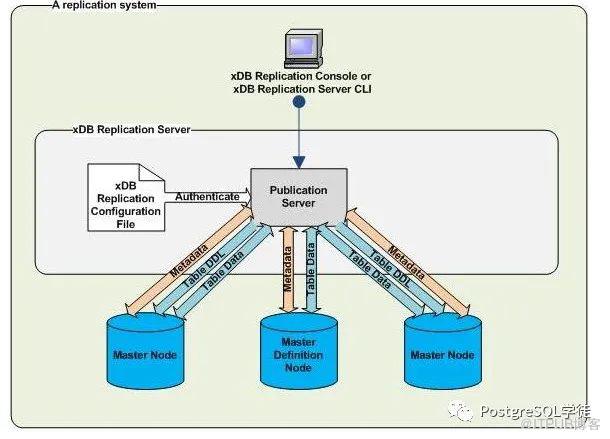
EnterpriseDB[4] 用 Java 开发了自己的双向复制解决方案xDB[5]。它基于自己的协议。因为它是一个闭源解决方案,所以暂时没有办法获得更多设计信息。
由 EnterpriseDB 开发和维护。
用 Java 开发。
xDB Replication Server 包含多个可执行程序。
这是一个完全闭源的专有软件。
Java 开发,性能受到抱怨。
故障转移时间无法接受。
用户界面可用于配置和维护复制系统
Bucardo
Bucardo[6] 是End Point Corporation[7]的 Jon Jensen 和 Greg Sabino Mullane 开发的基于触发器的复制解决方案。
基于触发器的复制
解决冲突政策
基于 Perl5,依赖 DBI,DBD::Pg,DBIx::Safe。
安装和配置很复杂。
复制经常中断并且是错误的。
PGXC
PostgreSQL-XC 由 EnterpriseDB 和 NTT 开发。它是一个同步复制解决方案。Postgres-XC 是一个开源项目,旨在提供可写扩展,同步,对称和透明的 PostgreSQL 集群解决方案。

更多细节参考:Multi-Master Replication Solutions for PostgreSQL
推荐阅读
PgSQL · 特性分析 · PG主备流复制机制
PgSQL · 内核解析 · 同步流复制实现分析
应用案例 · PG有standby的情况下为什么停库可能变慢?
PostgreSQL复制特性历史漫谈-士别三日,当刮目相看
Multi-Master Replication Solutions for PostgreSQL
PostgreSQL Replication and Automatic Failover Tutorial
PostgreSQL Timelines and History File – Master Guide
The history of replication in PostgreSQL
阅读上面的文章,可以方便我们更好的理解PostgreSQL流复制。
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

