深入浅出冻结炸弹
0x01 事务id回卷
在PostgreSQL中,由于没有像Oracle、MySQL那样的undo回滚段来实现多版本并发控制,而是当执行DML操作时在表上创建新行,并在每行中用额外的列(xmin,xmax)来记录事务号(xmin为insert或回滚时的事务号、xmax为update或delete的事务号,注意xmin还会记录回滚时的事务号),以此实现多版本并发控制,当然基于此也会导致PostgreSQL中一个比较常见的问题——表膨胀。
当前事务只能看到比表上xmin事务号小的记录,txid(事务id)的最大值为32位,即2^32为4294967296(约40亿),当数据库的事务号到达最大值后事务号就用尽了,此时需要重新使用,又从3(0、1、2为保留的事务id,后面会讲)开始。
这就会导致任何原来表上的数据的xmin均大于当前事务号,造成看不到以前的数据现象,这就违背了mvcc的原则。当然PostgreSQL数据库不会让这种情况发生,当数据库的年龄到达20亿时就要采取措施了,数据库中的表就需要清理事务号(使用vacuum freeze),以此来降低数据库表的年龄。
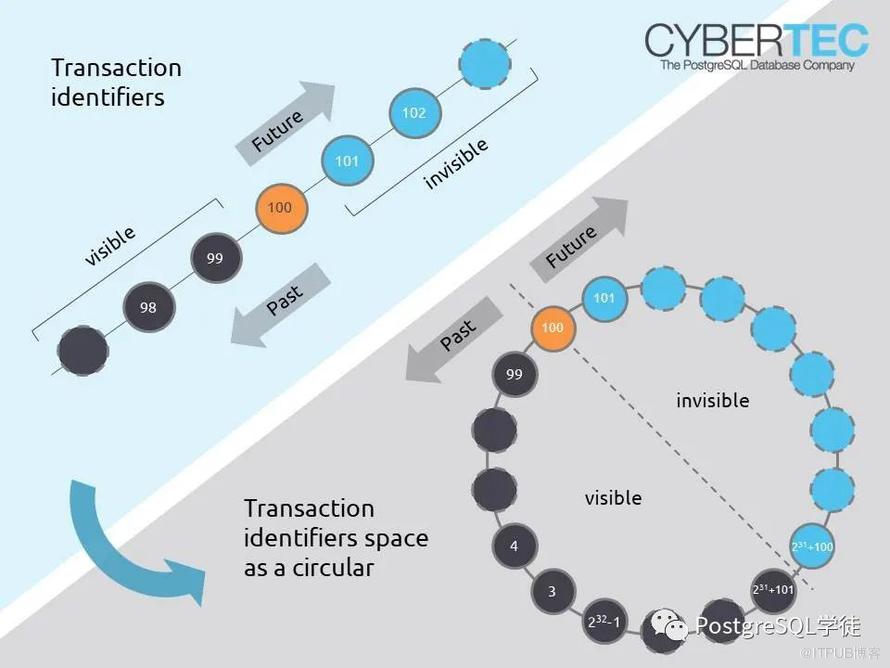
降低数据库的年龄是autovacuum进程在表的年龄到达阀值后自动进行的,也可以vacuum freeze命令手动执行。autovacuum 操作也有可能会进行部分行freeze而不是全表freeze。
0x02 事务id的分类
关于事务id的源码在src/include/access/transam.h中:
/* ----------------
 *Special transaction ID values
 *
 * BootstrapTransactionId is the XID for "bootstrap" operations, and
 * FrozenTransactionId is used for very old tuples.  Both should
 * always be considered valid.
 *
 * FirstNormalTransactionId is the first "normal" transaction id.
 * Note: if you need to change it, you must change pg_class.h as well.
 * ----------------
 */
#define InvalidTransactionId((TransactionId) 0)
#define BootstrapTransactionId((TransactionId) 1)
#define FrozenTransactionId((TransactionId) 2)
#define FirstNormalTransactionId((TransactionId) 3)
#define MaxTransactionId((TransactionId) 0xFFFFFFFF)
0 ~ 2是保留的txid,它们比任何普通txid都要旧。
0:invalidtransactionid,表示无效的事务id
1:bootstraptransactionid,表示系统表初始化时的事务id,比任何普通的事务id都旧。
2:frozentransactionid,冻结的事务id,比任何普通的事务id都旧。
大于2的事务id都是普通的事务id,即从3开始就是普通的事务id。
0x03 事务id的分配
PostgreSQL中事务号有两个概念,一个就是通常意义上的事务id,即transaction id,如tuple中的xmin,xmax等。另外一个是虚拟事务id,即virtual transaction id。我们知道,像类似于select这些只读语句,并不会改变数据库;而dml语句会对数据库状态产生影响。transaction id属于永久id。它的意义是指对数据库的更改序列,使得数据库从一种状态变成另外一种状态,而且状态的改变是持久、可恢复的,是一致性的。而查询,实际上并不需要这种永久事务id,只需要处理好mvcc,锁的获取和释放即可,因此virtual transaction id也就足够了。不需要去获取xidgenlock锁而产生transaction id,从而提高数据库性能。另外,数据库也不会因为查询而导致transaction id快速wrap around(回卷)。
关于transaction id和virtual transaction id可以从pg_locks系统表中查看到相关信息。其中virtualtransaction字段表示:持有或等待这个锁的虚拟事务ID
postgres=# \d pg_locks
                   View "pg_catalog.pg_locks"
       Column       |   Type   | Collation | Nullable | Default
--------------------+----------+-----------+----------+---------
 locktype           | text     |           |          |
 database           | oid      |           |          |
 relation           | oid      |           |          |
 page               | integer  |           |          |
 tuple              | smallint |           |          |
 virtualxid         | text     |           |          |
 transactionid      | xid      |           |          |
 classid            | oid      |           |          |
 objid              | oid      |           |          |
 objsubid           | smallint |           |          |
 virtualtransaction | text     |           |          |
 pid                | integer  |           |          |
 mode               | text     |           |          |
 granted             | boolean  |           |          |
 fastpath           | boolean  |           |          |
0x03 事务id的比较
/*
 * TransactionIdPrecedes --- is id1 logically < id2?
 */
bool
TransactionIdPrecedes(TransactionId id1, TransactionId id2)
{
    /*
     * If either ID is a permanent XID then we can just do unsigned
     * comparison.  If both are normal, do a modulo-2^32 comparison.
     */
    int32diff;

    if (!TransactionIdIsNormal(id1) || !TransactionIdIsNormal(id2))
        return (id1 < id2);

    diff = (int32) (id1 - id2);
    return (diff < 0);
}
其中,值得注意的是diff = (int32) (id1 - id2)。如果发生了XID 回卷后,即使id1=4294967290比id2=5(回卷后的XID)大,但因为相减后diff大于2^31(约等于20亿),结果值转成int32后会变成一个负数(最高位为1,表示负数),从而让判断逻辑与事务回卷前都是一样的: (int32)(id1 - id2) < 0(即返回true)。但是如果这里的id2是回卷前的XID,则这里就会出现问题。所以,PostgreSQL 就要保证一个数据库中两个有效的事务之间的年龄最多是2^31,即20亿。
也就是说:
PostgreSQL中是使用2^31取模的方法来进行事务的比较
同一个数据库中,存在的最旧和最新两个事务之间的年龄最多是2^31,即20亿
这时,我们可以把PostgreSQL 中事务ID理解为一个循环可重用的序列串。对其中的任一普通XID(特殊XID 除外)来说,都有20亿个相对它来说过去的事务,都有20亿个未来的事务,事务ID 回卷的问题得到了解决。但是可以看出这个问题得到解决的前提在同一个数据库中存在的最旧和最新两个事务之间的年龄是最多是2^31。
例如对于txid=100的事务,从101到2^31+100均为不可见事务(即n+1到n+2^31);从2^31+101到99均为可见事务(即n+2^31+1到n-1)。
特殊事务和普通事务的比较
首先利用transactionidisnormal判断当前txid是不是普通的txid(即txid>3),前面说过0-2都是保留的txid,它们比任何普通txid都要旧。
比较方法非常简单,就通过
if (!transactionidisnormal(id1) || !transactionidisnormal(id2))
    return (id1 < id2);
可以代入值实验一下:
若id1=10,id2=2,return(10<2)。明显10<2为假,所以10比2大,普通事务较新;
若id1=2,id2=10,return(2<10)。2<10为真,所以10比2大,还是普通事务较新。
普通事务之间的比较
diff = (int32) (id1 - id2);
    return (diff < 0);
由于int 32是带符号位的,需要用最高位表示符号位,所以它能表示的整数比unsigned int 32类型少一半,int 32的数据取值范围为[-2^(n-1),2^(n-1)-1],即[-2^31,2^31-1]。当两个txid相减结果>2^31时,转为int 32后其实是个负数(符号位从0变成了1,最高位是1,表示附属)。
比如id1=2^31+101,id2=100。id1-id2=2^31+1,用二进制表示即:100...(中间30个0)...001。当转为int 32后,由于第一位为符号位,而1表示负数,所以转换后这个值其实就是-1,小于0,因此txid=2^31+101的事务反而要旧。
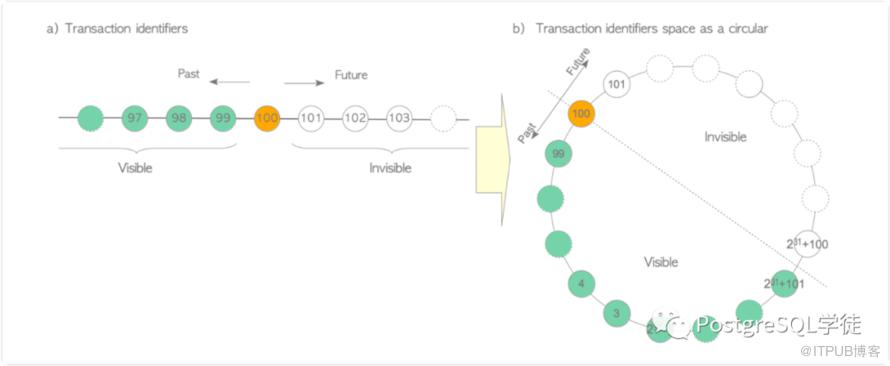
但是!
如果图中的100真的是非常非常旧的事务(而非回卷后的id),那它确实应该被2^31+101这个事务看见,此时上面的判断就是错的。
也就是说如果id2确实是回卷前的txid,上面的判断方法就会出现问题。所以为了避免这种问题,PostgreSQL必须保证一个数据库中两个有效的事务之间的年龄最多是2^31,即20亿(同一个数据库中,存在的最旧和最新两个事务txid相差不得超过2^31,而且同一个实例下的数据库获取的事务id是线性增长的,假如一个数据库实例下,有a、b两个数据库,a数据库当前事务id是n,那么b数据库获取的下一个事务id就是n+1,a数据库再获取的事务id就是n+2,以此类推,所以在写负载很大的情况下,事务ID的消耗是很快的)。
0x04 事务id冻结
为了保证同一个数据库中的最新和最旧的两个事务之间的年龄不超过2^31,PostgreSQL引入了冻结(freeze)功能。txid=2的事务在参与事务id比较时总是比所有事务都旧,冻结的txid始终处于非活跃状态,并且始终对其他事务可见。
这里涉及到三个与冻结相关的参数:
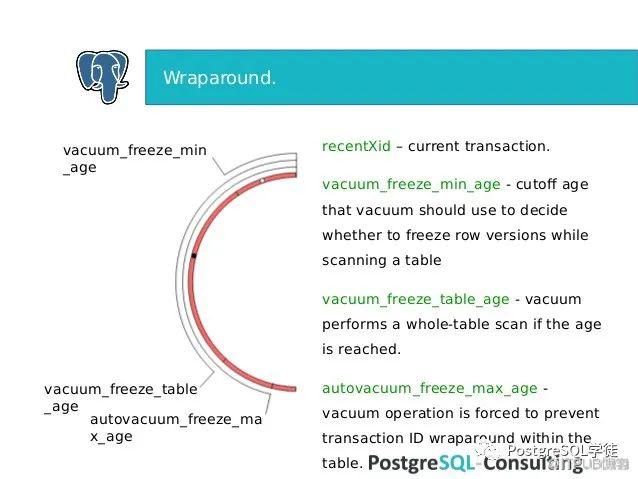
vacuum_freeze_min_age
vacuum_freeze_table_age
autovacuum_freeze_max_age
还有涉及到的术语:
表年龄:当前事务号距上一次表执行freeze操作的事务id的差值
元组年龄:当前元组的xmin距上一次执行freeze操作的事务id的差值
postgres=# create table test(id int);
CREATE TABLE
postgres=# select txid_current();
 txid_current
--------------
          512
(1 row)
postgres=# insert into test values(1);
INSERT 0 1
postgres=# insert into test values(2);
INSERT 0 1
postgres=# insert into test values(3);
INSERT 0 1
postgres=# select txid_current();
 txid_current
--------------
          516
(1 row)
postgres=# select t_xmin,t_xmax,t_infomask,t_infomask2,age(t_xmin) from heap_page_items(get_raw_page('test', 0));
 t_xmin | t_xmax | t_infomask | t_infomask2 | age
--------+--------+------------+-------------+-----
    513 |      0 |       2048 |           1 |   4
    514 |      0 |       2048 |           1 |   3
    515 |      0 |       2048 |           1 |   2
(3 rows)
postgres=# select relfrozenxid,age(relfrozenxid) from pg_class where relname = 'test';
 relfrozenxid | age
--------------+-----
          511 |   6
(1 row)
可以看到,表年龄此处为6,最开始的relfrozenxid为511(即最开始创建表的事务),现在手动执行一次冻结操作vacuum freeze:
postgres=# vacuum freeze test;
VACUUM
postgres=# select relfrozenxid,age(relfrozenxid) from pg_class where relname = 'test';
 relfrozenxid | age
--------------+-----
          517 |   0
(1 row)
postgres=# select t_xmin,t_xmax,t_infomask,t_infomask2,age(t_xmin) from heap_page_items(get_raw_page('test', 0));
 t_xmin | t_xmax | t_infomask | t_infomask2 | age
--------+--------+------------+-------------+-----
    513 |      0 |       2816 |           1 |   4
    514 |      0 |       2816 |           1 |   3
    515 |      0 |       2816 |           1 |   2
(3 rows)
可以看到,表年龄变为了0,因为执行冻结操作的事务是517,年龄降低为了0,说明此表,小于事务517的行版本都可见了。另外注意观察tuple的 t_infomask 变成了2816,因为冻结操作设置了该位为HEAP_XMIN_FROZEN (版本 > PostgreSQL9.4)。
/*
 * information stored in t_infomask:
 */
#define HEAP_HASNULL0x0001            /* has null attribute(s) */
#define HEAP_HASVARWIDTH0x0002        /* has variable-width attribute(s) */
#define HEAP_HASEXTERNAL0x0004        /* has external stored attribute(s) */
#define HEAP_HASOID_OLD0x0008         /* has an object-id field */
#define HEAP_XMAX_KEYSHR_LOCK0x0010   /* xmax is a key-shared locker */
#define HEAP_COMBOCID0x0020           /* t_cid is a combo cid */
#define HEAP_XMAX_EXCL_LOCK0x0040     /* xmax is exclusive locker */
#define HEAP_XMAX_LOCK_ONLY0x0080     /* xmax, if valid, is only a locker */

 /* xmax is a shared locker */
#define HEAP_XMAX_SHR_LOCK(HEAP_XMAX_EXCL_LOCK | HEAP_XMAX_KEYSHR_LOCK)

#define HEAP_LOCK_MASK(HEAP_XMAX_SHR_LOCK | HEAP_XMAX_EXCL_LOCK | \
 HEAP_XMAX_KEYSHR_LOCK)
#define HEAP_XMIN_COMMITTED0x0100     /* t_xmin committed */
#define HEAP_XMIN_INVALID0x0200       /* t_xmin invalid/aborted */
#define HEAP_XMIN_FROZEN(HEAP_XMIN_COMMITTED|HEAP_XMIN_INVALID)
#define HEAP_XMAX_COMMITTED0x0400     /* t_xmax committed */
#define HEAP_XMAX_INVALID0x0800       /* t_xmax invalid/aborted */
#define HEAP_XMAX_IS_MULTI0x1000      /* t_xmax is a MultiXactId */
#define HEAP_UPDATED0x2000            /* this is UPDATEd version of row */
#define HEAP_MOVED_OFF0x4000          /* moved to another place by pre-9.0
                                         * VACUUM FULL; kept for binary
                                         * upgrade support */
#define HEAP_MOVED_IN0x8000           /* moved from another place by pre-9.0
                                         * VACUUM FULL; kept for binary
                                         * upgrade support */
#define HEAP_MOVED (HEAP_MOVED_OFF | HEAP_MOVED_IN)

#define HEAP_XACT_MASK0xFFF0/* visibility-related bits */
如上,按位或的操作
#define HEAP_XMIN_FROZEN		(HEAP_XMIN_COMMITTED|HEAP_XMIN_INVALID)
#define HEAP_XMAX_COMMITTED		0x0400	    /* t_xmax committed */
#define HEAP_XMAX_INVALID		0x0800      	/* t_xmax invalid/aborted */
这里贴一个有用的函数,可以快速计算出infomask里面是些什么内容:
create type infomask_bit_desc as (mask varbit, symbol text);

create or replace function infomask(msk int, which int) returns text
language plpgsql as $$
declare
        r infomask_bit_desc;
        str text = '';
        append_bar bool = false;
begin
        for r in select * from infomask_bits(which) loop
                if (msk::bit(16) & r.mask)::int <> 0 then
                        if append_bar then
                                str = str || '|';
                        end if;
                        append_bar = true;
                        str = str || r.symbol;
                end if;
        end loop;
        return str;
end;
$$ ;

create or replace function infomask_bits(which int)
returns setof infomask_bit_desc
language plpgsql as $$
begin
        if which = 1 then
                return query values
                (x'8000'::varbit, 'MOVED_IN'),
                (x'4000', 'MOVED_OFF'),
                (x'2000', 'UPDATED'),
                (x'1000', 'XMAX_IS_MULTI'),
                (x'0800', 'XMAX_INVALID'),
                (x'0400', 'XMAX_COMMITTED'),
                (x'0200', 'XMIN_INVALID'),
                (x'0100', 'XMIN_COMMITTED'),
                (x'0080', 'XMAX_LOCK_ONLY'),
                (x'0040', 'EXCL_LOCK'),
                (x'0020', 'COMBOCID'),
                (x'0010', 'XMAX_KEYSHR_LOCK'),
                (x'0008', 'HASOID'),
                (x'0004', 'HASEXTERNAL'),
                (x'0002', 'HASVARWIDTH'),
                (x'0001', 'HASNULL');
        elsif which = 2 then
                return query values
                (x'2000'::varbit, 'UPDATE_KEY_REVOKED'),
                (x'4000', 'HOT_UPDATED'),
                (x'8000', 'HEAP_ONLY_TUPLE');
        end if;
end;
$$;
创建好之后,看以下t_infomask里面有什么玄机:
postgres=# select lp, t_xmin, t_xmax, t_ctid,
postgres-#        infomask(t_infomask, 1) as infomask,
postgres-#        infomask(t_infomask2, 2) as infomask2
postgres-# from heap_page_items(get_raw_page('test', 0));
 lp | t_xmin | t_xmax | t_ctid |                 infomask                 | infomask2
----+--------+--------+--------+------------------------------------------+-----------
  1 |  11060 |      0 | (0,1)  | XMAX_INVALID|XMIN_INVALID|XMIN_COMMITTED |
  2 |  11061 |      0 | (0,2)  | XMAX_INVALID|XMIN_INVALID|XMIN_COMMITTED |
(2 rows)
可以看到,XMIN_INVALID|XMIN_COMMITTED正式HEAP_XMIN_FROZEN,代表该行已经被冻结了。另外还设置了xmax_invalid,代表没有删除的动作,或者删除的事务无效。为什么会有这个动作呢?
#define HEAP_XMIN_FROZEN (HEAP_XMIN_COMMITTED|HEAP_XMIN_INVALID)
原来当查询一条数据的时候,需要去判断行的可见性,行是否可见,那么就需要去查询对应事务的提交状态,也就是去CLOG中查询事务的状态(当然还要根据隔离级别、事务快照来综合判断行的可见性,在此不再赘述)。在PostgreSQL中提供了TransactionIdIsInProgress、TransactionIdDidCommit和TransactionIdDidAbort用于获取事务的状态,这些函数被设计为尽可能减少对CLOG的频繁访问(假如把freeze相关参数设置为20亿的话,那么clog最多可能达到500多MB,每一个事务占2bit)。
PostgreSQL定义了四种事务状态——IN_PROGRESS, COMMITTED, ABORTED和SUB_COMMITTED,其中SUB_COMMITTED状态用于子事务,此处不讨论。
#define TRANSACTION_STATUS_IN_PROGRESS 		0x00
#define TRANSACTION_STATUS_COMMITTED 		0x01
#define TRANSACTION_STATUS_ABORTED 		0x02
#define TRANSACTION_STATUS_SUB_COMMITTED 	0x03
四种事务状态仅需两个bit即可记录。以一个块8KB为例,可以存储8KB*8/2 = 32K个事务的状态。内存中缓存CLOG的buffer大小为Min(128,Max(4,NBuffers/512))。
尽管如此,如果在检查每条元组时都执行这些函数,也可能会成为瓶颈。所以,为了解决这个问题,PostgreSQL在t_infomask中使用了相关标志位,正如之前所见:
#define HEAP_XMIN_COMMITTED		0x0100	/* t_xmin committed */
#define HEAP_XMIN_INVALID		0x0200	/* t_xmin invalid/aborted */
#define HEAP_XMIN_FROZEN		(HEAP_XMIN_COMMITTED|HEAP_XMIN_INVALID)
#define HEAP_XMAX_COMMITTED		0x0400	/* t_xmax committed */
#define HEAP_XMAX_INVALID		0x0800	/* t_xmax invalid/aborted */
在读取或写入元组时,PostgreSQL会择机将提示为设置到t_infomask中,比如上面的例子,PostgreSQL检查了元组的t_xmin对应事务的状态,结果为commited,那么就会在元组的t_infomask中置位一个HEAP_XMIN_COMMITTED,表示这条元组已经提交了,如果设置了标志位,那么就不再需要去调用TransactionIdDidCommit和TransactionIdDidAbort去获取事务的状态,可以高效地检查每个元组xmin和xmax对应的事务状态。所以,和Oracle一样,一些select操作也会产生写IO,原因就是设置标志位。别忘了,还有类似的行级锁~~
OK,这是题外话,回到冻结。当数据库最老的表年龄还剩1000万时,数据库便会发出告警,让你尽快做一个全库的vacuum操作,回收年龄:
WARNING: database "mydb" must be vacuumed within 177009986 transactions
HINT: To avoid a database shutdown, execute a database-wide VACUUM in "mydb".
根据提示,对该数据库执行vacuum freeze命令,可以解决这个潜在的问题。注意因为非超级用户没有权限更新database的datfrozenxid,只能使用超级用户执行vacuum freeze database_name。当数据库可用的txid空间还有100万时,即当前最新与最老txid差值还差100万达到20亿时,数据库就会变为只读并拒绝开启任何新的事务,同时在日志中打印如下错误信息:
ERROR:  database is not accepting commands to avoid wraparound data loss in database "mydb"
HINT:  Stop the postmaster and vacuum that database in single-user mode.
根据提示,用户可以以单用户模式启动PostgreSQL并执行vacuum freeze命令,但此时已经严重影响了业务。
而且冻结,这个操作,在PostgreSQL里面是一个很繁忙并且消耗资源的事情,俗称“冻结炸弹”

所以冻结过程应该在平时不断地自动做而不是等到事务号需要回卷的时候才去做。这时就需要引入一个参数:vacuum_freeze_min_age(默认为5000万),当冻结过程在扫描表页面元组的时候,也就是触发了vacuum后,发现元组的xmin比当前事务号current_txid - vacuum_freeze_min_age更小时,就将该元组事务id置为2,换个角度理解,也就是对于当前事务来说,如果存在某个元组的年龄超过vacuum_freeze_min_age参数值时(这里可以这么理解,假如元组的xmin < current_txid - vacuum_freeze_min_age,那么就会冻结该元组,那么换一下就是vacuum_freeze_min_age < current_txid - xmin,即元组的年龄超过vacuum_freeze_min_age),就可以在vacuum时把该元组事务号冻结。其中冻结又分为“惰性模式”和“急切模式”。惰性模式在扫描过程中仅使用vm文件,而急切模式会扫描的所有数据文件,并在可能的时候清理无用的clog文件。其中,vm文件长这样:
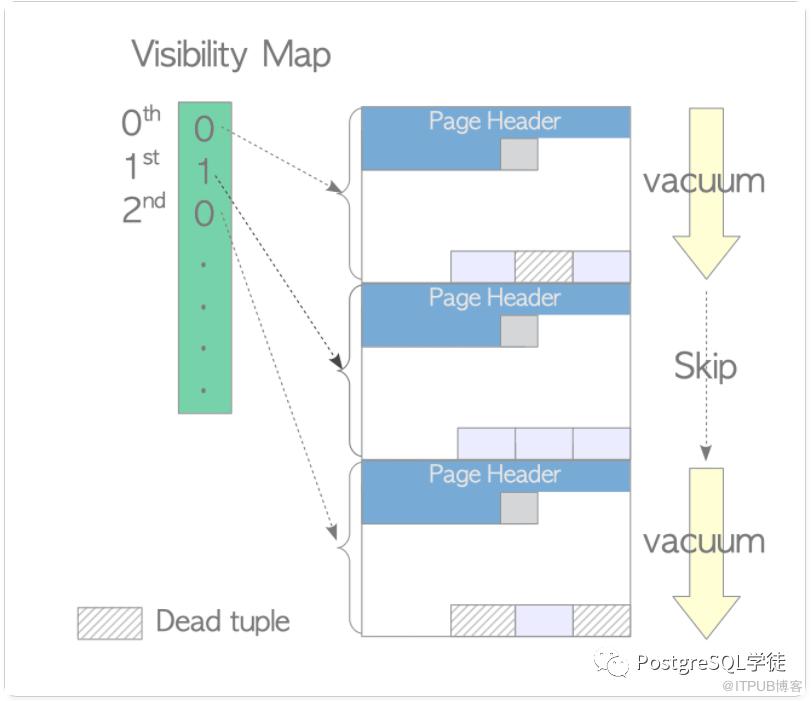
如果vm页损坏了,我们可以通过vacuum DISABLE_PAGE_SKIPPING强制扫描所有的页,然后PostgreSQL会尝试修复好VM
postgres=# \h vacuum
Command:     VACUUM
Description: garbage-collect and optionally analyze a database
Syntax:
VACUUM [ ( option [, ...] ) ] [ table_and_columns [, ...] ]
VACUUM [ FULL ] [ FREEZE ] [ VERBOSE ] [ ANALYZE ] [ table_and_columns [, ...] ]

where option can be one of:

    FULL [ boolean ]
    FREEZE [ boolean ]
    VERBOSE [ boolean ]
    ANALYZE [ boolean ]
    DISABLE_PAGE_SKIPPING [ boolean ]
    SKIP_LOCKED [ boolean ]
    INDEX_CLEANUP [ boolean ]
    TRUNCATE [ boolean ]
    PARALLEL integer
惰性模式
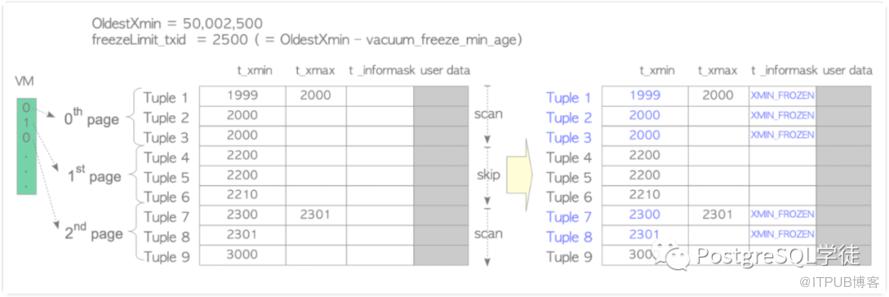
在冻结开始时,PostgreSQL会计算freezelimit_txid的值,并冻结xmin小于freezelimit_txid的元组,freezelimit_txid的计算前面也提到过,freezelimit_txid = oldestxmin-vacuum_freeze_min_age,vacuum_freeze_min_age可以理解为一个元组可以做freeze的最小间隔年龄,因为事务回卷的问题,这个值最大设置为20亿,oldestxmin代表当前活跃的所有事务中的最小的事务标识,假如有100、101和102三个事务,那么oldestxmin就是100;如果不存在其他事务,那oldestxmin就是当前执行vacuum命令的事务id。
普通vacuum进程会挨个扫描页面,同时配合vm可见性映射跳过不存在死元组的页面,将xmin小于freezelimit_txid的元组t_infomask置为xmin_frozen,清理完成之后,相关统计视图中如pg_stat_user_tables等,n_live_tuple、n_dead_tuple、vacuum_count、autovacuum_count、last_autovacuum、last_vacuum之类的统计信息会被更新。
假设当前的oldestxmin为50002500,那么freezelimit_txid就为50002500 - 5000000 = 2500,那么所有xmin小于2500的元组都会被冻结,如下图,可以看到因为vm文件的原因,跳过了第1个page,导致其中的元组没有被冻结:
注意:在9.4之前的PostgreSQL版本中,实际上会通过将一行的xmin替换为 frozentransactionid来实现冻结,这种frozentransactionid在行的 xmin系统列中是可见的。较新的版本只是设置一个标志位,保留行的原始xmin用于可能发生的鉴别用途。不过, 在9.4之前版本的数据库pg_upgrade中可能仍会找到xmin等于frozentransactionid2的行,如下:
postgres=# insert into test values(1);
INSERT 0 1
postgres=# select xmin,xmax from test;
 xmin | xmax
------+------
 1819 |    0
(1 row)
postgres=# vacuum freeze test;
VACUUM
postgres=# select xmin,xmax from test;
 xmin | xmax
------+------
    2 |    0
(1 row)
此外,系统目录可能会包含xmin等于bootstraptransactionid (1) 的行,这表示它们是在initdb的第一个阶段被插入的。和frozentransactionid相似,这个特殊的xid被认为比所有正常xid的年龄都要老。如下,可以看到很多系统表的xmin为1:
postgres=# select xmin,relname from pg_class;
 xmin  |                    relname
-------+-----------------------------------------------
     1 | pg_toast_2600
     1 | pg_toast_2600_index
     1 | pg_toast_2604
不过这种是十分消耗IO的,会产生大量的脏页。
急切模式
普通的vacuum 使用visibility map来快速定位哪些数据页需要被扫描,只会扫描那些脏页,其他的数据页即使其中元组对应的xmin非常旧也不会被扫描。而在freeze的过程中,我们是需要对所有可见且未被all-frozen的数据页进行扫描,这个扫描过程PostgreSQL称为aggressive vacuum急切冻结。每次vacuum都去扫描每个表所有符合条件的数据页显然是不现实的,所以我们要选择合理的aggressive vacuum周期。PostgreSQL引入了参数vacuum_freeze_table_age来决定这个周期,同理该参数的最大值也只能是20亿,当表的年龄大于vacuum_freeze_table_age时,会执行急切冻结,表的年龄通过oldestxmin-pg_class.relfrozenxid计算得到,pg_class.relfrozenxid字段是在某个表被冻结后更新的,代表着某个表最近的冻结事务id。而pg_database.datfrozenxid代表着当前库所有表的最小冻结标识,所以只有当该库具有最小冻结标识的表被冻结时,pg_database.datfrozenxid字段才会被更新。如下:
postgres=# \d pg_database
               Table "pg_catalog.pg_database"
    Column     |   Type    | Collation | Nullable | Default
---------------+-----------+-----------+----------+---------
 oid           | oid       |           | not null |
 datname       | name      |           | not null |
 datdba        | oid       |           | not null |
 encoding      | integer   |           | not null |
 datcollate    | name      |           | not null |
 datctype      | name      |           | not null |
 datistemplate | boolean   |           | not null |
 datallowconn  | boolean   |           | not null |
 datconnlimit  | integer   |           | not null |
 datlastsysoid | oid       |           | not null |
 datfrozenxid  | xid       |           | not null |
 datminmxid    | xid       |           | not null |
 dattablespace | oid       |           | not null |
 datacl        | aclitem[] |           |          |
Indexes:
    "pg_database_datname_index" UNIQUE, btree (datname), tablespace "pg_global"
    "pg_database_oid_index" UNIQUE, btree (oid), tablespace "pg_global"
Tablespace: "pg_global"
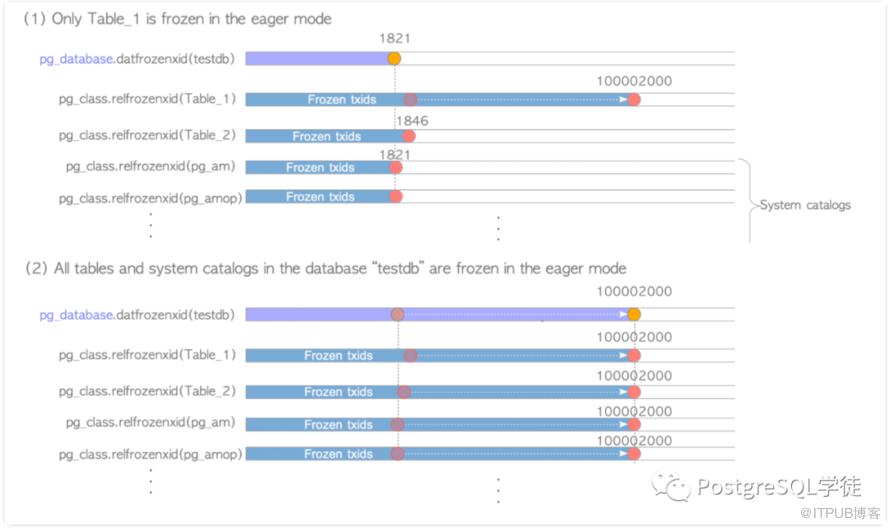
急切冻结的触发条件是pg_database.datfrozenxid < oldestxmin - vacuum_freeze_table_age,这其实和上面的说法不冲突,因为某个数据库所有表中的最老的relfrozenxid就是数据库的datfrozenxid,所以冻结可以用一句话来理解:当数据库中存在某个表的年龄大于vacuum_freeze_table_age参数设定值,就会执行急切冻结过程,当表中元组年龄超过vacuum_freeze_min_age,就可以被冻结,这里其实是必须和可以的区别。
假设oldestxmin为150002000,那么freezelimit_txid = 150002000 - 50000000 = 100002000,所有小于freezelimit_txid的元组都会被冻结,并且扫描每一个数据页面,即使某个页面已经被冻结过,如下(其中Tuple1 和Tuple7是死元组,在vacuum的过程中被移除了):

在PostgreSQL9.6之后,对freeze进行了优化,在vm文件中添加了一个标志位all_frozen。在9.6之前,假如某一个页面之前已经被冻结过,但执行急切模式的freeze依旧会扫描该页面,在9.6之后,通过判断vm文件中的all_frozen标志位,即可判断是否需要冻结该页面,如下,第一个页面的all_frozen的标志位为1,那么就可以跳过该页面,继续冻结第二个页面,冻结完之后再将vm文件的all_frozen标志位置1:

至于autovacuum_freeze_max_age的参数,是针对autovacuum的,如果当前最新的txid减去元组的t_xmin>=autovacuum_freeze_max_age,则元组对应的表会强制进行autovacuum(即使已经关闭了autovacuum),自动进行freeze。该参数最小值为2亿,最大值为20亿。
这里有疑问了,乍一看,有了vacuum_freeze_min_age和vacuum_freeze_table_age就可以解决了,为什么还需要autovacuum_freeze_max_age这个参数呢?举个例子,vacuum_freeze_min_age为2亿,vacuum_freeze_table_age为19亿,假设test表中的部分tuple的年龄达到了2亿,那么这个时候执行freeze的操作,表中部分tuple被冻结,部分没有被冻结,同时更新表的relfrozenxid为2亿。然后假设表的年龄从2亿又一直运行涨到了19亿,然后就需要去执行迫切模式的冻结,但此时某些元祖的年龄前后达到了21亿,超过了20亿的限制。这样就不能保证vacuum_freeze_table_age+vacuum_freeze_min_age<20亿,此时就需要单独弄一个参数来保证新老事务差不超过20亿,这个参数就是autovacuum_freeze_max_age。这个参数会强制限制元组的年龄(oldestxmin-xmin)如果超过该值就必须进行急切冻结操作,这个限制是个硬限制。当表的年龄大于autovacuum_freeze_max_age时(默认是2亿),autovacuum进程会自动对表进行freeze。freeze后,当更新pg_database.datfrozenxid时,PostgreSQL还可以清除掉比整个集群的最老事务号早的clog文件。因为表的最老事务号则是记录在pg_class.relfrozenxid里面的,之前的事务都已经可见了,那么就可以清理CLOG。

0x05 运维
查询所有表的年龄:select c.oid::regclass as table_name,greatest(age(c.relfrozenxid),age(t.relfrozenxid)) as age from pg_class c left join pg_class t on c.reltoastrelid = t.oid where c.relkind in ('r', 'm');
查询所有数据库的年龄:select datname, age(datfrozenxid) from pg_database;
监控工具:flexible-freeze,链接:https://github.com/pgexperts/flexible-freeze,它能够:会自动对具有最老xid的表进行vacuum freeze;确定数据库的高峰和低峰期等等
推荐德哥的一篇博文:PostgreSQL Freeze 风暴预测续 - 珍藏级SQL
0x06 最佳实践
在PostgreSQL中,vacuum是一个比较耗费io的过程,而vacuum freeze更是被称为“冻结炸弹”,因为涉及到了大量的读写io,读io(datafile)和写io(datafile以及写xlog)。对于业务繁忙的库,可能会出现如下情况:
可能有很多大表的年龄会先后到达2亿,数据库的autovacuum会开始对这些表依次进行vacuum freeze,从而集中式的爆发大量的读写io,数据库和操作系统响应迟缓,如果又碰上业务高峰,会出现很不好的影响。所以设置好参数尤为重要:
设置vacuum_cost_delay为一个比较高的数值(例如50ms),这样可以减少普通vacuum对正常数据查询的影响,vacuum_cost_limit这个值,默认是200,对于有缓存的raid卡,我们可以设为1000,假如SSD,可以把这个值设为10000
autovacuum_freeze_max_age的值应该大于vacuum_freeze_table_age的值,因为如果反过来设置,那么每次当表年龄vacuum_freeze_table_age达到时,autovacuum_freeze_max_age也达到了,那么刚刚做的freeze操作又会去扫描一遍,造成浪费。所以默认的规则,vacuum_freeze_table_age要设置的比autovacuum_freeze_max_age小,但是也不能太小,太小的话会造成频繁的aggressive vacuum。官方文档建议为95% * autovacuum_freeze_max_age。
执行急切冻结时,vacuum_freeze_table_age真正的值会去取vacuum_freeze_table_age和0.95 * autovacuum_freeze_max_age中的较小值,所以建议将vacuum_freeze_table_age设置为0.95 * autovacuum_freeze_max_age。
autovacuum_freeze_max_age和vacuum_freeze_table_age的值也不适合设置过大,因为过大会造成pg_clog中的日志文件堆积,来不及清理(执行迫切模式的冻结还会清理掉无用的clog文件)。如果设置过大,因为需要存储更多的事务提交信息,会造成pg_xact 和 pg_commit目录占用更多的空间。例如,我们把autovacuum_freeze_max_age设置为最大值20亿,pg_xact大约占500mb,pg_commit_ts大约是20gb(一个事务的提交状态占2位)。如果是对存储比较敏感的用户,也要考虑这点影响。
vacuum_freeze_min_age不易设置过小,比如我们freeze某个元组后,这个元组马上又被更新,那么之前的freeze操作其实是无用功,freeze真正应该针对的是那些长时间不被更新的元组。对于不经常更新的表,可以合理地增大autovacuum_freeze_max_age和vacuum_freeze_min_age的差值。
生产环境中做好pg_database.frozenxid的监控,当快达到触发值时,我们应该选择一个业务低峰期窗口主动执行vacuum freeze操作,而不是等待数据库被动触发。
分区,把大表分成小表。每个表的数据量取决于系统的io能力,前面说了vacuum freeze是扫全表的,现代的硬件每个表建议不超过32gb,单表数据不要超过3000w。
对大表设置不同的vacuum年龄,alter table test set (autovacuum_freeze_max_age=xxxx);
用户自己调度 freeze,如在业务低谷的时间窗口,对年龄较大,数据量较大的表进行vacuum freeze。
年龄只能降到系统存在的最早的长事务即 min (pg_stat_activity.(backend_xid, backend_xmin)),因此也需要密切关注长事务。
繁忙的库,可以适当增加autovacuum_vacuum_max_workers,5 ~ 10都是可以的。
冻结是PostgreSQL里必须维护的一件事情,也是让无数pger头疼的事。遗憾的是,无论怎么调优,都只是缓解,openGuass倒是改成了64位的,再也不用担心这个破玩意了。所以,对于写入负载高的库,空闲期间决定是否手动做一个vacuum freeze,另外冻结会受到长事务的影响,所以要密切监控长事务,包括恼人的2pc。另外需要注意的是,vacuum freeze是需要获取锁的,vacuum可能在获取不到锁的时候,跳过该页。关于autovacuum的优化历史,可以参照:https://www.enterprisedb.com/postgres-tutorials/history-improvements-vacuum-postgresql
在9.1中,autovacuum可以跳过当前获得不到表锁的表。
在9.2中,系统可以跳过获得不了清理锁的相应page,除非这个page包含一些必须要remove或者frozen的tuple。
在9.5中,减少了b-index保留最近访问的index page的情形,这样减少了VACUUM因为等待index scan而被卡主的case。
Several of the improvements since PostgreSQL 8.4 have focused on trying to prevent VACUUM from getting stuck. The basic problem, which exists in multiple variants, is that if an autovacuum process waits for some lock which doesn’t become available for a long time, then (1) the table that it is trying to VACUUM doesn’t get vacuumed by that process or any other, since only one process can vacuum a table at a time and (2) there is one fewer autovacuum worker available to run VACUUM on any other table in the system, which may mean that other tables don’t get promptly vacuumed either. Both problems can lead to bloat. PostgreSQL 9.1 improved things a bit by teaching autovacuum workers to skip tables that were due for vacuuming but on which they couldn’t immediately get a relation lock; since autovacuum retries every minute, this doesn’t hurt anything. PostgreSQL 9.2 improved things so that the system skipped individual table blocks on which it could not immediately obtain a cleanup lock, except for cases where the block contained tuples that needed to be removed or frozen and the vacuum was for the purpose of preventing transaction ID wraparound. PostgreSQL 9.5 reduced the number of cases in which btree index scans retain a pin on the last-accessed index page, which eliminates most cases of VACUUM getting stuck waiting for an index scan. As this list of improvements makes clear, the problem of index scans getting stuck has not been entirely solved, but we have steadily whittled away at the list of cases where it happens.
另外,有些插入操作,也可以直接将记录置为freeze,例如大批量的COPY数据。insert into等。
/* "options" flag bits for heap_insert */
#define HEAP_INSERT_SKIP_WAL	TABLE_INSERT_SKIP_WAL
#define HEAP_INSERT_SKIP_FSM	TABLE_INSERT_SKIP_FSM
#define HEAP_INSERT_FROZEN	TABLE_INSERT_FROZEN
#define HEAP_INSERT_NO_LOGICAL	TABLE_INSERT_NO_LOGICAL
#define HEAP_INSERT_SPECULATIVE 0x0010
0x07 参考
https://www.enterprisedb.com/postgres-tutorials/history-improvements-vacuum-postgresql
https://www.2ndquadrant.com/en/blog/when-autovacuum-does-not-vacuum/
PgSQL · 特性分析 · 事务ID回卷问题
https://www.interdb.jp/pg/pgsql06.html
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

