什么是TCP keepalive
什么是TCP keepalive
如果您听说过TCP keepalive,但不确定它是什么,请继续阅读。如果您曾经对这样的错误消息感到惊讶
•server closed the connection unexpectedly•SSL SYSCALL error: EOF detected•unexpected EOF on client connection•could not receive data from client: Connection reset by peer
那么这篇文章适合你。
连接断开的原因
连接断开有好几种原因
数据库服务崩溃
上述列表中的前两条消息可能是PostgreSQL自身服务出问题导致的结果。如果服务因任何原因崩溃,你便会看到类似的消息。要检查服务是否存在问题,你应该首先查看日志,看看是否可以找到匹配的崩溃报告。
我们不会在接下来处理这种情况,因为它不是网络问题。
连接被客户端抛弃
如果客户端没有正确关闭数据库连接而退出,服务器会在与网络套接字通信时得到一个end-of-file或一个错误。在v14中,引入的新的会话统计信息,你可以在pg_stat_database中跟踪这种被抛弃的数据库连接的数量:pg_stat_database.sessions_abandoned.
比如应用服务失败了然后重启,通常情况下它并不会关闭连接到数据库的连接。这并不值得恐慌,因为数据库会在尝试给客户端发送数据的时候检测到。但是如果数据库会话处于空闲状态,服务端进程会等待客户端下发下一条语句(你会在pg_stat_activity中看到wait_event是ClientRead)。但是服务端不会立马觉察到客户端连接已经不在了!这样的缓慢消失的连接会占用一个连接槽并且可能会导致需要增加max_connections。
在v14版本中,引入了一个新的参数 idle_session_timeout ,会在一定时间后关闭空闲连接。但是这同样也会杀掉"健康"的空闲连接,因此这并不是一个很好的解决方式。TCP keepalive针对这种问题提供了一个更好的解决方式。
由网络组件关闭的连接
有时,数据库连接的两端都会遇到相同的问题:每一端都看到另一端处于挂起的状态。在这种情况下,问题存在于数据库客户端和服务器之间的某个地方。
如果存在真正的连接问题,网络连接可能会断开。在软件层面,你无法改变这一点。但通常情况下,连接断开是由防火墙或路由器的配置方式引起的。网络组件可能必须"记住"每个打开连接的状态,而这些连接的资源是有限的。因此,"忘记"并删除闲置了较长时间的连接似乎是一种权宜之计。
因为现在很多TCP流量都是通过HTTP的,而且HTTP是无状态的,所以这通常不是问题。如果HTTP连接断开,只需为下一个请求建立一个新的连接,这开销也并不大。但是数据库是不同的:
•建立一个数据库连接是昂贵的•数据库连接不是无状态的,例如,在关闭连接的情况下,你会丢失打开的事务、临时表和预备语句•数据库会话空闲很长一段时间是正常的,例如,如果您正在使用连接池,或者客户端正在等待一个长时间运行的分析查询的结果
这就是TCP keepalive作为一种保持空闲连接打开的方法的用处所在。
什么是TCP keepalive
Keepalive是TCP协议的一种功能。当在TCP套接字上设置了SO_KEEPALIVE的选项后,套接字在空闲时会运行一个计时器。当超过了keepalive idle time,并且套接字上没有进一步的活动时,内核便会向通信对象发送一个keepalive报文。如果对象应答,则认为连接良好,计时器再次开始运行。
如果没有应答,内核会等待 keepalive interval,然后再发送另外的keepalive 报文,重复这个过程,直到发送keepalive报文的数量达到了keepalive count。在那之后,连接便被认为是死的,继续尝试使用套接字会报错。
请注意,发送keepalive消息的是操作系统内核,而不是应用程序(数据库服务器或客户端)。应用程序并不知晓这个过程。
TCP keepalive用作两个目的:
•保持网络连接不变成空闲状态•检测另一个通信端是否已经离开但却没有关闭网络连接("keepalive"这个词并没有描述准确,"detectdead"这个词更加贴切)
TCP keepalive的默认配置
keepalive相关的默认值因操作系统而异。在Linux和Windows上,默认值如下:
•keepalive idle time: 在Linux和Windows上均是2小时•keepalive interval: 在Linux上是75s,在Windows上是1s•keepalive count: 在Linux上是9,在Windows上是10(在Windows上这个值不可修改)
关于MacOS的默认值还不清楚。
确保空闲数据库会话存活
为了防止防火墙和路由器关闭空闲的连接,我们需要配置一个低得多的keepalive idle timeout值。然后在连接关闭之前发送keepalive报文。这将欺骗较为麻烦的网络组件,使其相信连接不是空闲的,即使数据库客户端和服务器都没有发送任何数据。
对于这个用例,keepalive count和keepalive interval无关紧要。我们所需要的只是让第一个keepalive报文足够早地发送出去。
检测死连接
对于这个案例,仅仅减少keepalive idle time的值通常情况下并不足够。如果服务器以75秒为间隔发送了9个keepalive报文,则需要10分钟以上才能检测到死连接。因此,我们还需要减少keepalive count或者keepalive interval,或像本例一样同时减少。
这个谜题还缺一块:即使操作系统检测到了网络连接已断开,数据库服务端并不知道,除非它尝试使用网络套接字。如果它正在等待客户端的请求,可以很快检测到连接断开。但是如果服务端正在忙于处理一个长查询,它并不会注意到死连接直到查询结束,并且尝试给客户端发送执行结果。为了防止这种问题的发生,PostgreSQL14引入了一个新的参数client_connection_check_interval,目前仅在Linux上支持。设置了此参数,服务器会定时"轮询"套接字,即使它还没有任何东西要发送。这样,它就可以检测到一个关闭的连接并中断SQL语句的执行。
在服务端设置TCP keepalive
PostgreSQL服务端总是会在TCP套接字上设置SO_KEEPALIVE来检测断开的连接,但是默认的空闲超时时间是两个小时,太长了。你可以通过设置参数
tcp_keepalives_idle, tcp_keepalives_interval 和 tcp_keepalives_count (最后一个参数在Windows上不支持)以调整所有的服务套接字。
这是为所有数据库连接配置TCP keepalive的最便捷的方法,无论使用的客户端是什么。
在客户端设置TCP keepalive
PostgreSQL客户端共享库libpq使用连接参数 keepalives_idle, keepalives_interval 和 keepalives_count (同样,后者在Windows上不支持)在客户端配置keepalive。
这些参数可以在PostgreSQL连接串中使用,用于所有连接libpq的客户端接口,例如Psycopg或PHP。
不使用libpq的PostgreSQL JDBC驱动,只有一个连接参数tcpKeepAlive来启用TCP keepalive(默认是禁用的),没有参数来配置keepalive空闲时间和其他keepalive设置。
在操作系统上设置TCP keepalive
如果你使用的是不允许设置keepalive连接参数的PostgreSQL客户端应用程序,你可以更改所有TCP连接的操作系统默认值,而不是专门为PostgreSQL连接配置keepalive。
在Linux上,可以编辑/etc/sysctl.conf
# detect dead connections after 70 seconds
net.ipv4.tcp_keepalive_time = 60
net.ipv4.tcp_keepalive_intvl = 5
net.ipv4.tcp_keepalive_probes = 3为了在不重启服务器的前提下激活配置,需要执行sysctl -p
在Windows上,您可以通过添加这些注册表项来更改TCP保持连接设置
HKEY_LOCAL_MACHINE\System\CurrentControlSet\Services\Tcpip\Parameters\KeepAliveTime
HKEY_LOCAL_MACHINE\System\CurrentControlSet\Services\Tcpip\Parameters\KeepAliveInterval如上所述,keepalive探测的数量没有设置,它被硬编码为10。注册表项必须是DWORD类型,值的单位是毫秒而不是秒。更改这些值后,重新启动Windows以激活它们。
总结
配置TCP keepalive可以提高使用PostgreSQL的体验,要么保持空闲的数据库连接打开,要么通过及时检测断开的连接。你可以在PostgreSQL客户端、服务器或操作系统上配置keepalive。
除了配置keepalive之外,还需要设置新的参数client_connection_check_interval,以便在客户端放弃会话时取消长时间运行的查询。
小结
在v14中,关于pg_stat_database新增了几个字段,对于以前的版本,假如我们要类似操作系统一样,计算数据库的负载的话,会比较棘手,平均负载可能大部分人都回答说平均负载不就是单位时间内CPU使用率吗?其实并不是这样的,我们可以man一下uptime
System load averages is the average number of processes that are either in a runnable or uninterruptable state. A process in a runnable state is either using the CPU or waiting to use the CPU. A process in uninterruptable state is waiting for some I/O access, eg waiting for disk. The averages are taken over the three time intervals. Load averages are not normalized for the number of CPUs in a system, so a load average of 1 means a single CPU system is loaded all the time while on a 4 CPU system it means it was idle 75% of the time.
系统负载平均值是处于可运行或不可中断状态的平均进程数。处于可运行状态的进程要么正在使用 CPU,要么正在等待使用 CPU。处于不可中断状态的进程正在等待某些 I/O 访问,例如等待磁盘。取三个时间间隔的平均值。平均负载没有针对系统中的 CPU 数量进行标准化,因此平均负载为 1 意味着单个 CPU 系统一直在加载,而在 4 个 CPU 系统上则意味着它有 75% 的时间处于空闲状态。
根据过往经验
•当平均负载持续大于 0.7 * CPU 逻辑核数,就需要开始调查原因,防止系统恶化;•当平均负载持续大于 1.0 * CPU 逻辑核数,必须寻找解决办法,降低平均负载;•当平均负载持续大于 5.0 * CPU 逻辑核数,表明系统已出现严重问题,长时间未响应,或者接近死机。
不幸的是在之前的版本中,很难通过数据库本身获取这一性能指标。虽然有pg_stat_activity,可以看到当前运行着的进程,但这仅仅是一个快照。在14中,新增了几个关键字段
postgres=# \d pg_stat_database
                          View "pg_catalog.pg_stat_database"
          Column          |           Type           | Collation | Nullable | Default
--------------------------+--------------------------+-----------+----------+---------
 datid                    | oid                      |           |          |
 datname                  | name                     |           |          |
 numbackends              | integer                  |           |          |
 xact_commit              | bigint                   |           |          |
 xact_rollback            | bigint                   |           |          |
 blks_read                | bigint                   |           |          |
 blks_hit                 | bigint                   |           |          |
 tup_returned             | bigint                   |           |          |
 tup_fetched              | bigint                   |           |          |
 tup_inserted             | bigint                   |           |          |
 tup_updated              | bigint                   |           |          |
 tup_deleted              | bigint                   |           |          |
 conflicts                | bigint                   |           |          |
 temp_files               | bigint                   |           |          |
 temp_bytes               | bigint                   |           |          |
 deadlocks                | bigint                   |           |          |
 checksum_failures        | bigint                   |           |          |
 checksum_last_failure    | timestamp with time zone |           |          |
 blk_read_time            | double precision         |           |          |
 blk_write_time           | double precision         |           |          |
 session_time             | double precision         |           |          |
 active_time              | double precision         |           |          |
 idle_in_transaction_time | double precision         |           |          |
 sessions                 | bigint                   |           |          |
 sessions_abandoned       | bigint                   |           |          |
 sessions_fatal           | bigint                   |           |          |
 sessions_killed          | bigint                   |           |          |
stats_reset | timestamp with time zone | | | 其中active_time、idle_in_transaction_time正是我们想要的,关于最大连接max_connections的设置其实一直是一门学问,首先我们要知道的是,PostgreSQL是进程模型,进程多了CPU会频繁忙于进程间调度,上下文切换等,那么有如下三种措施:
1.直接设得特别大,可能暂时一劳永逸。但是我们要考虑突发情况,假如业务没有控制好或者赶上了双11等流量暴涨又没有很好的熔断降级措施情况下,又或者遇到了缓存穿透等,duang的一下打了N多个连接到数据库里,这个时候可能数据库就会时刻处于高负载的状态下,CPU和IO子系统都处于高负载的状态下,操作系统崩不崩都不好说,并且你会发现CPU大多数时间都忙在了进程间调度上,整体业务全部变慢,拥堵严重2.设的不大不小,但是还是刚刚那个问题,开发人员来battle,连接又不够了!ERROR: remaining connection slots are reserved for non-replication superuser connections 为什么不能给我调大连接?但是调大连接又要重启数据库,需要一定的停机时间,对于业务的影响很大,这就陷入到了死胡同里去了3.加一个连接池,但是业务和数据库之间就增加了一跳,对于RT特别敏感的业务,就显得有点瑕疵了
所以,设置一个max_connections,是有一门学问的,可以看一下这一篇文章:TUNING MAX_CONNECTIONS IN POSTGRESQL,里面提出了一个模型,我们看一下
max_connections < max(num_cores, parallel_io_limit) /
``(session_busy_ratio * avg_parallelism)•num_cores is the number of cores available,CPU核数•parallel_io_limit is the number of concurrent I/O requests your storage subsystem can handle,存储子系统可以处理的并发 I/O 请求数•session_busy_ratio is the fraction of time that the connection is active executing a statement in the database,连接处于活动状态在数据库中执行语句的时间分数•avg_parallelism is the average number of backend processes working on a single query.,处理单个查询的后端进程的平均数量。
The first two numbers are easy to obtain, and you usually have a good idea if you will use a lot of parallel query or not. But session_busy_ratio can be tricky to estimate. If your workload consists of big analytical queries, session_busy_ratio can be up to 1, and avg_parallelism will be one more than max_parallel_workers_per_gather. If your workload consists of many short statements, session_busy_ratio can be close to 0, and avg_parallelism is 1.
现在,在14里面,observability大大提升
SELECT datname,
       active_time /
       (active_time + idle_in_transaction_time) AS session_busy_ratio
FROM pg_stat_database
WHERE active_time > 0;那我们合理调整一个max_connections也是有理可依的。并且基于这两个字段,做一个PostgreSQL Load监控项也变得容易多了。
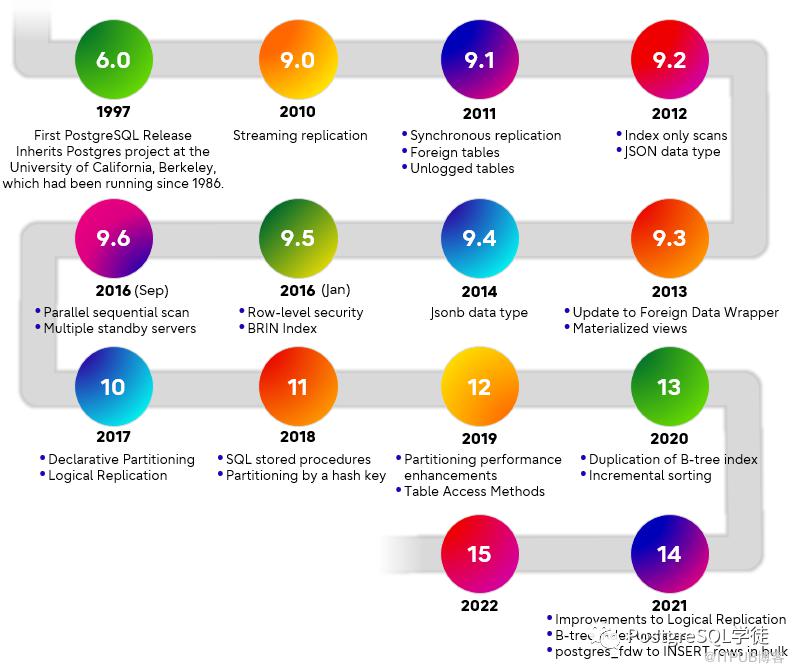
所以,升级吧?
原文译自:https://www.cybertec-postgresql.com/en/tcp-keepalive-for-a-better-postgresql-experience/
参考
https://www.cybertec-postgresql.com/en/estimating-connection-pool-size-with-postgresql-database-statistics/
https://www.cybertec-postgresql.com/en/tcp-keepalive-for-a-better-postgresql-experience/
https://www.cybertec-postgresql.com/en/tuning-max_connections-in-postgresql/
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

