Visualizing Vacuum
前言
前两天分享了一篇生产案例,是关于表膨胀的,里面提及到了vacuum,vacuum经常诟病的点就是无法合理预估还需要清理多久,对于大表可能跑三四天,而且由于使用的是ShareUpdateExclusiveLock,是自斥的,所以意味着无法并行vacuum,对于我们DBA来说,唯一能依靠的只有pg_stat_progress_vacuum视图,但是光看官网的介绍每个字段晦涩难懂,大多数时候我们只能干瞪眼数星星。
今天又翻到一篇不错的关于vacuum可视化的,可以帮助我们理解vacuum各个阶段,也就是
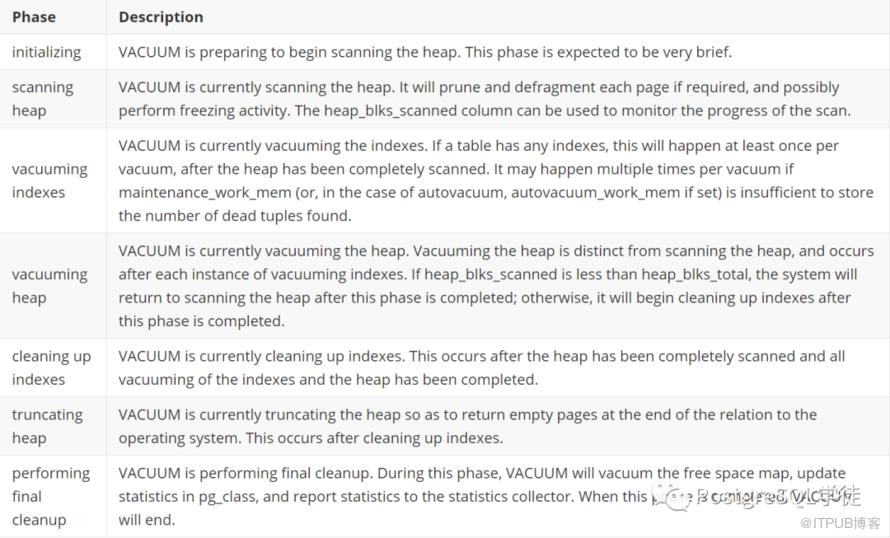
遂翻译出来,翻译的过程中也多了一些个人的理解,不失为一篇好文。
可视化vacuum进展
作为 2012 年以来 PostgreSQL 的重度用户,我们已经学到了很多关于大规模操作 PostgreSQL 的知识。我们的 Manta 对象存储系统在元数据层的核心使用了大量分片、高可用复制的 PostgreSQL 集群。当一个终端用户请求他们的对象时,比如 http://us-east.manta.joyent.com/dap/public/kartlytics/videos/2012-09-06_0000-00.mov,Manta 最终会在这个 PostgreSQL 集群中寻找该对象的元数据,以便查找托管该对象副本的存储服务器(以及大小、校验和以及其他有用的信息)。
从2012年一直到现在,我们最大的挑战之一便是管理PostgreSQL的vacuum进程。我不会在这里重述细节,因为有很多关于它的有用 信息。事实上,管理vacuum是操作PostgreSQL的一个众所周知的挑战,以至于我们正在努力从根本上改变磁盘存储系统(译者注:zheap),以消除这个潜在的问题。由于这些努力似乎还需要几年时间(特别是对于PostgreSQL的大版本升级需要时间来测试和组织),因此今天了解这个问题仍然很重要。
本文假设您对PostgreSQL已经足够熟悉,可以理解:
1.PostgreSQL数据库的基础知识:表、行、索引和基本SQL语句。2.术语,数据库"页面"(page)或者"块"(block)(我相信它们可以互换使用,来指代组成表的磁盘上表示的8KiB文件块),"堆"(heap,连续的页面,可能存储在多个文件中, 存储实际的表数据)、"元组"(tuple,行的内部表示)和"索引"(index,用于高效访问表中元组的一种磁盘的数据结构)。关于这些结构的更多信息,请参阅"Introduction to PostgreSQL physical storage"。3.在内部实现上,PostgreSQL中的更新操作类似于删除原始行再加上插入新行。由于我们在这篇文章中不关心插入,我们通常可以只考虑删除即可。4.当在PostgreSQL表中删除行时,它们不会被立即清理,因为在提供理想的ACID语义的同时这样做(其他事务可能仍然能够看到被更新或删除的行)会使系统变得更加复杂(而且可能很慢)。被删除或更新的行(元组)被称为 "死元组"(dead tuples)。关于这一点,请参阅PostgreSQL官方文档中的"Routine Vacuuming"。5.vacuum是一个长期运行的数据库操作,它扫描堆并从堆和索引中删除死的元组(即那些被之前"更新 "或"删除"操作留下的死元组)。vacuum也被用来解决其他问题,比如事务ID回卷,这无疑是我们和其他供应商的一个主要挑战,但它与这篇文章基本无关。
在我们的生产部署中,vacuum操作通常至少需要 5-10 天。由于各种原因,需要 15-20 天的情况也并不少见,我们已经看到有些需要 40 天以上。从历史上看,vacuum 一直是一个有点不透明的过程:它会运行很长时间,直到完成,此时它会记录一些信息关于之前发生了什么。幸运的是,最近版本的 PostgreSQL 包含了一个描述正在进行的清理操作进展的视图。这太棒了!文档中对解释这个视图的内容有点少,虽然你可以找到一些解释如何使用新视图的帖子,但我还是有很多问题。我们到底应该查看几组计数器中的哪一组来确定总体进度?我们关心的所有部分是否都有计数器?所有的计数器都会达到 100% 吗?我们如何知道某些阶段何时会重复,我们能做些什么呢?
这篇文章记录了我们如何对视图中的数据进行可视化以及我们对底层流程的一点认知。
可视化vacuum进度
我们开始通过在 pg_stat_progress_vacuum 视图中绘制值来组合 PostgreSQL vacuum可视化。我们使用我们创建的名为 pgstatsmon 的组件从 PostgreSQL 收集这些信息,将其存储在 Prometheus 中,并使用 Grafana 将其可视化。
首先,我们绘制了阶段:
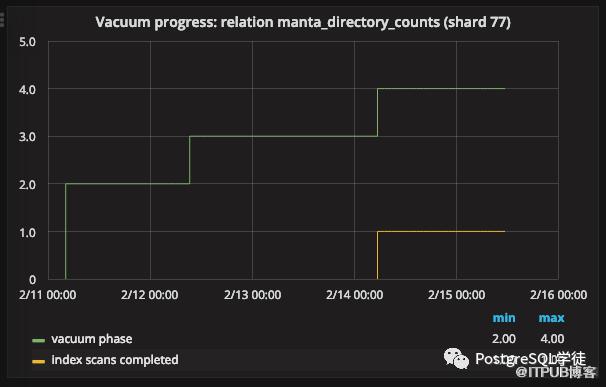
绿色的线条展示了vacuum的阶段。这个在官方文档中有所阐述,此处的关键阶段是"scanning heap"(2),"vacuuming indexes"(3),和"vacuuming heap"(4)。其他的阶段完成的很快,我们没有使用 pgstatsmon捕捉到。(请注意,这里的阶段编号可能与您看到的不同,因为 pgstatsmon 将 PostgreSQL 报告的阶段编号加了1)
我们也可以添加已经扫描(scanned)的数据块数量和已经清理(vacuumed)的数据块数量,再加上总的数据块数量 (这是一个常量)

我们可以看到,扫描的数据块数量(黄色线条)上升至总的数据块数量(蓝色线条)。然后有一段时间我们没有看到任何东西,接着我们看到被清理的数据块数量(橙色线条)上升至总的数据块数量(同样是蓝色线条)。这看起来十分有用!以前我们只知道这是一个不透明的为期4天的过程,现在我们对正在发生的事情有了更好的认识。
值得注意的是,这些线并不是线性的(特别是橙色的那条)。并且还有很长一段时间(大约占vacuum50%)我们没有观察到任何有意义的进展。
在这里,我们给阶段添加了一些信息(绿色的线条,目前在Y轴上):在"scanning heap"阶段,已扫描的数据块数量持续上升。然后我们看到了一段时间很长,不透明的"vacuuming indexes"的阶段。最后,在"vacuumimg heap"阶段,被清理的数据块数量持续上升(这听起来很明显,但请注意,堆有 "scan"和 "vacuum" 阶段,索引有 "vacuum" 和 "cleanup"阶段,所以如果你真的不知道幕后发生了什么,哪个计数器在哪个阶段增加并不明显。)
我们还创建了一个不那么繁忙的百分比视图,但基本上告诉了我们同样的事情:
这里发生了什么?为什么我们似乎要花两遍时间来处理这个堆?在两遍的间隙中发生了什么?
再深入一点:vacuum是如何运作的
要理解PostgreSQL的vacuum进度视图,你需要了解更多关于vacuum是如何运作的。我在这里的理解主要归功于 Peter Geoghegan 在 PostgresOpen 2018 上的演讲(slides,video)。此处任何错误都是我自己的理解,十分感谢更了解的人的纠正!
首先,表里面的元组由一个 ctid 所标识。ctid 自身是一个二元组(页号,行号)。(数据页指的是堆中连续的8KB页面,而不是操作系统的页)。页号是物理地址的一种,也就是说,根据页号,PostgreSQL准确知道在哪个文件里哪个偏移量处包含该页。行号是一个逻辑地址:它是页面内一个有序的数字。为了找到这个元组的信息,PostgreSQL会在页面头部中的相关信息(table-of-contents)进行查找。
对我们的讨论来说更重要的是:这个目录不仅指向存储元组数据的页面中的偏移量,而且它还包含一个标识元组是否已死的比特位。如果该位被设置,PostgreSQL 的行为就好像元组不存在一样——甚至不查看元组数据本身。
为什么这一点如此重要?因为元组不仅仅被堆引用,它同样也被索引所引用!索引是复杂的数据结构,通常允许更快速地访问特定的元组,例如,因为索引是根据元组中的某些字段排序的。索引存储的是 ctid ,而不是存储一条元组的全部内容。当某个查询通过索引访问某一行时,它首先查找索引的ctid,然后根据ctid去堆中获取元组内容。(同样的,如果在我所说的页面目录中设置了已死的比特位,PostgreSQL在访问元组时甚至在查看元组包含的实际数据之前就会看到这一点)
为了移除表中特定的某一行,vacuum不仅需要从堆中移除,也需要删除所有引用改行的索引。但是可能有很多索引,并且可能十分巨大,它们的结构也不一定能快速找到给定 ctid 的引用。PostgreSQL如何找到对元组的所有引用,就像大海捞针一样,以便它可以将其从堆中删除,而不会让引用悬挂在索引中?
PostgreSQL 使用了上述的间接方式。从逻辑上讲,从堆中删除元组的过程涉及几个步骤(注意:这并不是真正发生的事情——只是一个概念上的类比):
1.在包含该元组的页面头中标记元组已死。随即,任何试图从索引中引用该元组的行为(即通过 ctid )发现该比特位已被设置了,并将该元组视为已经消失。(这是正确的,因为vacuum已经确定这个元组真的已经死了。我们没有讨论过这个问题,但是vacuum可以知道这一点,因为它记录了它开始时运行的最老的事务ID,任何含有比这个ID更老的事务ID的元组都不能被任何运行中的事务看到)。2.对于每个索引:从头到尾扫描索引以查找对这个ctid的引用,并将它们从索引中删除。3.返回包含元组的页面并将slot标记为空闲(free,而不是仅仅是dead)。因此,现在这个 ctid 可以被重新用于新的插入,因为知道,现在已经没有对前一个 ctid 的空引用了。
总结一下:如果 PostgreSQL 只是重用给定的 ctid 而不先从索引中删除引用,那么索引中就会留下一个指向堆中谁都不知道是什么的指针。所以对于每个元组来说需要三个步骤:在堆中将其标记为死,以便现有的引用正常停止工作,从索引中删除引用,然后再实际释放堆中的槽。
PostgreSQL 不会为它要清理的每个元组从头到尾扫描所有索引。相反,当vacuum进程扫描堆并找到死元组后,它会像上面所述那样标记死元组并将其添加到它找到的死元组列表中。这个列表缓存在内存中,通常被称为 maintenance_work_mem,用于控制这个列表有多大。随后,vacuum 进程从头到尾扫描每个索引,并删除对列表中所有元组的引用。然后 PostgreSQL 回到堆并完成第 3 步,实际上释放了每个 ctid。在理想情况下,所有这些都发生一次:PostgreSQL 将整个元组列表进行批处理,并在每个索引上一次完整地处理它们。
回到可视化
这是我们阶段的图表,以及扫描的数据块
根据我们对ctids的理解,现在我们可以多说一些关于正在发生的事情:
1.在"scanning heap"的阶段(阶段2,在右边的Y轴上),PostgreSQL正在扫描堆的所有块,寻找死元组。我推断在这个阶段,PostgreSQL在页面头部中标记这些元组并将它们添加到被删除的元组列表中。2.在"vacuuming indexes"阶段(阶段3),PostgreSQL 正在扫描所有索引并从每个索引中删除元组,这些元组也在被删除的元组列表中(在上一阶段所累积的)。3.在"vacuuming heap"阶段(阶段4),PostgreSQL 返回堆中的所有块并实际释放已删除的 ctid。
太好了, 我们对vacuum期间发生的事情有一个很好的了解,并且可以可视化以实时观察它。不过上面提到的还有一些缺口,比如在"vacuuming indexes"阶段我们根本无法判断进度。但是,我们仍可以做一些事情:
1.如果我们在"scanning heap"阶段,我们至少可以估计什么时候会完成,因为进度看起来大致是线性的。我们也可以猜测"vacuumimg heap"阶段需要多长时间,因为它看起来差不多(这是有道理的,因为他们正在做类似的工作),这为总清理时间设置了一个下限,因为我们不知道"vacuuming indexes"需要多长时间。2.一旦我们到了"vacuuming heap"阶段,我们可以对vacuum完成时间做出合理的估计。
但它总是这么简单吗?
多个索引需要扫描
让我们看一个更加复杂的例子:
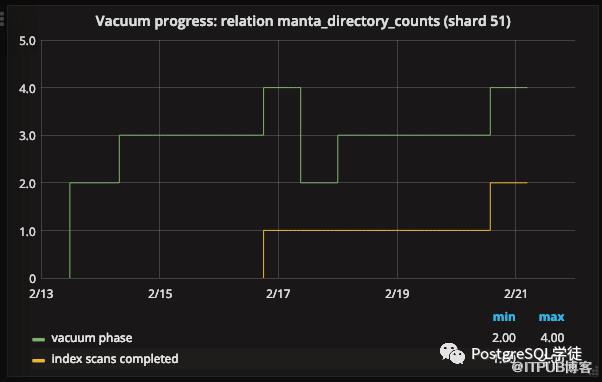
这里发生了什么?看起来像vacuum阶段向后倒退了?在vacuum阶段中所描述的那样:
vacuuming indexes…may happen multiple times per vacuum if
maintenance_work_memis insufficient to store the number of dead tuples found。
它也说在 "vacuuming heap"阶段
If
heap_blks_scannedis less thanheap_blks_total, the system will return to scanning the heap after this phase is completed; otherwise, it will begin cleaning up indexes after this phase is completed.
我发现仅从文档中很难理解这一点,但上面关于vacuum工作原理的更深入信息有助于解释发生了什么。上面我们说过,当vacuum在扫描堆时,它会累计一个需要删除的元组列表,同样也可以从索引中删除。这个列表是固定大小的数据块,由可调的maintenance_work_mem控制。当我们将这块内存缓冲区填充满了会发生什么?PostgreSQL没有太多选择。它继续完成对它已经找到的死元组的清理。这意味着扫描(并清理)所有索引,删除迄今为止发现的死元组。然后它也会从堆中清除这些元组(就像在正常的vacuum中一样)。现在,maintenance_work_mem可以被清理了,继续扫描它停下来的堆。
以下是数据块被扫描和清理的样子:
这个表格看起来有点繁忙!但是有很多有用信息:
1.绿色的线代表当前所在阶段。这个和上面的表格一样。各个阶段在右侧Y轴上有索引,主要是我们前面看到的三个阶段:2 = "scanning heap",3 = "vacuuming indexes",4 = "vacuuming heap"。2.和之前类似,在"scanning heap"阶段,已扫描的数据块持续上涨。然而,它并没有一直增加堆块的总数,而是在似乎是一半的地方停止。PostgreSQL进入到"vacuuming indexes"阶段。3.和之前一样,对"vacuuming indexes"阶段,我们不知道进展。4.一旦结束,我们会跳到"vacuuming heap"阶段(就像我们之前看到的例子一样)。在这里,被清理的数据块数量上涨到被扫描的数据块数量,然后停在了那里。
在这里,一些十分有趣的事情发生了:
1.PostgreSQL又回到了"scanning heap"阶段2."index scans"的数量增加了,我们之前没有谈论这个,因为它并不那么有趣。在前面的例子中,整个vacuum有一次index scan。这一次,我们已经在中途完成了一次index scan,但是整个vacuum需要第二次index scan3.堆扫描从之前停住的地方继续(黄色的线条展示了已经扫描的数据块,有一段时间是平的,又开始增长了。橙色的线条,展示了已经vacuum的数据块,现在变平了)4.这次,堆扫描一直持续到了结束。我们有了另一个"vacuuming indexes"阶段,接着是另一个"vacuuming heap"阶段,在这个阶段中,被清理的数据块的数量上涨到块的总数。5.当被清理的数据块数量到达了数据块的总数量,vacuum基本上结束了。
基本上,整个表的vacuum过程被分成了两部分:一部分覆盖堆的前一半,另一部分覆盖剩下的部分。
第二次扫描的原因是死元组填充满了maintenance_work_mem,在完成堆扫描之前不得不对索引进行vacuum。我们能确定吗?我们能进行可视化吗?幸运的是,pg_stat_progress_vacuum视图展示了累计的死元组的数量,以及可以存储的元组总数量。我们将其绘制出来,与阶段进行对比:
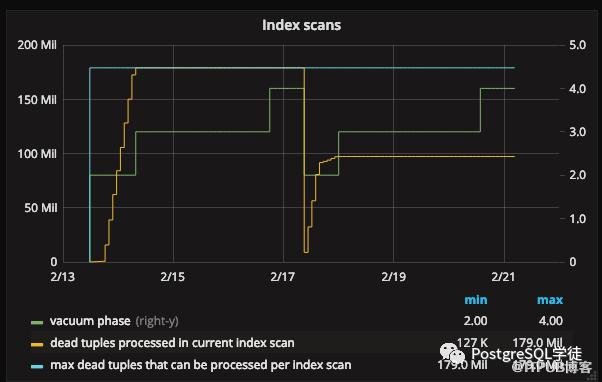
我们可以清晰地看到,死元组的数量在"scanning heap"阶段上升到最大数量。在接下来两个阶段一直是保持平稳。在清理完这些元组之后,列表被清空,PostgreSQL返回到"scanning heap"阶段。这一次,我们并没有完全填满缓冲区——死元组的数量平缓地停留在缓冲区总大小的一半左右。
从百分比的角度来看可能会更加清楚:
在这里,我们看到死元组的内存在我们扫描堆的时候被填满(从0%到100%),当扫描到大约55%的时候就填满了。我们对索引进行了一段时间的清理,然后又开始从堆中清理元组(黄线从0%增加到绿线,大约55%)。死元组内存清空(回到0%),在扫描过程中开始填充,当我们完成对堆的扫描后,内存就会变平。
这种可视化使我们能够清楚地看到在完成堆扫描之前vacuum正在耗尽维护内存,我们现在明白这会导致额外的完整索引扫描。
多少次index scan
在这个例子中,我们看到了两次索引扫描(index scans)。在扫描堆的过程中,vacuum被拆分成了两部分,大约各一半。需要明确的是,这只是一个巧合,这发生在扫描的一半左右。这是一个示例,我们几乎没有用完维护内存(即,第一轮在必须扫描索引之前扫描了大部分的堆):
具体来说,我们可以看到堆扫描第一次完成了堆扫描的 80% 以上。需要第二轮来完成扫描堆的剩余部分(不知怎的,这个案例真的强调了我们不得不进行第二次索引扫描的代价有多大。)
据我所知,有可能出现任何数量的索引扫描。我们在生产中注意到的最糟糕的情况是涉及大约5次索引扫描。很容易知道运行中的vacuum需要多少次,因为它暴露在pg_stat_progress_vacuum视图中。
这是个大问题吗?我们所看的三个vacuum都对整个堆扫描了两次(一次是扫描,一次是对每个元组进行清理)——只是在第二次和第三次vacuum中被分成了两部分。然而:这最后两次vacuum对索引文件进行了整整两次扫描,而之前的vacuum只扫描了一次。这是一个大问题! 在我们的例子中,光是索引就有几个TiB,而在第二个例子中,这个阶段几乎花了3天。要进行第二次扫描,可能会给这次vacuum增加3天的时间,几乎使花费的时间倍增。是的,这是个大问题。
将这些图表放在一起,这就是我们的 PostgreSQL vacuum dashboard的样子:
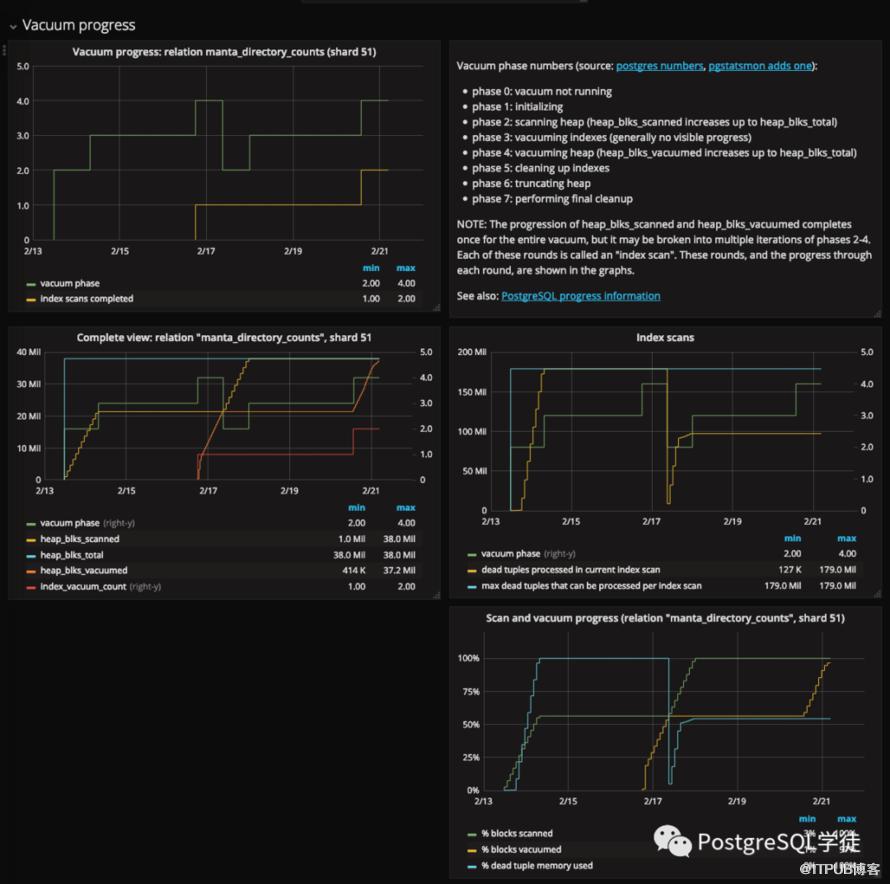
我认为这有点像X射线,因为它在某些情况下相当有用,但它需要相当深刻的理解才能解释。你得了解每一次表扫描所涉及的多个堆扫描,中间的索引扫描,以及维护内存和多次索引扫描。
有了这种理解,我们已经有足够的理论假设来解释一些主要的混淆点。例如:我们长期以来一直想知道为什么同一个分片上的一些vacuum要比其他分片长那么多?有时一个分片会经历12天,而下一个则是20天。我们现在可以猜测,第二次vacuum需要一个额外的索引扫描。如果是真的,这是非常可操作的:原则上,我们可以调整 maintenance_work_mem。调整 maintenance_work_mem 可以对vacuum的时间产生巨大的影响,而且这种影响是高度非线性的。如果你有价值520MB的死元组,而maintenance_work_mem为520 MiB,那么vacuum的时间可能接近maintenance_work_mem为512 MiB时所需时间的60%。这是一个极端的例子,但上面的第三个例子与此相差无几。(不幸的是,在我们的例子中,我们使用的数值已经超过了PostgreSQL可以使用的数值,所以这里没有容易实现的目标)。
在理解进展方面:
1.一旦堆扫描开始(基本上是马上开始),根据进展情况,我们可以估计它需要多长时间。据传闻,这与vacuum所需的时间也相当。通过加倍的估计,我们可以得到一个关于vacuum所需时间的下限。虽然很粗略,但这仍然是有帮助的。2.如果我们可以假设堆中死元组的密度在整个堆中是近似均匀的,那么我们也可以根据我们填充维护内存的速度来估计在给定的vacuum状态下需要多少次索引扫描。我们甚至可以通过观察我们在扫描堆时填充死元组内存的速度来验证这一假设。3.一旦我们完成了一轮对索引的vacuum,我们就可以对整个vacuum的完成时间做出合理的估计。当有许多后续的索引扫描时,这一点尤其有用,因为如果只有一次的话,无论如何我们在这一点上可能已经接近vacuum的终点了。
不过,这仍然感觉很粗糙。我们有非常多的开放性问题,首先是。
1.我们如何将其应用于一个有几百个分配的系统?我们不能依靠纯人工的对图形的解释。2.是否有可能在 "vacuuming index "阶段获取进展信息?这仍然是一个相当长的、不透明的阶段。3.我们能否得到在vacuum期间冻结的元组数量的信息?整个表中被冻结(或未冻结)的元组数量是多少?(这会帮助我们了解我们是否应该调整系统,使其在正常的vacuum期间更积极地冻结,或者这是否会导致vacuum时间过长)。4.对于每个被更新的数据块,是由于元组被冻结,一些元组死亡,还是其他原因?(这将有助于我们理解为什么有些vacuum需要比其他vacuum更多的扫描)。
最后说明
信不信由你,这是对 PostgreSQL 中发生的事情的非常简化的解释。Peter 的演讲(在下方)阐述了更多细节,包括机会性垃圾收集、HOT、在堆扫描过程中实际上释放了大部分空间的事实等等。其他机制比如hint bits、free space map、visibility map会影响所有这些。
以上是我从官方文档、各种会谈和源文件中整理出来的信息。我已经尽可能地引用来源,但在某些情况下,我的推论可能会有偏差。如果有对任何不正确或不明确的地方的反馈,我将不胜感激。
pg_stat_progress_vacuum视图对我们来说是一个巨大的进步。非常感谢PostgreSQL社区。PostgreSQL在短短几年内帮助我们将Manta的规模扩大了几个数量级。文档是相当广泛的。感谢那些帮助别人理解这些实现细节的社区成员,这些细节在大规模操作PostgreSQL时发挥了巨大的作用。特别感谢Peter Geoghegan在2018年SF的PostgresOpen上的演讲,他帮助我们把这些可视化图表放在一起。
在过去的几年里,vacuum的问题对我们来说是多么重要,这一点很难表达。说白了,这在很大程度上是由于我们自己在数据库配置、系统配置和应用程序行为方面的错误做法。(PostgreSQL的默认值也没有帮助——当20%的堆元组死亡时进行vacuum处理的默认行为意味着线性增长的表上的vacuum间隔越来越远,时间越来越长)。然而,我们的一些错误是相当难以纠正的,因为它们涉及到在数百个集群上进行耗时的、导致停机的模式迁移。多年来,Joyent的很多人都在努力工作,以更好地理解和提高PostgreSQL在Joyent的性能——太多人的名字了!
扩展阅读:
1.Rachid Belaid的 "Introduction to PostgreSQL physical storage"。这篇文章涵盖了PostgreSQL的相关内部结构,比我上面做的要详细得多,有更多的图表,而且不需要假设已经有太多的PostgreSQL内部知识。2."Bloat in PostgreSQL: A Taxonomy"。Peter Geoghegan。PostgresOpen 2018(幻灯片,视频)。这个演讲启发并告知了大部分的工作。3."Routine Vacuuming "来自PostgreSQL官方文档。这一节值得读几遍。4."Database Page Layout" 来自PostgreSQL官方文档。5."All the Dirt on Vacuum"。Jam Nasby。这个链接是这个关于vacuum的讲座。你可以在其他地方找到以前版本的视频。
原文译自 https://www.davepacheco.net/blog/2019/visualizing-postgresql-vacuum-progress/
小结
这篇文章可以帮助我们更好理解vacuum的内部工作原理,结论大体上和我之前写的《生产案例 怪异的表膨胀》相同,可以翻一下。
之前的SQL忘记贴了,这里补一下
SELECT
    p.pid,
    now() - a.xact_start AS duration,
    coalesce(wait_event_type || '.' || wait_event, 'f') AS waiting,
    CASE WHEN a.query ~* '^autovacuum.*to prevent wraparound' THEN
        'wraparound'
    WHEN a.query ~* '^vacuum' THEN
        'user'
    ELSE
        'regular'
    END AS mode,
    p.datname AS database,
    p.relid::regclass AS table,
    p.phase,
    pg_size_pretty(p.heap_blks_total * current_setting('block_size')::int) AS table_size,
    pg_size_pretty(pg_total_relation_size(relid)) AS total_size,
    pg_size_pretty(p.heap_blks_scanned * current_setting('block_size')::int) AS scanned,
    pg_size_pretty(p.heap_blks_vacuumed * current_setting('block_size')::int) AS vacuumed,
    round(100.0 * p.heap_blks_scanned / p.heap_blks_total, 1) AS scanned_pct,
    round(100.0 * p.heap_blks_vacuumed / p.heap_blks_total, 1) AS vacuumed_pct,
    p.index_vacuum_count,
    round(100.0 * p.num_dead_tuples / p.max_dead_tuples, 1) AS dead_pct
FROM
    pg_stat_progress_vacuum p
    JOIN pg_stat_activity a USING (pid)
ORDER BY
    now() - a.xact_start DESC;

Tue 01 Mar 2022 07:10:50 PM CST (every 3s)

-[ RECORD 1 ]------+----------------
pid                | 21270
duration           | 00:00:00.327657
waiting            | IO.DataFileRead
mode               | user
database           | postgres
table              | test_big2
phase              | scanning heap
table_size         | 2872 MB
total_size         | 3944 MB
scanned            | 44 MB
vacuumed           | 0 bytes
scanned_pct        | 1.5
vacuumed_pct       | 0.0
index_vacuum_count | 0
dead_pct           | 0.0

Tue 01 Mar 2022 07:10:53 PM CST (every 3s)

-[ RECORD 1 ]------+----------------
pid                | 21270
duration           | 00:00:03.4984
waiting            | IO.DataFileRead
mode               | user
database           | postgres
table              | test_big2
phase              | scanning heap
table_size         | 2872 MB
total_size         | 3944 MB
scanned            | 312 MB
vacuumed           | 0 bytes
scanned_pct        | 10.9
vacuumed_pct       | 0.0
index_vacuum_count | 0
dead_pct           | 0.0
关键就是maintenance_work_mem,用于控制vacuum进程分配的内存,存储那些无效索引元组的TID。vacuum进程扫描表并收集所有无效元组的TID。然后扫描索引,删除这些TID对应的所有索引项。如果它在扫描完整个表之前耗尽了存放无效元组TID所用的内存,那么它将停止表扫描,转而扫描索引,以丢弃堆积的TID列表,之后从它中断的位置继续扫描表。如果此后还遇到这样的情形,它将再次停止以扫描所有索引。对于一个大表,多次扫描索引的代价是非常昂贵的,特别是在表中有很多索引的情况下。如果maintenance_work_mem设置太低,可能需要多次索引扫描。而"vacuuming index"这个阶段又是黑盒,无法预估执行时间,对于大表,以及包括很多索引的系统,这个值合理调大是十分有必要的!
另外还有一个index clean up的阶段,这个阶段执行的很快。
翻了下源码,可以看到,大致上就是一些元信息,比如索引里面包括了多少个可以reuse的页面,被vacuum清理了多少页面。
/* ----------------
 *        index_vacuum_cleanup - do post-deletion cleanup of an index
 *
 *        return value is an optional palloc'd struct of statistics
 * ----------------
 */
IndexBulkDeleteResult *
index_vacuum_cleanup(IndexVacuumInfo *info,
                     IndexBulkDeleteResult *istat)
{
    Relation    indexRelation = info->index;

    RELATION_CHECKS;
    CHECK_REL_PROCEDURE(amvacuumcleanup);

    return indexRelation->rd_indam->amvacuumcleanup(info, istat);
}


typedef struct IndexBulkDeleteResult
{
    //index中剩下的pages
    BlockNumber num_pages;      /* pages remaining in index */
    //在vacuum期间清除的元组数
    BlockNumber pages_removed;  /* # removed during vacuum operation */
    //num_index_tuples是一个估算值
    bool        estimated_count;    /* num_index_tuples is an estimate */
    //剩余的元组数
    double      num_index_tuples;   /* tuples remaining */
    //在vacuum期间清除的元组数
    double      tuples_removed; /* # removed during vacuum operation */
    //索引中未使用的pages
    BlockNumber pages_deleted;  /* # unused pages in index */
    //可重用的pages
    BlockNumber pages_free;     /* # pages available for reuse */
} IndexBulkDeleteResult;


/* post-VACUUM cleanup */
typedef IndexBulkDeleteResult *(*amvacuumcleanup_function) (IndexVacuumInfo *info,
                                                            IndexBulkDeleteResult *stats);
IndexAmRoutine是PostgreSQL提供的索引API,支持非常丰富索引操作的接口,例如索引build和单个索引insert,以及标记和删除,还有查询初始化、返回以及查询相关的接口。
/*
 * API struct for an index AM.  Note this must be stored in a single palloc'd
 * chunk of memory.
 */
typedef struct IndexAmRoutine
{
    NodeTag        type;

    /*
     * Total number of strategies (operators) by which we can traverse/search
     * this AM.  Zero if AM does not have a fixed set of strategy assignments.
     */
    uint16        amstrategies;
    /* total number of support functions that this AM uses */
    uint16        amsupport;
    /* opclass options support function number or 0 */
    uint16        amoptsprocnum;
    /* does AM support ORDER BY indexed column's value? */
    bool        amcanorder;
    /* does AM support ORDER BY result of an operator on indexed column? */
    bool        amcanorderbyop;
    /* does AM support backward scanning? */
    bool        amcanbackward;
    /* does AM support UNIQUE indexes? */
    bool        amcanunique;
    /* does AM support multi-column indexes? */
    bool        amcanmulticol;
    /* does AM require scans to have a constraint on the first index column? */
    bool        amoptionalkey;
    /* does AM handle ScalarArrayOpExpr quals? */
    bool        amsearcharray;
    /* does AM handle IS NULL/IS NOT NULL quals? */
    bool        amsearchnulls;
    /* can index storage data type differ from column data type? */
    bool        amstorage;
    /* can an index of this type be clustered on? */
    bool        amclusterable;
    /* does AM handle predicate locks? */
    bool        ampredlocks;
    /* does AM support parallel scan? */
    bool        amcanparallel;
    /* does AM support columns included with clause INCLUDE? */
    bool        amcaninclude;
    /* does AM use maintenance_work_mem? */
    bool        amusemaintenanceworkmem;
    /* OR of parallel vacuum flags.  See vacuum.h for flags. */
    uint8        amparallelvacuumoptions;
    /* type of data stored in index, or InvalidOid if variable */
    Oid            amkeytype;

    /*
     * If you add new properties to either the above or the below lists, then
     * they should also (usually) be exposed via the property API (see
     * IndexAMProperty at the top of the file, and utils/adt/amutils.c).
     */

    /* interface functions */
    ambuild_function ambuild;
    ambuildempty_function ambuildempty;
    aminsert_function aminsert;
    ambulkdelete_function ambulkdelete;
    amvacuumcleanup_function amvacuumcleanup;
    amcanreturn_function amcanreturn;    /* can be NULL */
    amcostestimate_function amcostestimate;
    amoptions_function amoptions;
    amproperty_function amproperty; /* can be NULL */
    ambuildphasename_function ambuildphasename; /* can be NULL */
    amvalidate_function amvalidate;
    amadjustmembers_function amadjustmembers;    /* can be NULL */
    ambeginscan_function ambeginscan;
    amrescan_function amrescan;
    amgettuple_function amgettuple; /* can be NULL */
    amgetbitmap_function amgetbitmap;    /* can be NULL */
    amendscan_function amendscan;
    ammarkpos_function ammarkpos;    /* can be NULL */
    amrestrpos_function amrestrpos; /* can be NULL */

    /* interface functions to support parallel index scans */
    amestimateparallelscan_function amestimateparallelscan; /* can be NULL */
    aminitparallelscan_function aminitparallelscan; /* can be NULL */
    amparallelrescan_function amparallelrescan; /* can be NULL */
} IndexAmRoutine;
总之,还是希望官方能对"vacuuming indexes"这个阶段提供更多信息。
原文作者:PostgreSQL学徒;如有侵权,请联系管理员删除。

