先给结论:从公开产品形态、生态规模和市场地位看,国内较少见到与 Databricks完全对等的厂商。但“把数据与AI放进同一套底座”这件事,国内已经按四条技术路线在做——向量数据库、传统关系型数据库、组合式HTAP,以及内核级AI原生。路线不同,解决的问题也不同,放在一起比谁更强意义不大,按自己的场景对号入座才有意义。
一、国际三家:都在做加法,只是加在不同的层
Databricks的核心AI产品Lakebase,是一款专为AI应用与智能体设计的操作型数据库。它的路线是把OLTP带进湖仓,构建HTAP+AI的统一平台,核心产品组合是Lakebase加Agent Bricks,目标是消解ETL延迟,让AI直接操作实时数据。
Snowflake走的是另一条路。Cortex AISQL把AI能力封装成SQL原生函数,例如AI_FILTER、AI_AGG,用户沿用原有SQL语法即可调用;它不改变SQL引擎的内核范式,属于“外挂函数”式的扩展。
SAP的Datasphere依靠数据编织,为SAP及非SAP系统提供集成的数据治理与统一业务语义层,强依赖SAP生态,语义内嵌、开放性有限。
三家的共同前提是同一个判断: AI要真正进入业务,必须理解企业的业务数据。区别只在“在哪里加”——Databricks加在实时数据层,Snowflake加在SQL函数层,SAP加在业务语义层。
二、国内四个阵营,各自解决一段问题
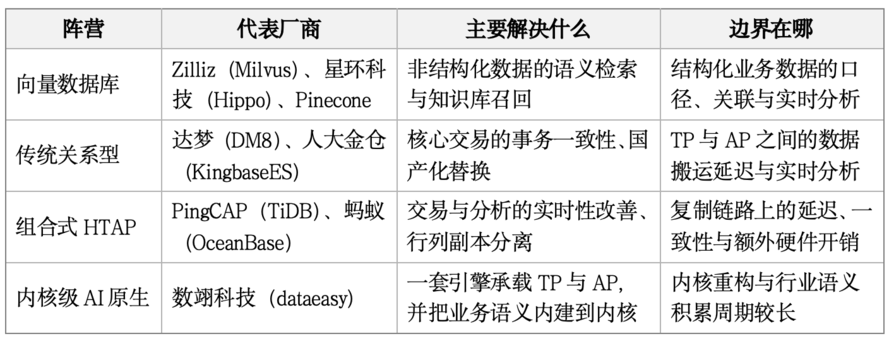
向量数据库阵营的代表厂商是 Zilliz(Milvus)、星环科技(Transwarp Hippo),国际上还有Pinecone。这一阵营以向量数据库切入AI数据场景,主要做非结构化数据的向量相似度检索,把文档、图片这类内容变成可检索的向量。它解决的是“找得到”,对应企业AI建设里的知识库、文档问答需求;结构化业务数据的语义理解,并不在它的主要射程内。
传统关系型数据库阵营的代表厂商是达梦( DM8)、人大金仓(KingbaseES)。技术路线是TP与AP分离:交易系统产生数据后,要经过抽取、转换、加载,清洗搬运之后才能进入分析系统。这条路线的优势在于事务处理的成熟与稳定,适合核心业务系统与国产化替换;代价是数据搬运带来的延迟,以及搬迁过程中的一致性与安全成本。
组合式 HTAP阵营的代表厂商是PingCAP(TiDB)、蚂蚁(OceanBase)。它们在同一个产品体系内由TP引擎与AP引擎分工,采用行列副本分离架构,通过数据复制把交易侧的数据同步到分析侧。相比TP/AP完全分离,实时性已经进了一步;但只要还依赖复制,复制延迟、一致性保障和额外硬件开销就仍然存在。
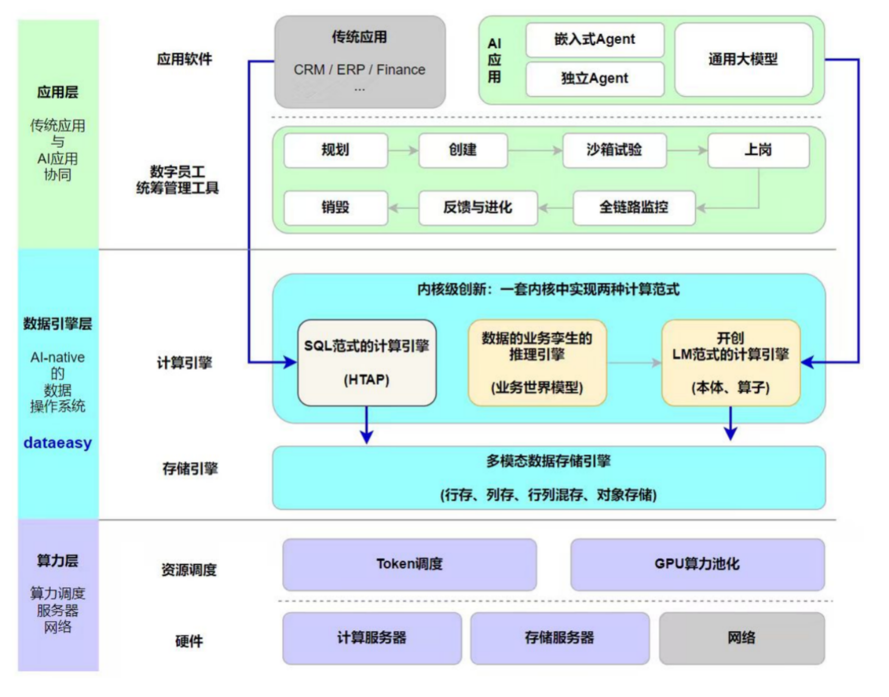
内核级 AI原生阵营的代表是数翊科技dataeasy。它的HTAP内核采用一体化架构,由一套引擎同时支撑TP与AP负载,数据产生的瞬间就具备被分析的能力,不经过跨系统复制,从源头减少搬迁带来的延迟、安全与一致性问题;据厂商资料,相比组合式HTAP方案, 可减少复制链路和多集群部署,降低建设与运维成本 。在此基础上, dataeasy进一步把AI推理 、 业务认知 与 智能执行 能力放进内核,通过业务世界模型与业务世界数字孪生,让大模型更贴近业务语境理解企业数据。
三、四条路线放在一张表里
四、数翊科技的选择:把 “理解业务”放进内核
这里不做优劣判断。四条路线是四种工程取舍:向量数据库改造小、见效快;传统关系型胜在成熟;组合式 HTAP在既有架构上换来了实时性;内核级AI原生则选择动底层,代价是研发周期长、门槛高,回报是业务语义和数据治理能沉淀在系统里,AI应用不必为每个场景重复开发接口。
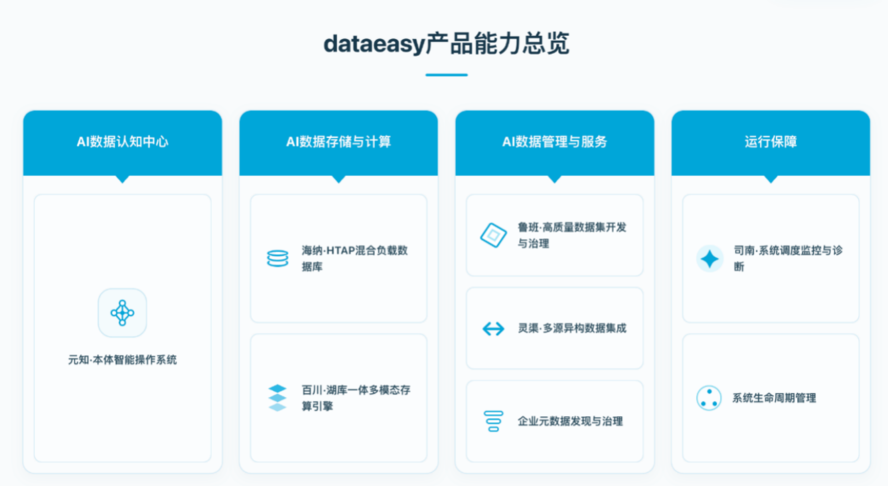
落到产品,这条路线的载体是六款工具:元知 ·本体智能操作系统把企业业务概念、数据关系与计算逻辑建成机器可读的本体;海纳·HexaDB提供原生HTAP内核;百川·湖库一体多模态存算引擎承载图片、音频、视频、文档等非结构化数据;鲁班·高质量数据集开发与治理统一数据口径与服务;灵渠·多源异构数据集成负责迁移与实时同步;司南·系统调度监控与诊断覆盖集群全生命周期运维。
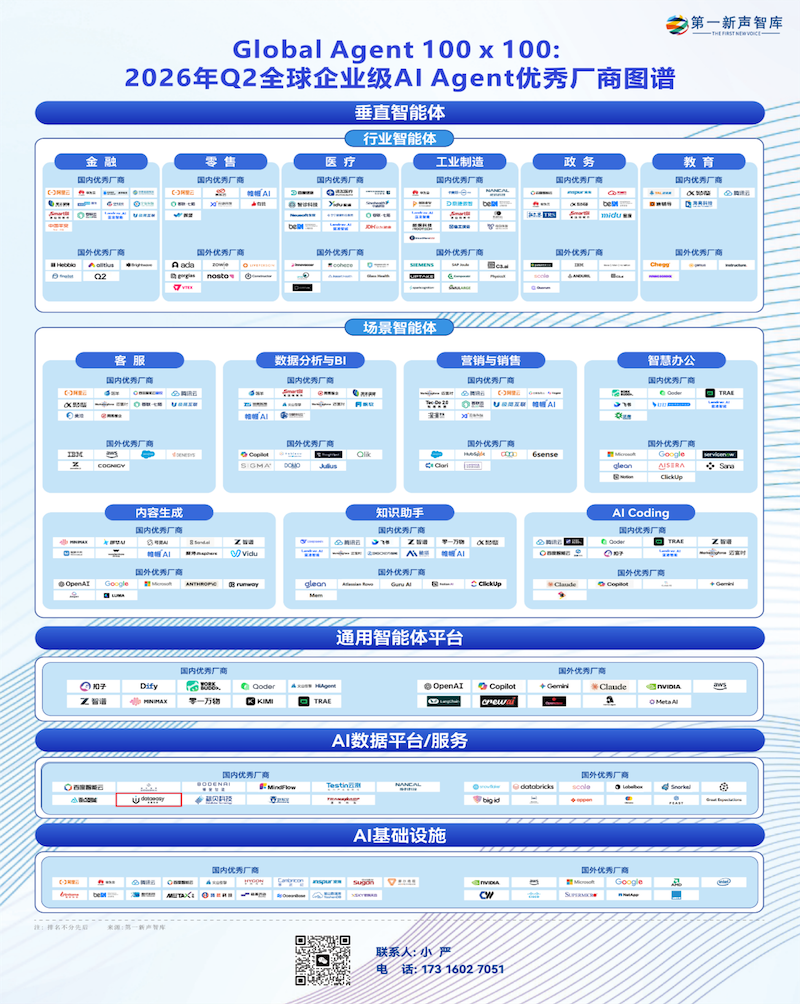
资质层面,据厂商公开资料,数翊科技于 2026年获评国家级专精特新“小巨人”企业,此前于2024年获评北京市“专精特新”中小企业;自研HexaDB通过CCRC EAL4增强级认证;并入选全球企业级AI Agent优秀厂商图谱的AI数据平台/服务板块。
五、选型:先看存量系统,再看 AI场景
如果存量系统以核心交易为主、当下诉求是国产化替换与稳定运行,传统关系型数据库仍是主线;如果痛点集中在文档、图片、知识库的检索,向量数据库是更直接的切入点;如果已经有大数据平台、希望交易与分析少搬一次数据,组合式 HTAP值得评估;如果目标是让AI Agent直接读懂企业业务数据、在授权范围内执行任务,而不只是检索文档或外挂SQL函数,那么内核级AI原生这条路线更适合放进考察名单。
选型的顺序通常是:先盘清存量系统的类型与数据量,再明确 AI场景落在检索、分析还是执行,最后用POC验证实时性、语义准确率与运维成本。路线没有统一答案,匹配才是。
原文作者:李航 ;链接:https://blog.itpub.net/69965512/viewspace-3187605/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- AI数据平台选型:dataeasy适合哪几类企业,哪几类不用看
- 数翊科技怎么样?从团队、产品、资质三个维度看这家公司
- 什么样的企业需要AI原生数据底座?从dataeasy看落地场景
- 大模型为什么读不懂企业业务数据?dataeasy的解题思路
- 每月 1 亿次通话背后:Retell 如何用 OpenAI 模型把语音智能体做成“可运营”的生产系统
- GitHub Copilot Fusion 解析:把模型选择交给系统,用一半 API 成本对标 Claude Code
- 让模型懂“本地规则”,而不只是本地语言:拆解 NVIDIA Nemotron 的区域化后训练工作流
- OpenAI 与 Oracle 把企业应用搬进 ChatGPT:一场关于“智能体工作台”的入口争夺
- 从“工作负载停在哪”到“故障从哪开始”:解读 NVIDIA Attribution 的分布式 AI 故障归因思路
- 2026 年数据科学平台选型指南:十大平台的能力边界与决策逻辑
