编者按
随着BERT在NLP各种任务上取得骄人的战绩,预训练模型在不到两年的时间内得到了很大的发展。BERT和Open-GPT等预训练语言模型的引入,使整个自然语言研究界发生了革命性的变化。然而,与它们巨大的好处相比,研究人员对它们的理论和经验性质仍然知之甚少。本文回顾了有关预训练深度神经网络的相关文献及观点,以及带有词嵌入的微调策略。针对已有的两种主流算法NFT-TM和FT-NTM,综合考虑了在预训练语言模型上建立一个上层网络,并以适当的方式对两者进行微调的可能性,提出了一种新算法FT-TM。通过对一系列NLP任务的实验结果分析,比较了算法FT-TM和FT-NTM的效果,证明了新算法FT-TM的优势。
在NLP的预训练语言模型时代,针对已有的两种主流算法NFT-TM和FT-NTM,本文提出了一种新算法FT-TM。它首先在BERT的基础上建立一个上层神经网络(LSTM或者CNN等等),然后在适当的策略下对两者进行同时训练。该算法融合了NFT-TM和FT-NTM两种算法的优势,通过一系列NLP任务的实验结果表明,新算法FT-TM能取得更好的效果,而且在公开的Quora和SLNI两个问题语义等价数据集上,新算法FT-TM的效果都达到了目前的State of the Art。
01 引 言
在这项研究中,我们的目标是比较算法FT-TM和FT-NTM的效果,更具体地说,我们执行三个NLP任务,包括序列标记、文本分类和句子语义等价性。在第一个任务中,实验结果表明即使不修改网络结构,在预训练语言模型之上构建上层网络也可以提高准确性。在第二个任务中,实验结果表明通过集成不同的神经网络,甚至可以进一步提高微调方法FT-NTM的效果。在最后一项任务中,实验结果表明如果可以定制一个专门适合于预训练语言模型特征的上层神经网络,则可以进一步提高效果。因此,所有实验结果都表明算法FT-TM优于FT-NTM。
本文接下来的内容安排如下:首先,我们回顾了有关预训练深度神经网络的相关文献,包括Peter等人的观点[3]以及带有词嵌入的微调策略;其次,我们给出了三个实验的结果,并显示了算法FT-TM与FT-NTM相比,能达到更好的效果,证明了算法FT-TM的优势。
02 文献综述
03 改进训练算法FT-TM
在传统的NLP语言处理中,通常采用的方法是词向量加上层模型的方式。在这个训练的过程中,由于词向量是已经经过大量训练,而上层模型的参数初始化是随机的,所以一般来说,如果直接同时训练词向量的参数和上层模型的参数,其效果将会大打折扣。对于这种情况,常常采用的策略是,首先固定词向量,并训练上层模型若干轮数达到理想效果,然后训练词向量或词向量加上层模型少数epoch。
如果我们将以上思维应用于BERT的话,我们会发现如果我们仅仅是同时训练BERT和上层模型将会产生较差的效果。BERT相比于词向量具备更大的参数,因此如果我们同时训练上层模型和BERT,就会面临两种困境。如果我们采用较小的学习率,上层模型收敛就会较慢,其效果不好。如果我们采用较大的学习率,就会严重破坏已经预训练好的BERT结构。因此我们必须采用其他的方法进行训练。
根据刚刚的分析,我们在本文中提出了一种基于预训练模型和联合调参的改进训练算法FT-TM,在该算法中,首先固定BERT的参数,然后训练上层的模型。在这里上层的模型既可以是比较通用的,例如LSTM和CNN,也可以是其他的模型。当训练达到一定的精度后,再同时开始训练BERT和上层模型,我们发现FT-TM已经可以显著的提高训练的效果。
但是在训练的过程中,有一些问题需要注意,首先如果是对于词向量来说,一般的方法是训练上层模型直至其收敛,换句话说,直至其在验证集上达到的最高的准确率。但是在对BERT进行试验的时候我们发现,这种方法效果并不理想,通过分析其训练集和验证集的预测精度对比,我们发现问题的根源在于可能存在的过拟合现象,这也是有一定直观原因的,从参数数量来说,BERT的参数数量远大于上层模型和常用的NLP模型,所以如果在上层模型精度达到最高后再开始训练,BERT就很有可能导致严重的过拟合。
这点在具体的NLP任务实验中也是很明显的,在实验中,这样的做法下,训练集的精度甚至会达到接近100%,为了解决这个问题,FT-TM中的做法是,不在上层模型收敛后再开始训练BERT和上层模型,而是在其达到一定的准确度就开始这个过程。
除此之外,在训练BERT的时候还会有另外的一种情况,如果BERT预训练语料和目标语料差别较大,就可能BERT在fine-tune的时候收敛很慢。在这种情况下,采用以上的方法进行训练效果并不好,为了应对这种情况,FT-TM中采取的做法是:首先,采用BERT加上全连接层对BERT的参数进行fine-tune,然后再采用前面讲到的措施进行fine-tune。
同时,在句子语义等价的NLP任务上,我们对FT-TM算法进行了进一步的具体化,在具体的实现中,预训练模型采用BERT,上层神经网络基于BIMPM[27]进行了改进,在实验4.3部分会介绍这种方法的效果,目的是说明FT-TM这种联合训练的算法相比FT-NTM能达到更好的效果,甚至能达到业界的State of the Art。在具体介绍算法之前,首先对句子等价的任务进行说明。判断句子是否等价的任务要远远比单纯的词语匹配复杂。举例来说,问题“市政府的管辖范围是什么?”和“市长的管辖范围是什么?”仅有两个字的差异,但两者语义是不相同的,因此其回答也应该不一样的。另一方面来说,“市政府的职责是什么”和“请问,从法律上来讲,市政府究竟可以管哪些事情“这两个问题,除去在“市政府”一词外,几乎是没有任何重合的,但两者语义是等价的,因此其答案也应该是一样的。从这几个例子来看,句子匹配的任务需要模型能够真正理解其句子的语义。
在BERT等预训练模型出现之前,语义本身的表达一般是用word vector来实现。为了得到句子的深层语义表达,所采用的方法往往是在上层架设网络,以BIMPM为例,BIMPM是一种matching-aggregation的方法,它对两个句子的单元做匹配,如经过LSTM处理后得到不同的time step输出,然后通过一个神经网络转化为向量,然后再将向量做匹配。下面来详细介绍一下BiMPM的大体流程,如图中所示,从Word Representation Layer 开始,将每个句子中的每个词语表示成d维向量,然后经过Context Representation Layer 将上下文的信息融合到需要对比的P和Q两个问题中的每个time-step表示。Matching Layer 则会比较问题P和问题Q的所有上下文向量,这里会用到multi-perspective 的匹配的方法,用于获取两个问题细粒度的联系信息,然后进入Aggregation Layer 聚合多个匹配向量序列,组成一个固定长度的匹配向量,最后用于Prediction Layer 进行预测概率。
图2 BIMPM神经网络结构 [27]
-
首先,我们去掉了原始BIMPM模型中接在字向量层的Bi-LSTM模型,之所以这样做,其原因在于LSTM并没有设计机制保证梯度向深度模型的后向传导;
-
其次,我们用Transformer模型替代了BIMPM最上层的Bi-LSTM模型。这样做的原因主要是考虑到Bi-LSTM能够捕捉数据当中的序列特征。但是由于BIMPM采用多种匹配后,其序列性并不强,所以Transformer更适合该模型。
04 实 验
在序列标记任务中,我们使用共享基准数据集CoNLL03数据集[6]探索实体识别子任务。文献[20],[21],[22]在此数据集上测试了它们的新网络结构。该实验以仅对BERT进行fine-tune(即方法FT-NTM)的结果为baseline,对比了在BERT基础上增加一个传统用于NER任务的Bi-LSTM网络(即方法FT-TM)的效果,实验结果如表2中所示。
实验结果表明,结合BERT的fine-tune和上层神经网络的FT-TM算法在该任务上的F1值较baseline提升了近7个百分点。
表3 文本分类的结果
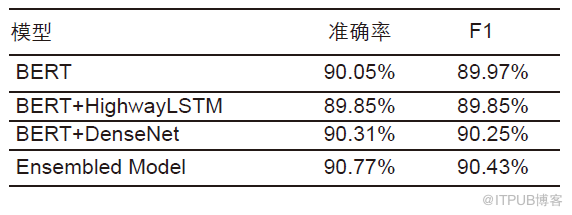

表4 句子语义相似任务在Quora数据集的结果
为了确保实验结论的有效性,除去Quora的数据集之外,我们还采用了SLNI数据集当中包含句子等价性的数据集,该数据集包括55万条训练集和10000条测试集。很多学者都用了这些数据来测试他们的模型包效果,对比这些模型,FT-TM算法的准确率上有将近两个点的提升,达到了目前的State of the Art,具体实验结果如下表所示:
表5 句子语义相似任务在SNLI数据集的结果
因此,从上面一系列的实验结果可以看出,我们提出的结合上层复杂模型和fine-tune的算法FT-TM是有效的,并且在NLP任务中优于fine-tune的算法FT-NTM,同时在BERT预训练模型上面集成的神经网络模型好坏也会影响到最终的任务效果。
参考文献
-
Jacob Devlin, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. Bert: Pre-training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805, 2018.
-
Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. Language models are unsupervised multitask learners. OpenAI Blog, 1:8, 2019.
-
Matthew Peters, Sebastian Ruder, and Noah A Smith. To tune or not to tune? adapting pretrained representations to diverse tasks. arXiv preprint arXiv:1903.05987, 2019.
-
Pranav Rajpurkar, Jian Zhang, Konstantin Lopyrev, and Percy Liang. Squad: 100,000+ questions for machine comprehension of text. arXiv preprint arXiv:1606.05250, 2016.
-
Siva Reddy, Danqi Chen, and Christopher D Manning. Coqa: A conversational question answering challenge. arXiv preprint arXiv:1808.07042, 2018.
-
Erik F Sang and Fien De Meulder. Introduction to the conll-2003 shared task: Language-independent named entity recognition. arXiv preprint cs/0306050, 2003..
-
Alex Wang, Amapreet Singh, Julian Michael, Felix Hill, Omer Levy, and Samuel R Bowman. Glue: A multi-task benchmark and analysis platform for natural language understanding. arXiv preprint arXiv:1804.07461, 2018.
-
Sébastien Jean, Orhan Firat, Kyunghyun Cho, Roland Memisevic, and Yoshua Bengio. Montreal neural machine translation systems for wmt’15. In Proceedings of the Tenth Workshop on Statistical Machine Translation, pages 134–140, 2015.
-
Yu Sun, Shuohuan Wang, Yukun Li, Shikun Feng, Xuyi Chen, Han Zhang, Xin Tian, Danxiang Zhu, Hao Tian, and Hua Wu. Ernie: Enhanced representation through knowledge integration. arXiv preprint arXiv:1904.09223, 2019.
-
Tomas Mikolov, Kai Chen, Gregory S Corrado, and Jeffrey Dean. Efficient estimation of word representations in vector space. international conference on learning representations, 2013.
-
Matthew E Peters, Mark Neumann, Mohit Iyyer, Matt Gardner, Christopher G Clark, Kenton Lee, and Luke S Zettlemoyer. Deep contextualized word representations. north american chapter of the association for computa- tional linguistics, 1:2227–2237, 2018.
-
Jeremy Howard and Sebastian Ruder. Universal language model fine-tuning for text classification. meeting of the association for computational linguistics, 1:328–339, 2018.
-
Sepp Hochreiter and Jürgen Schmidhuber. Long short-term memory. Neural computation, 9(8):1735–1780, 1997.
-
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention is all you need. In Advances in neural information processing systems, pages 5998–6008, 2017.
-
Kaz Sato, Cliff Young, and David Patterson. An in-depth look at google’s first tensor processing unit (tpu). Google Cloud Big Data and Machine Learning Blog, 12, 2017.
-
Richard Socher, Alex Perelygin, Jean Wu, Jason Chuang, Christopher D Manning, Andrew Ng, and Christopher Potts. Recursive deep models for semantic compositionality over a sentiment treebank. In Proceedings of the 2013 conference on empirical methods in natural language processing, pages 1631–1642, 2013
-
Adina Williams, Nikita Nangia, and Samuel R Bowman. A broad-coverage challenge corpus for sentence understanding through inference. arXiv preprint arXiv:1704.05426, 2017.
-
WilliamBDolanandChrisBrockett.Automaticallyconstructingacorpusofsententialparaphrases.InProceedings of the Third International Workshop on Paraphrasing (IWP2005), 2015.
-
Daniel Cer, Mona Diab, Eneko Agirre, Inigo Lopez-Gazpio, and Lucia Specia. Semeval-2017 task 1: Semantic textual similarity-multilingual and cross-lingual focused evaluation. arXiv preprint arXiv:1708.00055,2017.
-
Jeffrey Pennington, Richard Socher, and Christopher Manning. Glove: Global vectors for word representation. In Proceedings of the 2014 conference on empirical methods in natural language processing (EMNLP), pages 1532–1543, 2014.
-
Guillaume Lample, Miguel Ballesteros, Sandeep Subramanian, Kazuya Kawakami, and Chris Dyer. Neural architectures for named entity recognition. arXiv preprint arXiv:1603.01360, 2016.
-
Xuezhe Ma and Eduard Hovy. End-to-end sequence labeling via bi- directional lstm-cnns-crf. arXiv preprint arXiv:1603.01354, 2016.
-
Hoa T Le, Christophe Cerisara, and Alexandre Denis. Do convolutional networks need to be deep for text classification? In Workshops at the Thirty-Second AAAI Conference on Artificial Intelligence, 2018.
-
Yu Zhang, Guoguo Chen, Dong Yu, Kaisheng Yaco, Sanjeev Khudanpur, and James Glass. Highway long short-term memory rnns for distant speech recognition. In 2016 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), pages 5755–5759.IEEE, 2016.
-
Jonas Mueller and Aditya Thyagarajan. Siamese recurrent architectures for learning sentence similarity. In Thirtieth AAAI Conference on Artificial Intelligence, 2016.
-
Shuohang Wang and Jing Jiang. A compare-aggregate model for matching text sequences. arXiv preprint arXiv:1611.01747, 2016.
-
Qian Chen, Xiaodan Zhu, Zhenhua Ling, Si Wei, Hui Jiang, and Diana Inkpen. Enhanced lstm for natural language inference. arXiv preprint arXiv:1609.06038, 2016.
-
Zhiguo Wang,Wael Hamza, and Radu Florian. Bilateral multi- perspective matching for natural language esentences. arXiv preprint arXiv:1702.03814, 2017.
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69965230/viewspace-2684329/ ,如需转载,请注明出处,否则将追究法律责任。

