Flink介绍:
很多人可能都是在 2015 年才听到 Flink 这个词,其实早在 2008 年,Flink 的前身已经是柏林理工大学一个研究性项目, 在 2014 被 Apache 孵化器所接受,然后迅速地成为了 ASF(Apache Software Foundation)的顶级项目之一。Flink 的最新版本目前已经更新到了 0.10.0 了,在很多人感慨 Spark 的快速发展的同时,或许我们也该为 Flink 的发展速度点个赞。
Flink 是一个针对流数据和批数据的分布式处理引擎。它主要是由 Java 代码实现。目前主要还是依靠开源社区的贡献而发展。对 Flink 而言,其所要处理的主要场景就是流数据,批数据只是流数据的一个极限特例而已。再换句话说,Flink 会把所有任务当成流来处理,这也是其最大的特点。Flink 可以支持本地的快速迭代,以及一些环形的迭代任务。

Flink的特性:
Flink是个分布式流处理开源框架:
1: 即使数据源是无序的或者晚到达的数据,也能保持结果准确性
2:有状态并且容错,可以无缝的从失败中恢复,并可以保持exactly-once
3:大规模分布式
Flink可以确保仅一次语义状态计算;Flink有状态意味着,程序可以保持已经处理过的数据;
Flink支持流处理和窗口事件时间语义,Flink支持灵活的基于时间窗口,计数,或会话数据驱动的窗户;
Flink容错是轻量级和在同一时间允许系统维持高吞吐率和提供仅一次的一致性保证,Flink从失败中恢复,零数据丢失;
Flink能够高吞吐量和低延迟;
Flink保存点提供版本控制机制,从而能够更新应用程序或再加工历史数据没有丢失并在最小的停机时间。


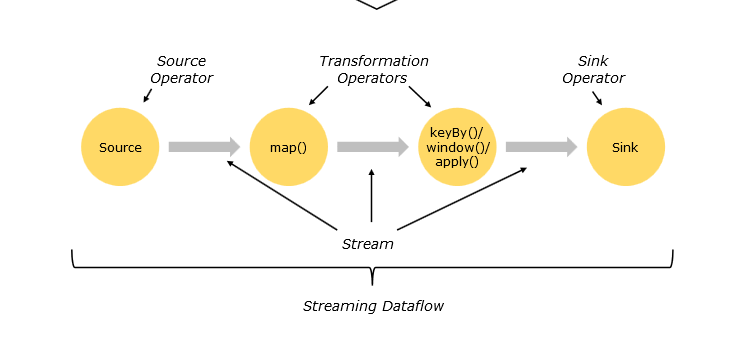
Flink的程序内在是并行和分布式的,数据流可以被分区成
stream partitions
,operators被划分为operator subtasks;这些subtasks在不同的机器或容器中分不同的线程独立运行;operator subtasks的数量在具体的operator就是并行计算数,程序不同的operator阶段可能有不同的并行数;如下图所示,source operator的并行数为2,但最后的sink operator为1;

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69963428/viewspace-2742579/
,如需转载,请注明出处,否则将追究法律责任。