[OSDI'14]
[OSDI'14] Scaling Distributed Machine Learning with the Parameter Server
本期论文:Scaling Distributed Machine Learning with the Parameter Server
背景
参数服务器是一种编程框架,用于简化分布式机器学习程序的编写,其中重点在于对大规模参数的分布式存储和协同的支持。
机器学习任务相比于其他计算任务而言,具有以下特点:
- 迭代性:模型的更新并非一次完成,需要多次迭代
- 容错性:即使在每次迭代中产生一些错误,模型最终仍能收敛
- 参数收敛非统一性:各参数收敛需要的迭代次数不同
同时对于工业界中的大规模机器学习而言,具有以下特点:
- 模型参数很大,超过单台机器的容纳能力
- 训练数据很大,需要并行加速
此外,设计一个上述系统时,我们还需要解决一系列问题,例如如何降低频繁更新模型参数消耗的大量带宽,如何提高并行度,减少同步等待造成的延迟,以及如何设计容错机制等等。显然 MapReduce 等框架不能满足这些需求,而参数服务器即为解决这种需求提出的。
发展历史
参数服务器的概念最早来自于 Alex Smola 于2010年提出的并行 LDA 框架,它采用 Memcached 分布式存储参数,提供了有效的机制用于分布式系统中 worker 之间同步模型参数,而每个 worker 只需要保存其计算时所需要的一小部分参数即可。
后来由 Google 的 Jeff Dean 进一步提出了 Google 第一代深度学习系统:DistBelief。DistBelief 将巨大的深度学习模型分布存储在参数服务器中,计算节点通过参数服务器进行通信,很好地解决了 SGD 和 L-BFGS 算法的分布式训练问题。
本文作者李沐提出第三代参数服务器。
设计原则
- 高效的网络通信:因为模型参数和训练数据都十分巨大,高效的网络通信是大规模机器学习系统不可或缺的,通过支持异步通信,可以大大减少延迟
- 灵活的一致性模型:提供 BSP,ASP,SSP 三种一致性模型,允许开发人员在算法收敛速率和系统性能之间进行权衡
- 弹性可扩展:对于任务时效性要求的变化而随时更改集群机器配置的需求,系统需要能在不影响任务的情况下做到机器的热插拔,通过使用一致性哈希算法,新增加的节点可以随时插入到系统中,无需重启系统
- 容错性:大规模集群协作进行计算任务时,不可避免会出现故障或者计算任务的资源被抢占等情况,因此系统设计时就要考虑如何应对。对于 server,使用链备份;而对于 worker,因为 worker 之间互相不通信,因此在某个 worker 失效后,新的 worker 可以直接加入
- 易用性:全局共享参数被表示为稀疏的 vector 或 matrices 等线性代数对象,从而在计算参数时可以使用 BLAS 等线性代数库进行优化
系统架构
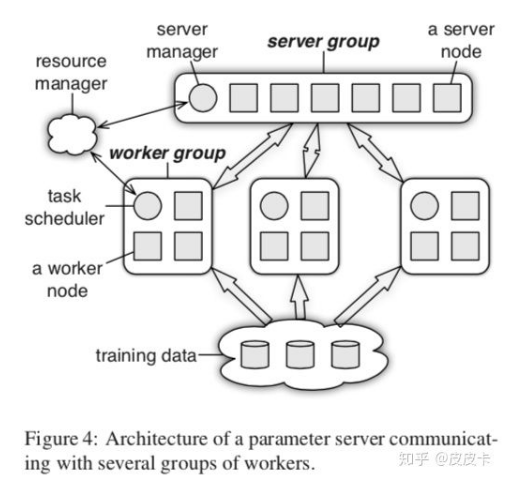
如上图所示,参数服务器的节点被划分到一个 server group 和多个 worker group ,server group 中的每个 server 只负责自己分到的部分全局共享参数。server 之间相互通信进行参数的备份、迁移。server group 有一个 server manager,负责维护 server 元数据的一致性,例如节点状态,参数的分配情况。
每个 worker group 运行一个计算任务,worker group 中的 worker 使用部分数据进行训练,worker 之间没有通信,只和对应的 server 通信进行参数更新。每个 worker group 有一个 task scheduler,负责向 worker 分配任务,并监控他们的运行情况,当有 worker 进入或者退出时,task scheduler 重新分配未完成的任务。
此外,参数服务器复用现有的资源管理系统,如 Yarn、Mesos 或者 Kubernetes 作为 resource manager;训练数据则使用分布式文件系统存储,一般是 HDFS。
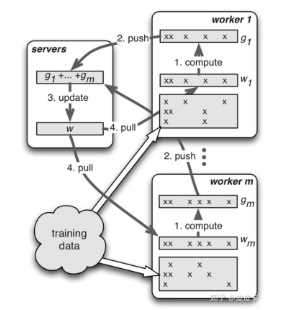
如上图所示,一个具体任务运行时,task scheduler 负责通知每个 worker 加载自己对应的数据,然后从 server 上拉取一个要更新的参数分片,用本地数据计算参数分片对应的变化量,然后同步给 server;server 在收到自己负责的参数分片对应的所有 worker 的更新后,对参数分片做一次更新。
(Key, Value) Vectors
大多数已有的框架中将参数视作 (key, value) 对象进行抽象。例如对于常见的机器学习算法来说,key 是 feature ID,value 是其权重,对于不存在的 key,可认为其权值为0。而在本文中,还将参数视作稀疏的 vector 或 matrices 等线性代数对象(通过保证key是有序的情况下),从而在计算参数时可以使用 BLAS 等线性代数库进行优化。
Range Push and Pull
worker 和 server 之间通信是通过 push() 和 pull() 方法进行的。worker 通过 push() 将计算好的梯度发送到 server,然后通过 pull() 从 server 获取更新参数。
为了简化编程,提高通信效率,允许用户使用 Range Push/Range Pull 操作。
w.push(R, dest)
w.pull(R, dest)
Flexible Consistency
众所周知,在分布式计算系统中,由于多个计算节点计算进度不可能完全一致,会导致在汇总结果时需要等待那些计算速度较慢的节点(Straggler),即慢节点会拖慢整个计算任务的进度,浪费计算资源。
考虑到机器学习的特殊性,系统可以适当放宽同步限制,不需要每一轮都等待所有的计算节点完成计算,跑得快的计算任务,完全可以先把训练好的参数 push 上去,然后进行下一轮训练。这样可以减少等待时间,让整个计算任务更快。
这样做会使得模型更新的时候,worker 的模型参数与 server 的模型参数可能会不一致,导致收敛速率下降甚至不收敛,但是在非凸问题(例如深度学习的优化)中,这反而是个好事,引入了随机性。因为非凸问题本身就不是梯度下降能够解决的,正常的单机迭代肯定会收敛到局部最优。有时我们常常会用一些额外的方法来跳出局部最优:
- 多组参数值初始化
- 模拟退火
- 随机梯度下降
而参数服务器正好利用异步性引入了随机性,有助于跳出局部最优。因此在 Google 的DistBelief 框架中,提出了 Downpour SGD 算法,就是尽最大可能利用了这种随机性。因此,异步通信在分布式机器学习系统中,是非常重要的功能之一。
本文提出的参数服务器提供如下三个级别的一致性模型:
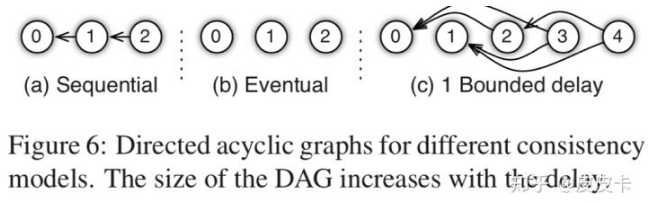
Sequential:一般的分布式计算采用的同步通信,例如 Spark。在每一轮迭代中都需要等待所有的任务计算完成。Sequential 也称为 BSP(Bulk Synchronous Parallel)。
- 优点:适用范围广;每一轮迭代收敛质量高
- 缺点:每一轮迭代都需要等待最慢的任务,整体任务计算时间长
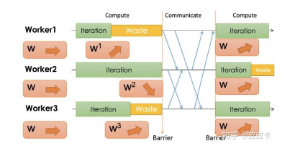
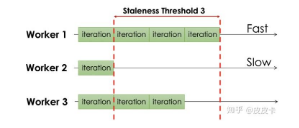
Bounded Delay:设置一个最大延时时间,称之为 staleness 值,允许一定程度的任务进度不一致,即最快的任务最多领先最慢的任务 staleness 轮迭代。因此 staleness = 0 时,即 Sequential 一致性模型;staleness = ∞ 时,即 Eventual 一致性模型。Bounded Delay 也称为 SSP(Stalness Synchronous Parallel)。
- 优点:一定程度减少了任务之间的等待时间,计算速度较快,允许开发人员在算法收敛速率和系统性能之间进行权衡
- 缺点:每一轮迭代的收敛质量不如 BSP,达到同样的收敛效果可能需要更多轮的迭代;适用性也不如 BSP,部分算法不适用
Eventual:异步通信,任务之间完全不用相互等待,先完成的任务,继续下一轮的训练。Eventual 也称为 ASP(Asynchronous Parallel)。
- 优点:不用等待其他任务,计算速度快
- 缺点:适用性差,收敛速率下降甚至不收敛
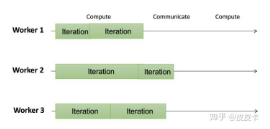
三种一致性模型的同步限制依次放宽。为了追求更快的计算速度,算法可以选择更宽松的一致性模型。在实际算法中,需要根据指标的变化情况,调整一致性模型以及相关的参数,以达到收敛性和计算速度的平衡。
User-defined Filters
支持用户自定义过滤器过滤部分 entries,从而减少网络带宽。常用的过滤器有 significantly modified filter,即只 push 变化大于某一阈值的 entries;KKT filter,利用最优化问题的一些条件来过滤对 weights 影响不大的 entries。
具体实现
Vector Clock
参数服务器使用 range vector clock 来记录每个节点的参数的时间戳,用来跟踪数据状态或避免数据重复发送。由于参数都是 Range Push/Range Pull,因此同一个 key range 里的参数可以共享同一个时间戳,相较于传统的 vector clock 进行了压缩,降低了内存和网络带宽开销。
Messages
节点之间通信发送的 message 由 range vector clock 和 (key, value) 对组成。
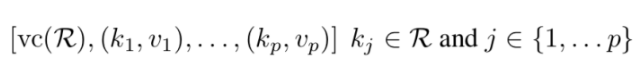
由于频繁更新模型参数,需要对 message 进行压缩以减少网络带宽开销。参数服务器采用两种方法来压缩 message:
- key 的压缩:训练数据在迭代时通常不会改变,因此 worker 没必要每次都发送相同的 key lists,server 第一次接收时缓存起来即可,后续只需要发送 key lists 的哈希值进行匹配。
- value 的压缩:有些参数更新并非对最终优化有价值,因此用户可以自定义过滤规则来过滤掉一些不必要的参数。例如对于梯度下降,大量value 为 0 或者很小的梯度是低效的,可以过滤。
Consistency and Replication
参数服务器采用一致性哈希算法,将 key 和 server 按照某种哈希算法映射到环上。每一个 server 负责管理从插入点逆时针方向到另一个 server 之间的 key range,即将 key 存储到环上顺时针方向最近的 server 上,这个 server 被称为该 key range 的主 server;每个 server 会备份逆时针方向 k 个 key range,这个 server 称为该 key range 的备份 server。一个物理上的 server 通常会表示为多个虚拟化的 server,以提高负载均衡和故障恢复能力。
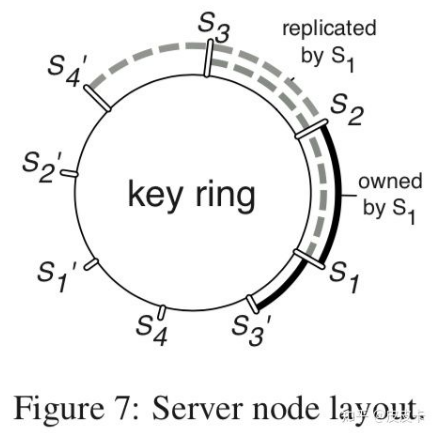
上图中,k= 2,server 1 对 server 2 和 server 3 的 key range 进行了备份。
有两种方式保证主节点与备份节点之间的数据一致性:
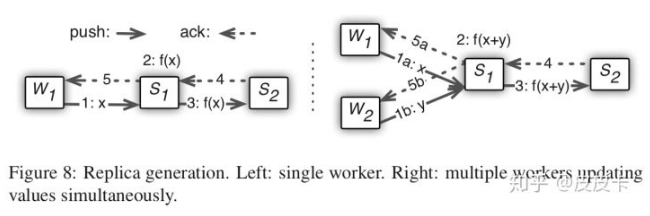
- Chain Replication:如下左图所示,worker 1 更新 x,server 1 调用自定义的函数 f(x) 处理数据。然后将 f(x) 备份到 server 2,这次的 push 才算结束,woker1 收到 ack。该备份方式对于一些需要频繁更新参数的算法,可能造成难以承受的网络带宽开销。
- Replication after Aggregation:如下右图所示,server 将所有 worker 的更新聚合后进行备份,再发送 ack 给 worker。由于要等待聚合操作,会带来任务拉取更新的延时,然而可以通过放宽一致性模型来弥补。
Server Management
添加 server:
- server manager 给新 server 分配 key range,其他 server 的 key range 做出相应更改
- 新 server 获取作为主 server 维护的 key range 和作为从 server 维护的 k 个 key range
- server manager 广播节点的更改
删除 server:
当 server manager 通过心跳信号发现 server 出现故障后,会将该 server 的 key range 分配给新的 server,并删除该 server
Worker Management
添加 woker:
- task scheduler 给新 worker 分配数据
- 该新 worker 载入训练数据,然后从 server 获取参数
- task scheduler 广播节点的更改,可能造成其他 worker 释放部分训练数据
删除 woker:
丢失小部分训练数据通常并不会影响模型训练结果,此外恢复一个 worker 比 server 需要更多的开销。因此删除 worker 通常是直接不管该节点,可以用于终止最慢的 worker,减缓 Straggler 带来的性能影响。当然用户也可以选择用新 worker 来替代丢失的 worker。
参考文献
[1] Smola A, Narayanamurthy S. An architecture for parallel topic models[J]. Proceedings of the VLDB Endowment, 2010, 3(1): 703-710.
[2] Dean J, Corrado G, Monga R, et al. Large scale distributed deep networks[C]. 26th Annual Conference on Neural Information Processing Systems. 2012: 1232-1240.
[3] Li M, Andersen D G, Park J W, et al. Scaling distributed machine learning with the parameter server[C]. 11th USENIX Symposium on Operating Systems Design and Implementation (OSDI 14). 2014: 583-598.
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69957675/viewspace-3149732/ ,如需转载,请注明出处,否则将追究法律责任。

