嵌套循环,哈希连接,排序合并连接的使用场景介绍
嵌套循环连接-Nested Loops
1 、 首先选择一张表作为连接的驱动表,这张表也称为外部表(Outer Table )。由驱动表进行驱动连接的表称为被驱动表,也叫内部表(Inner Table )。
2 、 提取驱动表中符合条件的记录,与被驱动表的连接列进行关联查询符合条件的记录。在这个过程中,首先提取驱动表中符合条件的第一条记录,再与内部表的连接列进行关联查询相应的记录行。在关联查询的过程中,会持续提取驱动表中其他符合条件的记录与内部表关联查询。这两个过程是并行进行的,因此嵌套循环连接返回前几条记录的速度是非常快的。
3 、嵌套循环连接使用场景
适用于查询的选择性强、约束性高并且仅返回小部分记录的结果集。通常要求 驱动表的记录(符合条件的记录,通常通过高效的索引访问) 较少,且 被驱动表连接列有唯一索引或者选择性强的非唯一索引时,嵌套循环连接的效率是比较高的。
嵌套循环连接返回前几行的记录是非常快的,这是因为使用了嵌套循环后,不需要等到全部循环结束再返回结果集,而是不断地将查询出来的结果集返回。在这种情况下,终端用户将会快速地得到返回的首批记录,且同时等待数据库内部处理其他记录并返回。如果查询的驱动表的记录数非常多,或者被驱动表的连接列上无索引或索引不是高度可选的情况,嵌套循环连接的效率是非常低的。
举例说明:
|
create table t1 ( id int , name varchar2 ( 20 )); create table t2 ( id1 int , name varchar2 ( 20 ));
begin for i in 1 .. 5 loop insert into t1 values ( i , 'A' ||i ); end loop ; commit ; end ;
begin for i in 1 .. 100000 loop insert into t2 values ( i , 'B' ||i ); end loop ; commit ; end ;
create index idx_t2_id1 on t2 ( id1 ); |
执行查询:
select a . * , b . *
from t1 a , t2 b
where a . id=b . id1 and a . name like 'A1%' ;
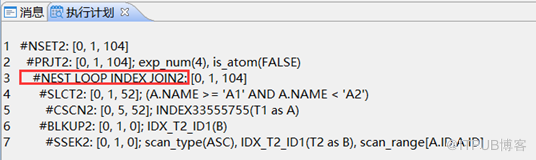
解析:
1 .select * from t1 a where a.name like 'A1%';
2.loop (data from 1)
3.select * from t2 b where b.id1 = a.id;
注:第三步执行次数= 第一步的返回记录数
假如第一步返回记录数是100 ,需要消耗3s ,第三步需要消耗1s ,则执行查询一共需要消耗的时间是:3s+100*1s
所以要想使用嵌套循环,则:
1 、驱动表要小
2 、通过连接条件访问被驱动表要快(要有合适且高效的索引)
哈希连接-Hash Join
哈希连接分为两个阶段:
1
、
构建阶段:优化器首先选择一张小表做为驱动表,运用哈希函数对连接列进行计算产生一张哈希表。通常这个步骤是在内存(hash_area_size
)里面进行的,因此运算很快。
2
、
探测阶段:优化器对被驱动表的连接列运用同样的哈希函数计算得到的结果与前面形成的哈希表进行探测返回符合条件的记录。这个阶段中如果被驱动表的连接列的值没有与驱动表连接列的值相等的话,那么这些记录将会被丢弃而不进行探测。
接前面的例子:
drop index idx_t2_id1 on t2 ( id1 );
执行查询:
select a . * , b . *
from t1 a , t2 b
where a . id=b . id1 and a . name like 'A1%' ;
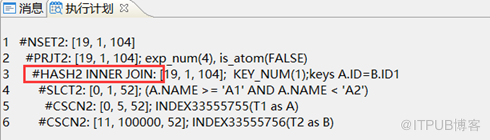
3 、使用场景
( 1 )驱动表可能记录数相对大
( 2 )被驱动表通过连接条件没有合适的索引。
4 、局限
( 1 )必须是等值连接
( 2 )要求连接条件有一定的区分度。
5 、对比
nested loop :驱动表数据量* 被驱动表单条(带连接条件)访问性能
hash join :被驱动表全结果集(无连接条件)访问性能
被驱动表没有索引,使用hash join
被驱动表是复杂运算后的结果集,使用hash join 。
排序合并连接-Sort Merge Join
First and second row sources are sorted by same sort key.
Sorted rows from both side are merged.
排序合并连接的方法非常简单。在排序合并连接中是没有驱动表的概念的,两个互相连接的表 按连接列的值先排序,排序完后形成的结果集再互相进行合并连接提取符合条件的记录。相比嵌套循环连接,排序合并连接比较 适用于返回大数据量的结果。
排序合并连接在数据表预先排序好的情况下效率是非常高的,也比较 适用于非等值连接的情况,比如 > 、>= 、<= 等情况下的连接 (哈希连接只适用于等值连接)。由于排序操作的开销是非常消耗资源的,当结果集很大时排序合并连接的性能很差。
接前面的例子说明:
|
create index idx_t1_id on t1 ( id ); create index idx_t2_id2 on t2 ( id1 );
stat 100 on t1 ( id ); stat 100 on t2 ( id1 );
|
查询:
select /*+use_merge(a,b)*/ * from t1 a , t2 b
where a . id=b . id1
and a . id>1
and b . id1<6 ;
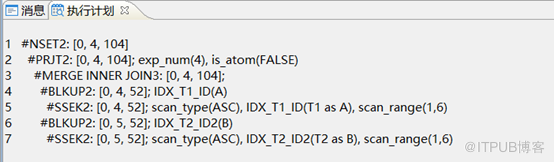
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69949798/viewspace-2680785/ ,如需转载,请注明出处,否则将追究法律责任。

