再有人问你O的SQL性能优化,这篇文章甩给他!
SQL优化对于数据库应用程序的性能、稳定性、可靠性、数据质量、开发效率和管理效率都具有重要意义,以下是给大家分享的一些技巧!
1.获取正确的执行计划
1.1 awr执行计划
select * from table(dbms_xplan.display_awr('&sql_id'));
--awr中记录的执行计划(多个)
1.2 share pool计划
select * from
table(dbms_xplan.display_cursor('&sql_id',null,'typical'));
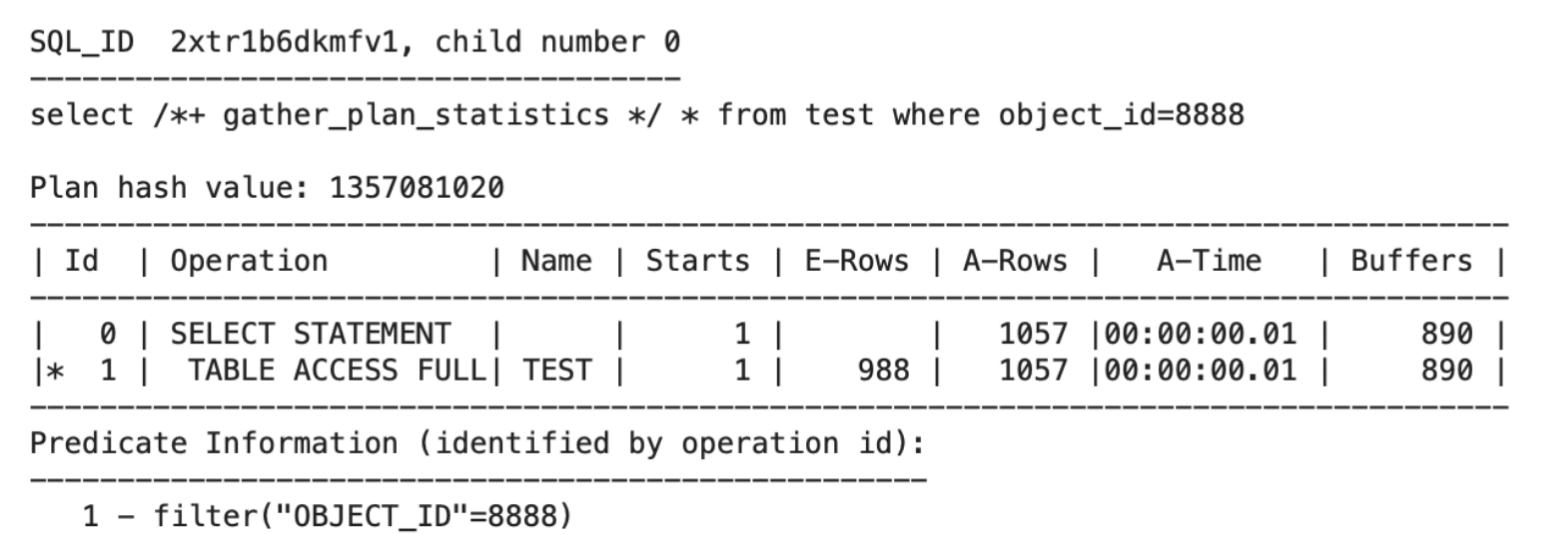
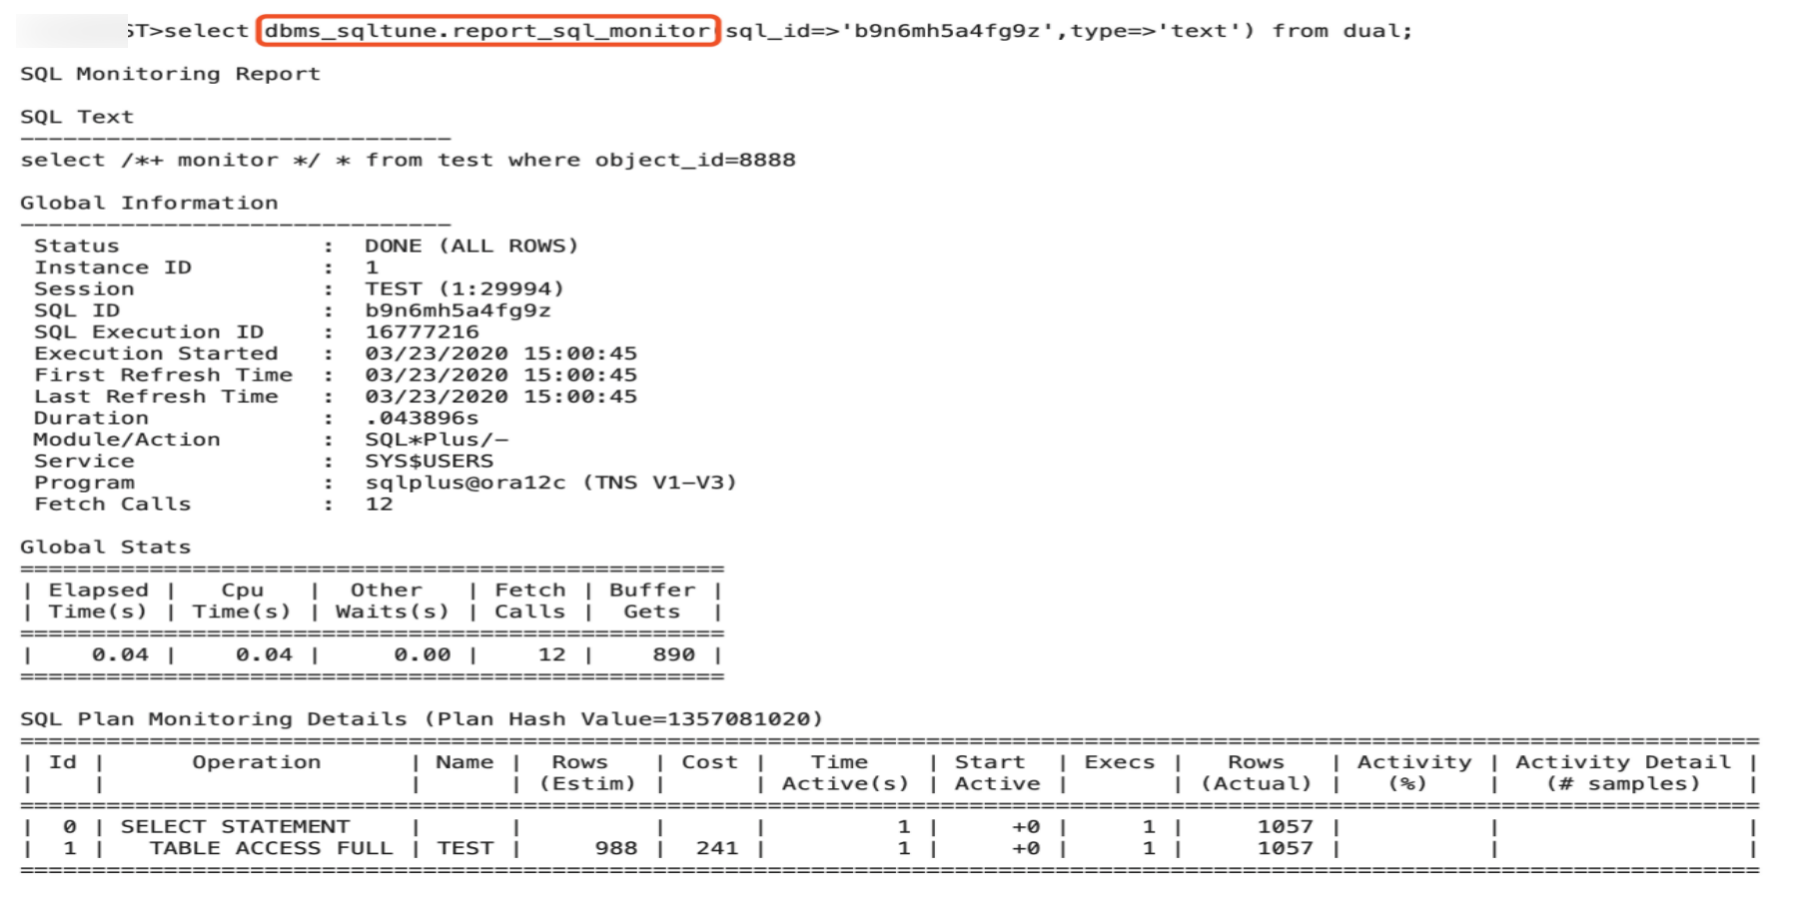
1.3.真实的资源消耗
SELECT
DBMS_SQLTUNE.REPORT_SQL_MONITOR(
sql_id=>'djpz68jy0wbgv',
type =>'TEXT',
report_level => 'ALL')
AS report FROM dual;
2.索引的应用
2.1 如何建索引
1.适合创建索引的列
索引覆盖、避免排序
复合索引尽量兼顾更多SQL
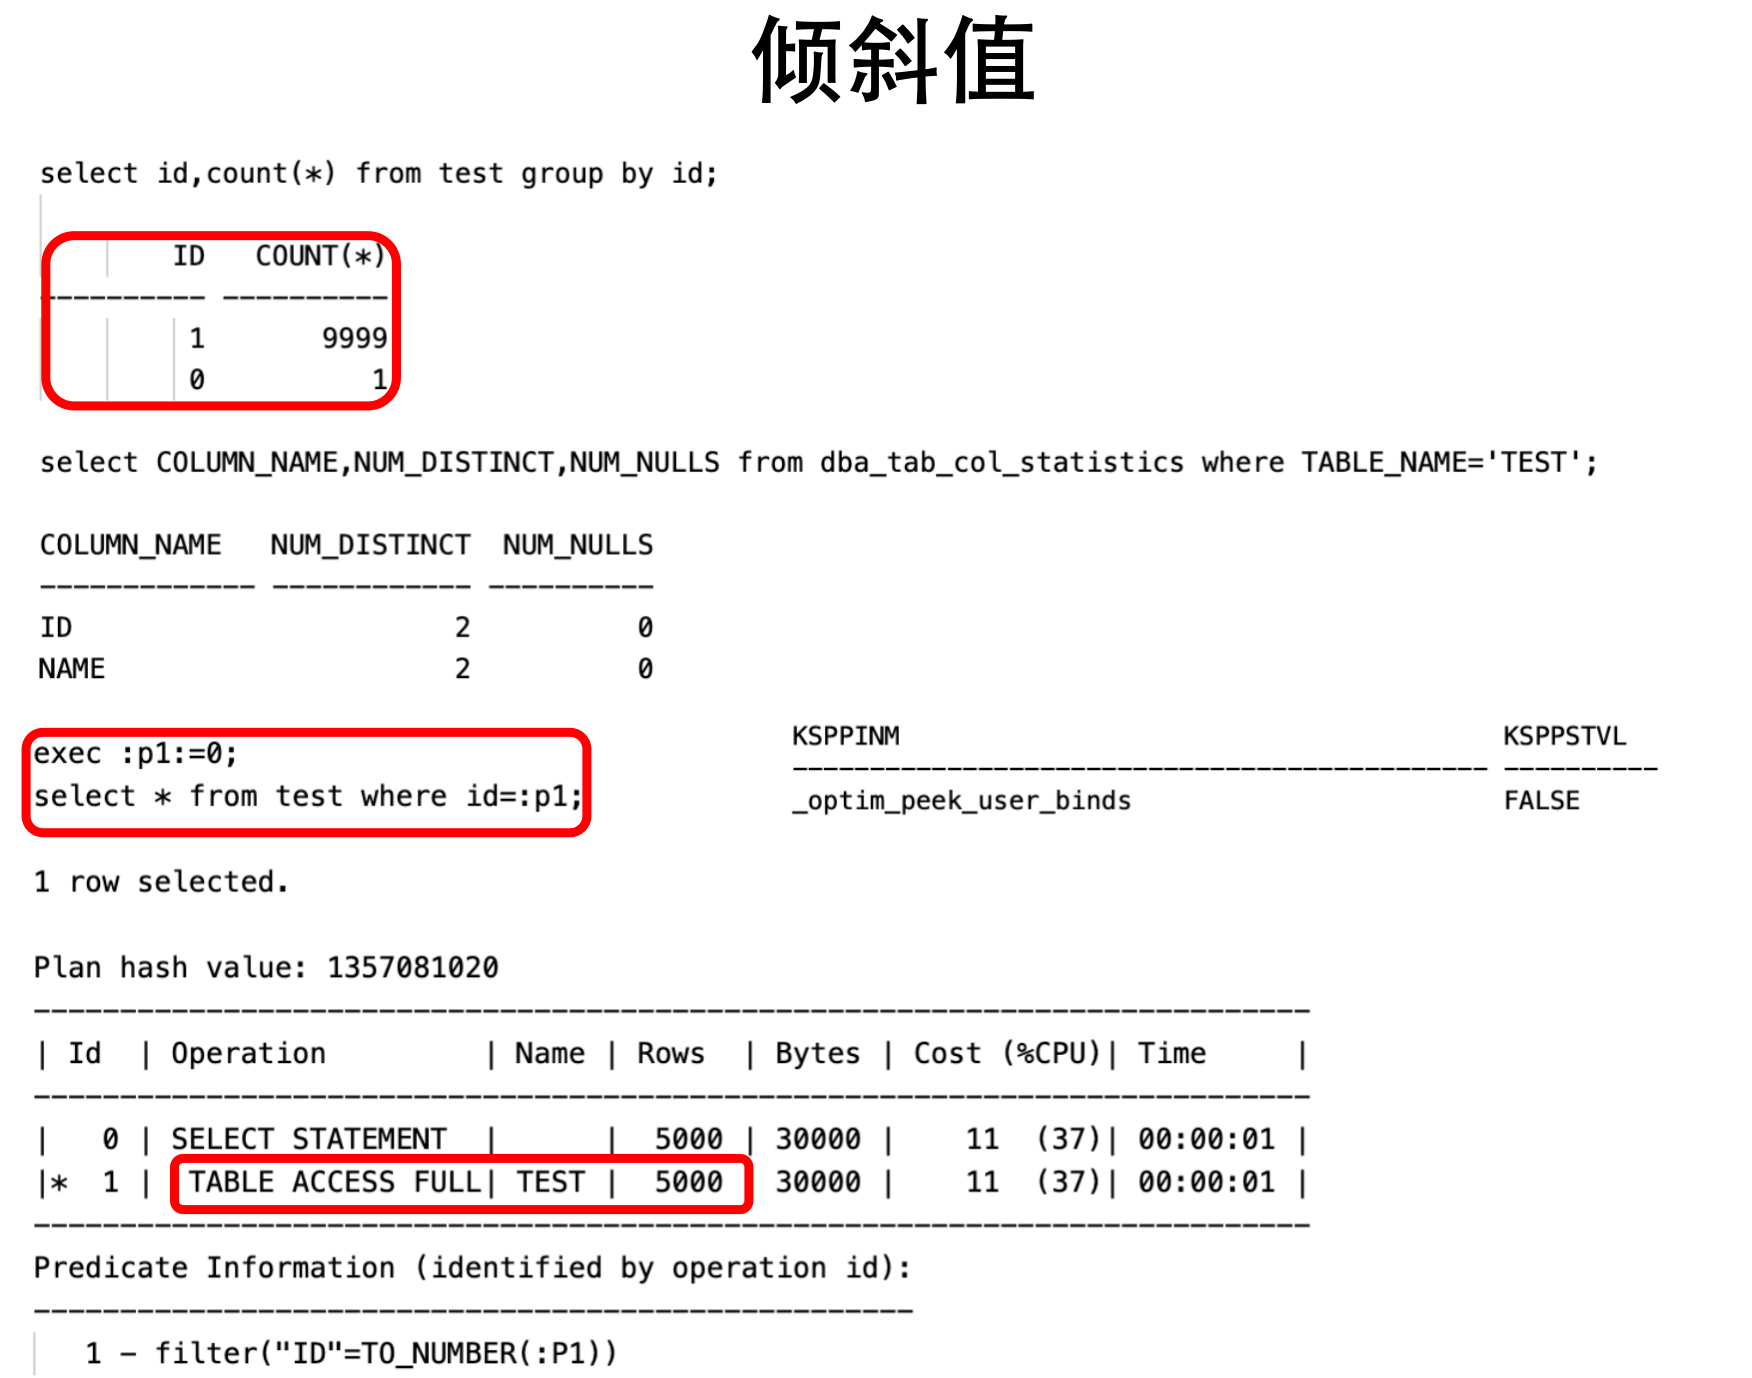
该列在表中的唯一性特别高或者有些状态列有倾斜值
等值谓词条件字段放在前面,非等值谓词条件字段放在后面
表关联使用Nested Loop 被驱动表的关联字段上建议创建索引
该SQL语句是主流的业务,具有高并发,where条件中出现的列
2.不适合创建索引的列
DML频繁的表不适合创建索引,索引会带来额外的维护成本
Where条件中不会使用的列也不适合创建索引
2.2 那种情况不走索引
1.统计信息不准
2.倾斜值
3.聚簇因子
4.隐式转换
5.条件列上存在运算符
6.索引状态
7.表很小
8.null值 要么where条件限制is not null
要么字段属性设为not null
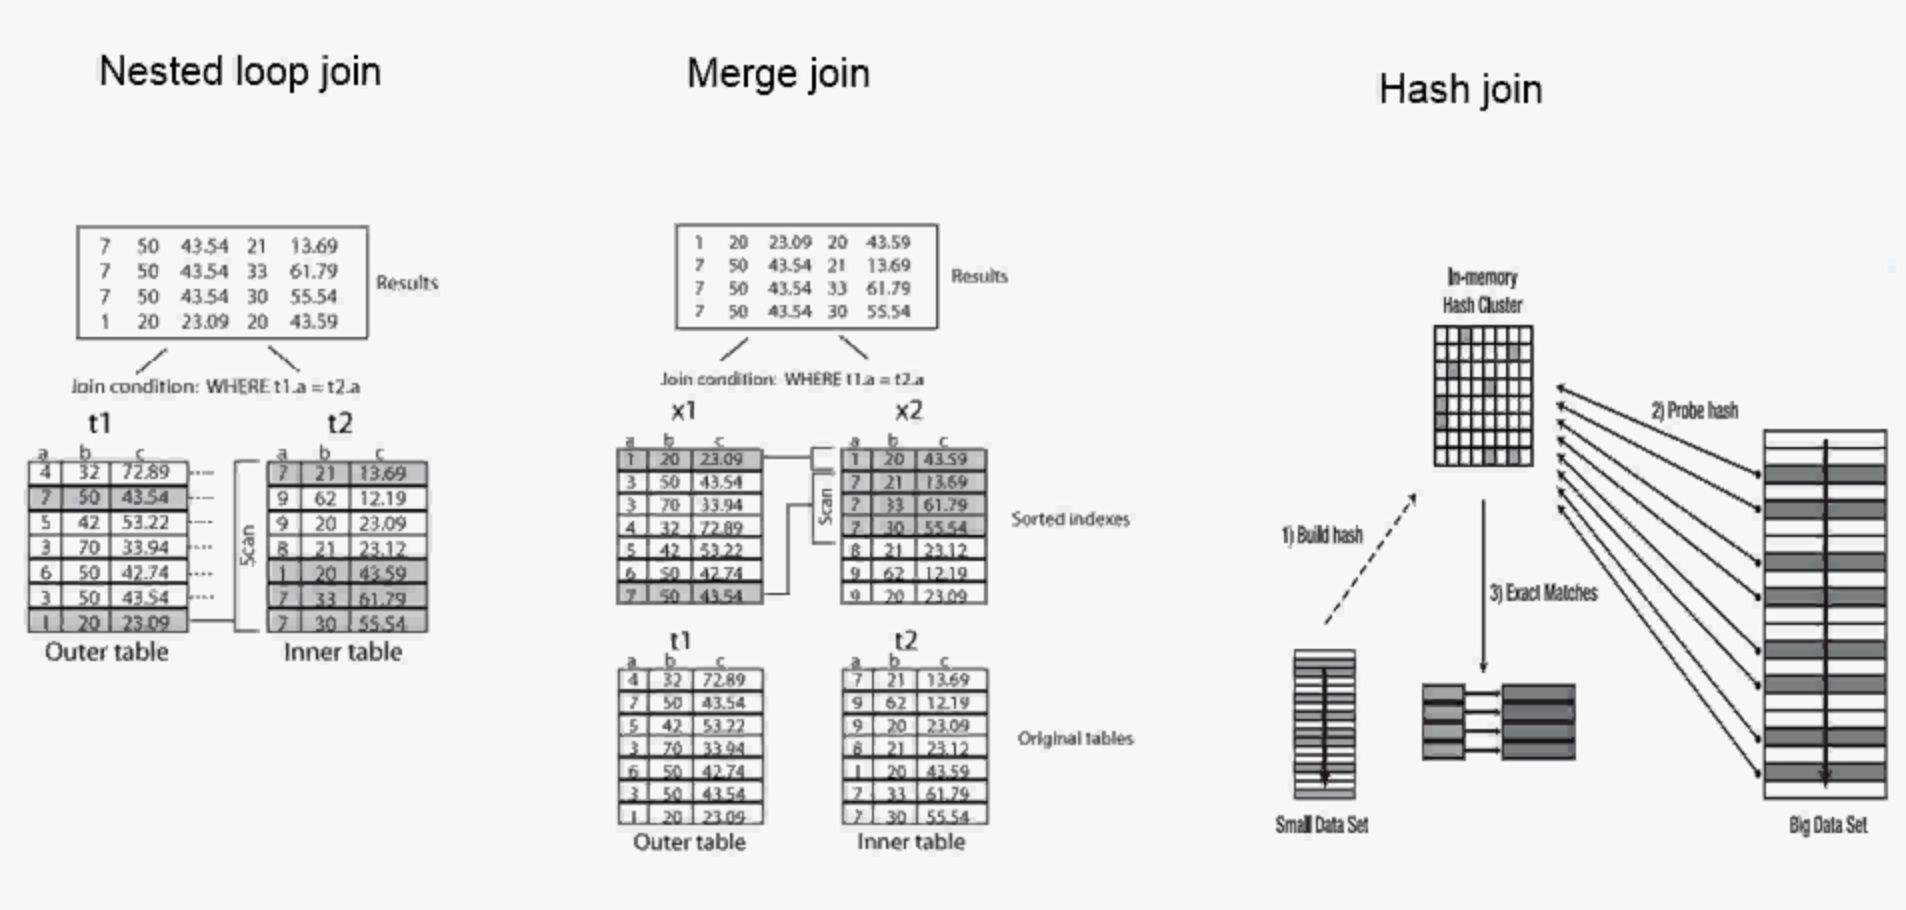
2.3 表连接
1.Nested Loops:每读一条驱动表的数据,就根据连接条件去被驱动表中查找对应的数据,直到读完驱动表所有数据为止。
一般用于驱动表小,被驱动表较大,且关联字段有索引的情况。
2.Hash Join:首先在内存根据连接条件生成一张hash表,然后再去扫描被驱动表,并将每行与hash表对比,找到所有匹配的行。
一般用于两个大表关联、查询小表大部分数据、相同数量级的表关联。
3.Sort Merge Join:将两个表的数据分别全部读取出来并排序,然后再根据连接条件合并。
3.绑定变量
如何查询已执行的目标SQL中绑定变量的值
V$SQL_BIND_CAPTUTE;
DBA_HIST_SQLBIND;
1.如果是绑定变量,选择率: 1/numdistinct
2.如果是是字面值,选择率:
有直方图:该字段某个具体值的1/数据记录
没有直方图:1/numdistinct
4.统计信息
该何时收集统计信息呢?
很难用一种收集策略而适合所有的情况。但对于一些有代表性的对象,我们可以制定相对更适合的收集策略。
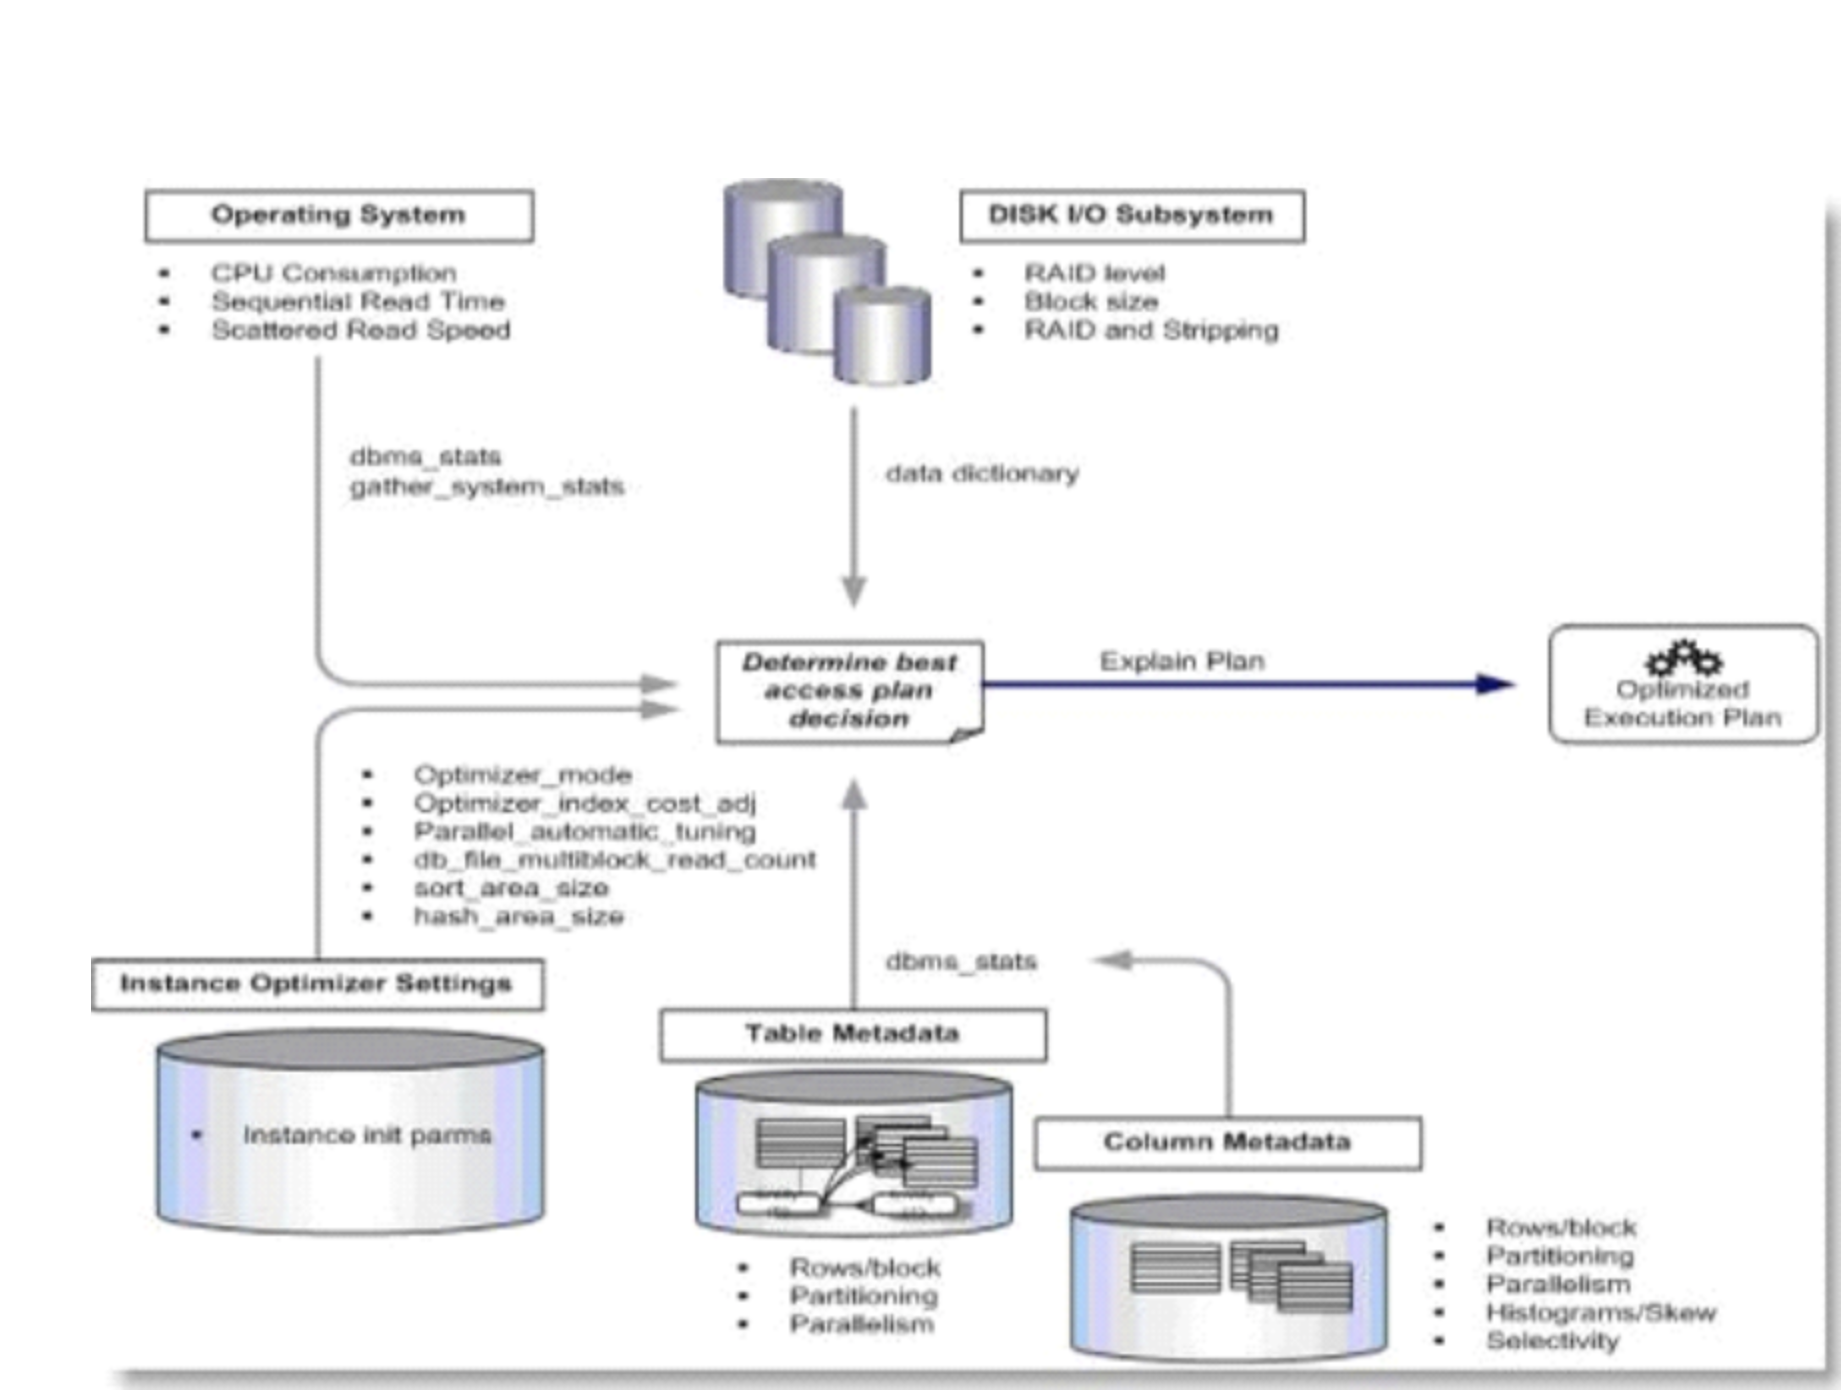
一、针对每天规律变化的表(插入的数据量和数据特征基本近似)
建议策略:使用数据库的自动收集任务。或者在收集了代表性的统计信息后,将该表的统计信息锁定,不再收集。但对于会列中的最大值或最小值出现变化,且该列还会出现在WHERE子句中时,就不适用锁定的方法了。
二、针对临时或每特定时间使用一次的中间表
建议策略:建议在完成数据准备后(通常是大量的插入或更新后),手动做一次统计信息的收集。或者在相关SQL中加入动态采样的提示(/*+ dynamic_sampling(<表别名> <采样级别>) */)。若可以确定有最适合的执行计划,可以在数据库层面做绑定或在SQL代码中加入提示来固定执计计划。
三、数据会出现大幅变化(指一段时间内,插入,更新和删除的行较多)
建议策略:若相关SQL较少(使用绑定变量会减少不一样SQL的数量),可以考虑使用动态采样的方法。若相关SQL较多,但绝大多数SQL可以在统计信息不再更新后,仍能生成正确的执行计划,那么可以考虑将相关表上的统计信息锁定,并针对极少数对统计信息的准确性敏感(比如前边提到的谓词越界的情况)的SQL做执行计划的绑定或固定。
总结
通过优化SQL语句,可以提高数据库的响应速度,降低系统资源的消耗,从而提升整体应用性能!优化是一个长期的持续的过程,分析TOP SQL、分析AWR报告、定期对数据库进行巡检至关重要!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69947868/viewspace-3026229/ ,如需转载,请注明出处,否则将追究法律责任。

