向量数据库PGVECTOR,AI浪潮下崛起的新秀!
📣 1.序言
>自从OpenAI推出了全新的对话式通用人工智能工具——ChatGPT,
ChatGPT 表现出了非常惊艳的语言理解、生成、知识推理能力,
ChatGPT 的横空出世拉开了大语言模型产业和生成式AI产业蓬勃发展的序幕,
大模型作为新一代的AI处理器,提供了数据处理能力;
而向量数据库提供了存储能力,成为大模型时代的重要基座。
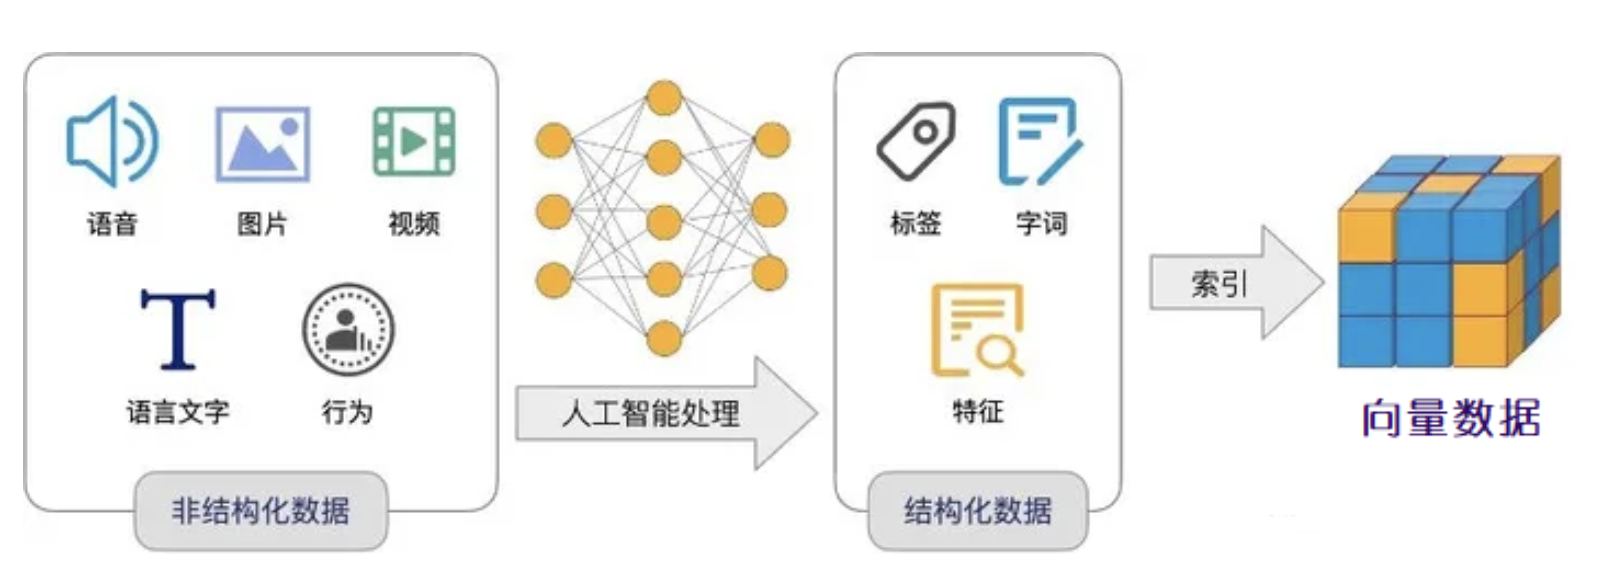
📣 2.向量数据库
数据库有事务处理(OLTP)与数据分析(OLAP)两大核心场景,
向量数据库自然也不例外。典型的事务处理场景包括:知识库,问答,推荐系统,人脸识别,图片搜索,等等等等。
知识问答:给出一个自然语言描述的问题,返回与这些输入最为接近的结果;
以图搜图:给定一张图片,找出与这张图片在逻辑上最接近的其他相关图片。
这些功能说到底都是一个共同的数学问题:向量最近邻检索(KNN):
给定一个向量,找到距离此向量最近的其他向量。
向量数据库的主要应用场景:
1.人脸识别
向量数据库可以存储大量的人脸向量数据,
并通过向量索引技术实现快速的人脸识别和比对。
2.图像搜索
向量数据库可以存储大量的图像向量数据,
并通过向量索引技术实现快速的图像搜索和相似度匹配。
3.音频识别
向量数据库可以存储大量的音频向量数据,
并通过向量索引技术实现快速的音频识别和匹配。
4.自然语言处理
向量数据库可以存储大量的文本向量数据,
并通过向量索引技术实现快速的文本搜索和相似度匹配。
5.推荐系统
向量数据库可以存储大量的用户向量和物品向量数据,
并通过向量索引技术实现快速的推荐和相似度匹配。
6.数据挖掘
向量数据库可以存储大量的向量数据,
并通过向量索引技术实现快速的数据挖掘和分析。
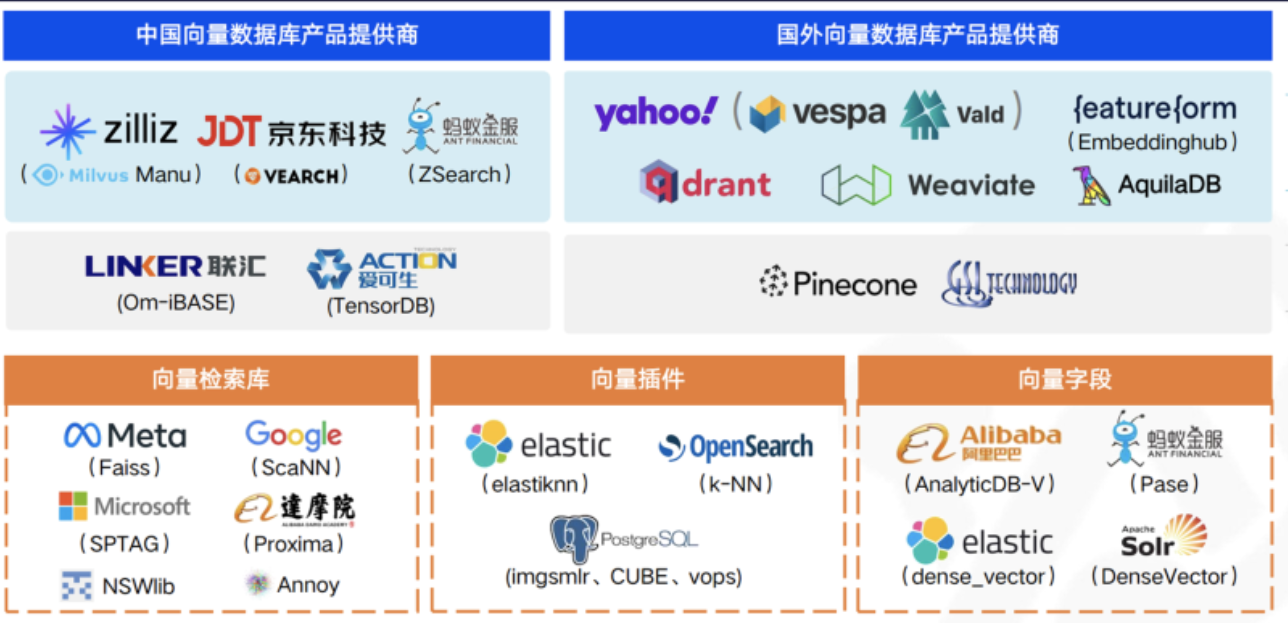
📣 3.向量插件PGVECTOR
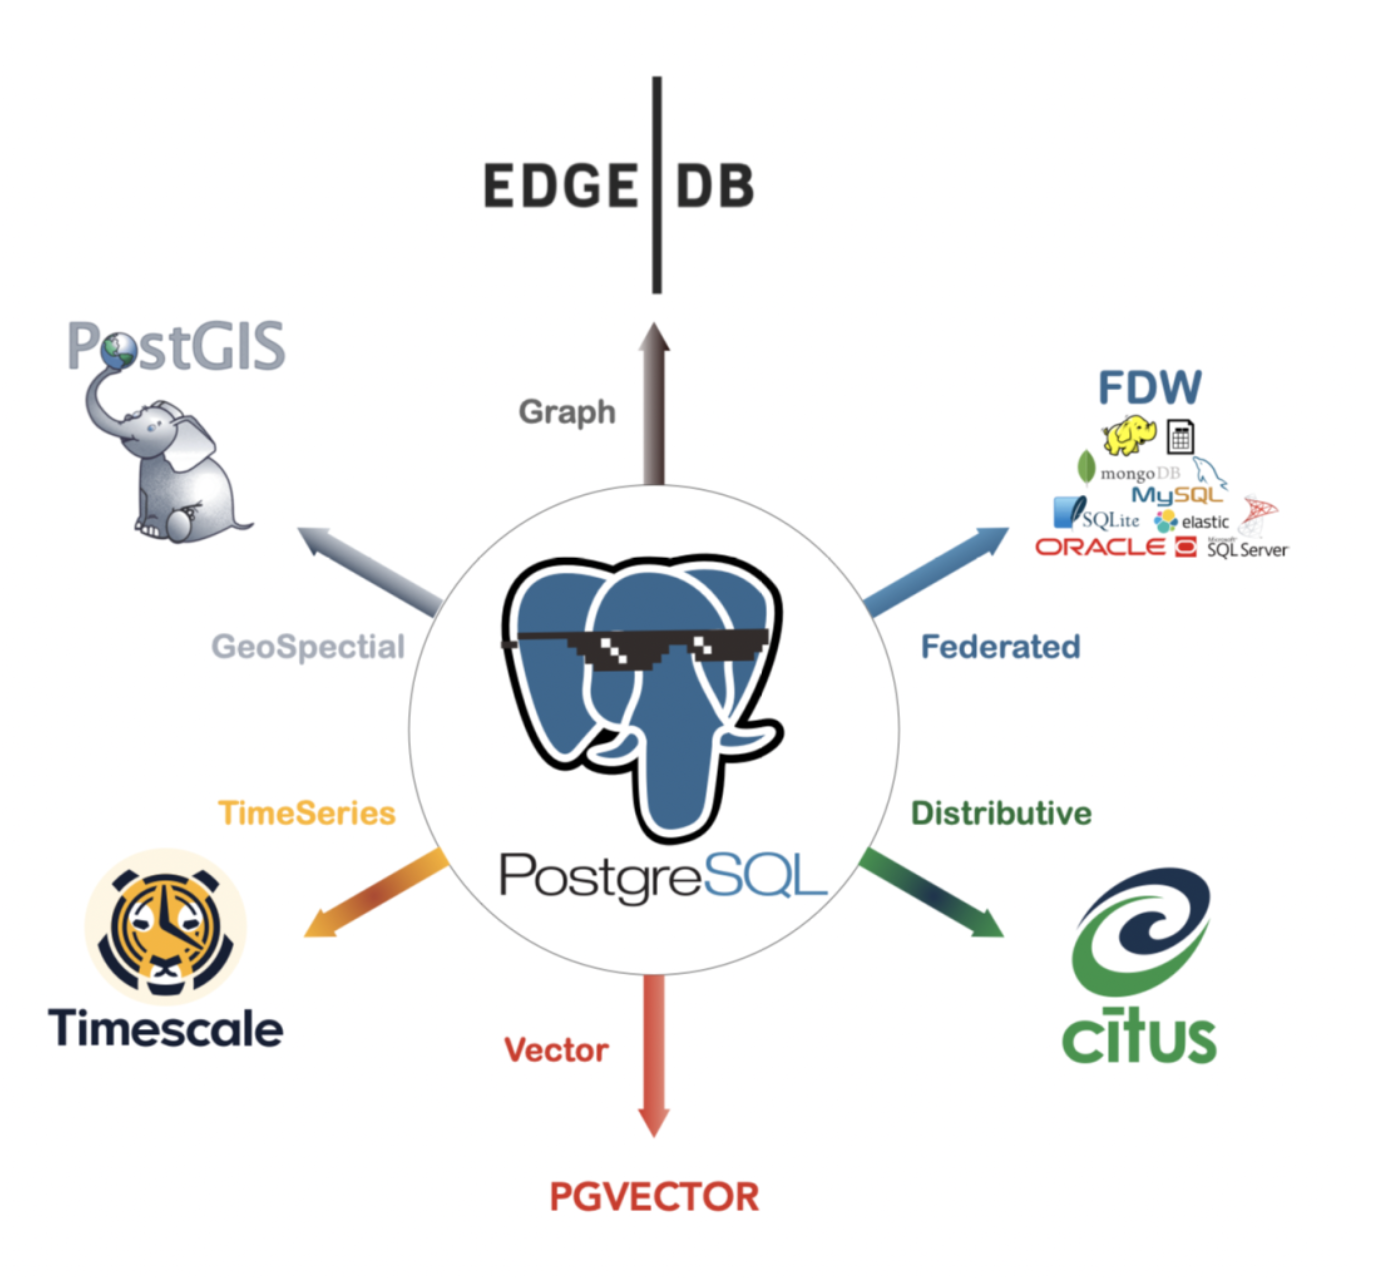
>在所有现有向量数据库中,pgvector是一个独特的存在 ——
它选择了在现有的世界上最强大的开源关系型数据库 PostgreSQL 上以插件的形式添砖加瓦,
而不是另起炉灶做成另一个专用的“数据库” pgvector有着优雅简单易用的接口,
不俗的性能表现,更是继承了PG生态的超能力集合。
📣 4.PGVECTOR安装
1.配置yum源
yum install -y
2.编译安装
# 先安装git(如果已安装,跳过)
yum install -y git
# 切换到/tmp目录,下载源码包,我这里选择是目前最新版本0.5.1
cd /tmp
git clone --branch v0.6.0
# 进入/tmp/pgvector目录,进行编译安装
cd pgvector
make & make install
3.安装vector扩展
# 创建demo数据库
create database demo;
# 切换到demo数据库
\c demo
# 安装vector扩展
CREATE EXTENSION vector;
# 创建测试表
CREATE TABLE test (id bigserial PRIMARY KEY, embedding vector(3));
# 插入测试数据
INSERT INTO test (embedding) VALUES ('[1,2,3]'), ('[4,5,6]');
# 按与给定向量相似度(L2 distance)排序,显示前5条
SELECT * FROM test ORDER BY embedding <-> '[3,1,2]' LIMIT 5;
📣 5.PGVECTOR实践
✨ 5.1 知识检索
用一个简易的 Python 小脚本,
就可以制作一个全文模糊检索的命令行小工具
# !/usr/bin/env python3
from text2vec import SentenceModel
from psycopg2 import connect
model = SentenceModel('shibing624/text2vec-base-chinese')
def query(question, limit=64):
vec = model.encode(question) # 生成一个一次性的编码向量,默认查找最接近的64条记录
item = 'ARRAY[' + ','.join([str(f) for f in vec.tolist()]) + ']::VECTOR(768)'
cursor = connect('postgres:///').cursor()
cursor.execute("""SELECT id, txt, vec <-> %s AS d FROM sentences ORDER BY 3 LIMIT %s;""" % (item, limit))
for id, txt, distance in cursor.fetchall():
print("%-6d [%.3f]\t%s" % (id, distance, txt))
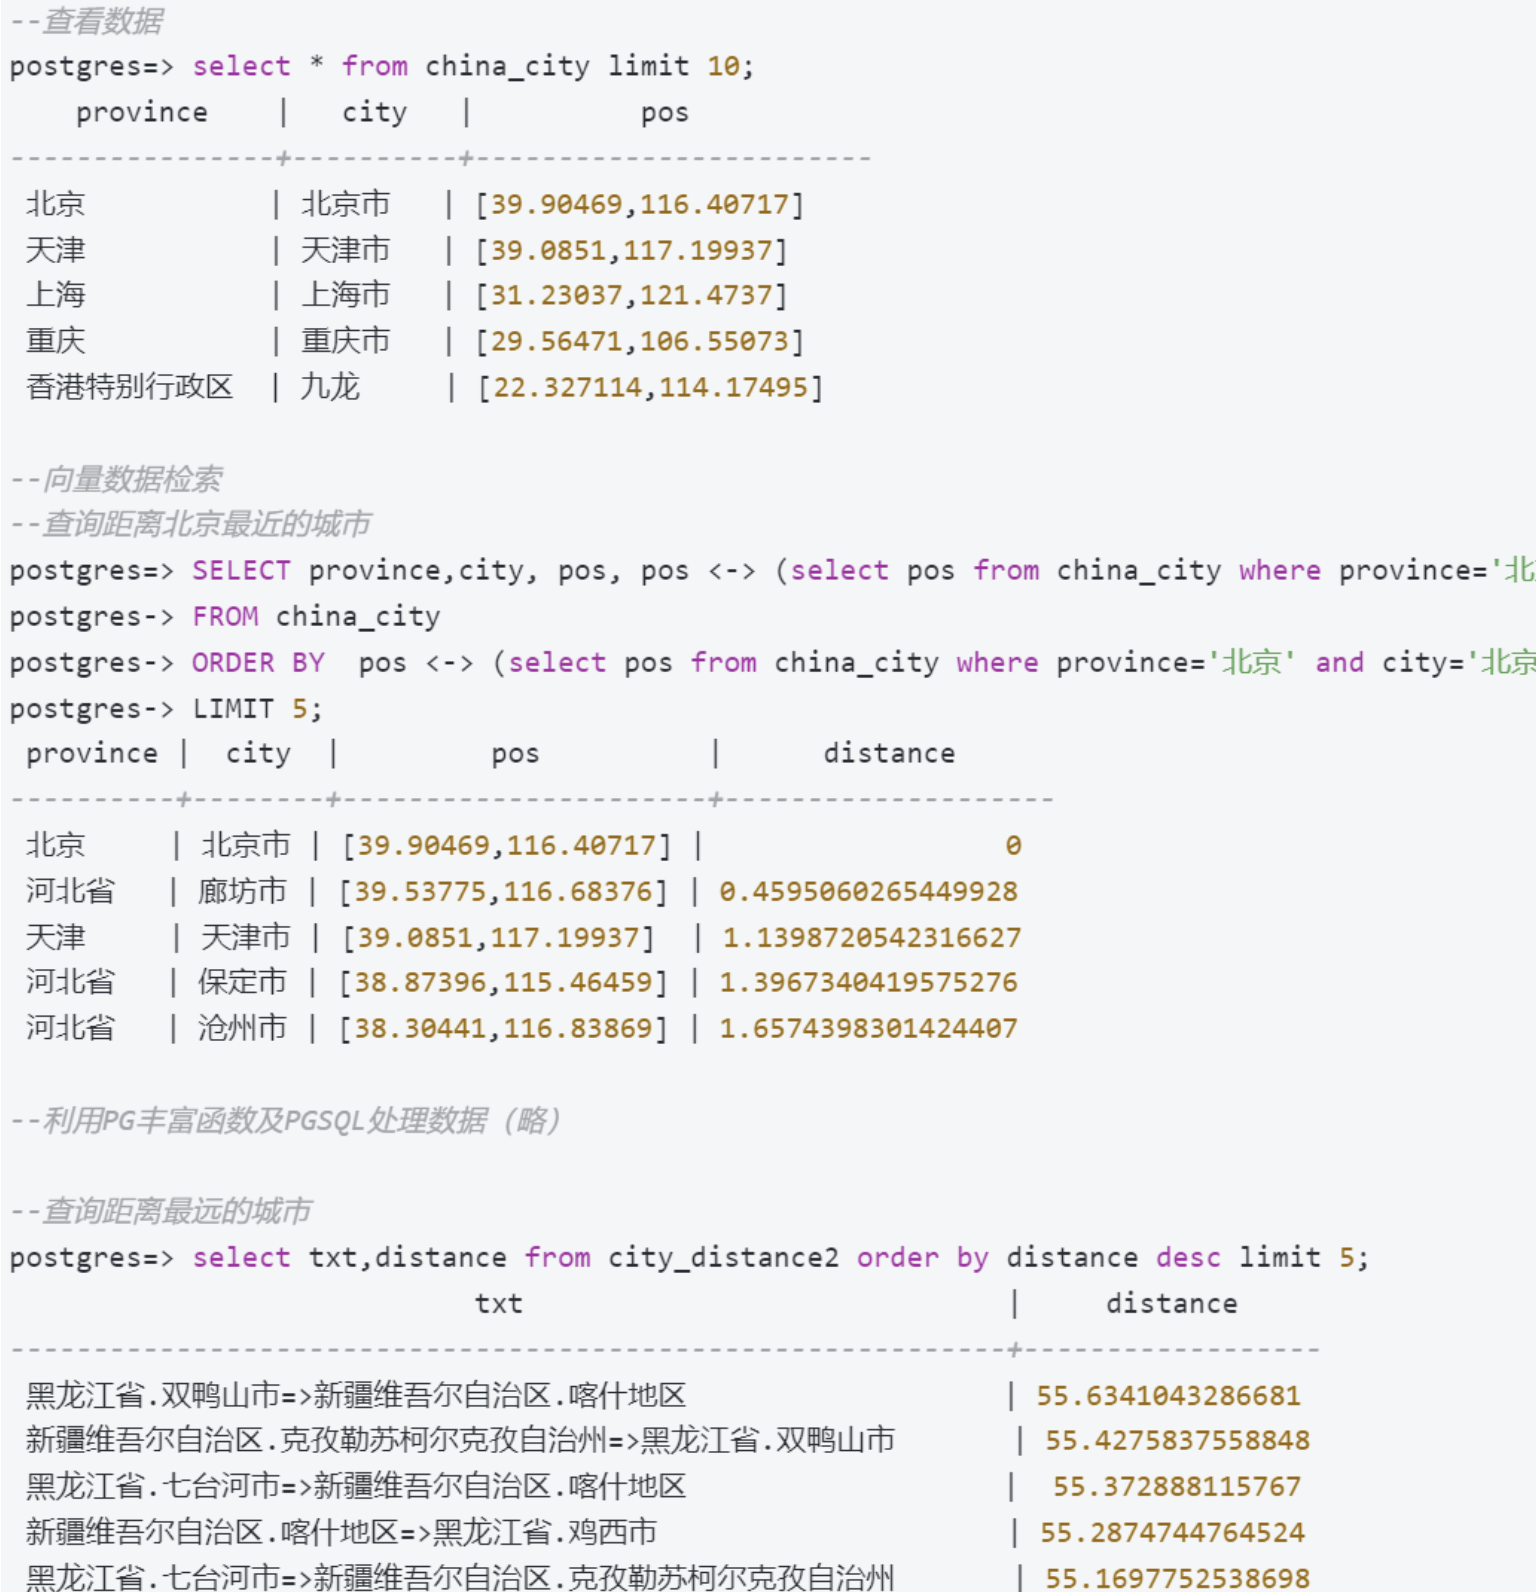
✨ 5.2 距离定位
📣 6.总结
>向量数据库是一个非常有前景和潜力的行业,相信未来随着AI技术的不断发展,
向量数据库也必将迎来更加广阔的发展空间。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69947868/viewspace-3009634/ ,如需转载,请注明出处,否则将追究法律责任。

