GreatDB 数据库关键技术介绍
- 水平拆分:支持数据sharding和分布式部署
- 动态扩展:支持动态扩容,数据在线重分布
- 故障恢复:故障自动切换保证系统高可用性
- 分布式事务:提供ACID分布式事务支持
- 数据安全:提供企业级数据安全特性,例如安全审计,访问控制
- MySQL协议:完美适配mysql,继承mysql生态
- SQL语法兼容:支持视图、触发器、存储过程、自定义函数等对象
- 并行计算:基于分布式部署,通过分布式并行实现高性能
- HTAP融合:实现基于内存计算的TP与AP混合负载支撑
- 云化支持:支持OpenStack、容器、物理机等多种部署模式
- 国产硬件支持:支持国产软硬件龙芯、飞腾、鲲鹏、海光,中标麒麟芯片、银河麒麟、深之度、统一操作系统。
产品架构
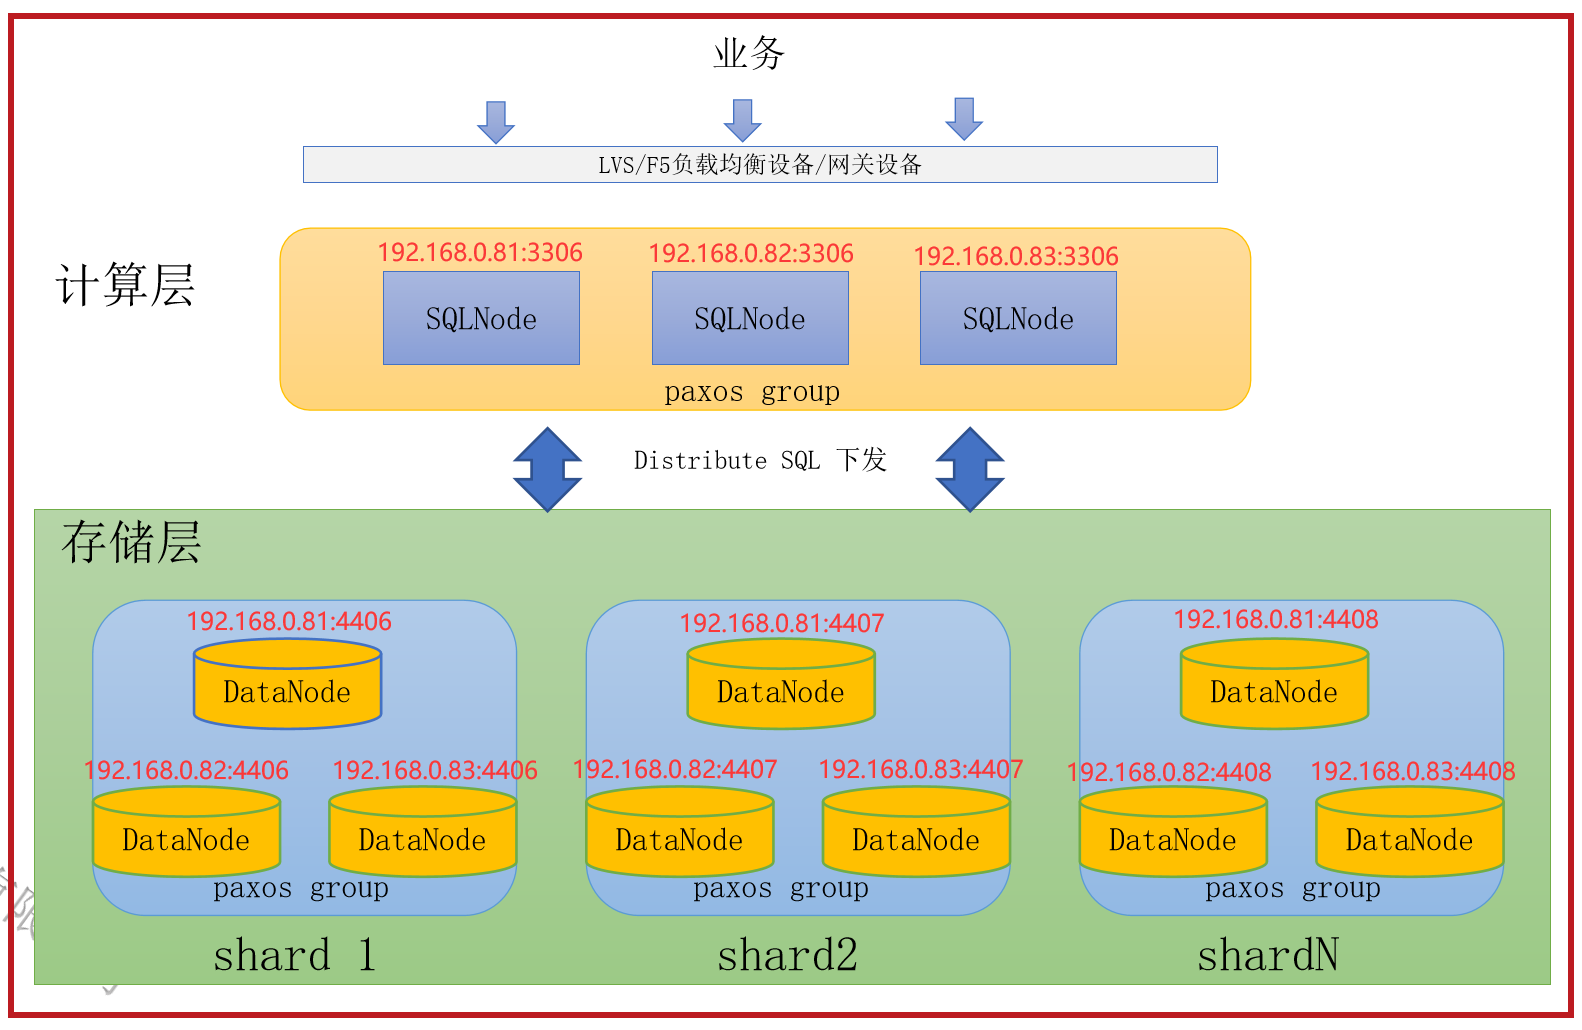
GreatDB Cluster 采⽤了⽆共享(share-nothing)且计算和存储分离的架构设计,计算层由SQL节点 GreatSQL 组成,存储层由数据节点 GreatDB 组成。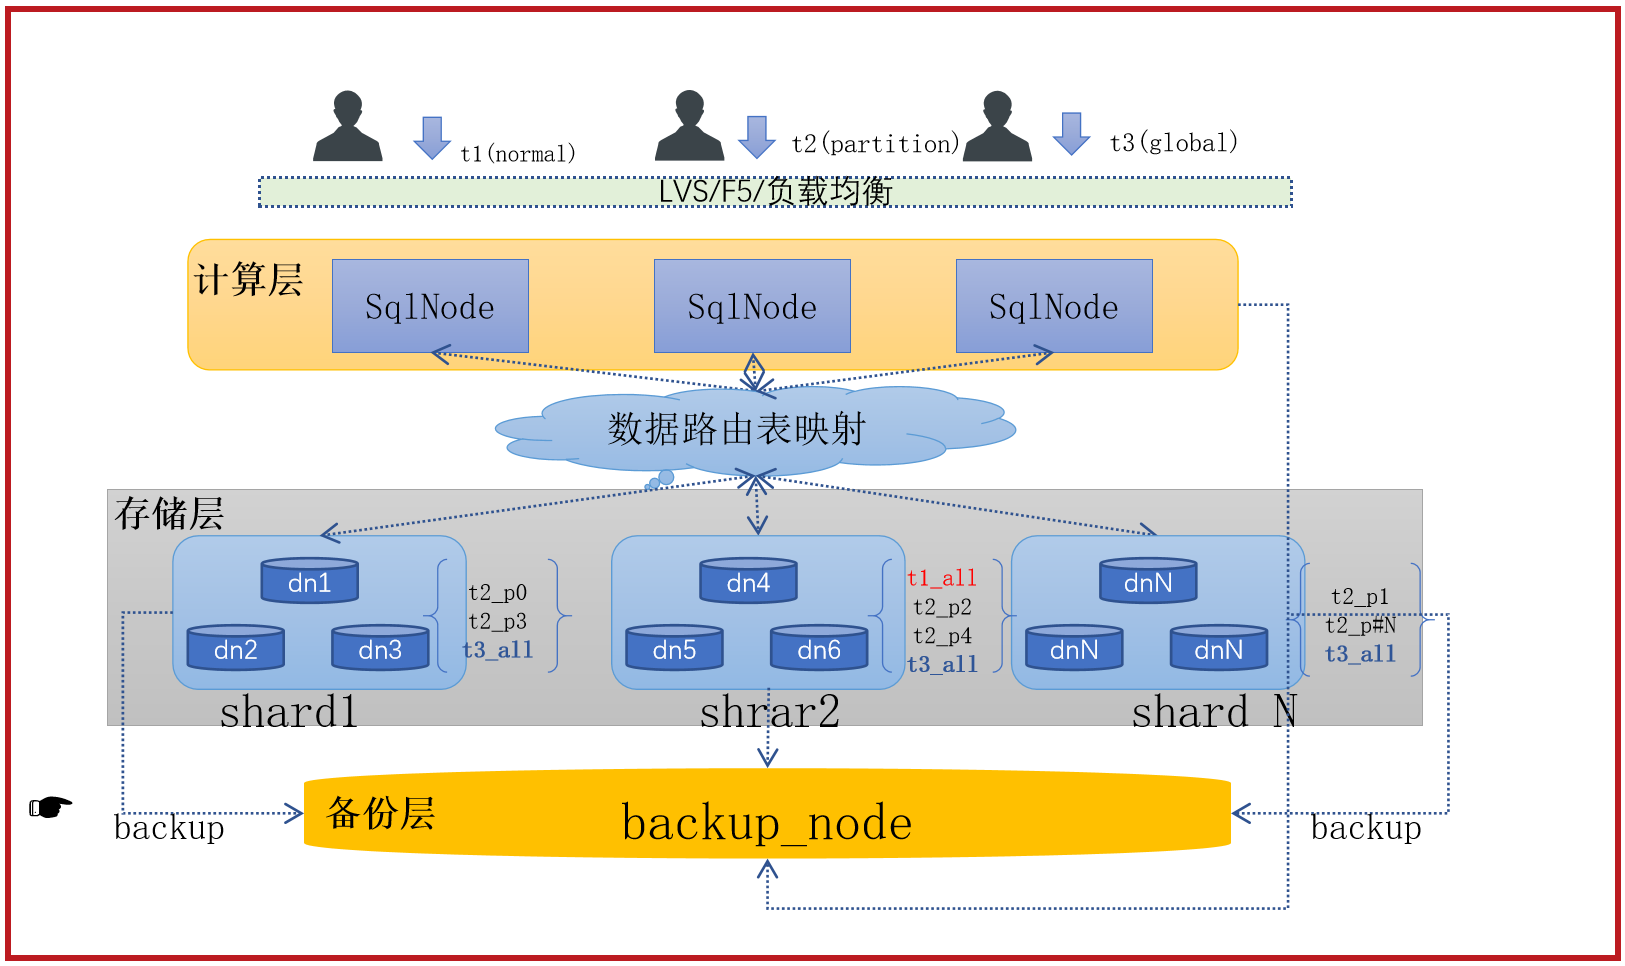
- GreatSQL: SqlNode节点。⽤于接收、处理⽤户请求,维护集群元数据,管理集群状态。
- GreatDB: DataNode节点,⽤于接收SQL节点的请求,进⾏简单的数据存取的操作;维护数据副本强⼀致性。
- 多个 GreatSQL 组成了计算层,计算层中的集群元数据通过 paxos 协议进⾏同步。
- 存储层以 shard 进⾏数据分⽚管理,同⼀个 shard 内的多个 GreatDB 组成⼀个 paxos 复制组,维护同⼀份数据,不同的 shard 之间数据⽆重叠。
SqlNode 节点
SqlNode 节点包含如下模块:
- GreatDB计算引擎,兼容MGR多主模式。
- 连接管理: 负责接受⽤户的连接、登陆请求。
- SQL解析: 将⽤户请求的SQL,解析成内部 parse tree 的格式。
- 计划⽣成: 根据表元数据信息和统计信息,⽣成最优执⾏计划。
- 执行SQL或SQL下推:根据执⾏计划,操作 DataNode,进⾏数据的获取与写⼊。
- Sequence,SqlNode/DataNode/backup_node 增删调整,配置执行。
DataNode 节点
⽤户数据存储在 DataNode 节点,节点间通过 paxos 协议保证⽤户数据的多副本的强⼀致性。GreatDB Cluster 的 DataNode 不仅仅是存储数据,本⾝具有相对完整的计算能⼒,可以进⾏较强的运算,分担计算层的计算压⼒。
- 主数据节点接收上层 SqlNode 下发命令。
- DataNode 为 Shard 的成员,一个 Shard 分片为一个 Paxos group 复制组。
- 存储节点层标准的一个 Shard 组为1主2从结构。
- Shard 内部存储表和本地索引数据,Shard 支持在线扩容、缩容。
- 扩缩容操作可以在新增 Shard 和原始 Shard 之间进行数据重分布。
- 故障自动切换,自身具备一定的健壮性。
GreatDB 分布式关系型数据库安装部署(三种安装方式,任选其一,推荐使用Ansible部署)
软硬件环境建议配置
GreatDB Cluster可以很好的部署和运⾏在 Intel 架构服务器环境、ARM 架构的服务器环境及主流虚拟化 环境,并⽀持绝⼤多数的主流硬件⽹络。作为⼀款⾼性能数据库系统。⽀持主流的Linux操作系统。
Linux 操作系统版本要求
服务器建议配置
- 开发及测试环境
SQL节点最⼩数量为3,最好配置成奇数个,如3,5,7。
数据节点个数建议为3的整数倍。每个shard内3副本。
- ⽣产环境
SQL节点最⼩数量为3,最好配置成奇数个,如3,5,7。SQL节点存储集群元数据,同时承担⼤部分计算任务,有些优化策略会⽣成临时表,故如果⽤户对性能要求很⾼,可以配置SSD。
数据节点最⼩数量为3,⼀个shard内最⼩副本数为3,最⼤副本数为9,推荐⼀个逻辑shard内副本个数为3。
BIOS 设置
- 选择 Performance Per Watt Optimized(DAPC) 模式,发挥 CPU 最大性能
- 关闭 C1E 和 CStates 等选项,目的也是为了提升 CPU 效率
- Memory Frequency(内存频率)选择 Maximum Performance(最佳性能)
- 内存设置菜单中,启用 Node Interleaving,避免NUMA问题
- 关闭 SMMU (非虚拟化场景使用),重启服务器过程中,进入 BIOS–MISC Config–Support Smmu 设置为 Disable
- 关闭预读,重启服务器过程中,进入BIOS–MISC Config–CPU Prefetching Configuration 设置为 Disabled
- 关闭 RAID 卡的预读一般配置项为 Read Policy,
- 经测试单机 GreatDB,将 stripe size 从 256k 调整到 64k,依据并发度的不同,性能提升有10%-25%
调整 CPU 模式
数据库服务器的CPU运⾏模式需要调整到 performance 模式,以追求⽐较稳定的性能。
以 centos7 为例,执⾏以下命令检查和设置 cpu 运⾏模式:
# 检查当前cpu模式,发现是 powersave 模式
[root@greatdb-test-01 ~]# cpupower frequency-info
...
available cpufreq governors: performance powersave
...
# 设置CPU为 performance 模式
[root@greatdb-test-01 ~]# cpupower frequency-set -g "performance"
# performance 模式检查
[root@greatdb-test-01 ~]# cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor
performance
注:如果该步报文件不存在,则需要安装 kernel-tools
# CentOS 安装 kernel-tools
yum install kernel-tools -y
# Ubuntu 安装 CPU 模式无图形化切换器
apt install cpufrequtils
文件系统
建议使用xfs高性能文件系统
Linux ext系列的文件系统,应该是文件系统史上非常经典的杰作。在CentOS 7之前都是默认采用的这一系列文件系统。但是从CentOS 7开始默认的文件系统变成了xfs文件系统,在操作系统支持的情况下,选择顺序如下 xfs>ext4>ext3
io调度参数调整
修改 /sys/block/sda/queue/scheduler 调整io调度配置
如果是机械硬盘建议调整成 deadline
如果是 SSD&PCI-E 建议调整成 noop
配置拓扑结构
最⼩部署拓扑结构
最⼩部署拓扑结构⽤于个⼈快速尝试新功能,可以将所有的节点部署在⼀台服务器上,3个SQL节点,2个shard,每个shard内3个数据节点。具体的部署拓扑图如下: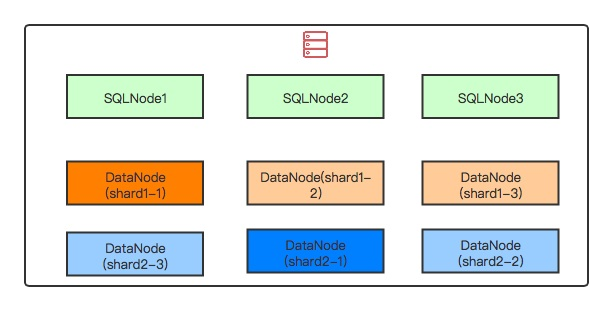
开发及测试环境部署拓扑,下面的部署测试使用的是这种拓扑
开发及测试环境⽤于团队⻓期开发或者团队内部⻓期进⾏功能测试的场景,不适合⾼性能场景。 下⾯以总共3台服务器,SQL节点与数据节点共⽤的情况,给出部署拓扑图。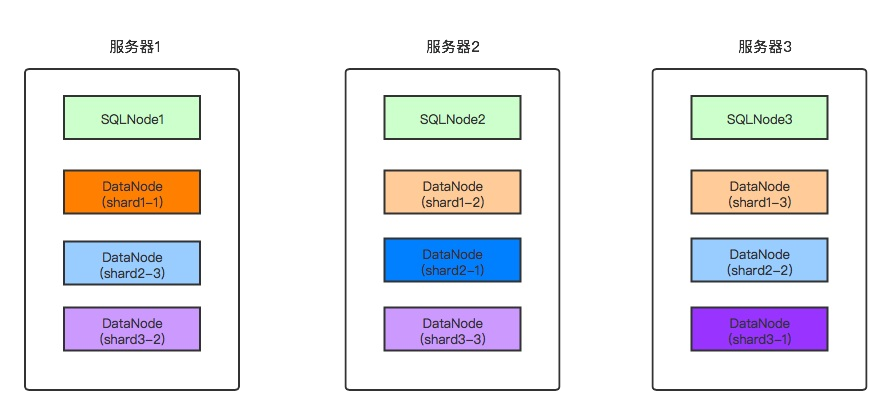
⽣产环境部署拓扑
下⾯以总共6台服务器,3台计算服务器,3台存储服务器的场景,给出部署架构图。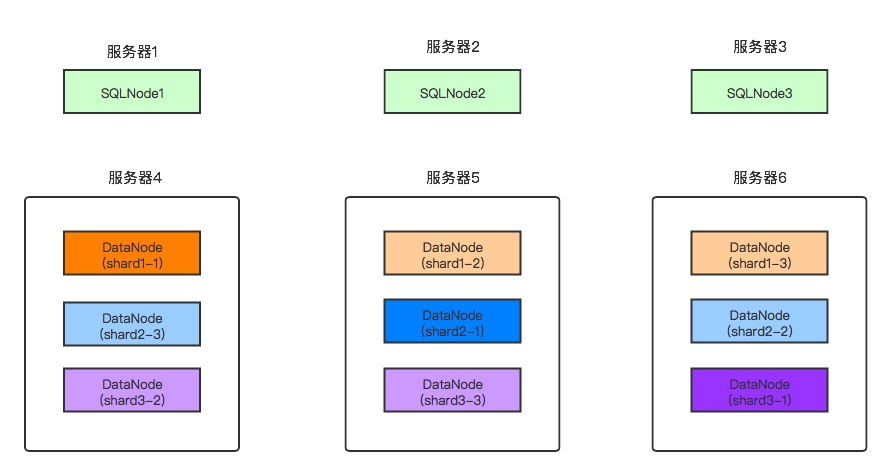
本次实验架构图
安装前准备(所有节点)
- 关闭操作系统防火墙和NetworkManager,使用Ansible部署会自动关闭防火墙
systemctl stop firewalld.service
systemctl disable firewalld.service
systemctl stop NetworkManager.service
systemctl disable NetworkManager.service
- 关闭SELINUX,使用Ansible部署会自动关闭SELINUX
sed -i "s/SELINUX=enforcing/SELINUX=disabled/g" /etc/selinux/config
setenforce
- 设置时区和时间,有条件的配置时间同步,使用Ansible部署会自动配置时区为 Asia/Shanghai
cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime

date -s "20201021 09:43:00"

[root@enmo ~]# timedatectl
      Local time: Wed 2020-10-21 09:43:04 CST
  Universal time: Wed 2020-10-21 01:43:04 UTC
        RTC time: Wed 2020-10-21 09:43:10
       Time zone: Asia/Shanghai (CST, +0800)
     NTP enabled: n/a
NTP synchronized: no
 RTC in local TZ: no
      DST active: n/a
- 配置系统内核参数,看心情配置吧
cat >> /etc/sysctl.conf << EOF
# for GreatDB
kernel.shmall = 965378       # expr `free |grep Mem|awk '{print $2 *1024}'` / `getconf PAGE_SIZE`
kernel.shmmax = 3954188288   # free |grep Mem|awk '{print $2 *1024}'
kernel.shmmni = 4096
kernel.sem = 50100 64128000 50100 1280
fs.file-max = 76724200
net.ipv4.ip_local_port_range = 9000 65000
net.core.rmem_default = 1048576
net.core.rmem_max = 4194304
net.core.wmem_default = 262144
net.core.wmem_max = 1048576
net.ipv4.tcp_tw_recycle = 1
net.ipv4.tcp_max_syn_backlog = 819200
net.core.netdev_max_backlog = 400000
net.core.somaxconn=4096
vm.overcommit_memory =
fs.aio-max-nr = 40960000
net.ipv4.tcp_timestamps =
vm.dirty_ratio=10
vm.dirty_background_ratio=10
vm.dirty_writeback_centisecs=100
vm.dirty_expire_centisecs=500
vm.swappiness=1
vm.min_free_kbytes=524288
EOF

sysctl -p
- 配置资源限制,使用Ansible部署会自动加入 “greatdb - nofile 655350”
cat >> /etc/security/limits.conf << EOF
# for GreatDB
* soft    nofile  1048576
* hard    nofile  1048576
* soft    nproc   unlimited
* hard    nproc   unlimited
* soft    core    unlimited
* hard    core    unlimited
* soft    memlock unlimited
* hard    memlock unlimited
EOF

# 使用Ansible部署会自动配置 /etc/pam.d/login
cat >> /etc/pam.d/login << EOF
# for GreatDB
session    required     pam_limits.so
EOF
- 优先选用xfs文件系统,及挂载优化
#/etc/fstab
/dev/sdb /data xfs defaults,noatime,nodiratime,nobarrier,inode64
不记录对象访问、创建、修改时间戳信息,减少日志写入提高磁盘 IO 的效率、提升文件系统的性能
- 设置CPU最大性能模式
数据库服务器的CPU运⾏模式需要调整到 performance 模式,以追求⽐较稳定的性能。
cpupower frequency-set -g "performance"  # 调整设置
cpupower frequency-info  # 查询、确认设置
- 安装系统依赖包,使用Ansible部署会自动安装
[root@greatdb1 ~]# yum install -y numactl-devel
GreatDB Cluster 服务器程序依赖 libaio 库
[root@greatdb1 ~]# yum search libaio
[root@greatdb1 ~]# yum install -y libaio-devel
GreatDB Cluster 客户端程序依赖 libncurses 库
[root@greatdb1 ~]# yum search ncurses
[root@greatdb1 ~]# yum install -y ncurses-devel
安装方式一,通过 GreatDB-Ansible 一键部署
安装 Ansible
[root@greatdb1 ~]# rpm -Uvh http://mirrors.ustc.edu.cn/epel/epel-release-latest-7.noarch.rpm
[root@greatdb1 ~]# yum install -y epel-release
[root@greatdb1 ~]# yum install -y ansible
上传安装包
[root@greatdb1 ~]# ll
total 591188
-rw-r--r--. 1 root root    174080 Feb 25 07:08 greatdb-ansible.tar
-rw-r--r--. 1 root root 605194964 Feb 25 07:08 greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz
解压 greatdb-ansible.tar
[root@greatdb1 ~]# tar -xvf greatdb-ansible.tar
配置 ansible
- 配置 inventory/deploy.ini
安装部署时,配合deploy.yml使用;卸载清除时,配合clearnup.yml使用。
[root@greatdb1 ~]# cat greatdb-ansible-master/inventory/deploy.ini
[all:vars]
cluster_username = 'greatdb'
cluster_password = 'greatdb'
package_name = 'greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz'
root_dir = '/greatdb'
ansible_ssh_user=root
ansible_ssh_port=22
ansible_ssh_pass=root
ansible_sudo_pass=
close_firewall = yes
close_selinux = yes

; hosts 组应包含所有安装 greatdb 的主机 IP
[hosts]
192.168.0.81
192.168.0.82
192.168.0.83

; define sqlnodes
[sqlnodes]
sqlnode1 ansible_host=192.168.0.81
sqlnode2 ansible_host=192.168.0.82
sqlnode3 ansible_host=192.168.0.83

[sqlnodes:vars]
port=3306
node_type='sqlnode'

; define shards group
[datanodes:children]
shard1
shard2
shard3

[datanodes:vars]
node_type='datanode'
shard_names = ['shard1', 'shard2', 'shard3']

; define shard, the 1st is the primary, others are secondary
[shard1]
datanode1 ansible_host=192.168.0.81 port=4406
datanode2 ansible_host=192.168.0.82 port=4406
datanode3 ansible_host=192.168.0.83 port=4406

[shard2]
datanode4 ansible_host=192.168.0.81 port=4407
datanode5 ansible_host=192.168.0.82 port=4407
datanode6 ansible_host=192.168.0.83 port=4407

[shard3]
datanode7 ansible_host=192.168.0.81 port=4408
datanode8 ansible_host=192.168.0.82 port=4408
datanode9 ansible_host=192.168.0.83 port=4408
解释:
- cluster_username 和 cluster_password :集群内置管理账号和密码
- package_name :需要安装的 GreatDB Cluster 包的版本名称,注意需要和downloads目录中的安装包名称匹配。
- root_dir :集群安装的根目录,标准化安装不要调整。
- ansible_ssh_xxx :远端ssh端口、root用户名、root密码,主机密码不同,可先配置ansible一对多的SSH互信认证来解决。
- close_firewall、close_selinux :是否关闭防火墙、selinux
[host]: 所有的数据库机器的列表sqlnodes: 定义sqlnode节点- 3个shard,每个shard分布在不同的主机上,为了维护方便使用相同的端口。
- 准备 GreatDB Cluster 安装包
GreatDB Cluster 安装包放到 downloads 目录下
[root@greatdb1 ~]# ll greatdb-ansible-master/downloads/
total 591012
-rw-r--r--. 1 root root 605194964 Feb 25 07:08 greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz
- 配置参数
# sqlnode.yml 用于单独定制sqlnode的数据库参数配置。
[root@greatdb1 ~]# cat greatdb-ansible-master/conf/sqlnode.yml
---
# TODO: config options for sqlnode.

max_connections: "2000"
innodb_buffer_pool_size: "128M"
innodb_log_file_size: "1G"
loose_group_replication_consistency: "BEFORE_AND_AFTER"

# datanode.yml 用于单独定制datanode的数据库参数配置。
[root@greatdb1 ~]# cat greatdb-ansible-master/conf/datanode.yml
---
# TODO: config options for datanode.

max_connections: "3000"
innodb_buffer_pool_size: "128M"
innodb_log_file_size: "1G"
loose_group_replication_consistency: "BEFORE_ON_PRIMARY_FAILOVER"
使用 root 执行安装
[root@greatdb1 ~]# cd greatdb-ansible-master/
[root@greatdb1 greatdb-ansible-master]# ansible-playbook deploy.yml -i inventory/deploy.ini -v
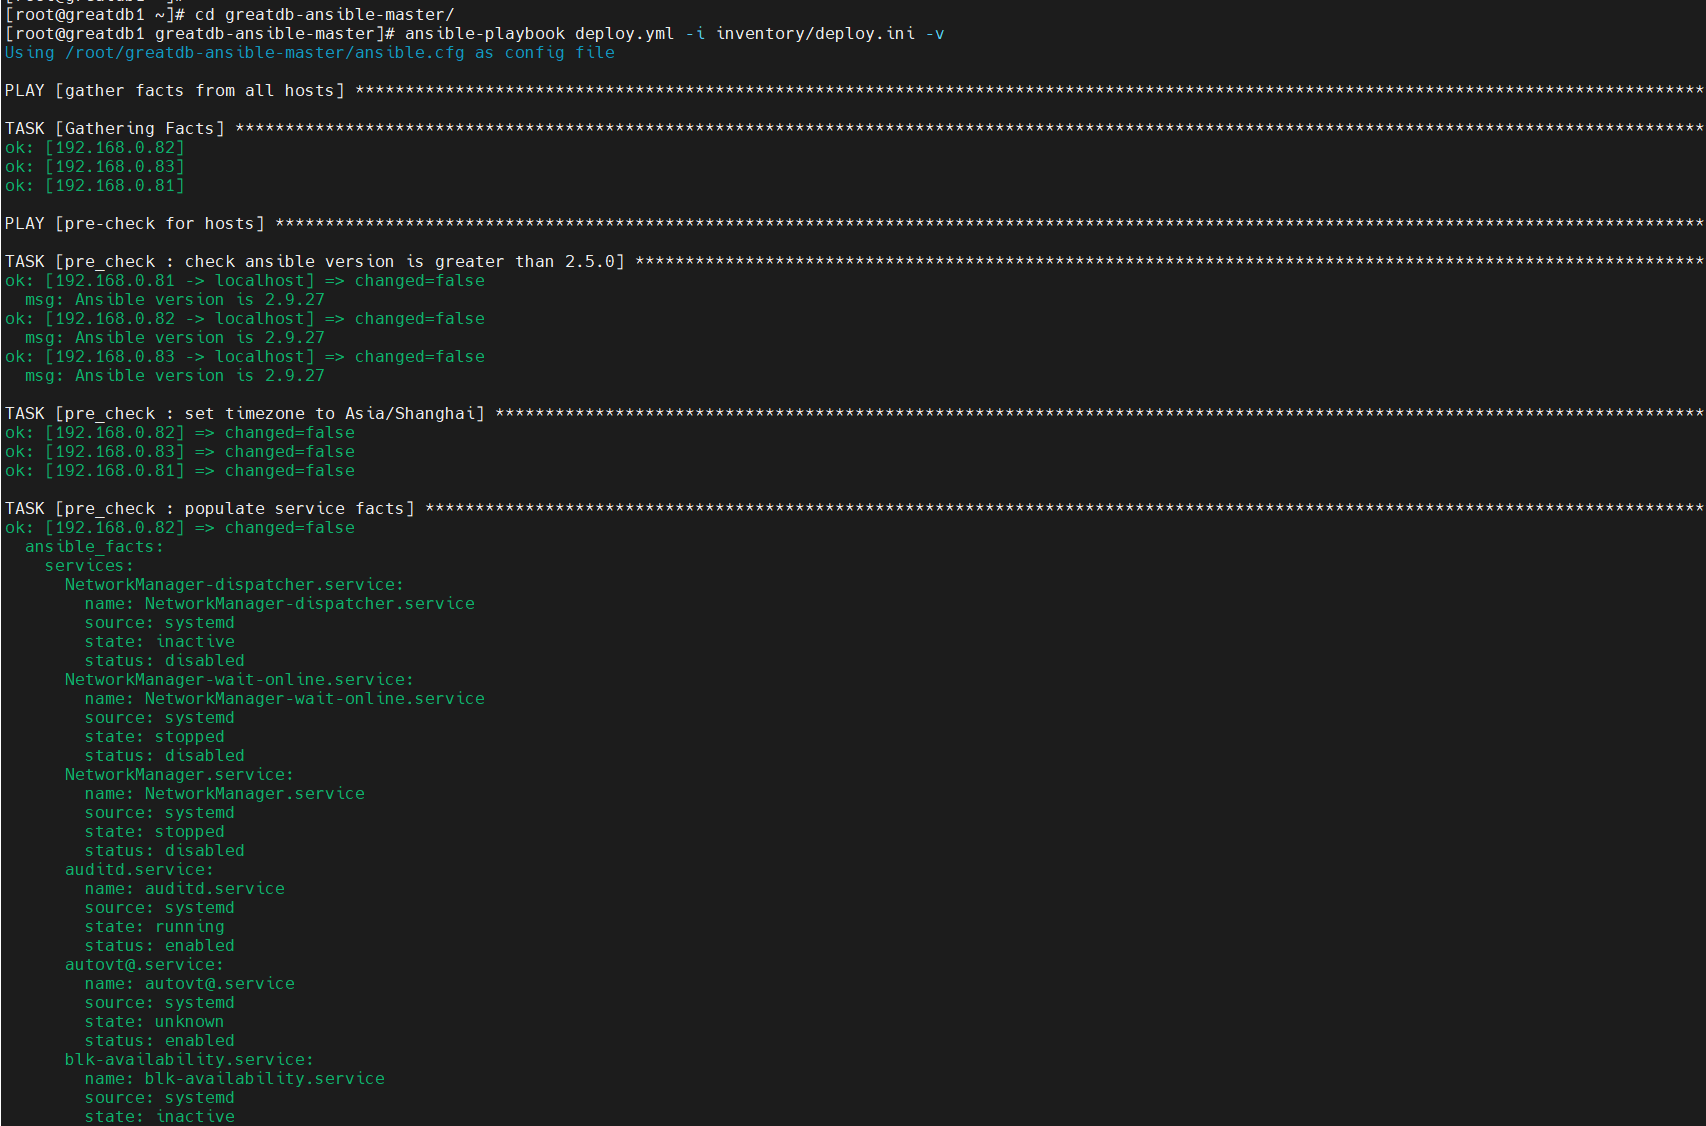
第一次安装出现以下错误:
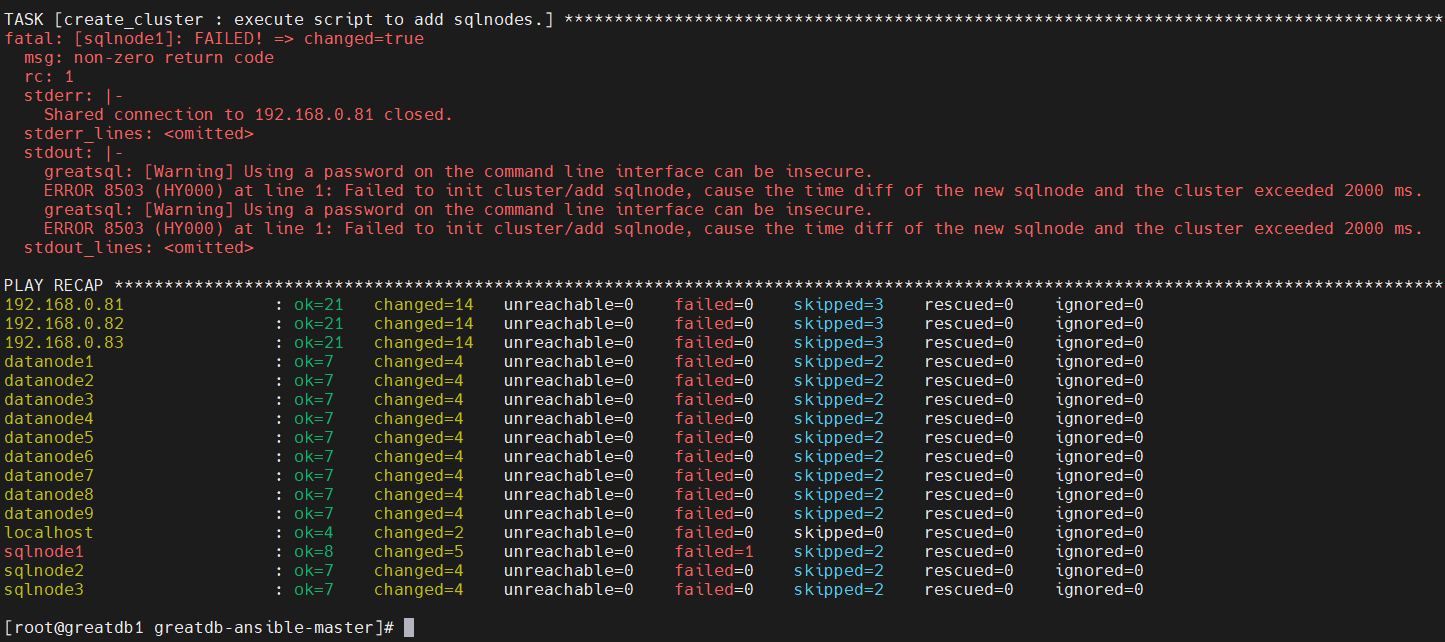
看报错是时间相差较多,调整一下时间,清理环境再次执行
date -s "20210225 01:36:00"

[root@greatdb1 greatdb-ansible-master]# ansible-playbook cleanup.yml -i inventory/deploy.ini -v
[root@greatdb1 greatdb-ansible-master]# ansible-playbook deploy.yml -i inventory/deploy.ini -v
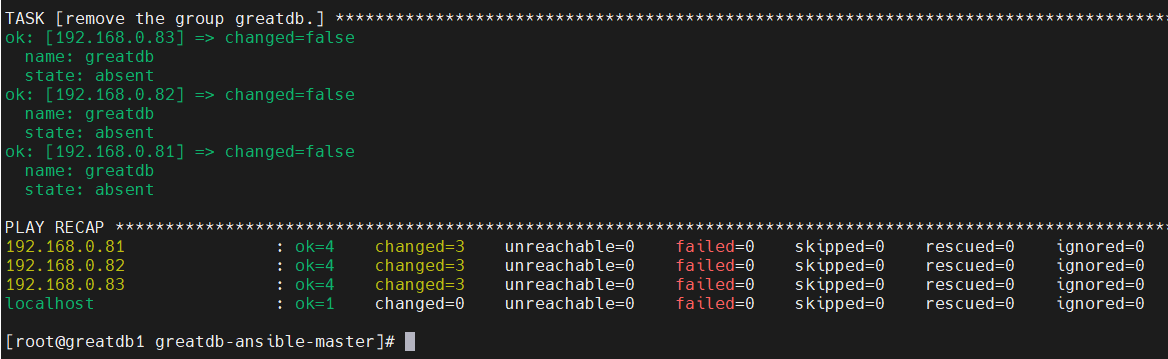
再次执行安装,成功了
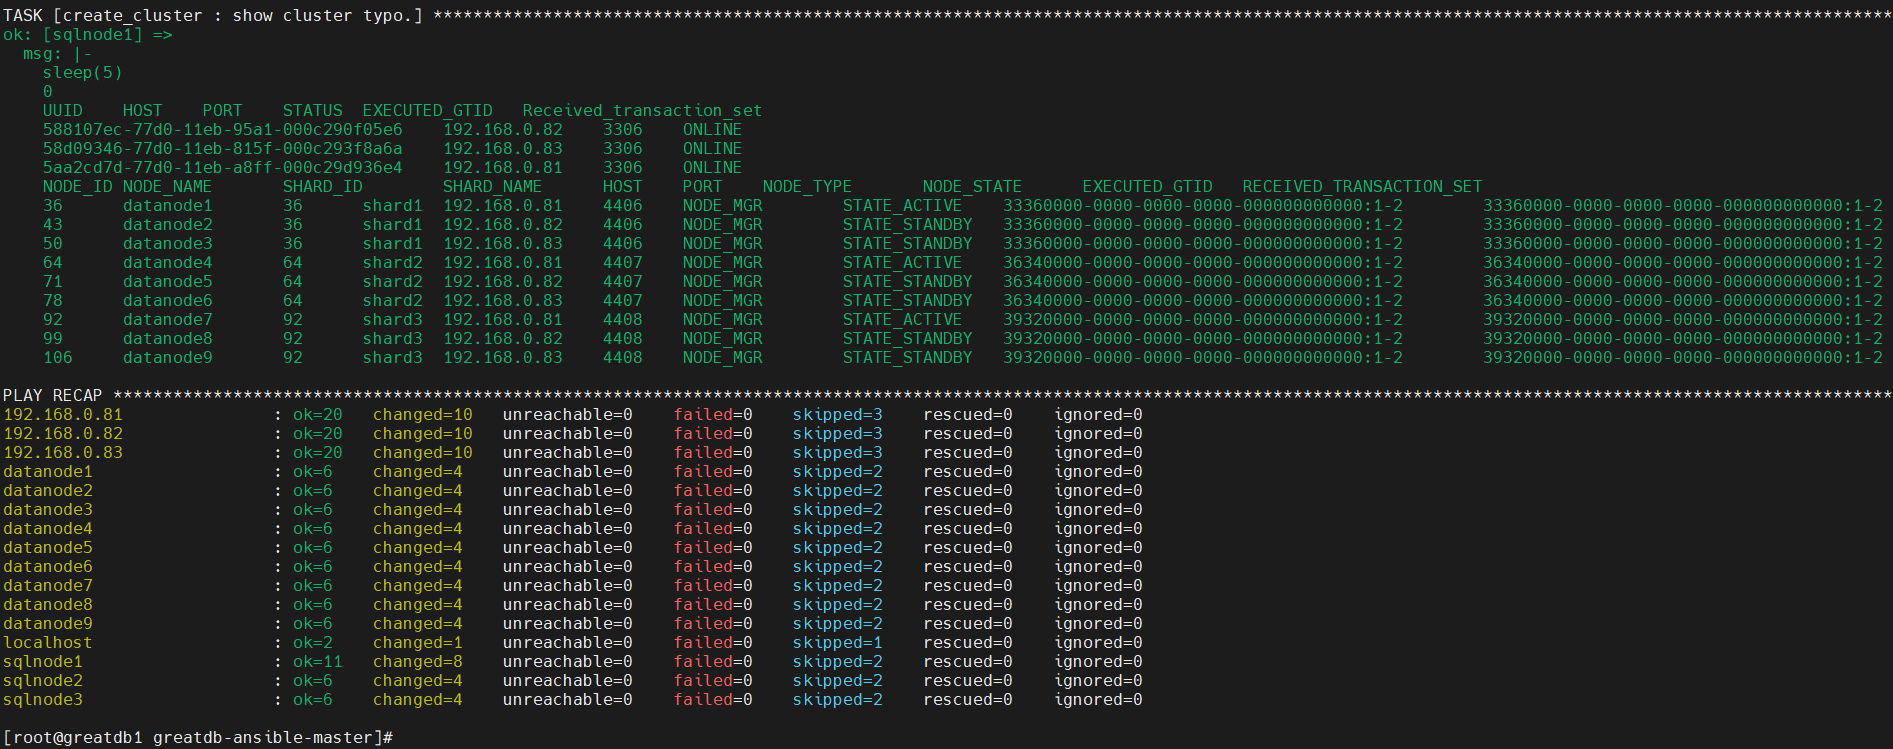
Ansible 的自动部署流程
# ansible-playbook deploy.yml -i inventory/deploy.ini -v

# pre-check
1. check ansible version is greater than 2.5.0
2. set timezone to Asia/Shanghai
3. populate service facts
4. restart crond to ensure the jobs run at the right time
5. stop|disable firewalld service
6. ensure the selinux module dependency in centos
   yum install libselinux-python
7. disable selinux

# ensure_dependencies
# ensure dependencies of greatdb cluster was installed.
1. install greatdb dependencies for centos systems
   yum install libaio-devel ncurses-devel numactl-devel

# distribute_and_install
# distribute and install greatdb binary file.
1. create greatdb group.
2. create greatdb system user.
3. create some required directories.
   mkdir /greatdb/svr
   mkdir /greatdb/dbdata
   mkdir /greatdb/logs
   mkdir /greatdb/conf
   mkdir /greatdb/sh
   mkdir /greatdb/tool
   mkdir /greatdb/dbbackup
   chmod -R 755 /greatdb
4. copy the shell scripts under sh dir to remote host for operational controls.
   scp /root/greatdb-ansible-master/sh/* 192.168.0.82:/greatdb/sh/
   scp /root/greatdb-ansible-master/sh/* 192.168.0.83:/greatdb/sh/
5. add or modify nofile limit for the user greatdb
   echo "greatdb -       nofile  655350" >> /etc/security/limits.conf
6. config pam login option
   echo "session    required   pam_limits.so" >> /etc/pam.d/login
7. distribute the greatdb archive file to all nodes.
   scp "{{ downloads_dir }}/{{ item.file_name }}" 192.168.0.81:/greatdb/svr/greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz
   scp "{{ downloads_dir }}/{{ item.file_name }}" 192.168.0.82:/greatdb/svr/greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz
   scp "{{ downloads_dir }}/{{ item.file_name }}" 192.168.0.83:/greatdb/svr/greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz
8. unarchive the compressed binary executable file.
   tar -zxvf /greatdb/svr/greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz -C /greatdb/svr
9. create symbolic link for greatdb binary executable file.
   ln -s greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64 /greatdb/svr/greatdb
10. remove the useless archive file.
   rm -f /greatdb/svr/greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz
11. get stats of root_dir   -- /greatdb
12. change owner of installed directories and files to greatdb
   chown -R greatdb:greatdb /greatdb
   chmod 755 /greatdb
13. change owner of installed directories and files to greatdb (symbolic link)

# initialize_node
# initialize and start up all sqlnodes.
1. include sqlnode vars
   /root/greatdb-ansible-master/conf/sqlnode.yml
2. include datanode vars
   /root/greatdb-ansible-master/conf/datanode.yml
3. set sqlnode dynamic variables.
   start_cmd: greatsqld_safe
4. set datanode dynamic variables.
   start_cmd: greatdbd_safe
5. copy the configuration file to given nodes.
   /greatdb/conf/sqlnode3306.cnf
   /greatdb/conf/datanode4406.cnf
   /greatdb/conf/datanode4407.cnf
   /greatdb/conf/datanode4408.cnf
6. create dir log, data, tmp under data_dir for current node.
   mkdir -p /greatdb/dbdata/sqlnode3306/data
   mkdir -p /greatdb/dbdata/sqlnode3306/log
   mkdir -p /greatdb/dbdata/sqlnode3306/tmp
   mkdir -p /greatdb/dbdata/datanode4406/data
   mkdir -p /greatdb/dbdata/datanode4406/log
   mkdir -p /greatdb/dbdata/datanode4406/tmp
   mkdir -p /greatdb/dbdata/datanode4407/data
   mkdir -p /greatdb/dbdata/datanode4407/log
   mkdir -p /greatdb/dbdata/datanode4407/tmp
   mkdir -p /greatdb/dbdata/datanode4408/data
   mkdir -p /greatdb/dbdata/datanode4408/log
   mkdir -p /greatdb/dbdata/datanode4408/tmp
   chown -R greatdb:greatdb /greatdb/dbdata
   chmod -R 755 /greatdb/dbdata
7. initialize node datadir by greatdb_init command.
   su - greatdb
   /greatdb/svr/greatdb/bin/greatdb_init \
   --defaults-file=/greatdb/conf/sqlnode3306.cnf \
   --cluster-user=greatdb \
   --cluster-host=% \
   --cluster-password=greatdb \
   --node-type=sqlnode \

   /greatdb/svr/greatdb/bin/greatdb_init \
   --defaults-file=/greatdb/conf/datanode4406.cnf \
   --cluster-user=greatdb \
   --cluster-host=% \
   --cluster-password=greatdb \
   --node-type=datanode \

   /greatdb/svr/greatdb/bin/greatdb_init \
   --defaults-file=/greatdb/conf/datanode4407.cnf \
   --cluster-user=greatdb \
   --cluster-host=% \
   --cluster-password=greatdb \
   --node-type=datanode \

   /greatdb/svr/greatdb/bin/greatdb_init \
   --defaults-file=/greatdb/conf/datanode4408.cnf \
   --cluster-user=greatdb \
   --cluster-host=% \
   --cluster-password=greatdb \
   --node-type=datanode \

8. distribute start-stop scripts for operational controls.
   /greatdb/sh/sqlnode3306.sh
   /greatdb/sh/datanode4406.sh
   /greatdb/sh/datanode4407.sh
   /greatdb/sh/datanode4408.sh

# generate_scripts
# generate cluster creation scripts for all nodes.
1. check whether shells directory exists or not.
2. create a shells directory if not exists.
   mkdir -p /root/greatdb-ansible-master/scripts
3. generate shell scripts
   /root/greatdb-ansible-master/scripts/add_sqlnode.sh
   /root/greatdb-ansible-master/scripts/add_datanode.sh

# create_cluster
1. initialize cluster.
   /greatdb/svr/greatdb/bin/greatsql -S/greatdb/dbdata/sqlnode3306/data/greatdb.sock -ugreatdb -pgreatdb \
   -e "call mysql.greatdb_init_cluster('greatdb_cluster', 'greatdb', 'greatdb');"
2. execute script to add sqlnodes.
   /root/greatdb-ansible-master/scripts/add_sqlnode.sh
3. execute script to add datanode.
   /root/greatdb-ansible-master/scripts/add_datanode.sh
4. fetch cluster typo
   /greatdb/svr/greatdb/bin/greatsql -S/greatdb/dbdata/sqlnode3306/data/greatdb.sock -ugreatdb -pgreatdb \
   -e "select sleep(5);select * from information_schema.greatdb_sqlnodes;select * from information_schema.greatdb_datanodes;"
5. show cluster typo
Ansible 的自动清理环境的流程
# ansible-playbook cleanup.yml -i inventory/deploy.ini -v

1. Check ansible version is greater than 2.2.0
2. stop greatdb services.
   for svr in greatdbd greatdbd_safe greatsqld greatsqld_safe; do pkill -9 $svr || true; done;
3. remove the root directory.
   rm -rf /greatdb
4. remove greatdb system user and group.
   userdel -r greatdb
   groupdel greatdb
运行 cleanup.yml playbook 关闭集群并清除安装目录,该脚本会移除 GreatDB 安装部署的根目录,因此运行前请先备份集群数据,放置到别处。
安装方式二,使用⼆进制包手动部署 GreatDB
所有节点创建系统用户组和用户
[root@greatdb1 ~]# groupadd greatdb
[root@greatdb1 ~]# useradd -g greatdb -s /bin/bash greatdb
[root@greatdb1 ~]# echo "greatdb " | passwd --stdin greatdb
所有节点创建目录
[root@greatdb1 ~]# mkdir -p /greatdb/svr
[root@greatdb1 ~]# mkdir -p /greatdb/dbdata
[root@greatdb1 ~]# mkdir -p /greatdb/logs
[root@greatdb1 ~]# mkdir -p /greatdb/conf
[root@greatdb1 ~]# mkdir -p /greatdb/sh
[root@greatdb1 ~]# mkdir -p /greatdb/tool
[root@greatdb1 ~]# mkdir -p /greatdb/dbbackup
[root@greatdb1 ~]# chmod -R 755 /greatdb
[root@greatdb1 ~]# chown -R greatdb:greatdb /greatdb
所有节点上传并解压安装包
万⾥开源提供 GreatDB Cluster 的⼆进制发布包,以 tar 包的形式发布,这⾥以 greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz 的压缩包为例,进⾏安装说明。
[root@greatdb1 ~]# ll /opt/
total 591016
-rw-r--r--.  1 root root 605194964 Feb 25 15:28 greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz
[root@greatdb1 ~]# tar -xvf /opt/greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64.tar.gz -C /greatdb/svr
[root@greatdb1 ~]# cd /greatdb/svr
[root@greatdb1 svr]# ln -s greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64 greatdb
[root@greatdb1 svr]# chown -R greatdb:greatdb greatdb
[root@greatdb1 svr]# chown -R greatdb:greatdb greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64
[root@greatdb1 svr]# cd greatdb
[root@greatdb1 greatdb]# ll
total 628
drwxr-xr-x.  2 greatdb greatdb   4096 Sep  1  2021 bin
drwxr-xr-x.  2 greatdb greatdb     69 Sep  1  2021 cmake
-rw-r--r--.  1 greatdb greatdb   1703 Sep  1  2021 COPYING-jemalloc
drwxr-xr-x.  2 greatdb greatdb    115 Sep  1  2021 docs
drwxr-xr-x.  6 greatdb greatdb   4096 Sep  1  2021 include
drwxr-xr-x.  8 greatdb greatdb   4096 Sep  1  2021 lib
-rw-r--r--.  1 greatdb greatdb 274942 Sep  1  2021 LICENSE
-rw-r--r--.  1 greatdb greatdb  45333 Sep  1  2021 LICENSE.router
-rw-r--r--.  1 greatdb greatdb 274942 Sep  1  2021 LICENSE-test
drwxr-xr-x.  4 greatdb greatdb     30 Sep  1  2021 man
-rw-r--r--.  1 greatdb greatdb   1623 Sep  1  2021 mysqlrouter-log-rotate
-rw-r--r--.  1 greatdb greatdb    685 Sep  1  2021 README
-rw-r--r--.  1 greatdb greatdb    679 Sep  1  2021 README.router
-rw-r--r--.  1 greatdb greatdb    685 Sep  1  2021 README-test
drwxrwxr-x.  2 greatdb greatdb      6 Sep  1  2021 run
drwxr-xr-x. 28 greatdb greatdb   4096 Sep  1  2021 share
drwxr-xr-x.  2 greatdb greatdb     77 Sep  1  2021 support-files
drwxr-xr-x.  3 greatdb greatdb     17 Sep  1  2021 var
- 解压后的⽂件布局如下:
- 重点⽂件说明:
- bin/greatsqld: SQL节点后台程序
- bin/greatdbd: 数据节点后台程序
- bin/greatsql: SQL节点客户端程序,⽤于登陆SQL节点
- bin/greatsqld_safe: 启动SQL节点的守护程序
- bin/greatdbd_safe: 启动数据节点的守护程序
- greatdb_init: greatdb_init 会自动初始化数据库节点实例,并启动实例
- greatsqldump: 集群进行逻辑备份工具
配置⽂件模板
- bash脚本 create_config.sh
SQL节点和数据节点的配置⽂件模板与MySQL配置⽅式⼀致,为了简化⽣成配置⽂件的复杂度,我们提供如下bash脚本 create_config.sh ,内容如下
[root@greatdb1 ~]# cat create_config.sh
#!/bin/bash
set -ex
echo "[mysqld]

basedir=/greatdb/svr/greatdb
datadir=/greatdb/dbdata/$1$3/data
tmpdir=/greatdb/dbdata/$1$3/tmp
pid-file=/greatdb/dbdata/$1$3/data/greatdb.pid
socket=/greatdb/dbdata/$1$3/data/greatdb.sock
mysqlx_socket=/greatdb/dbdata/$1$3/data/greatdbx.sock

user=greatdb
port=$3
server_id=$RANDOM
max_connections=1000
report-host=$2

## group replication configuration
binlog-checksum=NONE
enforce-gtid-consistency=ON
gtid-mode=ON
loose-group_replication_start_on_boot=OFF
loose_group_replication_recovery_get_public_key=ON
loose-group_replication_local_address= \"$2:1$3\""

if [ "x"$1 == "xsqlnode" ]; then
  mkdir -p /greatdb/dbdata/sqlnode$3/data
  mkdir -p /greatdb/dbdata/sqlnode$3/log
  mkdir -p /greatdb/dbdata/sqlnode$3/tmp
elif [ "x"$1 == "xdatanode" ]; then
  mkdir -p /greatdb/dbdata/datanode$3/data
  mkdir -p /greatdb/dbdata/datanode$3/log
  mkdir -p /greatdb/dbdata/datanode$3/tmp
fi
chown -R greatdb:greatdb /greatdb/dbdata
chmod -R 755 /greatdb/dbdata
loose-group_replication_local_address 这个参数需要进⾏配置,保证端⼝号不冲突,此参数⽤于集群内部的 group replication 的设置,⽤户只需要设置这⼀个参数即可。 max_connections 可以尽量设置⼤点,如果超过最⼤句柄数限制,可以通过 ulimit -n unlimited 进⾏调整。
此模板接收三个参数,第一个参数表示为 sqlnode 还是 datanode 创建配置⽂件,第二个参数是 IP 地址,第三个参数是端口号,这⾥使⽤ create_config.sh 创建不同节点的配置⽂件。
- 分别在ssh连到三个 sqlnode 上⽣成计算实例的配置⽂件
[root@greatdb1 ~]# bash create_config.sh sqlnode 192.168.0.81 3306 > /greatdb/conf/sqlnode3306.cnf
[root@greatdb2 ~]# bash create_config.sh sqlnode 192.168.0.82 3306 > /greatdb/conf/sqlnode3306.cnf
[root@greatdb3 ~]# bash create_config.sh sqlnode 192.168.0.83 3306 > /greatdb/conf/sqlnode3306.cnf
- 在 datanode1 上⽣成数据节点的配置⽂件
[root@greatdb1 ~]# bash create_config.sh datanode 192.168.0.81 4406 > /greatdb/conf/datanode4406.cnf
[root@greatdb1 ~]# bash create_config.sh datanode 192.168.0.81 4407 > /greatdb/conf/datanode4407.cnf
[root@greatdb1 ~]# bash create_config.sh datanode 192.168.0.81 4408 > /greatdb/conf/datanode4408.cnf
- 在 datanode2 上⽣成数据节点的配置⽂件
[root@greatdb2 ~]# bash create_config.sh datanode 192.168.0.82 4406 > /greatdb/conf/datanode4406.cnf
[root@greatdb2 ~]# bash create_config.sh datanode 192.168.0.82 4407 > /greatdb/conf/datanode4407.cnf
[root@greatdb2 ~]# bash create_config.sh datanode 192.168.0.82 4408 > /greatdb/conf/datanode4408.cnf
- 在 datanode3 上⽣成数据节点的配置⽂件
[root@greatdb3 ~]# bash create_config.sh datanode 192.168.0.83 4406 > /greatdb/conf/datanode4406.cnf
[root@greatdb3 ~]# bash create_config.sh datanode 192.168.0.83 4407 > /greatdb/conf/datanode4407.cnf
[root@greatdb3 ~]# bash create_config.sh datanode 192.168.0.83 4408 > /greatdb/conf/datanode4408.cnf
- 优化配置选项
⽣成配置⽂件后,需要根据机器的配置以及单台物理机器上的实例数,对配置⽂件中的选项进⾏优 化。需要重点关注如下⼏个选项的配置
初始化节点并启动实例
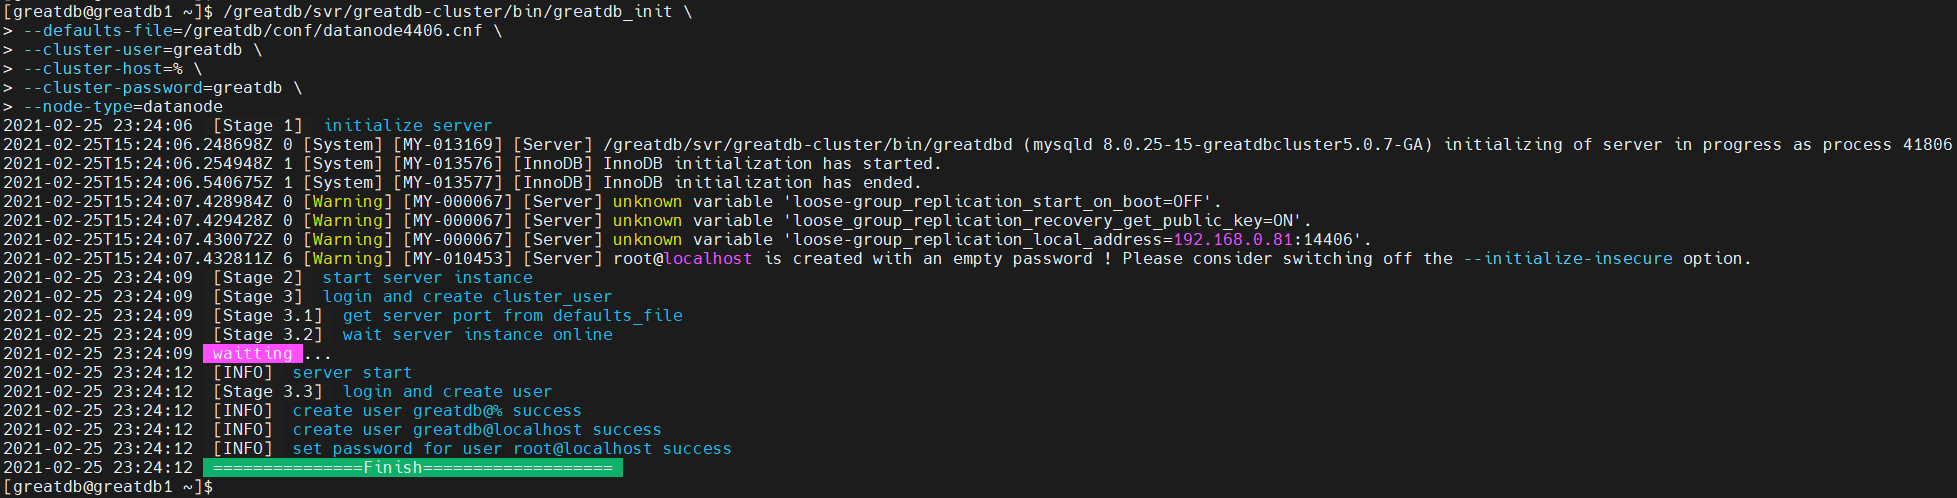
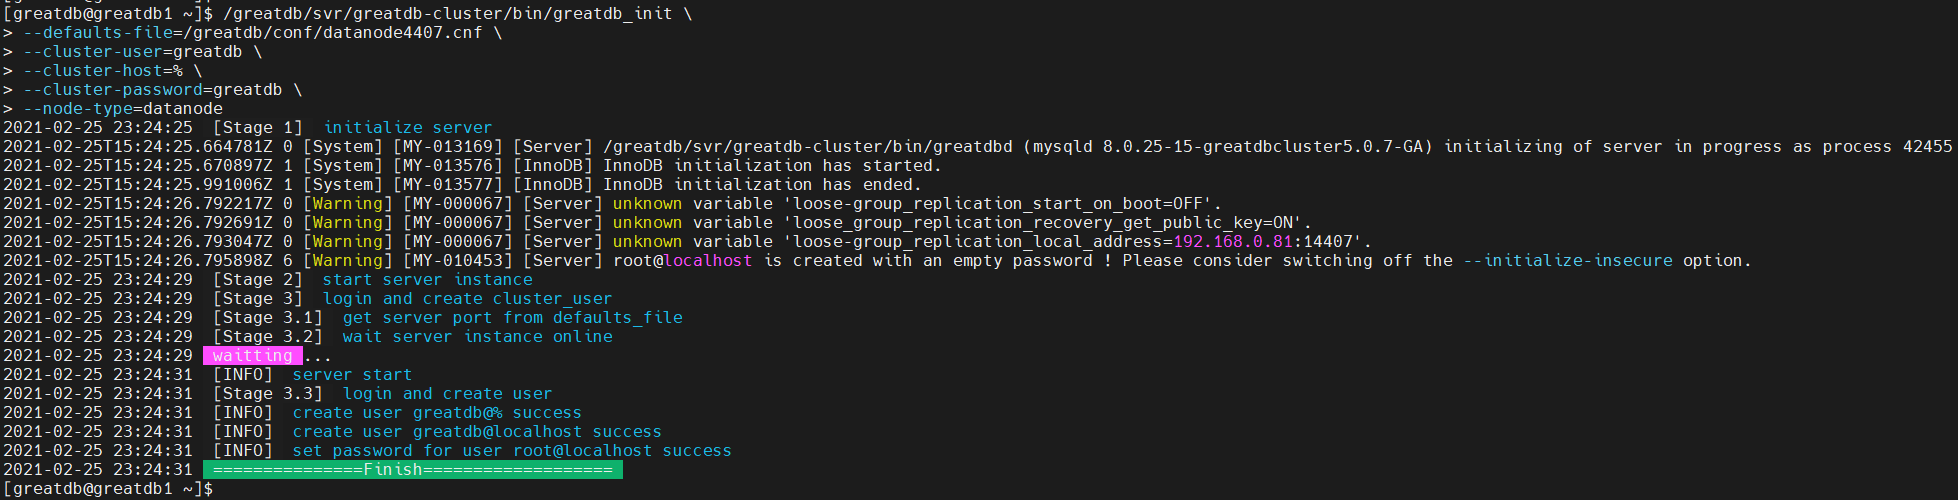
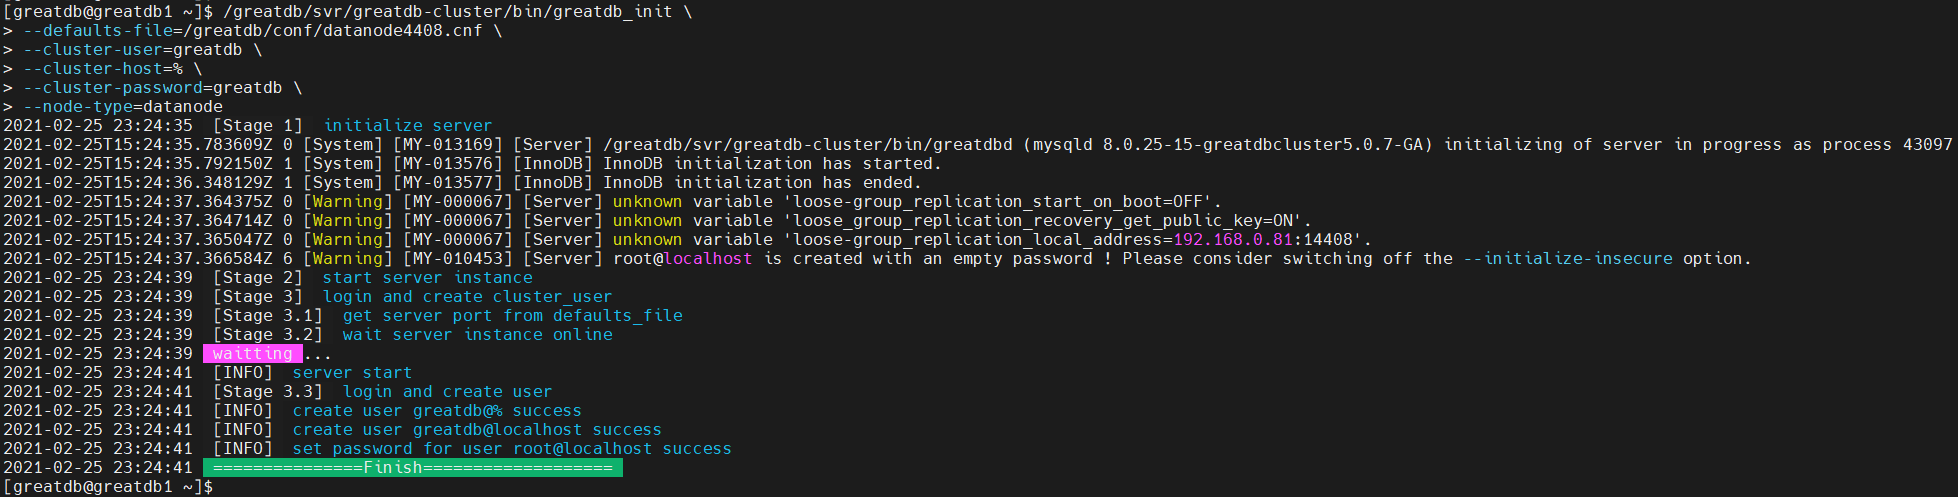
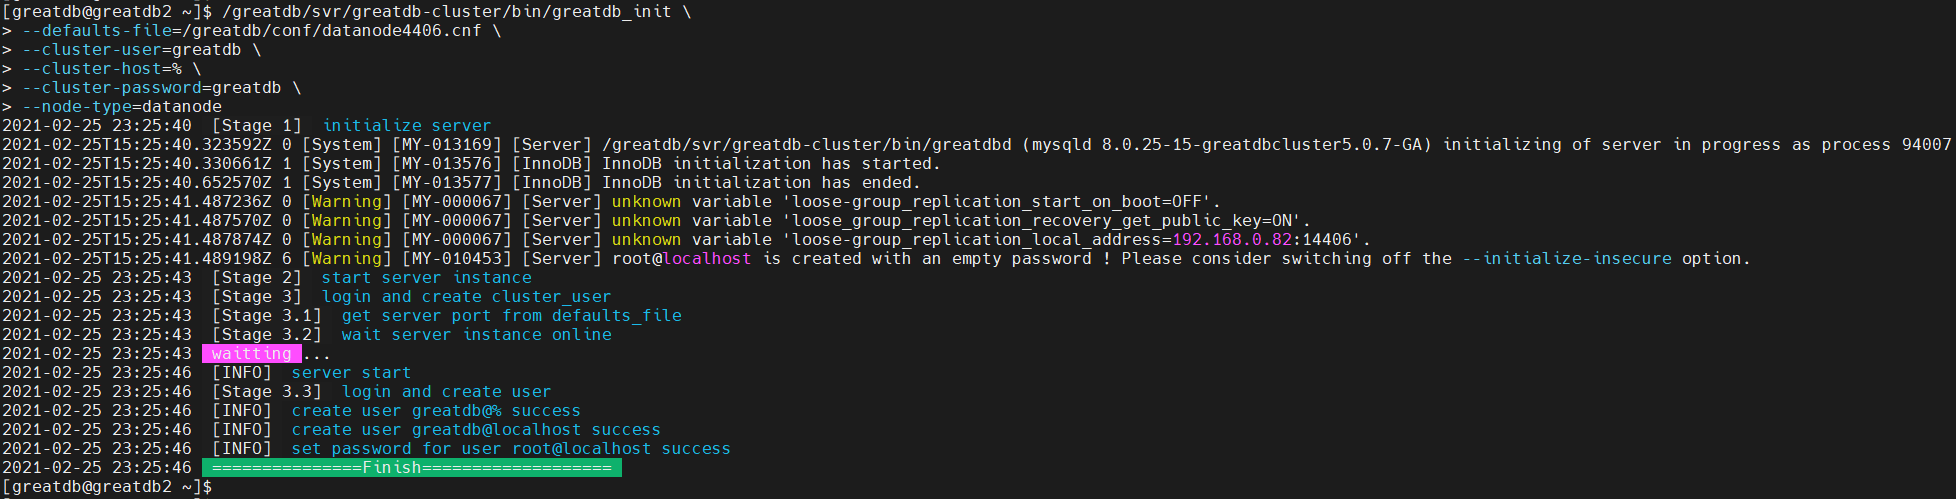
创建好各⾃的配置⽂件后,直接使⽤ greatdb_init 初始化各个节点,greatdb_init 会⾃动初始化数据库节点实例,并启动实例。
- 初始化并启动 SQLNode
分别ssh连到在 sqlnode1,sqlnode2,sqlnode3 上,使⽤ greatdb_init 初始化并启动 SQLNode。
[root@greatdb1 ~]# su - greatdb
/greatdb/svr/greatdb/bin/greatdb_init \
--defaults-file=/greatdb/conf/sqlnode3306.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=sqlnode
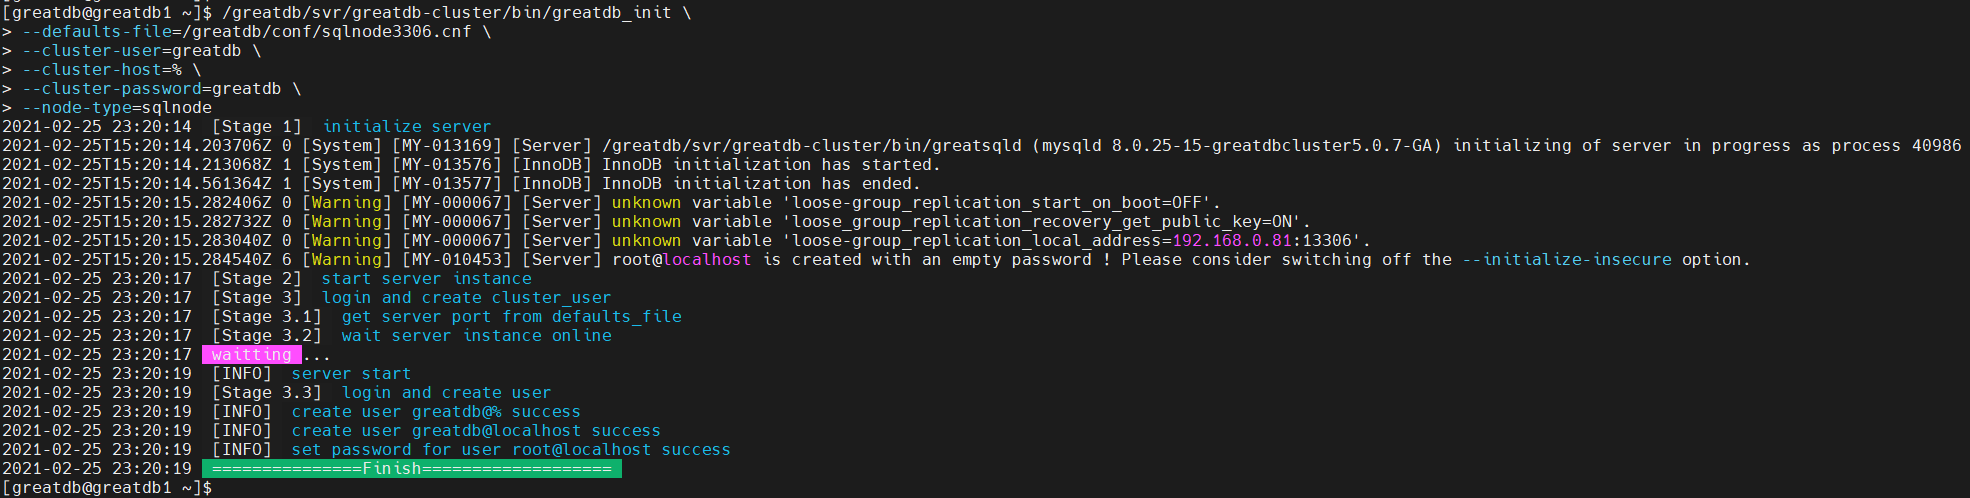
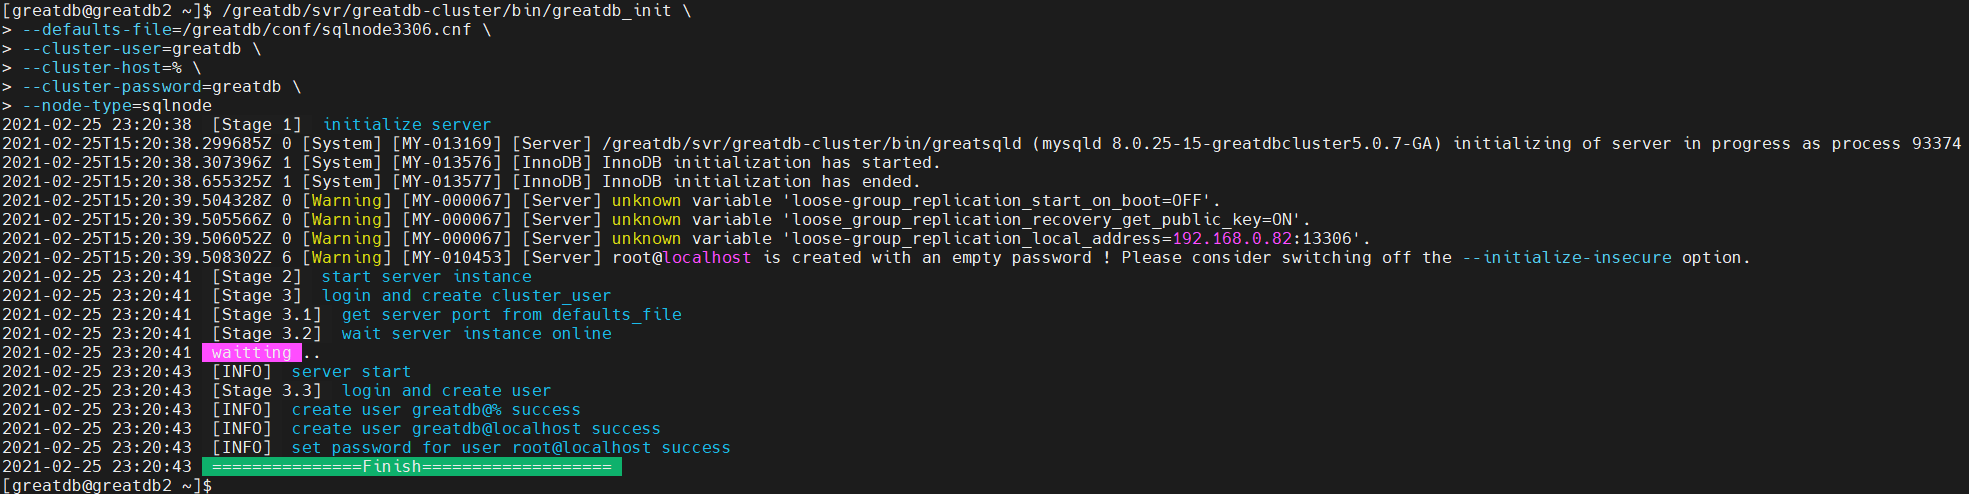
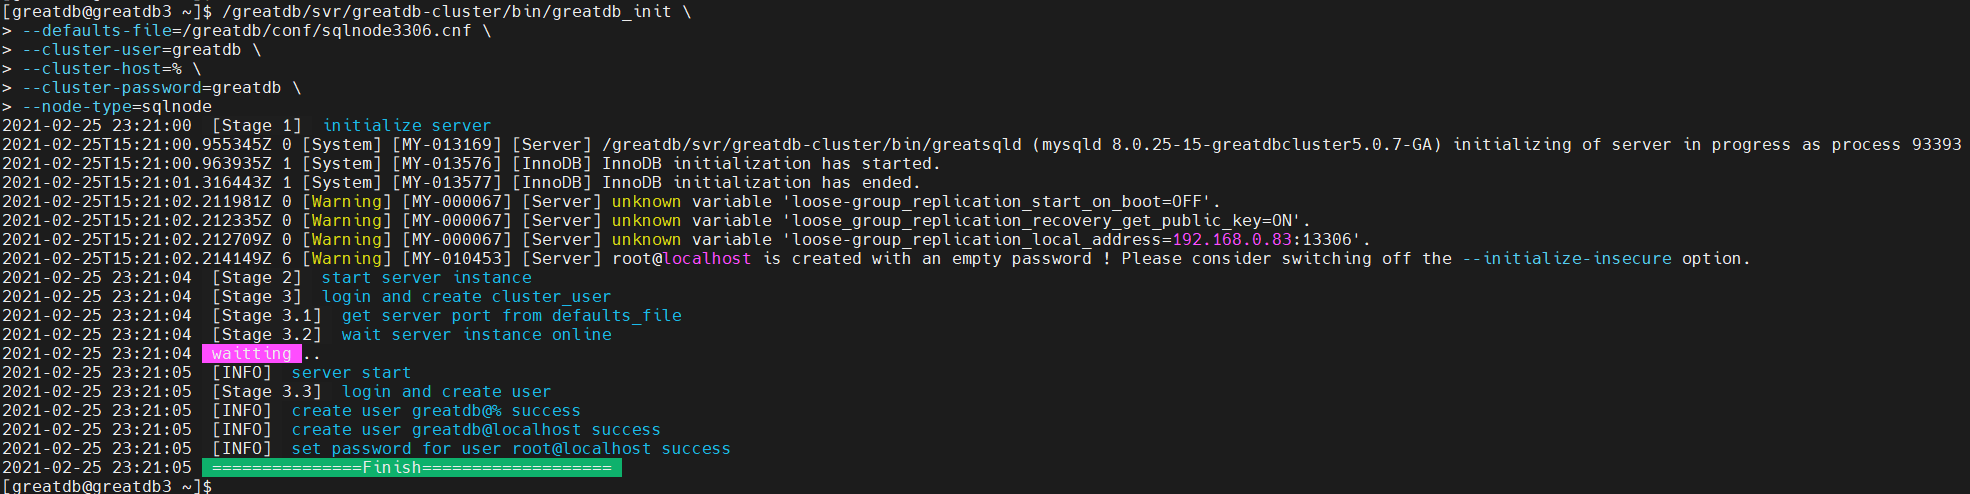
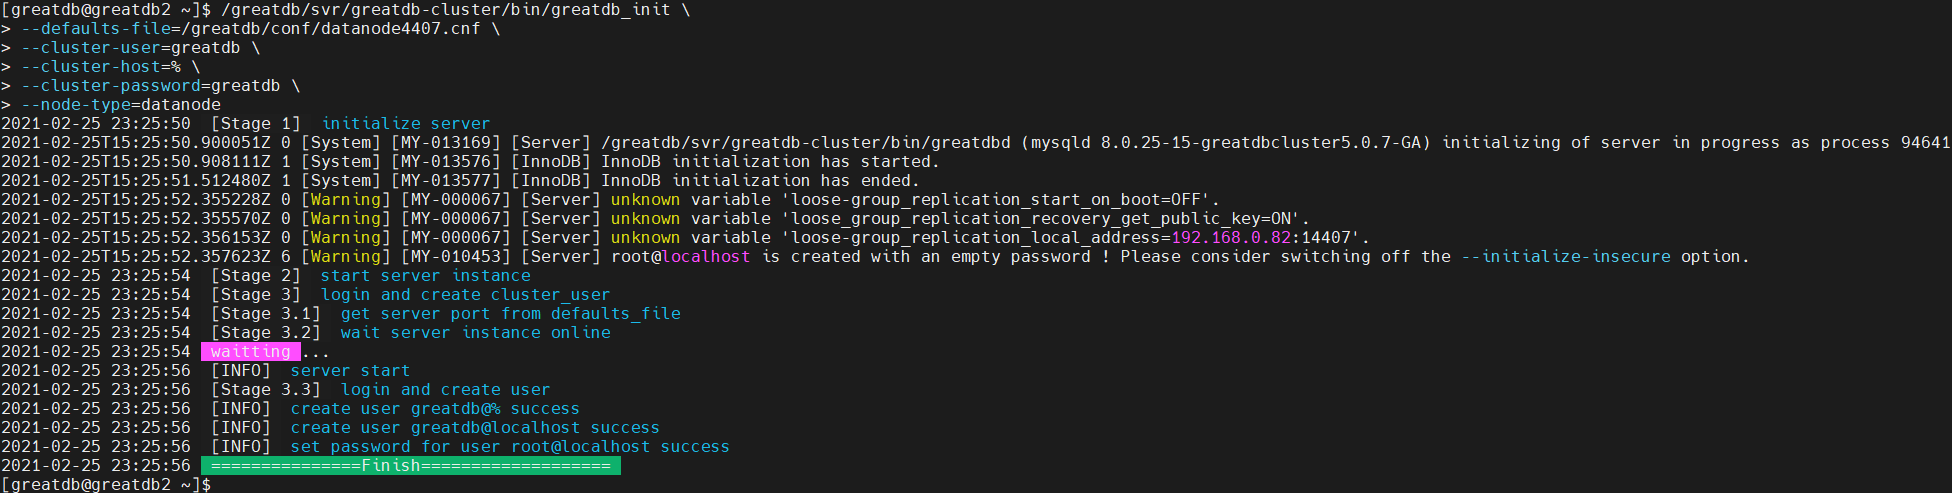
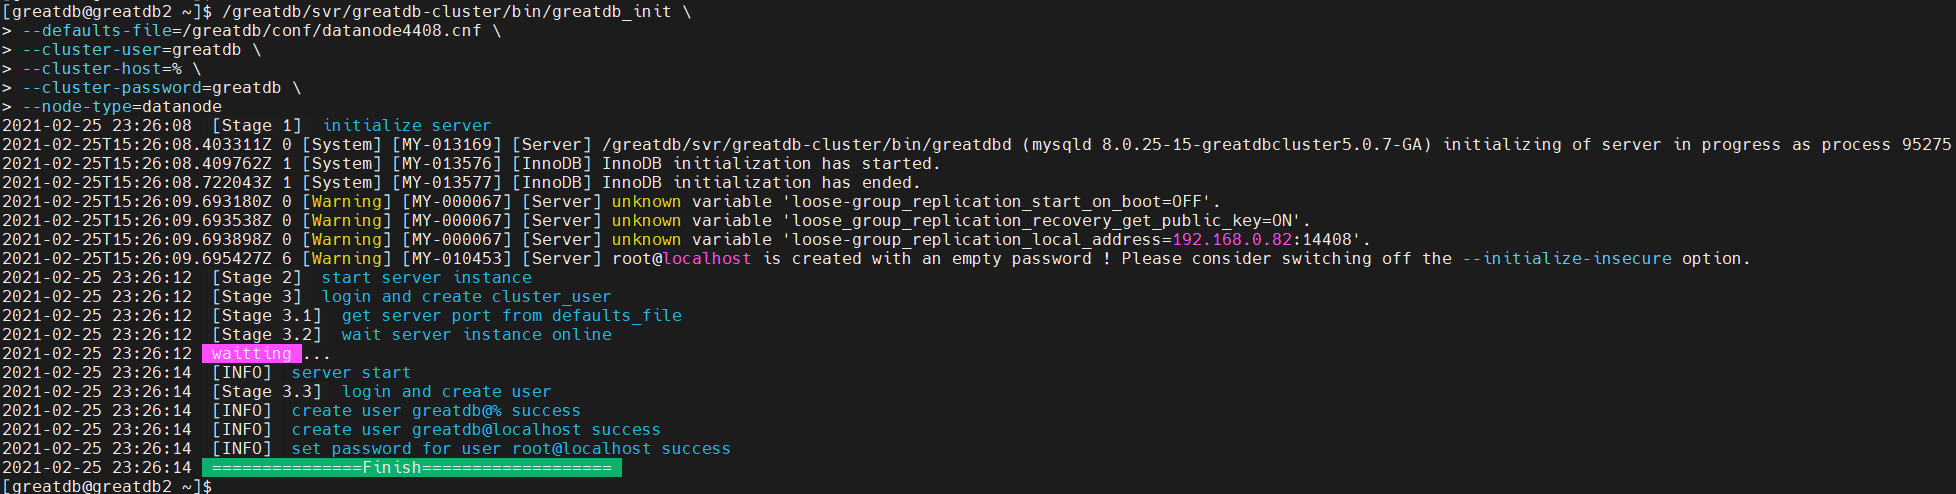
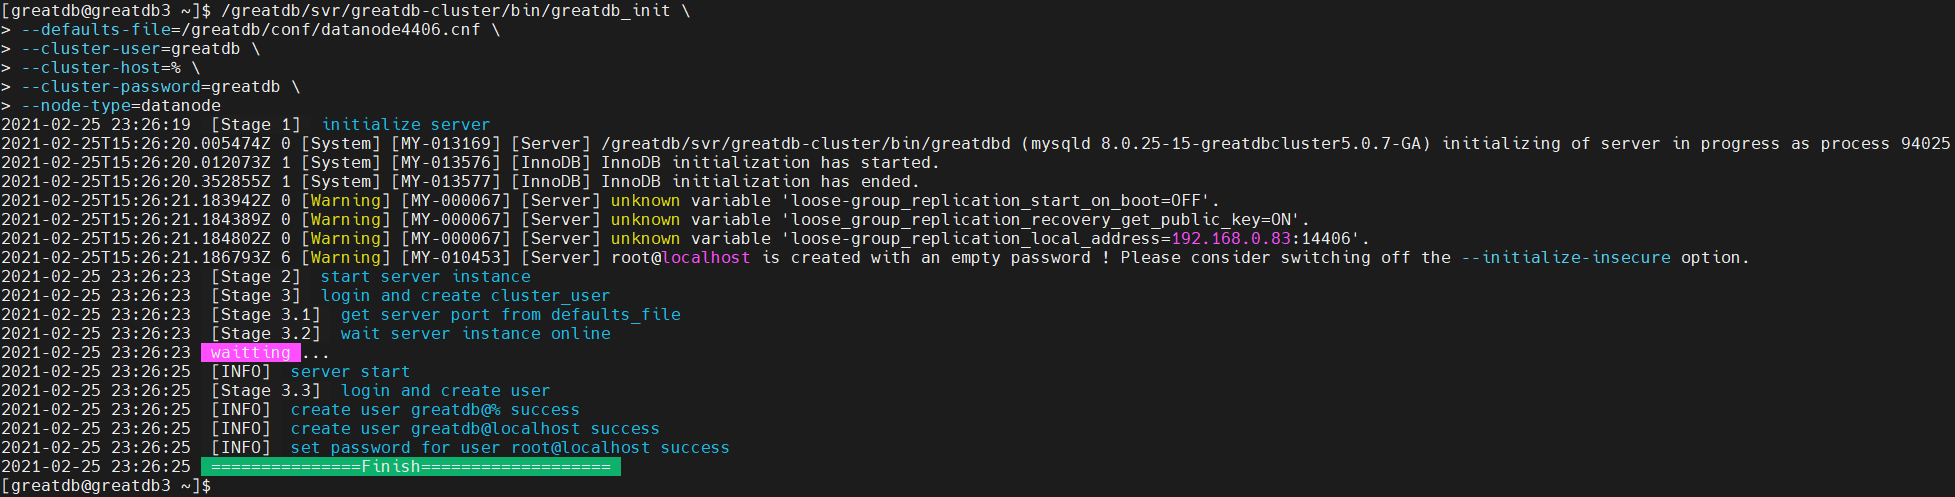
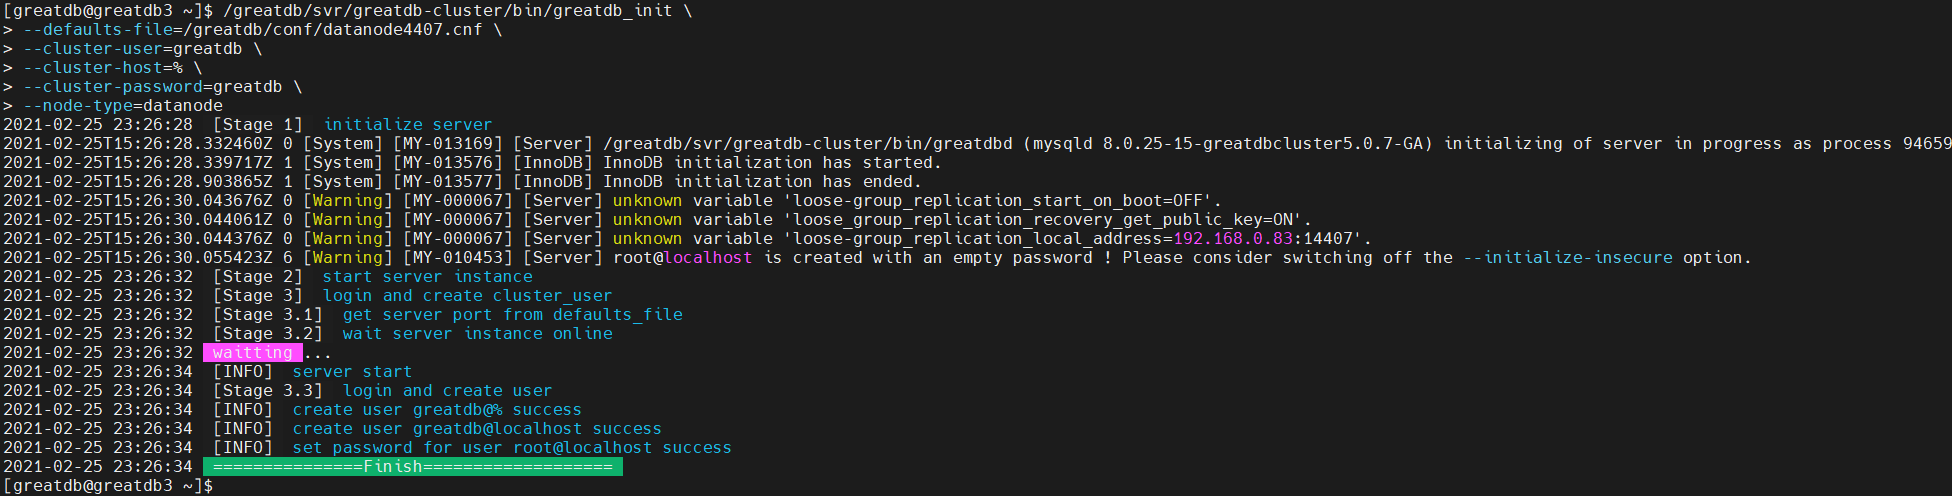
- 初始化并启动 DataNode
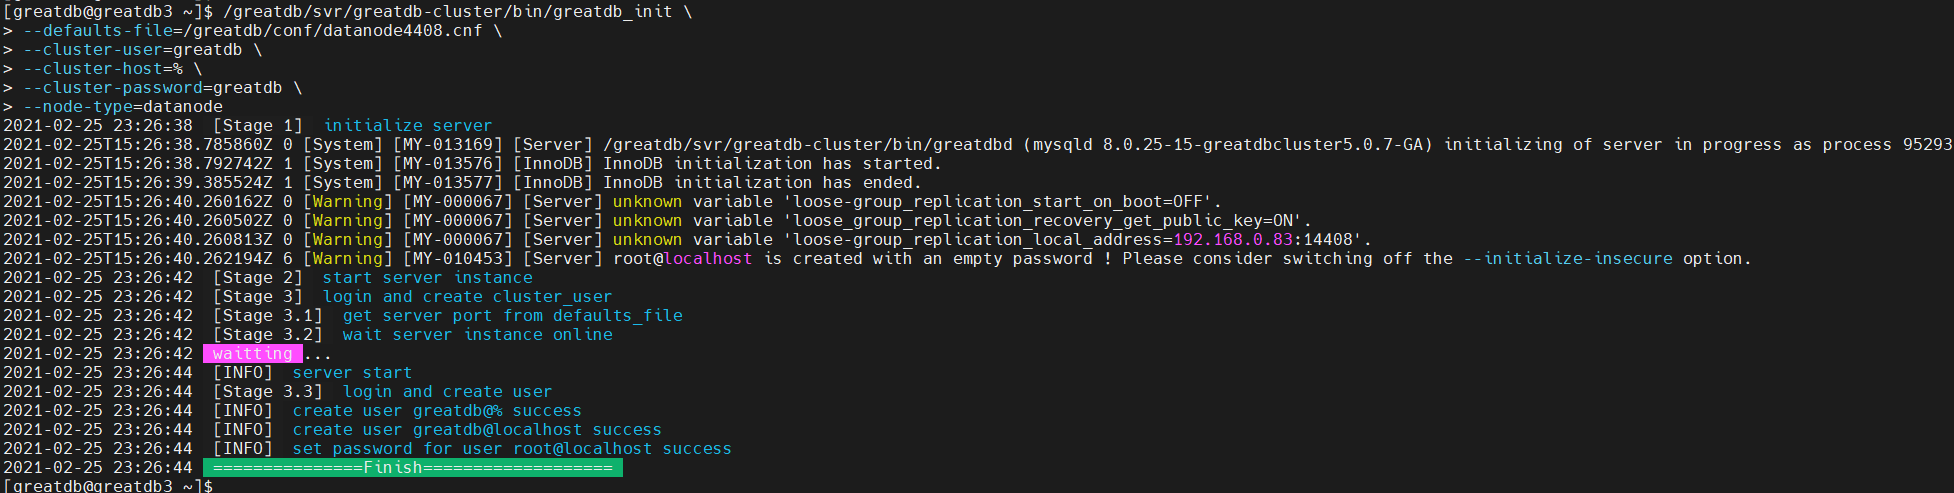
分别ssh连到在 datanode1,datanode2,datanode3 上,使⽤ greatdb_init 初始化 DataNode 的数据⽬录。
[root@greatdb1 ~]# su - greatdb
/greatdb/svr/greatdb/bin/greatdb_init \
--defaults-file=/greatdb/conf/datanode4406.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=datanode

/greatdb/svr/greatdb/bin/greatdb_init \
--defaults-file=/greatdb/conf/datanode4407.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=datanode

/greatdb/svr/greatdb/bin/greatdb_init \
--defaults-file=/greatdb/conf/datanode4408.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=datanode
创建集群
使⽤ root 登陆任意⼀个 SQLNode,进⾏初始化集群操作,随后进⾏添加 SQLNode 和 DataNode 的操作,这⾥以 sqlnode1 作为初始化节点。
# 登陆sqlnode1
[root@greatdb1 ~]# su - greatdb
[greatdb@greatdb1 ~]$ /greatdb/svr/greatdb/bin/greatsql -h127.0.0.1 -P3306 -uroot -pgreatdb

# 初始化集群
GreatDB Cluster[(none)]> call mysql.greatdb_init_cluster('greatdb_cluster', 'greatdb', 'greatdb');
Query OK, 1 row affected (3.31 sec)

# 添加SQLNode sqlnode2
GreatDB Cluster[(none)]> call mysql.greatdb_add_sqlnode('192.168.0.82', 3306);
Query OK,  rows affected (3.24 sec)

# 添加SQLNode sqlnode3
GreatDB Cluster[(none)]> call mysql.greatdb_add_sqlnode('192.168.0.83', 3306);
Query OK,  rows affected (2.56 sec)

# 添加 shard1 的数据节点并初始化
GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard1', 'datanode1', '192.168.0.81', 4406, 'NODE_MGR');
Query OK, 1 row affected (0.06 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard1', 'datanode2', '192.168.0.82', 4406, 'NODE_MGR');
Query OK, 1 row affected (0.05 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard1', 'datanode3', '192.168.0.83', 4406, 'NODE_MGR');
Query OK, 1 row affected (0.05 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_init_shard('shard1');
Query OK, 1 row affected (8.30 sec)

# 添加shard2的数据节点并初始化
GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard2', 'datanode4', '192.168.0.81', 4407, 'NODE_MGR');
Query OK, 1 row affected (0.06 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard2', 'datanode5', '192.168.0.82', 4407, 'NODE_MGR');
Query OK, 1 row affected (0.06 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard2', 'datanode6', '192.168.0.83', 4407, 'NODE_MGR');
Query OK, 1 row affected (0.06 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_init_shard('shard2');
Query OK, 1 row affected (8.40 sec)

# 添加shard3的数据节点并初始化
GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard3', 'datanode7', '192.168.0.81', 4408, 'NODE_MGR');
Query OK, 1 row affected (0.06 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard3', 'datanode8', '192.168.0.82', 4408, 'NODE_MGR');
Query OK, 1 row affected (0.06 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard3', 'datanode9', '192.168.0.83', 4408, 'NODE_MGR');
Query OK, 1 row affected (0.07 sec)

GreatDB Cluster[(none)]> call mysql.greatdb_init_shard('shard3');
Query OK, 1 row affected (8.19 sec)
⾄此,整个集群变搭建完成。
安装方式三,通过 GreatRDS 管理平台集成部署
GreatRDS 还没有得到学习的机会,日后有机会再补充。
GreatDB 登录程序
使用 GreatDB 自带的客户端程序 greatsql
- 添加环境变量
vi /etc/profile
export PATH=/greatdb/svr/greatdb/bin:$PATH

source /etc/profile
- 使用 greatsql 登录 GreatDB
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
greatsql: [Warning] Using a password on the command line interface can be insecure.
Welcome to the MySQL monitor.  Commands end with ; or \g.
Your MySQL connection id is 8934
Server version: 8.0.25-15-greatdbcluster5.0.7-GA GreatDB Cluster, Release GA, Revision fbb08fbed60

Copyright (c) 2009-2021 BEIJING GREAT OPENSOURCE SOFTWARE TECHNOLOGY CO.,LTD.

Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.

GreatDB Cluster[(none)]> show databases;
+--------------------+
| Database           |
+--------------------+
| information_schema |
| mysql              |
| performance_schema |
| sys                |
+--------------------+
4 rows in set (0.05 sec)
兼容 MySQL 客户端
- 安装mysql客户端
[root@db1 ~]# yum -y install mysql
- 使用 mysql 登录 GreatDB
[root@greatdb1 ~]# mysql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
Welcome to the MariaDB monitor.  Commands end with ; or \g.
Your MySQL connection id is 9026
Server version: 8.0.25-15-greatdbcluster5.0.7-GA GreatDB Cluster, Release GA, Revision fbb08fbed60

Copyright (c) 2000, 2018, Oracle, MariaDB Corporation Ab and others.

Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.

MySQL [(none)]> show databases;
+--------------------+
| Database           |
+--------------------+
| information_schema |
| mysql              |
| performance_schema |
| sys                |
+--------------------+
4 rows in set (0.02 sec)
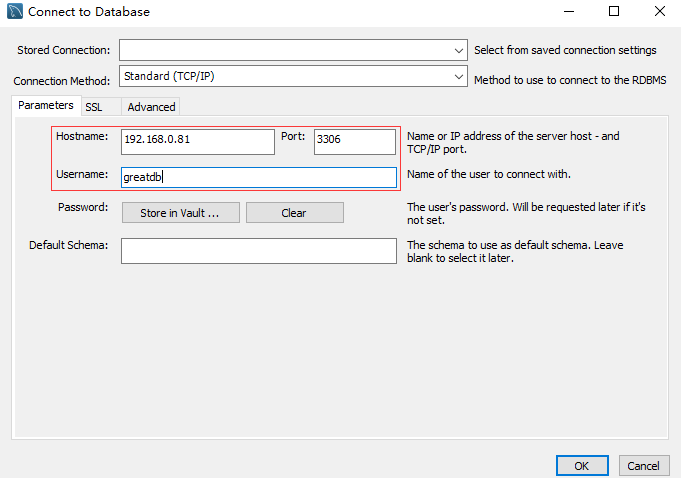
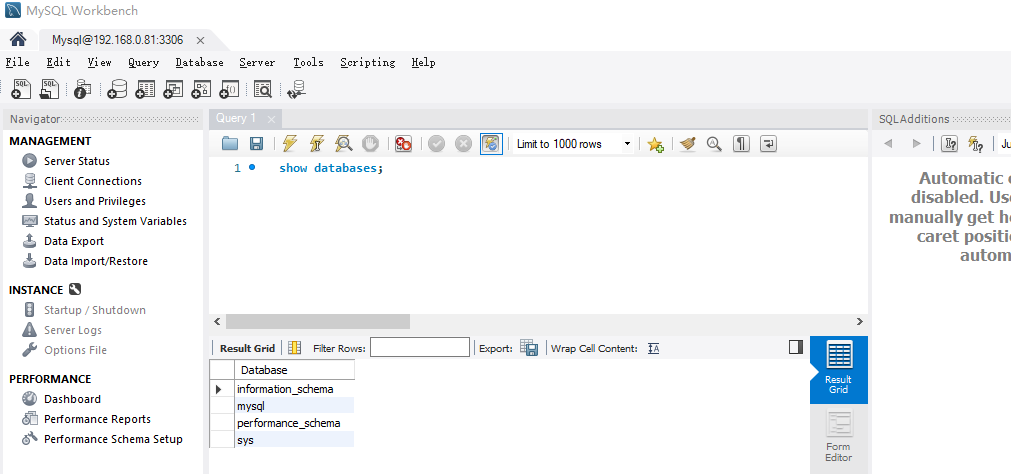
使用 GUI 工具连接 GreatDB 数据库
- 使用 MySQL Workbench 客户端连接 GreatDB 数据库

验证集群状态
查看版本信息
- 通过 greatsqld --version 查看版本
[root@greatdb1 ~]# greatsqld --version
/greatdb/svr/greatdb-cluster-5.0.7-fbb08fbed60-Linux-glibc2.17-x86_64/bin/greatsqld  Ver 8.0.25-15-greatdbcluster5.0.7-GA for Linux on x86_64 (GreatDB Cluster, Release GA, Revision fbb08fbed60)
- 通过全局变量查看版本
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> show global variables like 'greatdb_version';
+-----------------+---------+
| Variable_name   | Value   |
+-----------------+---------+
| greatdb_version | 5.0.7.3 |
+-----------------+---------+
1 row in set (0.01 sec)
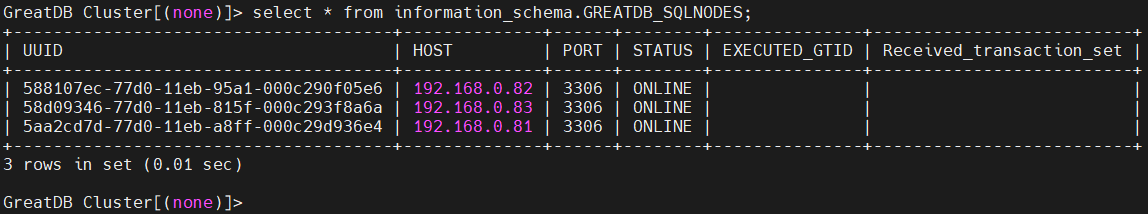
查看SQL节点状态
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> select * from information_schema.GREATDB_SQLNODES;
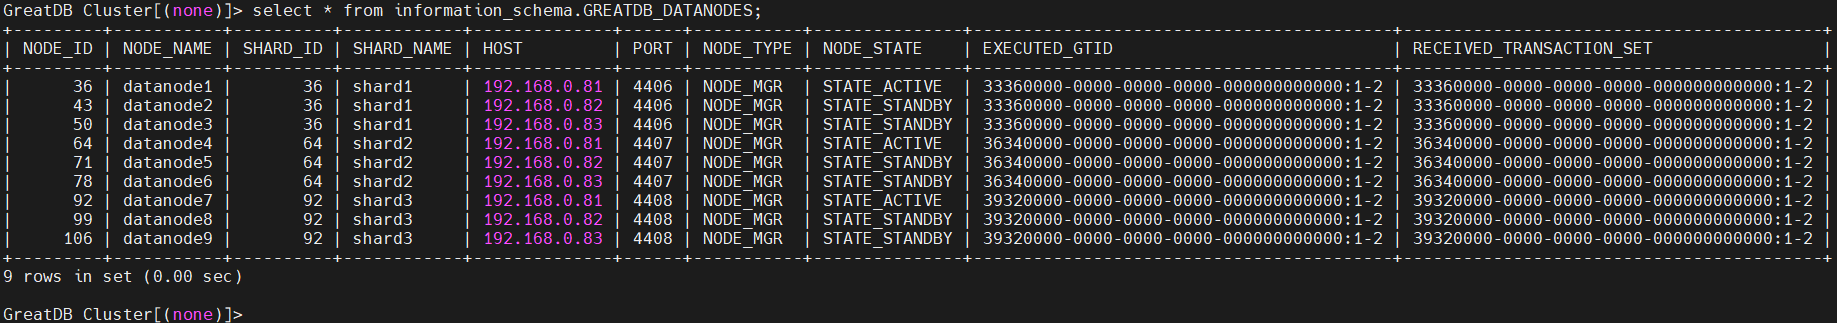
查看数据节点状态
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> select * from information_schema.GREATDB_DATANODES;
查看 SHARD 状态
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> select * from information_schema.GREATDB_SHARDS;
+----------+------------+--------------+---------+
| SHARD_ID | SHARD_NAME | SHARD_STATE  | SUSPEND |
+----------+------------+--------------+---------+
|       36 | shard1     | SHARD_ONLINE | OFF     |
|       64 | shard2     | SHARD_ONLINE | OFF     |
|       92 | shard3     | SHARD_ONLINE | OFF     |
+----------+------------+--------------+---------+
3 rows in set (0.00 sec)
查看 GreatDB 当前节点信息
GreatDB Cluster[(none)]> select * from performance_schema.replication_group_members;
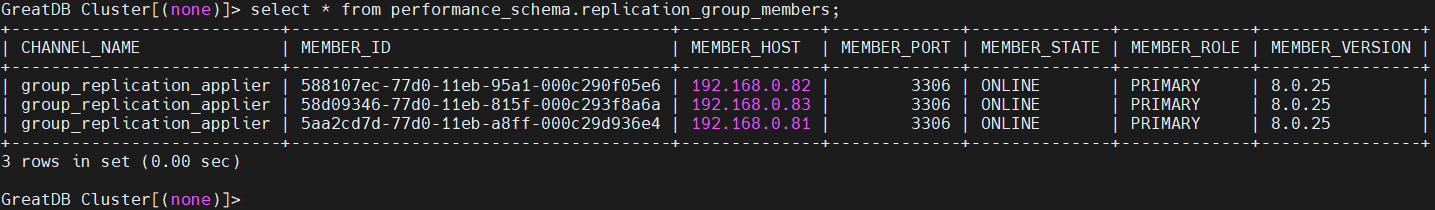
GreatDB 分区表
- 创建分布式分区表
GreatDB Cluster[(none)]> create database test; Query OK, 1 row affected (0.02 sec) GreatDB Cluster[(none)]> create table test.t_hash(c1 int primary key, c2 int) partition by hash(c1) partitions 8; Query OK, 0 rows affected (0.12 sec)登录后复制
- SqlNode 上查看表分布信息
GreatDB Cluster[(none)]> select * from information_schema.GREATDB_TABLE_DISTRIBUTION where table_name='t_hash';
+-------------+------------+----------------+-----------------+------------+----------------+--------------+
| SCHEMA_NAME | TABLE_NAME | BACKEND_ENGINE | DISTRIBUTE_MODE | SHARD_NAME | PARTITION_NAME | PARTITION_ID |
+-------------+------------+----------------+-----------------+------------+----------------+--------------+
| test        | t_hash     | InnoDB         | PARTITION       | shard1     | p0             |            0 |
| test        | t_hash     | InnoDB         | PARTITION       | shard1     | p4             |            4 |
| test        | t_hash     | InnoDB         | PARTITION       | shard2     | p1             |            1 |
| test        | t_hash     | InnoDB         | PARTITION       | shard2     | p3             |            3 |
| test        | t_hash     | InnoDB         | PARTITION       | shard2     | p5             |            5 |
| test        | t_hash     | InnoDB         | PARTITION       | shard2     | p7             |            7 |
| test        | t_hash     | InnoDB         | PARTITION       | shard3     | p2             |            2 |
| test        | t_hash     | InnoDB         | PARTITION       | shard3     | p6             |            6 |
+-------------+------------+----------------+-----------------+------------+----------------+--------------+
8 rows in set (0.00 sec)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69946831/viewspace-3167685/ ,如需转载,请注明出处,否则将追究法律责任。

