GreatDB 系统元数据
GreatDB 元数据类型
1、系统动态视图元数据
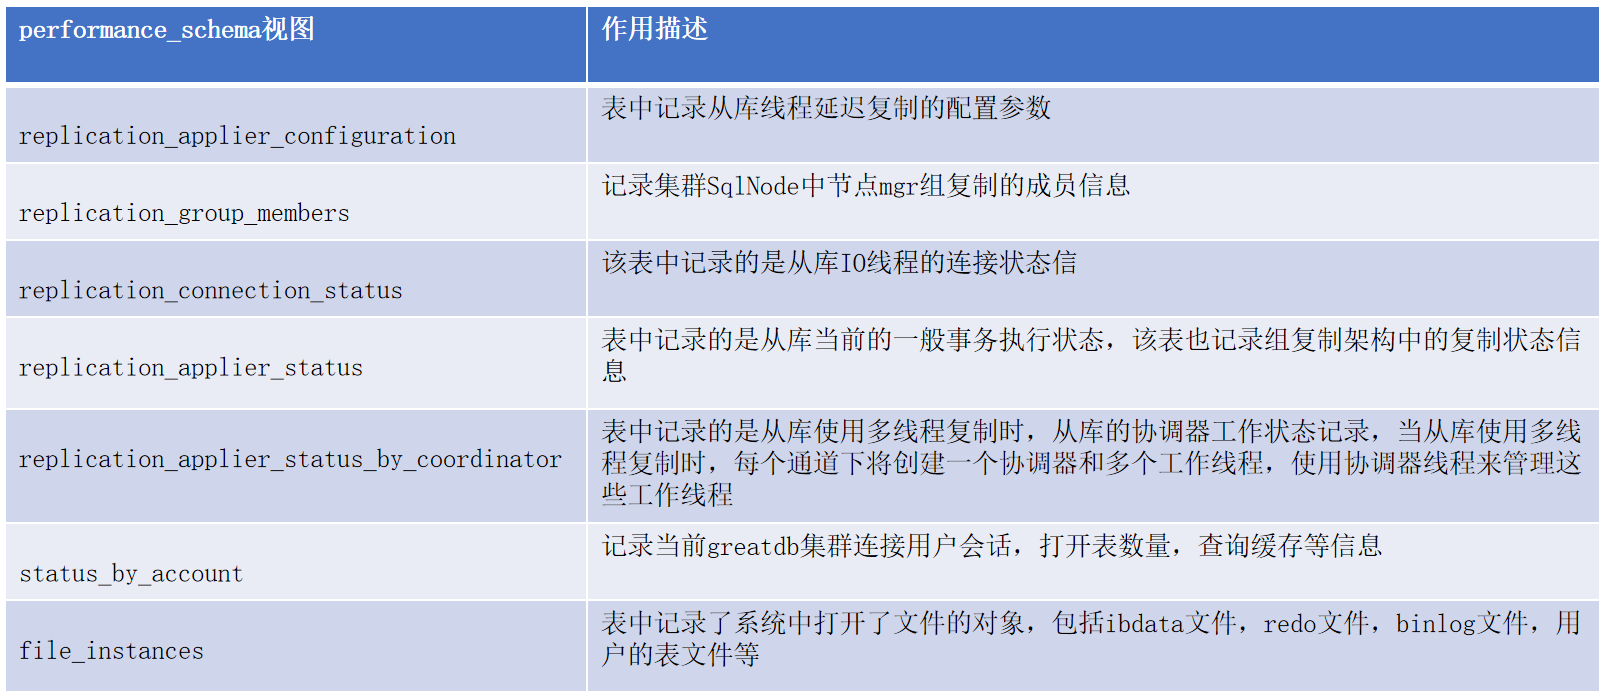
存储在 performance_schema、sys 两个库中。一般记录 SQL 执行 I/O、EVENT 事件、SQL 锁等待、会话链接、集群复制信息等动态元数据,一般用于集群运行参数优化、集群状态巡检等。
2、系统数据字典元数据
存储在 mysql、information_schema 两个库中。一般存储集群用户、权限分配、集群结构元数据、任务执行记录、库表存储空间使用,分片分布情况等内容。用于对集群节点状态,数据库表对象,任务执行等情况进行信息汇总查询,获取业务信息使用。
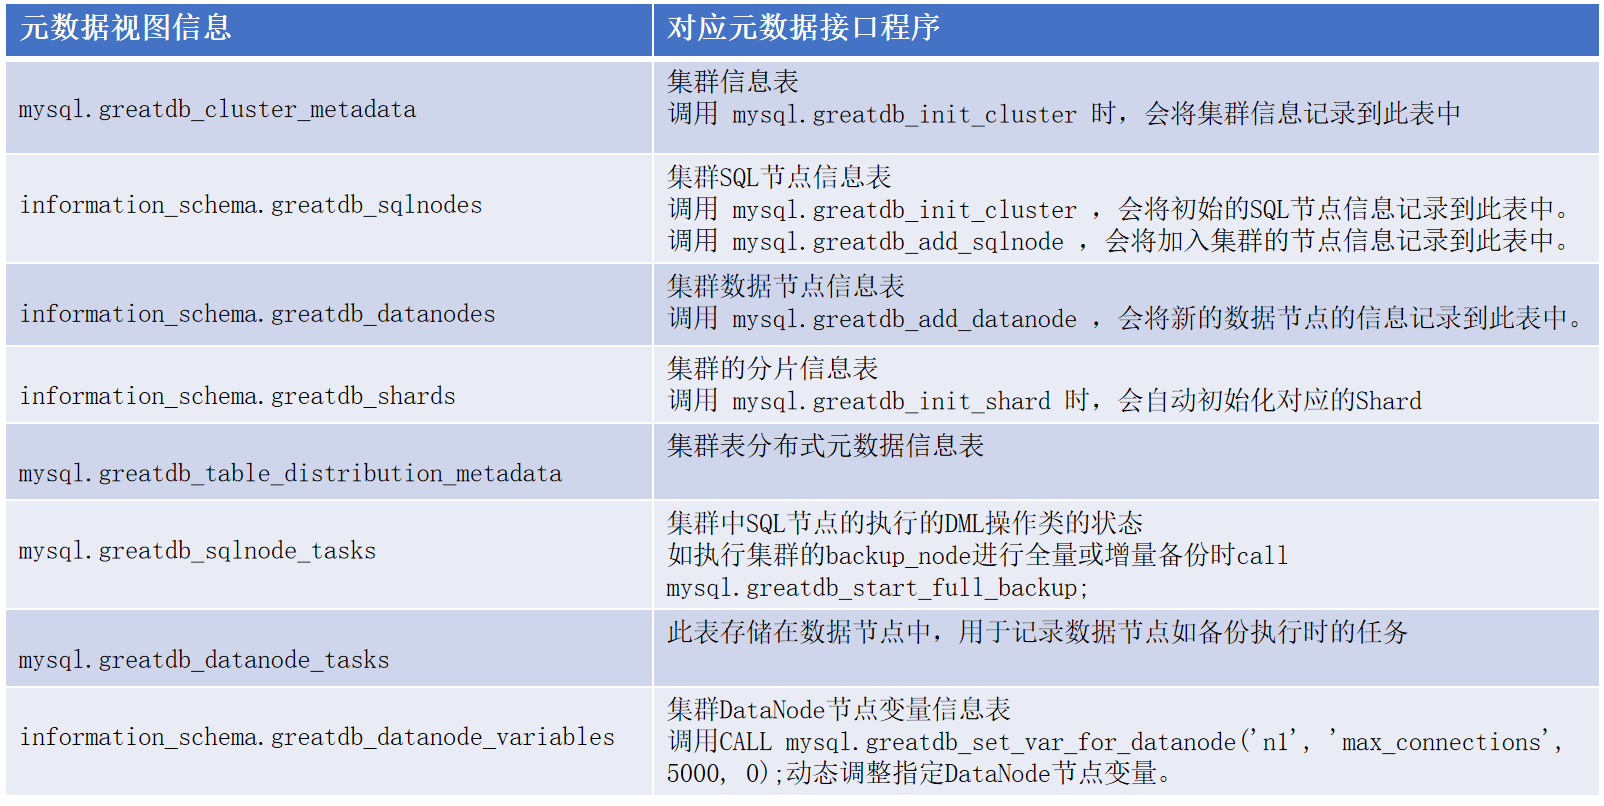
3、节点管理接口元数据
存储在 mysql 库中。一般用于节点的扩容、缩容、数据重分布、集群备份、主从切换、节点启停等管理接口元数据,用于集群节点和架构调整使用。
常用元数据
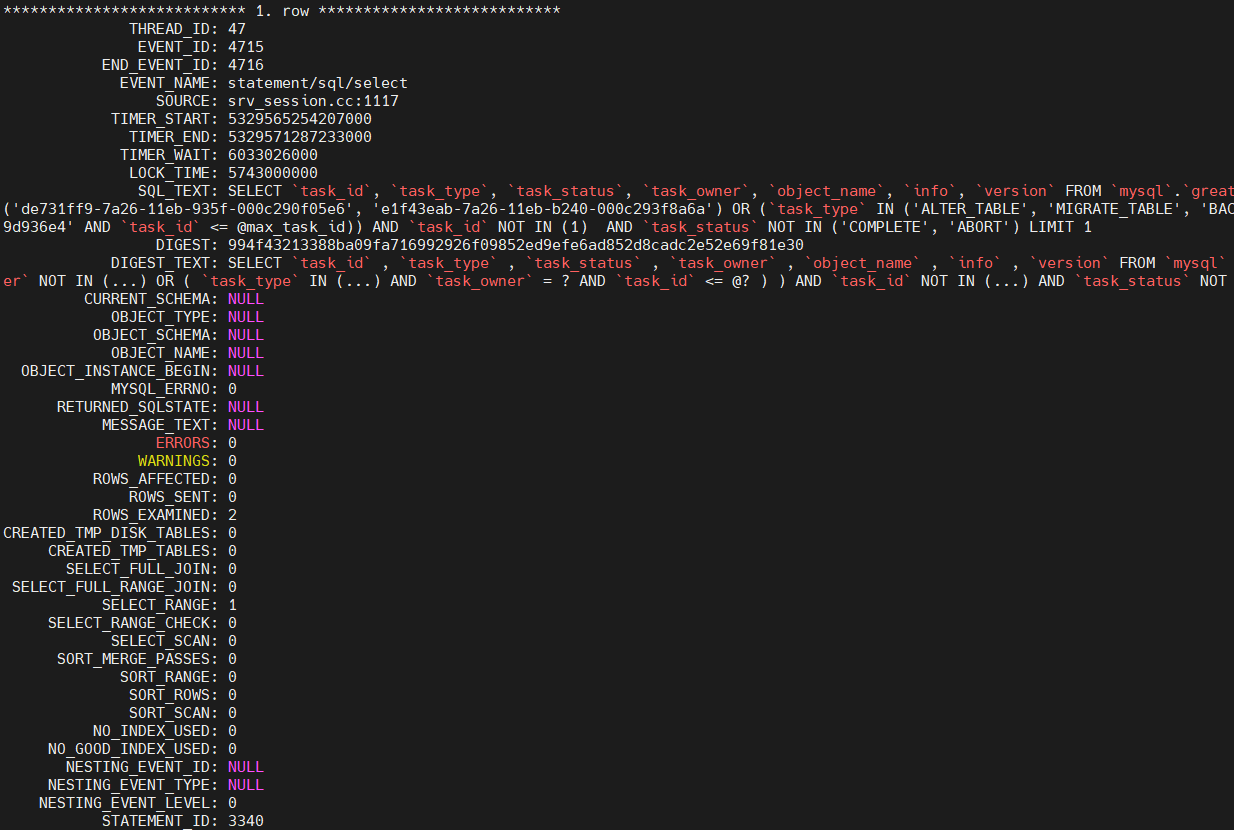
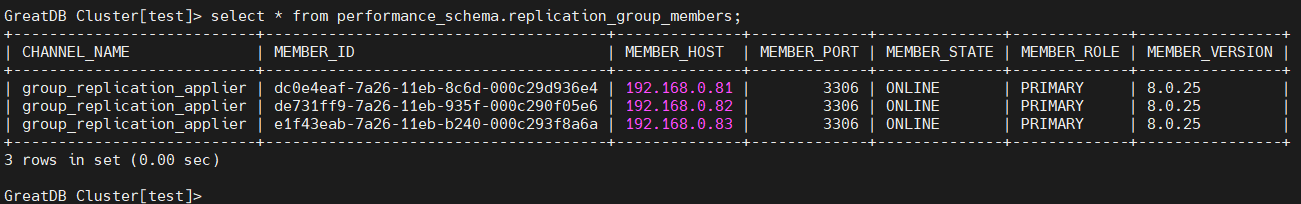
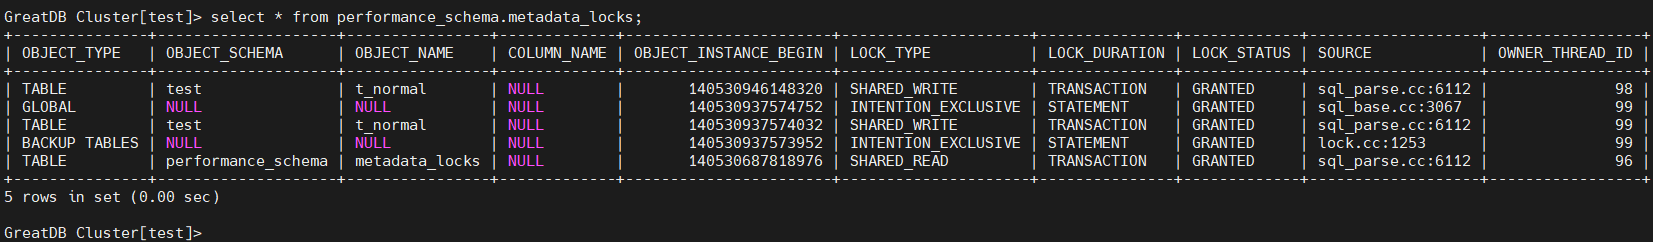
1、查看当前执行SQL的事件信息、复制信息、以及锁相关信息
- performance_schema.events_statements_current
- performance_schema.replication_group_members
- performance_schema.metadata_locks
-- 第一个 session 执行 delete 不提交
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> select * from test.t_normal;
+----+------+
| c1 | c2   |
+----+------+
|  1 |    1 |
|  2 |    2 |
|  3 |    3 |
+----+------+
3 rows in set (0.06 sec)

GreatDB Cluster[(none)]> begin;
Query OK, 0 rows affected (0.00 sec)

GreatDB Cluster[(none)]> delete from test.t_normal where c1=1;
Query OK, 1 row affected (0.00 sec)

-- 第二个 session 执行相同的 delete 被锁住
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> delete from test.t_normal where c1=1;
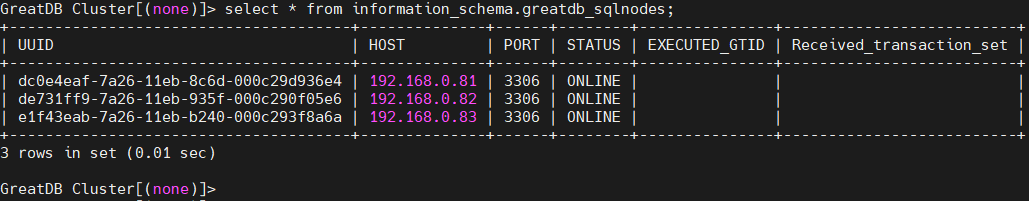
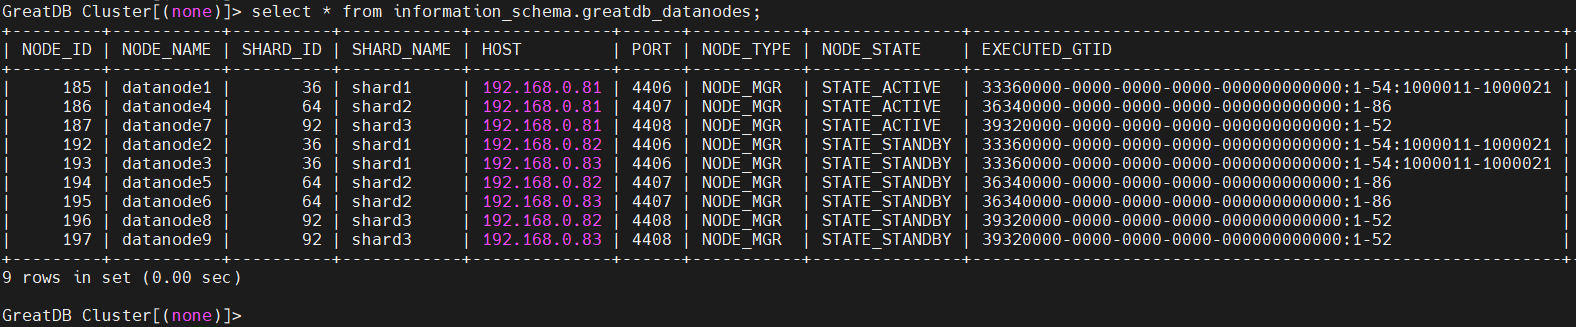
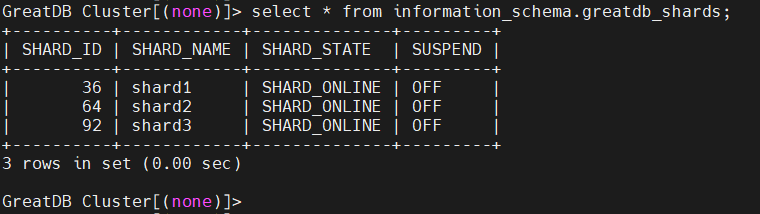
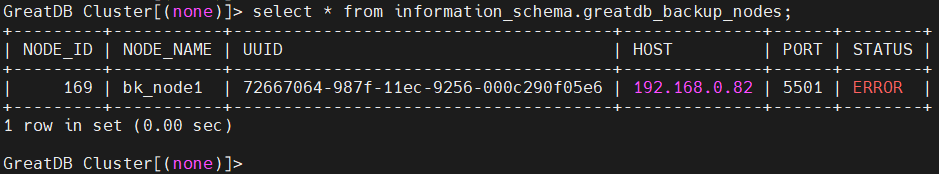
2、查看集群节点运行状态、shard状态、备份节点等集群结构信息
- information_schema.greatdb_sqlnodes、information_schema.greatdb_datanodes
- information_schema.greatdb_shards
- information_schema.greatdb_backup_nodes
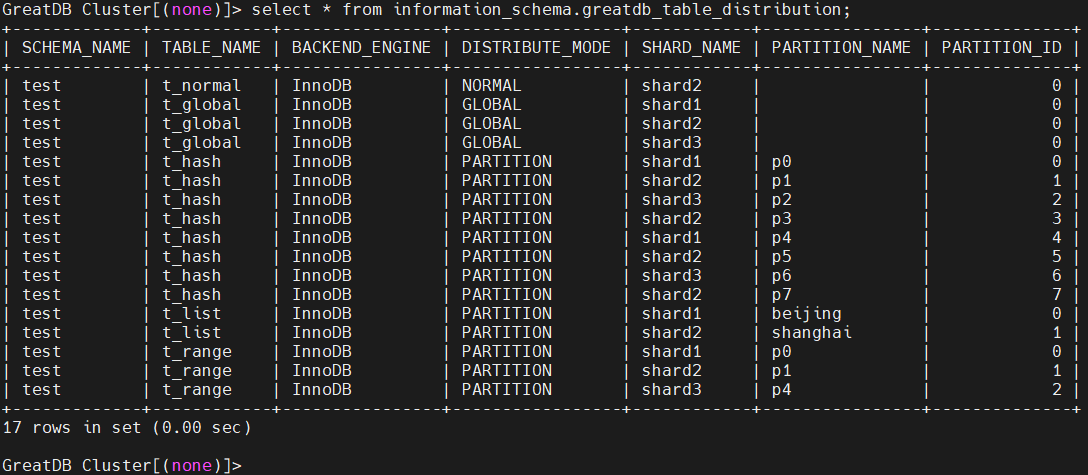
3、查看表的分片分布信息、DDL任务、数据重分布执行情况信息
- information_schema.greatdb_table_distribution
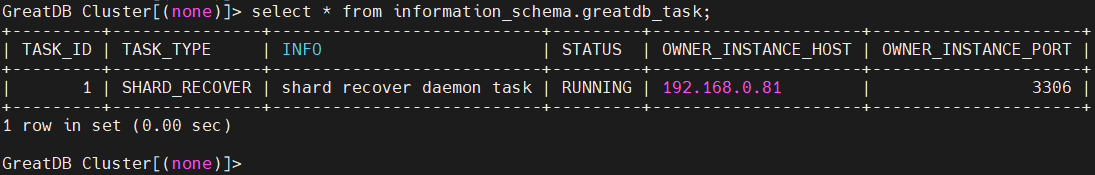
- information_schema.greatdb_task
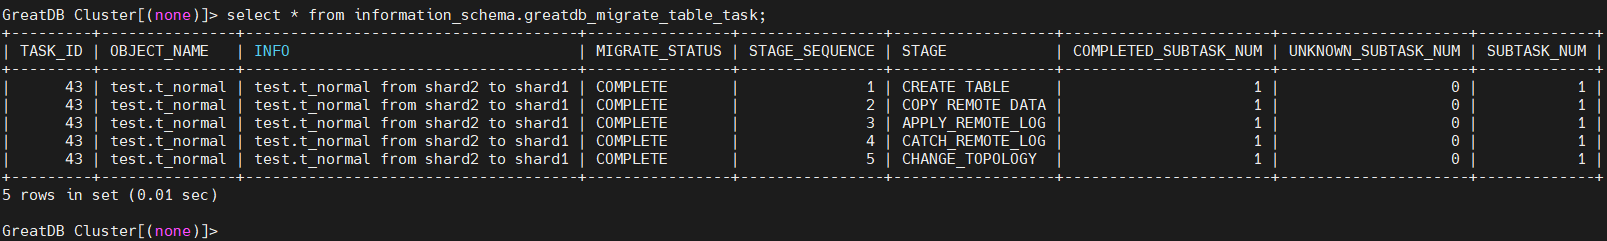
- information_schema.greatdb_migrate_table_task
GreatDB 接口元数据
GreatDB 状态元数据
GreatDB 元数据维护
- SqlNode元数据同步方式:GreatDB节点扩充了MySQL系统表,会将集群元数据写入到系统表中,用户操作任何一个节点改变了集群的元数据,都会通过全同步复制同步到集群其它节点,从而达到元数据强一致的效果。
- 可以通过show plugins查看元数据的扩展库
GreatDB Cluster[(none)]> show plugins;
+---------------------------------+----------+--------------------+----------------------+---------+
| Name                            | Status   | Type               | Library              | License |
+---------------------------------+----------+--------------------+----------------------+---------+
| binlog                          | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| mysql_native_password           | ACTIVE   | AUTHENTICATION     | NULL                 | GPL     |
| sha256_password                 | ACTIVE   | AUTHENTICATION     | NULL                 | GPL     |
| caching_sha2_password           | ACTIVE   | AUTHENTICATION     | NULL                 | GPL     |
| sha2_cache_cleaner              | ACTIVE   | AUDIT              | NULL                 | GPL     |
| daemon_keyring_proxy_plugin     | ACTIVE   | DAEMON             | NULL                 | GPL     |
| PERFORMANCE_SCHEMA              | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| CSV                             | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| MEMORY                          | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| InnoDB                          | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| INNODB_TRX                      | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_CMP                      | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_CMP_RESET                | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_CMPMEM                   | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_CMPMEM_RESET             | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_CMP_PER_INDEX            | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_CMP_PER_INDEX_RESET      | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_BUFFER_PAGE              | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_BUFFER_PAGE_LRU          | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_BUFFER_POOL_STATS        | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_TEMP_TABLE_INFO          | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_METRICS                  | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_FT_DEFAULT_STOPWORD      | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_FT_DELETED               | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_FT_BEING_DELETED         | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_FT_CONFIG                | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_FT_INDEX_CACHE           | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_FT_INDEX_TABLE           | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_TABLES                   | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_TABLESTATS               | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_INDEXES                  | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_TABLESPACES              | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_COLUMNS                  | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_VIRTUAL                  | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_CACHED_INDEXES           | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_SESSION_TEMP_TABLESPACES | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| INNODB_TABLESPACES_ENCRYPTION   | ACTIVE   | INFORMATION SCHEMA | NULL                 | BSD     |
| INNODB_TABLESPACES_SCRUBBING    | ACTIVE   | INFORMATION SCHEMA | NULL                 | BSD     |
| INNODB_CHANGED_PAGES            | ACTIVE   | INFORMATION SCHEMA | NULL                 | GPL     |
| MyISAM                          | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| MRG_MYISAM                      | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| TempTable                       | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| ARCHIVE                         | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| BLACKHOLE                       | ACTIVE   | STORAGE ENGINE     | NULL                 | GPL     |
| FEDERATED                       | DISABLED | STORAGE ENGINE     | NULL                 | GPL     |
| ngram                           | ACTIVE   | FTPARSER           | NULL                 | GPL     |
| mysqlx_cache_cleaner            | ACTIVE   | AUDIT              | NULL                 | GPL     |
| mysqlx                          | ACTIVE   | DAEMON             | NULL                 | GPL     |
| clone                           | ACTIVE   | CLONE              | mysql_clone.so       | GPL     |
| GreatDB                         | ACTIVE   | STORAGE ENGINE     | ha_greatdb.so        | GPL     |
| GREATDB_ALTER_TABLE_SUBTASK     | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_ALTER_TABLE_TASK        | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_BACKUP_NODES            | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_CONNECTION_POOL         | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_DATANODES               | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_DATANODE_STATUS         | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_DATANODE_VARIABLES      | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_DCSTATS                 | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_MIGRATE_TABLE_SUBTASK   | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_MIGRATE_TABLE_TASK      | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_SHARDS                  | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_SQLNODES                | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_SQLNODE_STATUS          | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_SQLNODE_VARIABLES       | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_TABLE_DISTRIBUTION      | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_TASK                    | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| GREATDB_UPGRADE_STATUS          | ACTIVE   | INFORMATION SCHEMA | ha_greatdb.so        | GPL     |
| group_replication               | ACTIVE   | GROUP REPLICATION  | group_replication.so | GPL     |
+---------------------------------+----------+--------------------+----------------------+---------+
68 rows in set (0.00 sec)
GreatDB 集群节点管理
GreatDB 节点类型介绍
GreatDB支持3种角色节点,SqlNode 计算节点、DataNode 数据节点、backup_node 备份节点。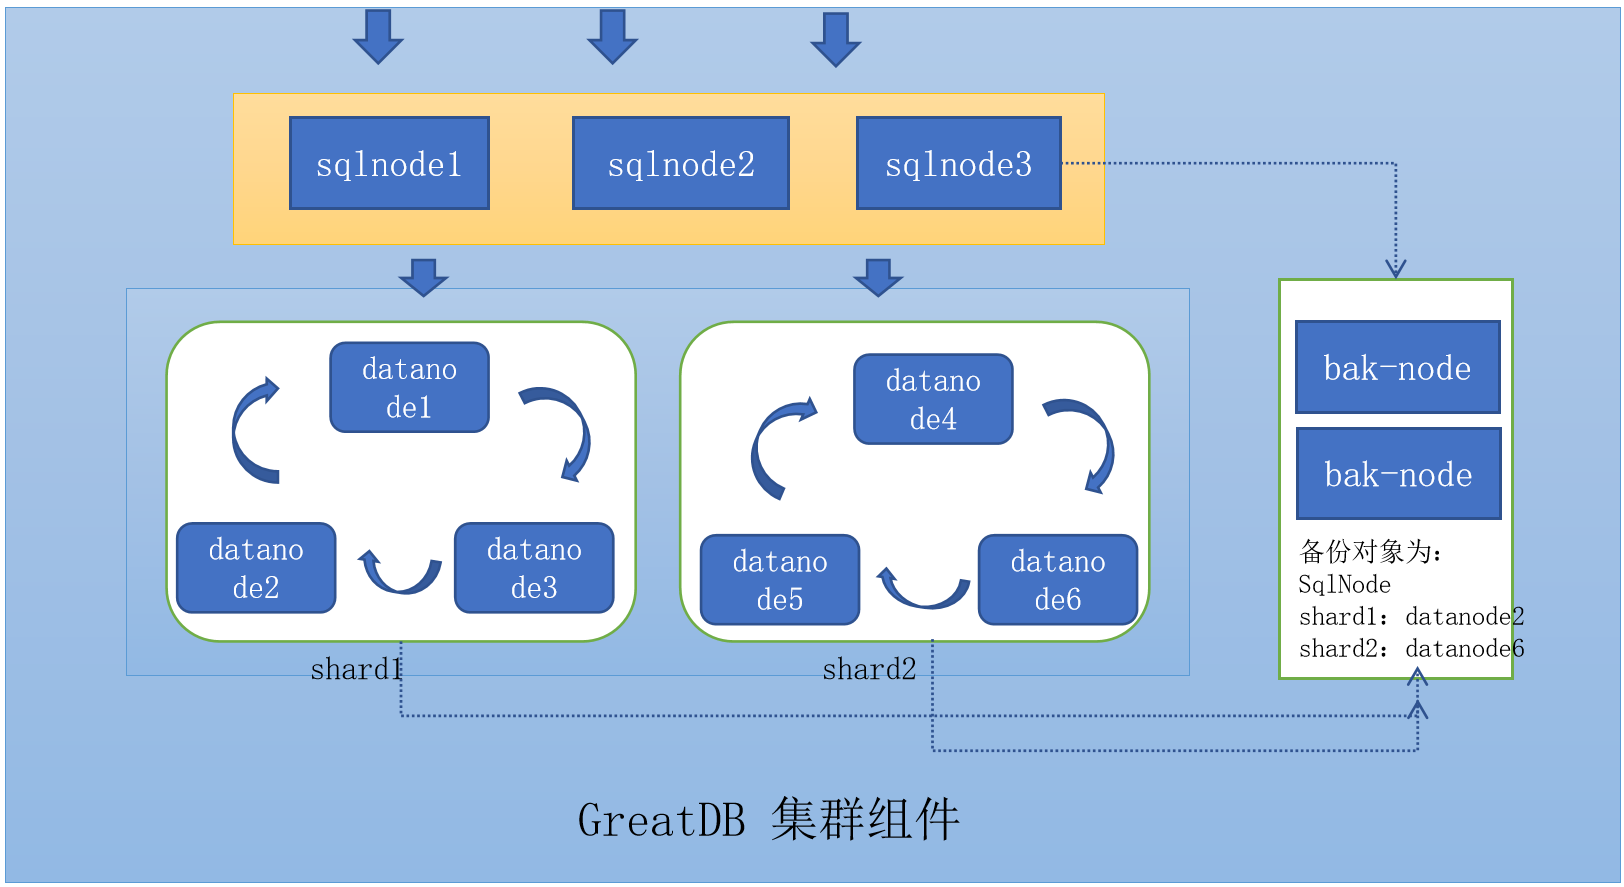
GreatDB 节点可以做哪些管理
1、SqlNode 节点添加、删除
2、DataNode 副本添加、删除
3、新增 Shard 扩容和数据重分布
4、Backup_node 的添加和删除
SqlNode 计算节点的添加与删除
- GreatDB 的扩容分为计算节点扩展和数据节点扩展。计算节点扩容则可以增加更多的业务并发接入,提高集群的计算能力;扩容数据节点,即扩展数据存储节点,则可以存储更多的业务数据,最多可扩展9个节点副本,即9个Shard,每个Shard内可以做到一主九从的节点分布。
- GreatDB的计算节点主要以SQL语句的执行解析为主,其中存储集群元数据,对象结构数据,分片路由,节点任务执行状态等信息对内存和CPU要求较高,对磁盘存储空间要求较小,建议采用高性能SSD作为存储。扩展 Sqlnode 以达到提升业务多点接入,和并发读写操作。
删除 SqlNode 计算节点
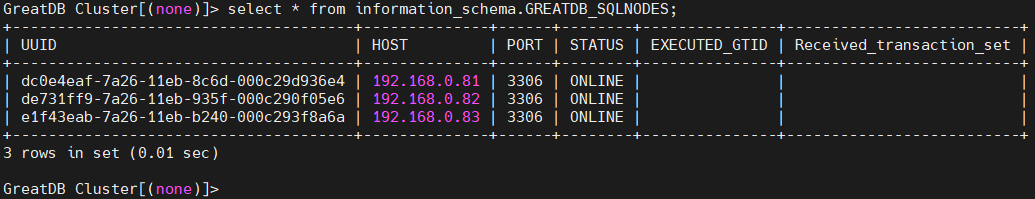
- 查看当前 SqlNode 计算节点
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> select * from information_schema.GREATDB_SQLNODES;
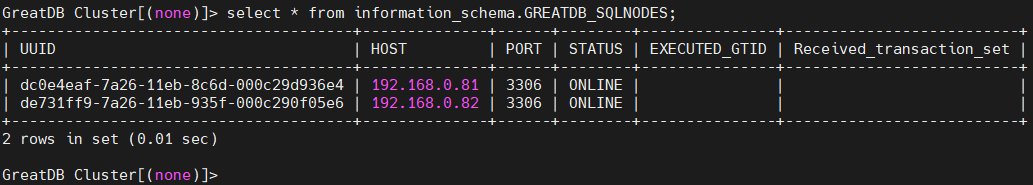
- 调用存储过程执行节点(192.168.0.83)的删除
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> call mysql.greatdb_drop_sqlnode('192.168.0.83',3306);
Query OK, 1 row affected (5.54 sec)
- 停止被删除的数据库实例
[root@greatdb3 ~]# /greatdb/sh/sqlnode3306.sh stop
- 清理被删除节点上的数据文件和配置文件
[root@greatdb3 ~]# rm -rf /greatdb/dbdata/sqlnode3306/
[root@greatdb3 ~]# rm -rf /greatdb/conf/sqlnode3306.cnf
添加 SqlNode 计算节点
添加 SqlNode 节点的步骤
1、使用 greatdb_init 初始化 GreatDB 实例。
2、无业务数据时,可直接登录 GreatDB 集群任一 SqlNode 节点,调用 mysql.greatdb_add_sqlnode 接口添加节点。
3、针对已存储大量业务数据时,新初始化的实例需要从现有节点复制克隆存量数据后,才可执行 sqlnode 添加。
4、查询 information_schema.greatdb_sqlnodes 新加 SqlNode 节点状态。配置实例cnf参数文件
配置实例cnf参数文件方法有两种(推荐使用第二种):
1、使用手动配置方式快速生成核心参数文件。
bash create_config.sh sqlnode4 3307 1 3 > /usr/local/greatdb-cluster/conf/sqlnode4.cnf
此模板接收四个参数,node名称、端口号、自增值偏移、自增值步长
2、拷贝当前运行的 sqlnode 的 cnf,修改后重命名修改为新配置文件。
cp /usr/local/greatdb-cluster/conf/sqlnode3306.cnf /usr/local/greatdb-cluster/conf/sqlnode3307.cnf
替换修改:sed -i ‘s/3306/3307/g’ sqlnode3307.cnf 相关端口,目录名,server-id等信息
# 从现有节点将配置文件复制到新节点上
[root@greatdb1 ~]# scp -rp /greatdb/conf/sqlnode3306.cnf 192.168.0.83:/greatdb/conf/
# 在新节点上修改配置文件,根据实际情况修改
[root@greatdb3 ~]# sed -i 's/192.168.0.81/192.168.0.83/g' /greatdb/conf/sqlnode3306.cnf
- 在新节点上创建 cnf 中指定的目录并授权
[root@greatdb3 ~]# mkdir -p /greatdb/dbdata/sqlnode3306/{data,log,tmp}
[root@greatdb3 ~]# chown -R greatdb:greatdb /greatdb
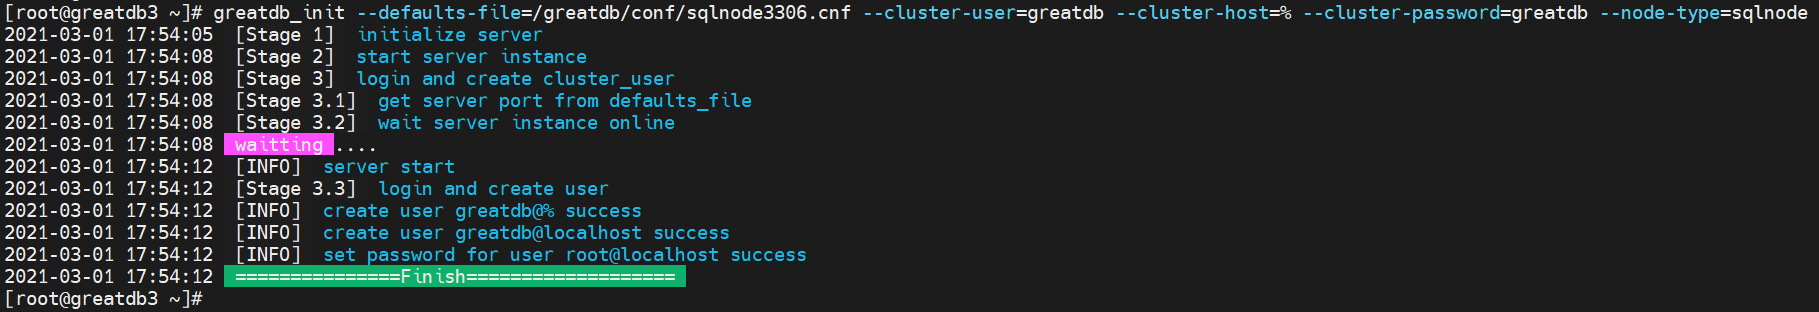
- 在新节点上使用 greatdb_init 初始化 GreatDB 实例
[root@greatdb3 ~]# greatdb_init --defaults-file=/greatdb/conf/sqlnode3306.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=sqlnode
- 从现有节点复制克隆存量数据到新实例
1、无业务数据时,可直接登录 GreatDB 集群任一 SqlNode 节点,调用 mysql.greatdb_add_sqlnode 接口添加节点。
2、针对已存储大量业务数据时,新初始化的实例需要从现有节点复制克隆存量数据后,才可执行sqlnode添加。
-- 登录到新节点实例
[root@greatdb3 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.83 -P3306
-- 在新节点实例中安装 clone 插件
GreatDB Cluster[(none)]> install plugin clone soname 'mysql_clone.so';
Query OK, 0 rows affected (0.01 sec)
-- 或调用存储过程安装 clone 插件
GreatDB Cluster[(none)]> call mysql.greatdb_install_clone_plugin();
-- 在新节点实例中配置参数 clone_valid_donor_list,指定有哪里获取数据
GreatDB Cluster[(none)]> set global clone_valid_donor_list = '192.168.0.81:3306';
Query OK, 0 rows affected (0.00 sec)
-- 执行 clone 实例操作
GreatDB Cluster[(none)]> clone instance from greatdb@'192.168.0.81':3306 identified by 'greatdb';
Query OK, 0 rows affected (2.94 sec)
-- clone 完成之后实例会被重启
GreatDB Cluster[(none)]> show global status like 'uptime';
ERROR 2013 (HY000): Lost connection to MySQL server during query
No connection. Trying to reconnect...
Connection id:    8
Current database: *** NONE ***

+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| Uptime        | 137   |
+---------------+-------+
1 row in set (0.02 sec)

-- 查看数据库也存在之前的测试库 test
GreatDB Cluster[(none)]> show databases;
+--------------------+
| Database           |
+--------------------+
| information_schema |
| mysql              |
| performance_schema |
| sys                |
| test               |
+--------------------+
5 rows in set (0.00 sec)
- 调用 mysql.greatdb_add_sqlnode 接口添加节点
# 登录 GreatDB 集群现有任一 SqlNode 节点,调用 mysql.greatdb_add_sqlnode 接口添加节点
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> call mysql.greatdb_add_sqlnode('192.168.0.83',3306);
Query OK, 0 rows affected (2.97 sec)

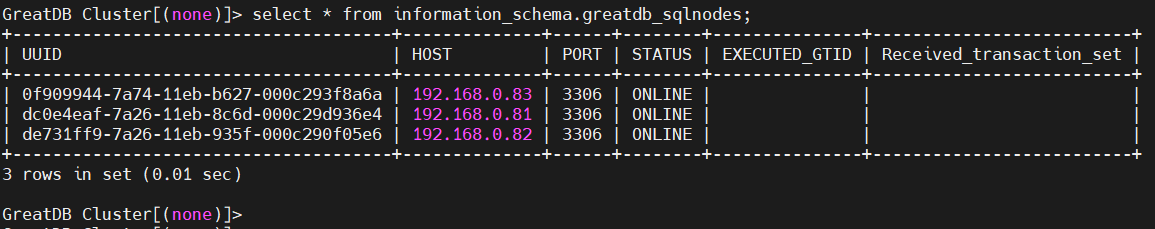
# 查询 information_schema.greatdb_sqlnodes 新加 sqlnode 节点状态
GreatDB Cluster[(none)]> select * from information_schema.greatdb_sqlnodes;
DataNode 存储节点的添加与删除
GreatDB 提供灵活的在线存储节点扩容或缩容,且扩容后可实现 DataNode 存储层,各 Shard 间的数据重分布,以增加整体存储和运算能力。
扩容或缩容分为2种:
1、添加或删除 Shard 内的从节点
2、添加或删除新的 Shard 分片节点组,以达到扩容存储和提升运算能力目的。
删除 Shard 分片内的 DataNode 节点
- 删除 DataNode 的注意事项。
- 如果数据节点正常提供服务,会同时停⽌节点的组复制关系
- 如果节点是 shard 组中最后一个数据节点,且 shard 中包含了用户表数据,此时,⽆法删除节点
- 如果 shard 异常,没有任何节点可以提供读写服务,⽆法删除节点
- 如果节点是 shard 组中最后一个数据节点,需要用户保证 binlog-server 同步完该 shard 上的数据
- 调整主从节点角色关系
如果删除的节点是从节点可以忽略此步骤,如果删除的节点是 shard 组中的主节点,建议手动切换主从角色,将主节点切换到 shard 组中的其他节点上。
# 手动做主从角色切换,例如将 shard1 的主节点切换到 datanode2 上
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
# 传递两个参数,一个是要做主从角色切换的 SHARD_NAME,另一个是要将主节点切换到哪个 NODE_NAME 上。
GreatDB Cluster[(none)]> call mysql.greatdb_change_shard_primary_node('shard1','datanode2');
Query OK, 1 row affected (1.08 sec)
GreatDB Cluster[(none)]> select * from information_schema.GREATDB_SQLNODES;
示例,我要删除 datanode7(192.168.0.81:4408) DataNode 节点,此时 datanode7 是 shard3 的主节点,状态为 STATE_ACTIVE,将其切换到 datanode8(192.168.0.82:4408) DataNode 节点。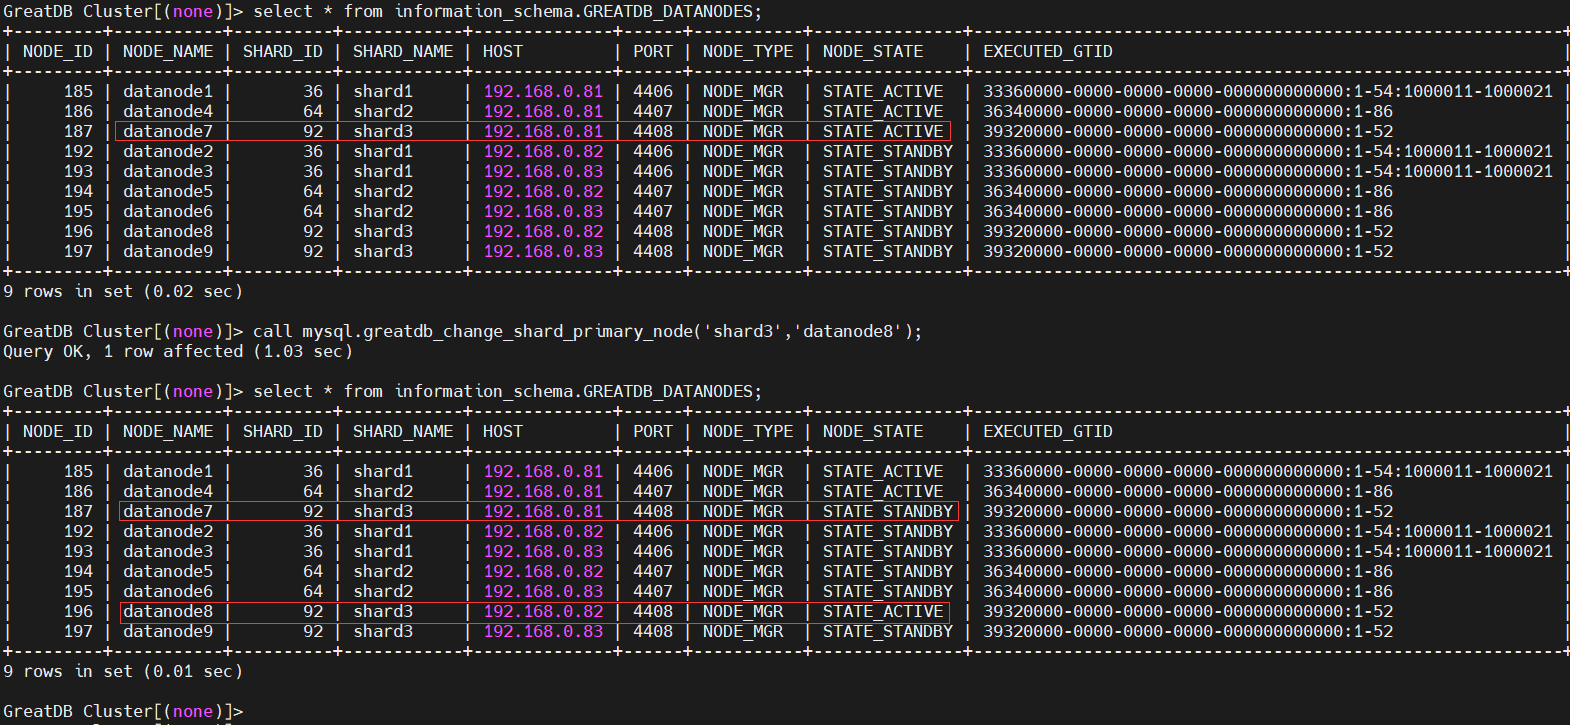
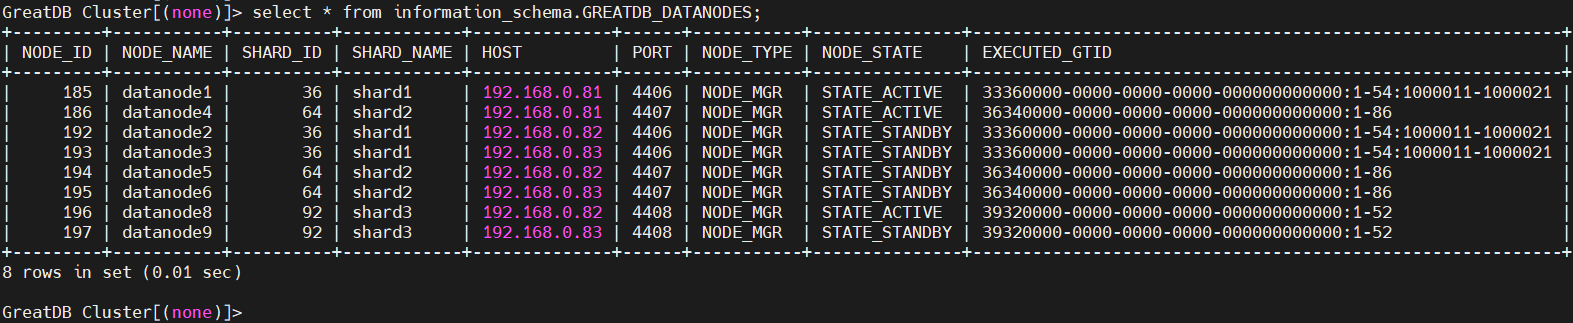
- 调用存储过程执行节点 datanode7(192.168.0.81:4408) 的删除
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> call mysql.greatdb_drop_datanode('datanode7');
Query OK, 1 row affected (5.50 sec)
- 停止被删除的 DataNode 节点实例
[root@greatdb1 ~]# /greatdb/sh/datanode4408.sh stop
- 清理被删除节点上的数据文件和配置文件
[root@greatdb1 ~]# rm -rf /greatdb/dbdata/datanode4408/
[root@greatdb1 ~]# rm -rf /greatdb/conf/datanode4408.cnf
添加 Shard 分片内的 DataNode 节点
- 配置实例cnf参数文件
# 从现有节点将配置文件复制到新节点上
[root@greatdb2 ~]# scp -rp /greatdb/conf/datanode4408.cnf 192.168.0.81:/greatdb/conf/
# 在新节点上修改配置文件,根据实际情况修改
[root@greatdb1 ~]# sed -i 's/192.168.0.82/192.168.0.81/g' /greatdb/conf/datanode4408.cnf
- 在新节点上创建 cnf 中指定的目录并授权
[root@greatdb1 ~]# mkdir -p /greatdb/dbdata/datanode4408/{data,log,tmp}
[root@greatdb1 ~]# chown -R greatdb:greatdb /greatdb
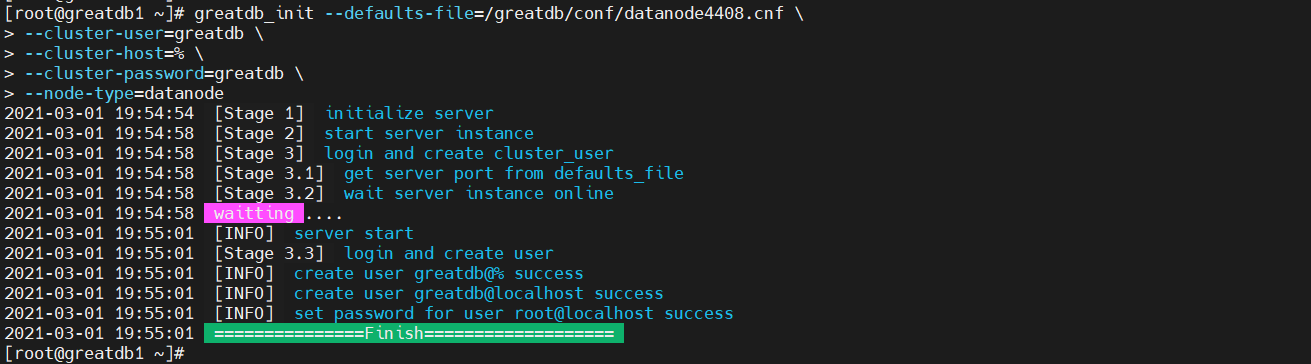
- 在新节点上使用 greatdb_init 初始化 GreatDB 实例
[root@greatdb1 ~]# greatdb_init --defaults-file=/greatdb/conf/datanode4408.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=datanode
- 调用 mysql.greatdb_add_datanode 接口添加节点
# 登录 GreatDB 集群现有任一 SqlNode 节点,调用 mysql.greatdb_add_datanode 接口添加节点
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard3','datanode7','192.168.0.81',4408,'NODE_MGR');
Query OK, 1 row affected (3.95 sec)
# 当前节点支持 NODE_MGR 和 NODE_SINGLE 两种类型,NODE_SINGLE 表示Shard 中只有一个数据节点,此时无法保证数据的可靠性,不推荐线上环境使用;
# NODE_MGR 类型可以包含多个数据节点,节 点间使用 mysql group_replication 进行数据同步和故障切换。

# 查询 information_schema.greatdb_sqlnodes 新加 sqlnode 节点状态
GreatDB Cluster[(none)]> select * from information_schema.greatdb_sqlnodes;
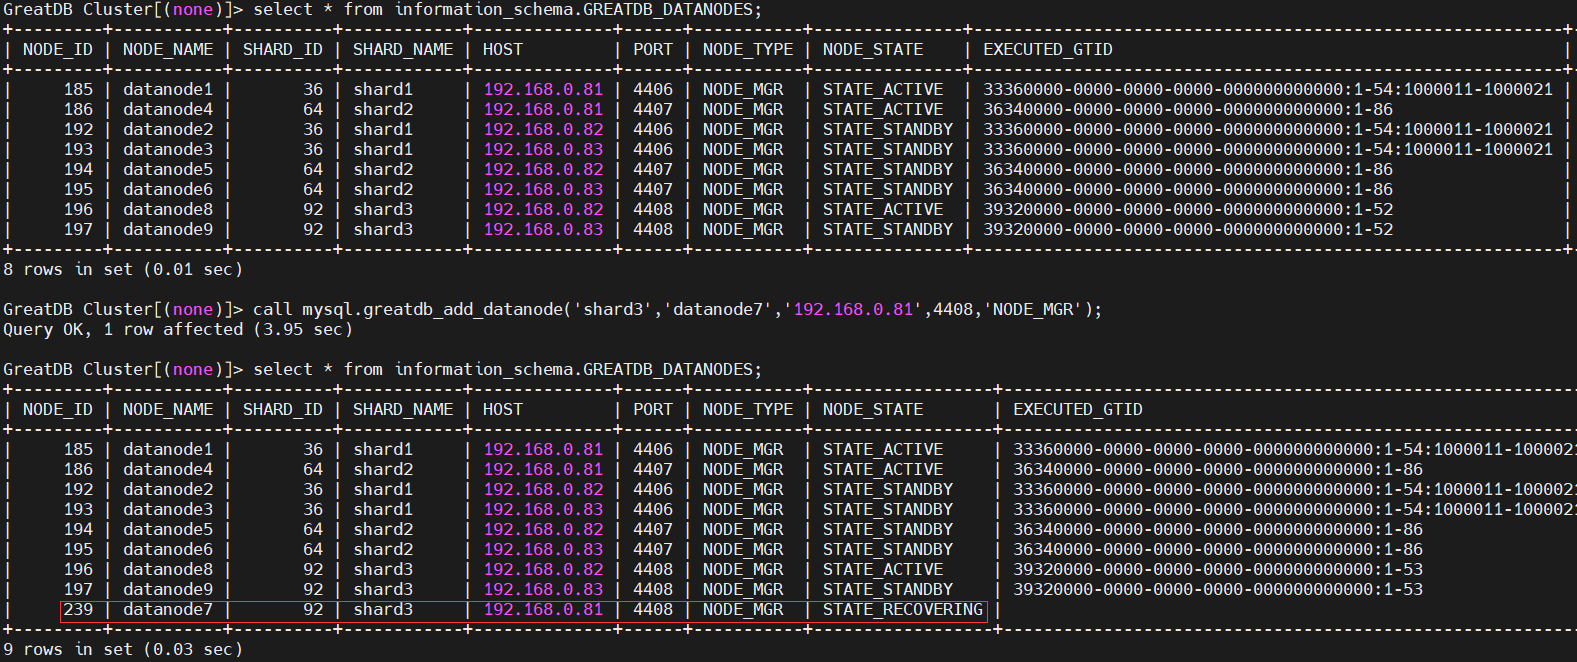
此时在自动做恢复并重启节点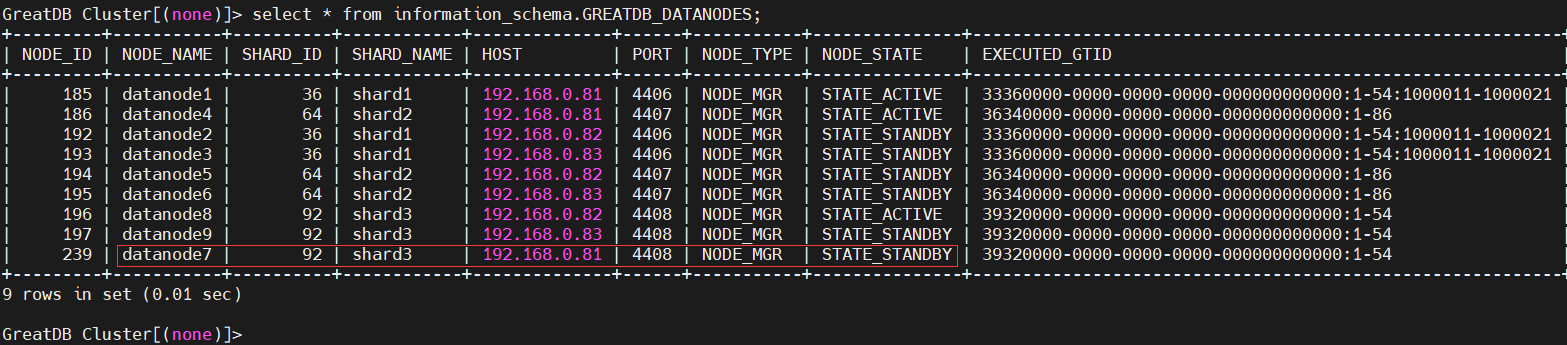
最后节点会以 STATE_STANDBY 状态加入到集群。
添加 Shard 分片
新增Shard分片步骤:
1、初始化各物理机准备加入 Shard 的新实例。
2、sqlnode 调用 mysql.greatdb_add_datanode 接口创建新 Shard。
3、sqlnode 调用 mysql.greatdb_init_shard 接口初始化新的 Shard 分片。
4、另外2个节点分别调用步骤2的方式加入Shard,完成扩容。查看当前 Shard 的信息以及 Shard 中数据表的分布情况
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> select * from information_schema.GREATDB_DATANODES;
GreatDB Cluster[(none)]> select * from information_schema.greatdb_shards;
GreatDB Cluster[(none)]> select * from information_schema.greatdb_table_distribution;
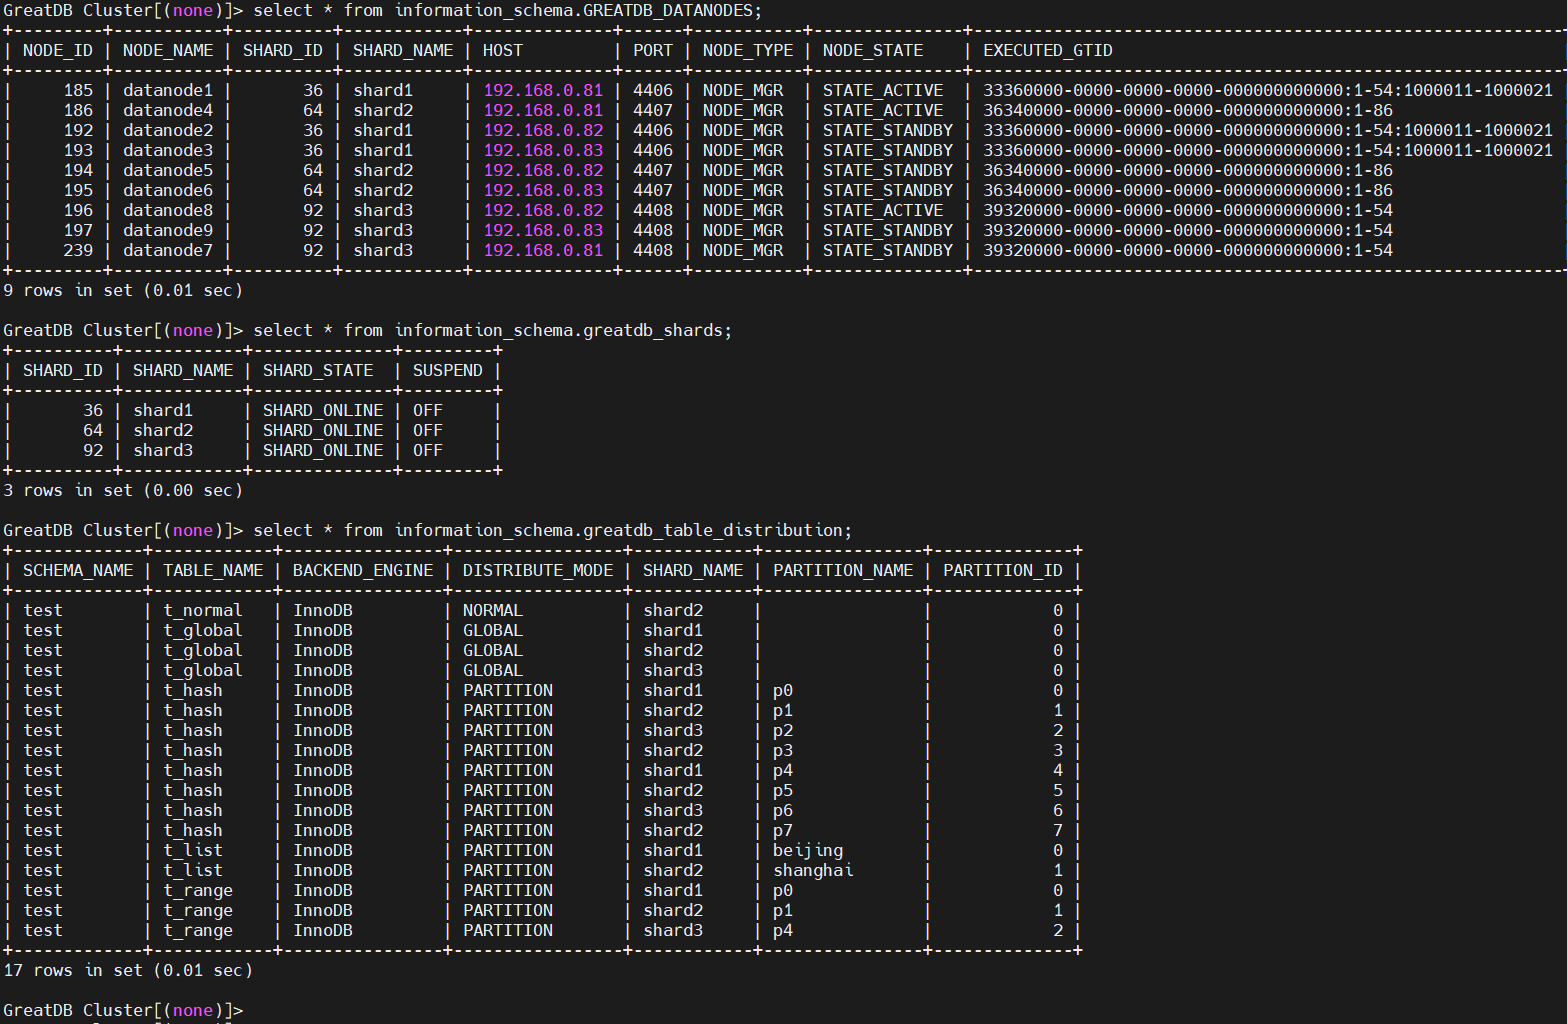
- 增加 shard4 ,组成员有 192.168.0.81:4409、192.168.0.82:4409、192.168.0.83:4409
- 配置 shard4 的3个组成员实例cnf参数文件
# 从现有节点将配置文件复制到新节点上
[root@greatdb1 ~]# cp -p /greatdb/conf/datanode4408.cnf /greatdb/conf/datanode4409.cnf
[root@greatdb2 ~]# cp -p /greatdb/conf/datanode4408.cnf /greatdb/conf/datanode4409.cnf
[root@greatdb3 ~]# cp -p /greatdb/conf/datanode4408.cnf /greatdb/conf/datanode4409.cnf
# 在新节点上修改配置文件,根据实际情况修改
[root@greatdb1 ~]# sed -i 's/4408/4409/g' /greatdb/conf/datanode4409.cnf
[root@greatdb2 ~]# sed -i 's/4408/4409/g' /greatdb/conf/datanode4409.cnf
[root@greatdb3 ~]# sed -i 's/4408/4409/g' /greatdb/conf/datanode4409.cnf
- 在新节点上创建 cnf 中指定的目录并授权
[root@greatdb1 ~]# mkdir -p /greatdb/dbdata/datanode4409/{data,log,tmp}
[root@greatdb1 ~]# chown -R greatdb:greatdb /greatdb
[root@greatdb2 ~]# mkdir -p /greatdb/dbdata/datanode4409/{data,log,tmp}
[root@greatdb2 ~]# chown -R greatdb:greatdb /greatdb
[root@greatdb3 ~]# mkdir -p /greatdb/dbdata/datanode4409/{data,log,tmp}
[root@greatdb3 ~]# chown -R greatdb:greatdb /greatdb
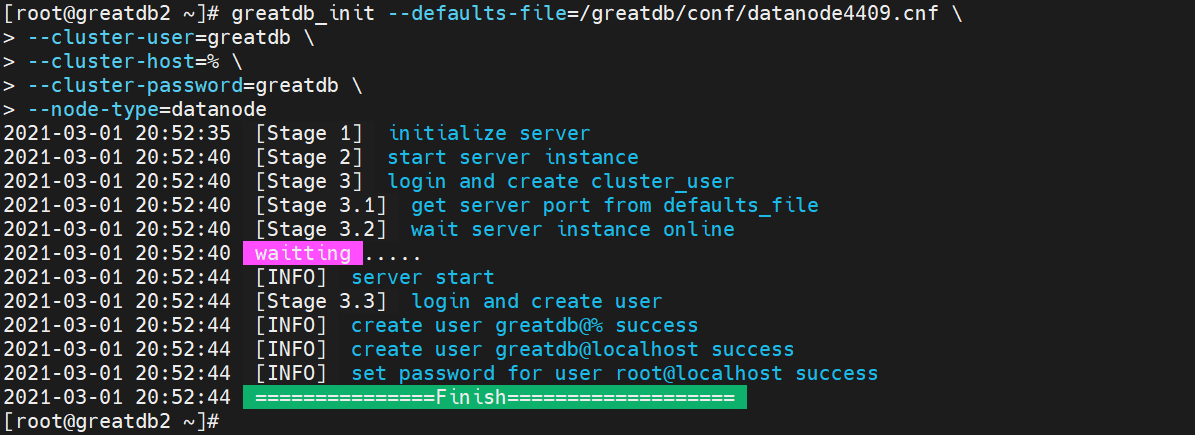
- 在新节点上使用 greatdb_init 初始化 GreatDB 实例
[root@greatdb1 ~]# greatdb_init --defaults-file=/greatdb/conf/datanode4409.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=datanode

[root@greatdb2 ~]# greatdb_init --defaults-file=/greatdb/conf/datanode4409.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=datanode

[root@greatdb3 ~]# greatdb_init --defaults-file=/greatdb/conf/datanode4409.cnf \
--cluster-user=greatdb \
--cluster-host=% \
--cluster-password=greatdb \
--node-type=datanode
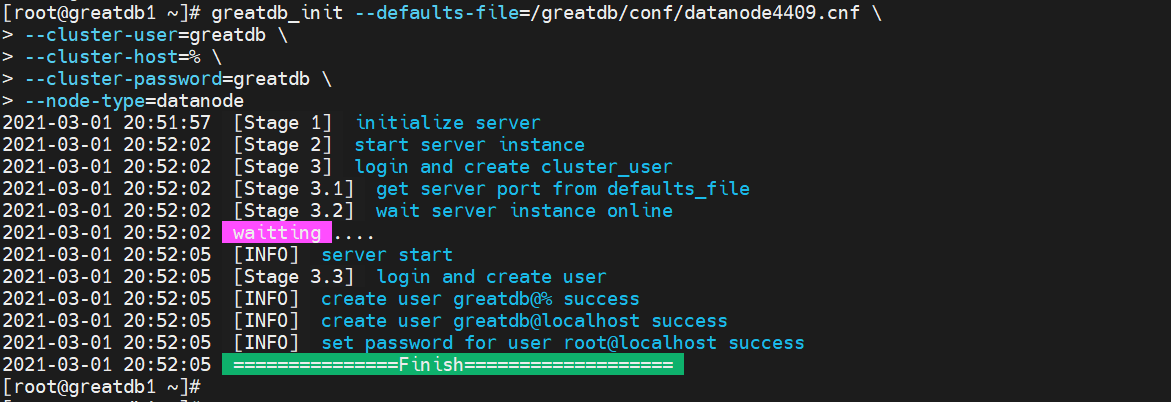
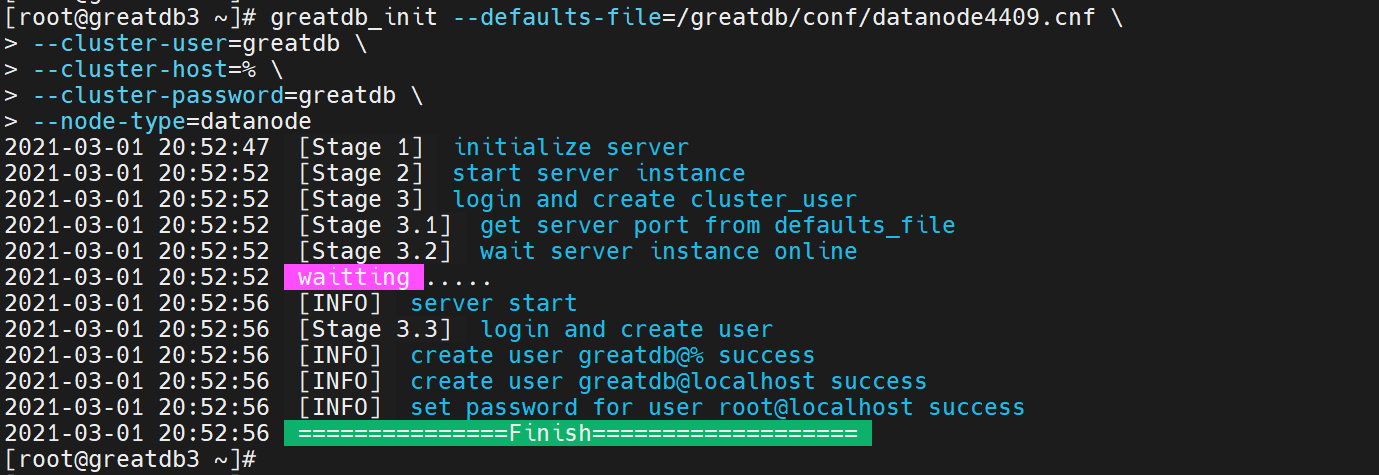
- 添加一个新数据节点到新 Shard
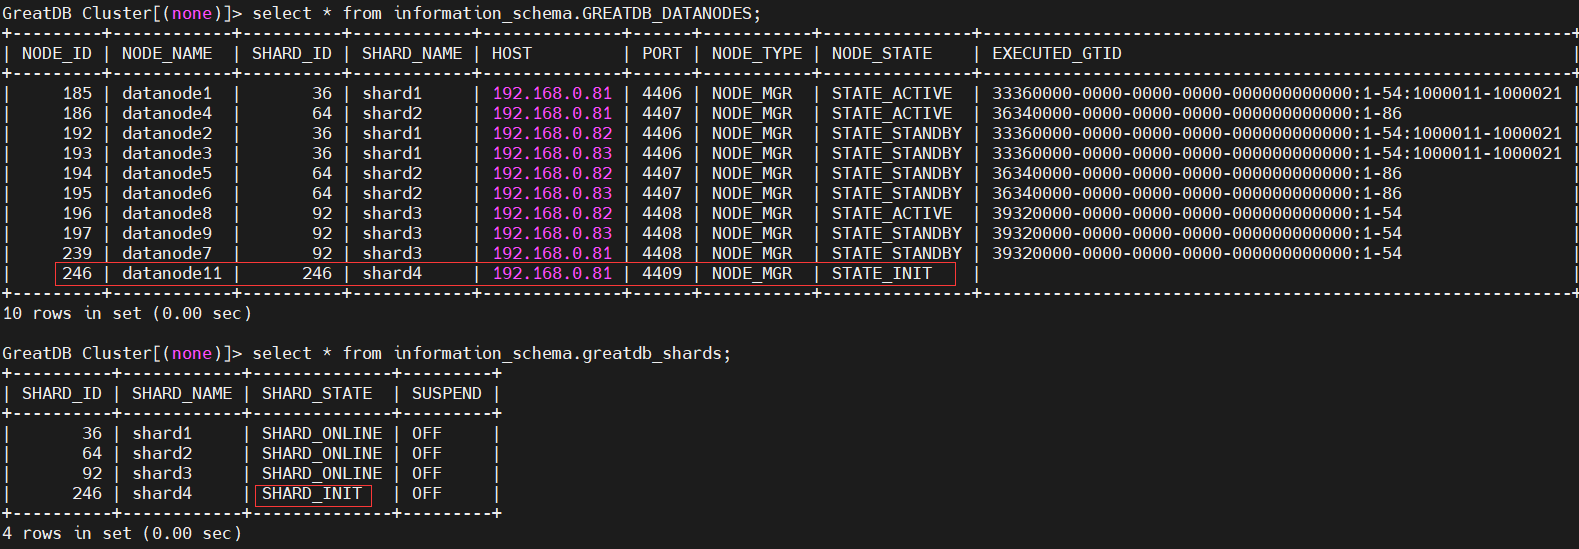
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard4','datanode11','192.168.0.81',4409,'NODE_MGR');
Query OK, 1 row affected (0.07 sec)

GreatDB Cluster[(none)]> select * from information_schema.GREATDB_DATANODES;
GreatDB Cluster[(none)]> select * from information_schema.greatdb_shards;
- 初始化 shard4
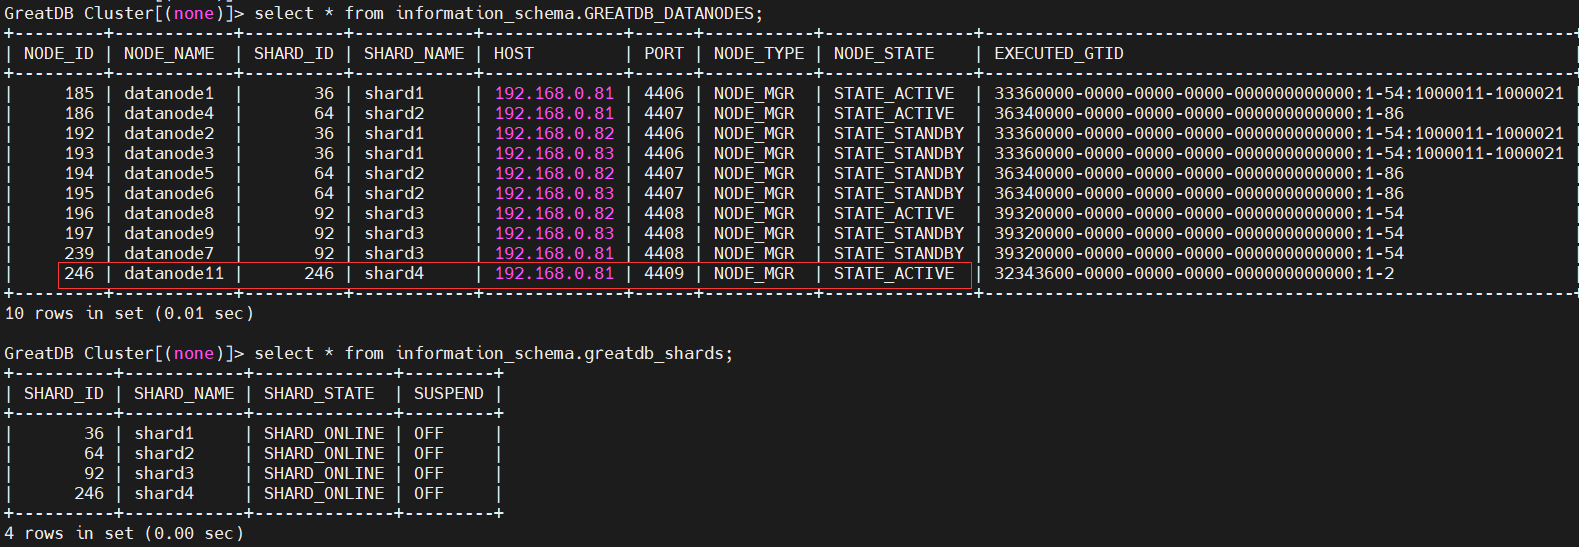
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> call mysql.greatdb_init_shard('shard4');
Query OK, 1 row affected (4.54 sec)

GreatDB Cluster[(none)]> select * from information_schema.GREATDB_DATANODES;
GreatDB Cluster[(none)]> select * from information_schema.greatdb_shards;
- 添加另外两个节点到 shard4 中
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306
GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard4','datanode12','192.168.0.82',4409,'NODE_MGR');
Query OK, 1 row affected (4.15 sec)
GreatDB Cluster[(none)]> call mysql.greatdb_add_datanode('shard4','datanode13','192.168.0.83',4409,'NODE_MGR');
Query OK, 1 row affected (3.95 sec)

GreatDB Cluster[(none)]> select * from information_schema.GREATDB_DATANODES;
GreatDB Cluster[(none)]> select * from information_schema.greatdb_table_distribution;
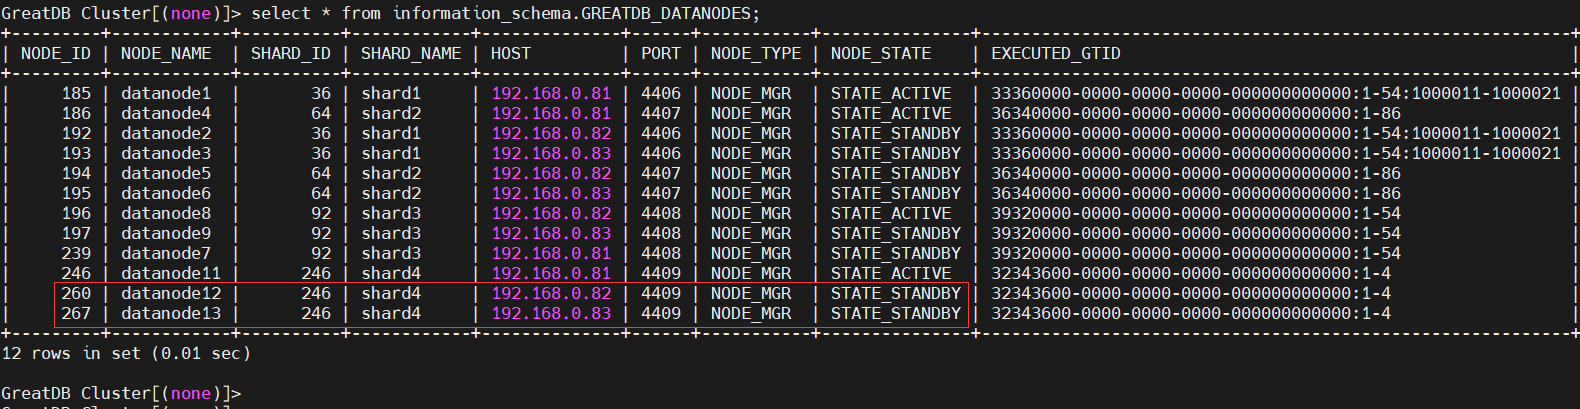
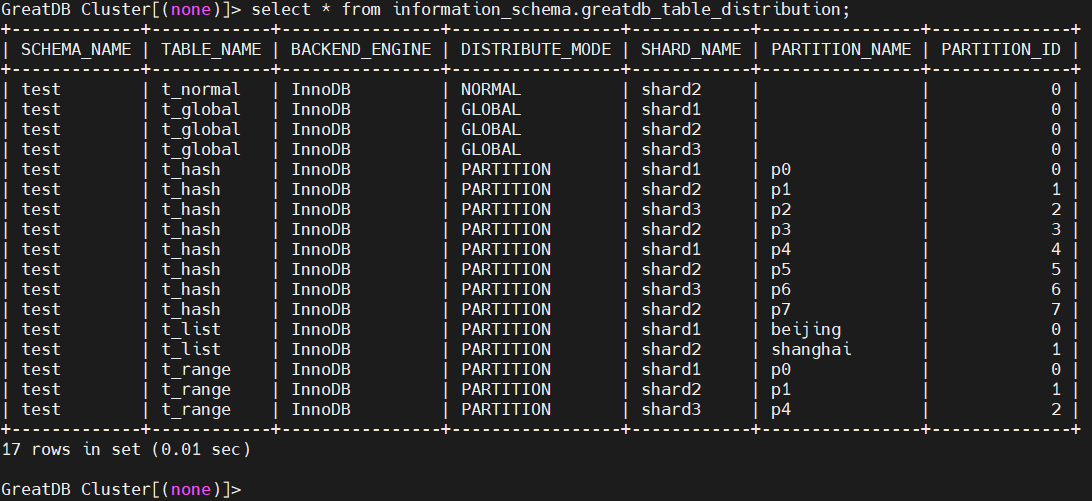
添加 shard4 完成后,数据表还是分散在原有的Shard分片中,有两种方式可以进行数据表在Shard分片上的重分布,一种是调用存储过程 mysql.greatdb_migrate_table 进行手动重分布,如果数据表比较多的情况下比较麻烦,另一种是调用存储过程 mysql.greatdb_auto_migrate_tables_after_upscale 自动进行重分布。
- 数据表自动在 Shard 分片上重分布
调用存储过程 mysql.greatdb_auto_migrate_tables_after_upscale 自动进行重分布,只会重分布分区表和全局表,对于普通表是不生效的。
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> call mysql.greatdb_auto_migrate_tables_after_upscale;
GreatDB Cluster[(none)]> select * from information_schema.GREATDB_MIGRATE_TABLE_TASK;

GreatDB Cluster[(none)]> select * from information_schema.greatdb_table_distribution;
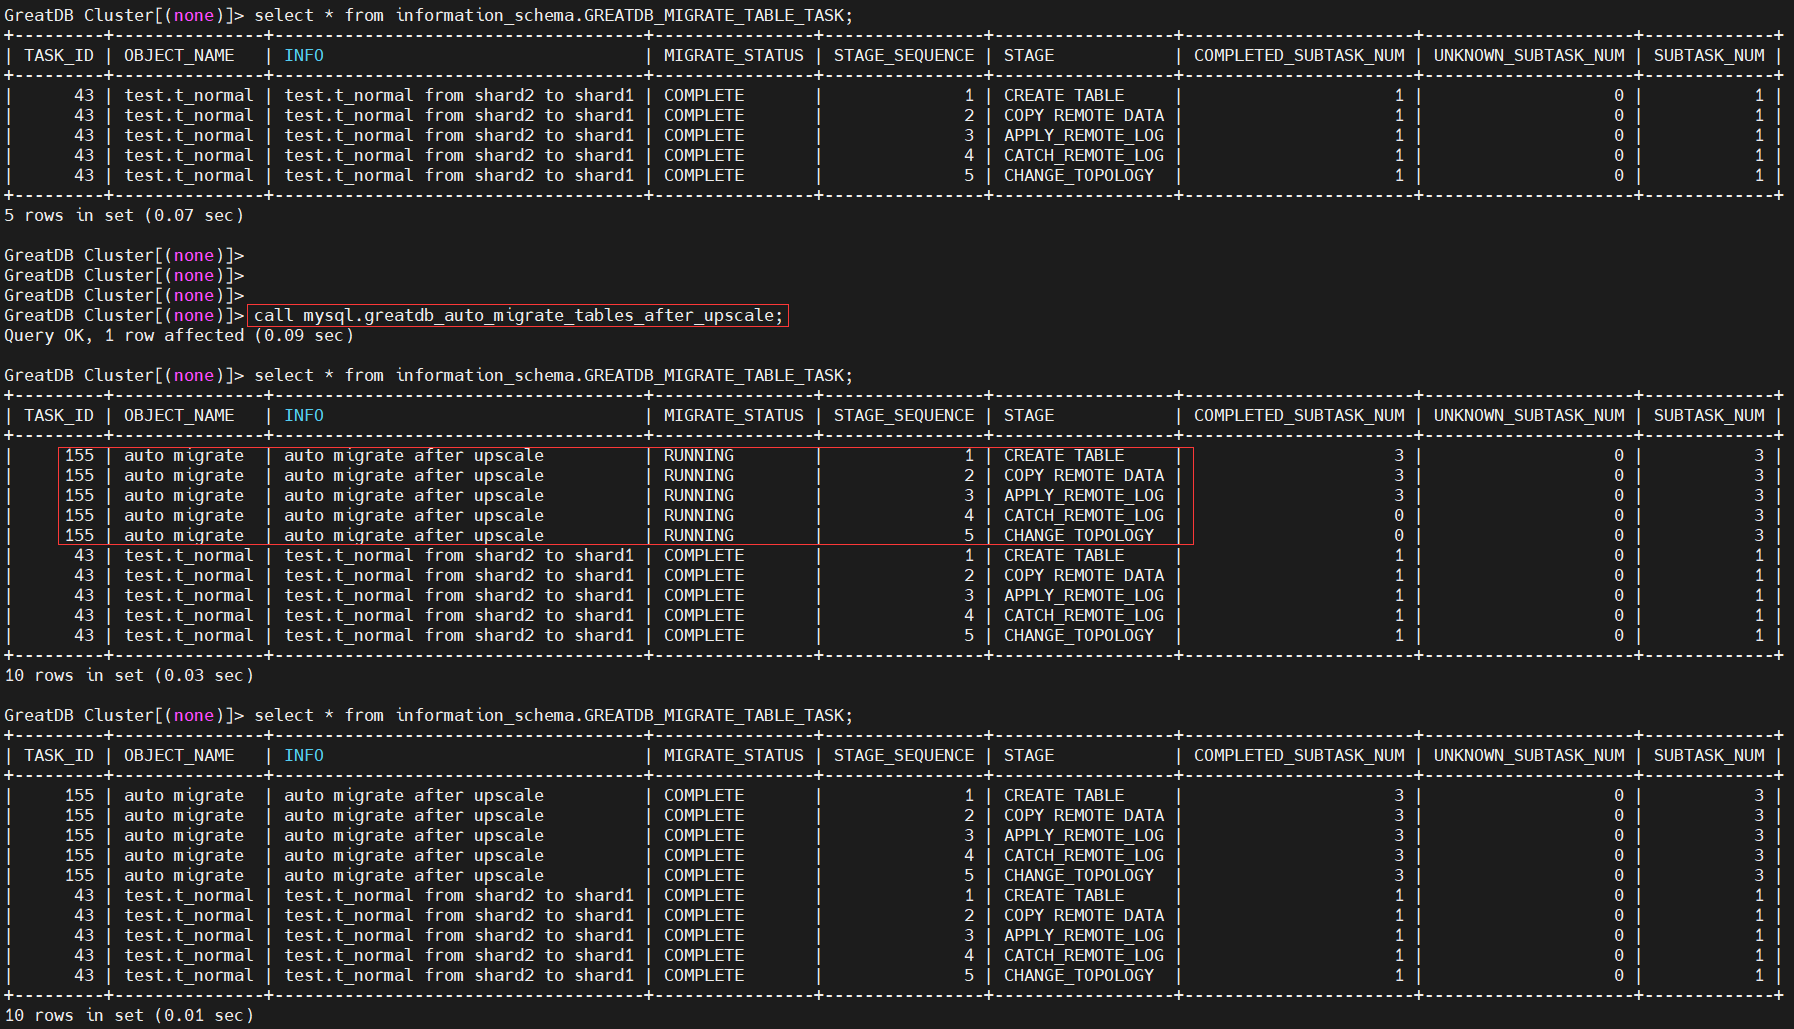
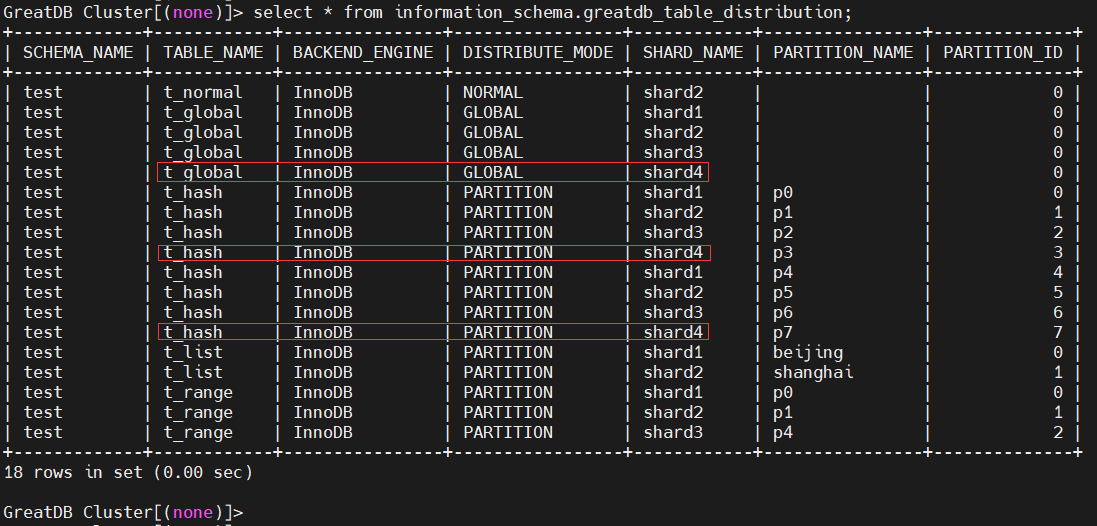
可以看到,数据表已经重分布到 shard4 上了。
整个 Shard 分片的删除
- 删除 Shard 时的注意事项。
- 如果该 shard 中包含用户表数据,则⽆法删除
- 不会停⽌组内数据节点间的复制关系
- 如果 binlog-server 正在获取此 shard 上的 binlog ⽇志,此操作需用户保证同步完该 shard 上的数据
- 将要删除的 Shard 分片中的数据表重分布到其他 Shard 分片中
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

# 传入一个参数,缩容后还剩几个 Shard,默认会将Shard编号从大到小缩容,不能指定删除哪个 Shard
GreatDB Cluster[(none)]> call mysql.greatdb_auto_migrate_tables_before_downscale(3);
GreatDB Cluster[(none)]> select * from information_schema.greatdb_shards;
GreatDB Cluster[(none)]> select * from information_schema.greatdb_table_distribution;
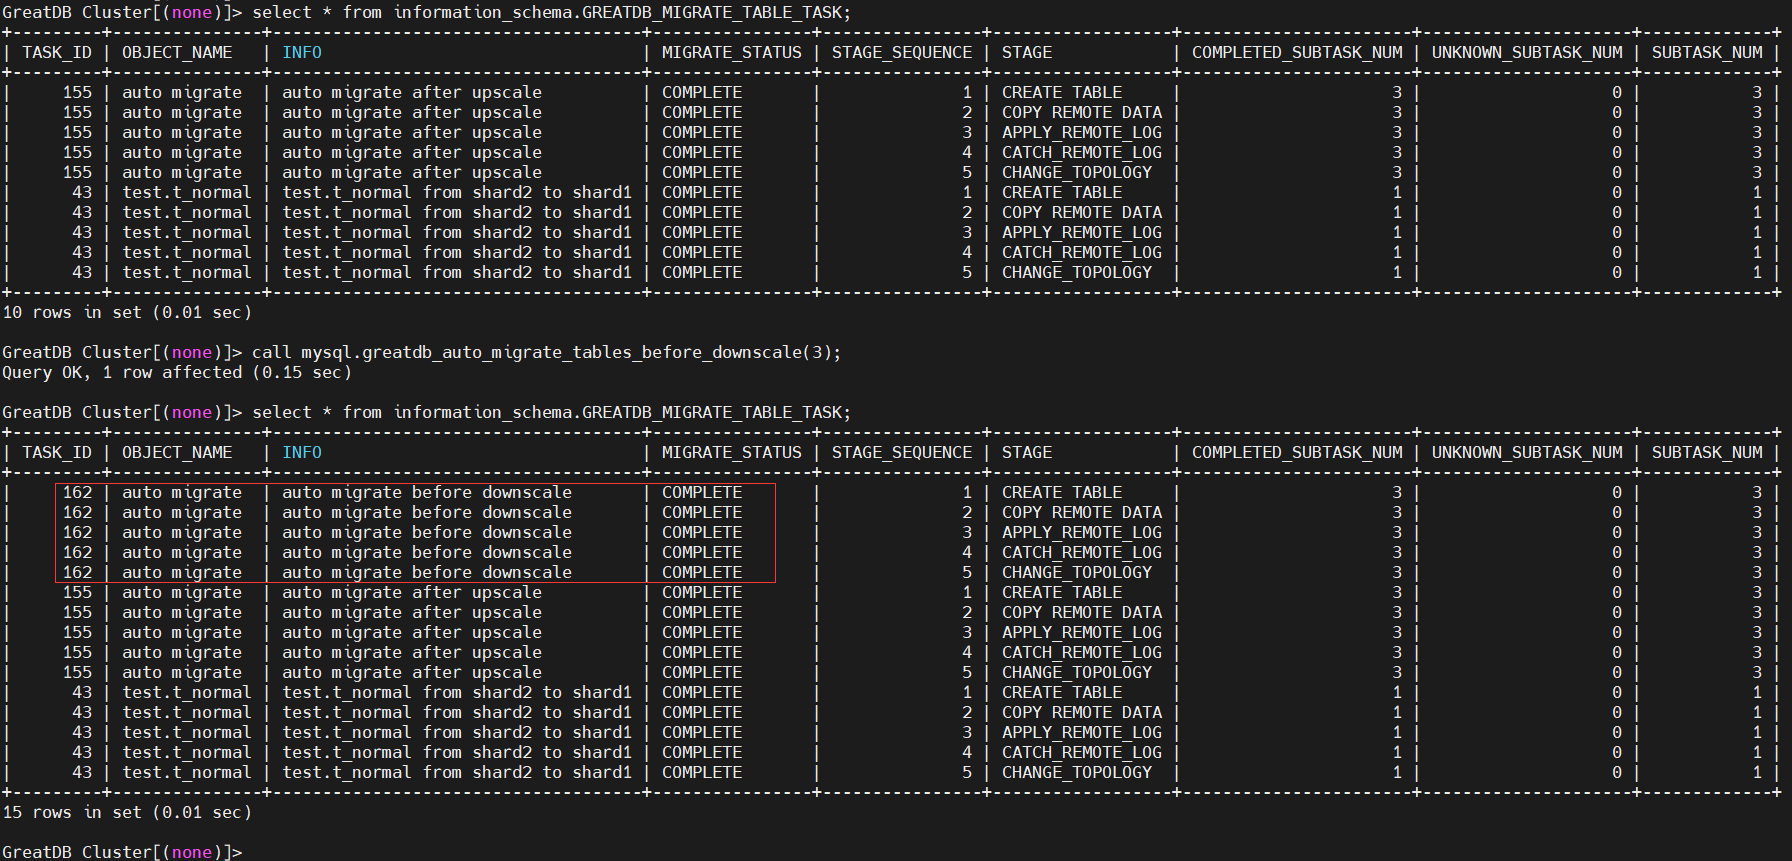
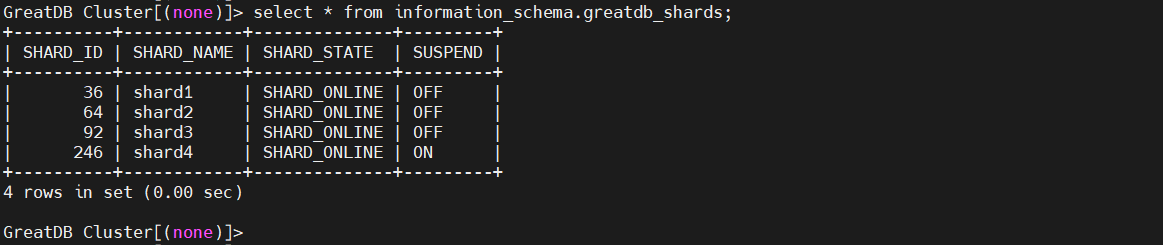
执行过缩容后,Shard 分片节点状态 suspend 挂起状态为ON,新建的表数据存储在shard1-3上,shard4不会被使用。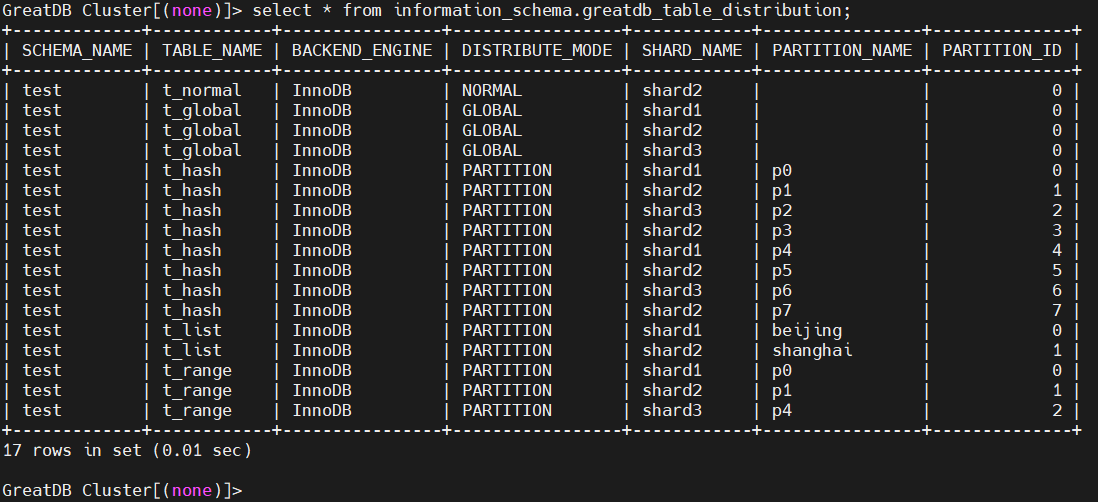
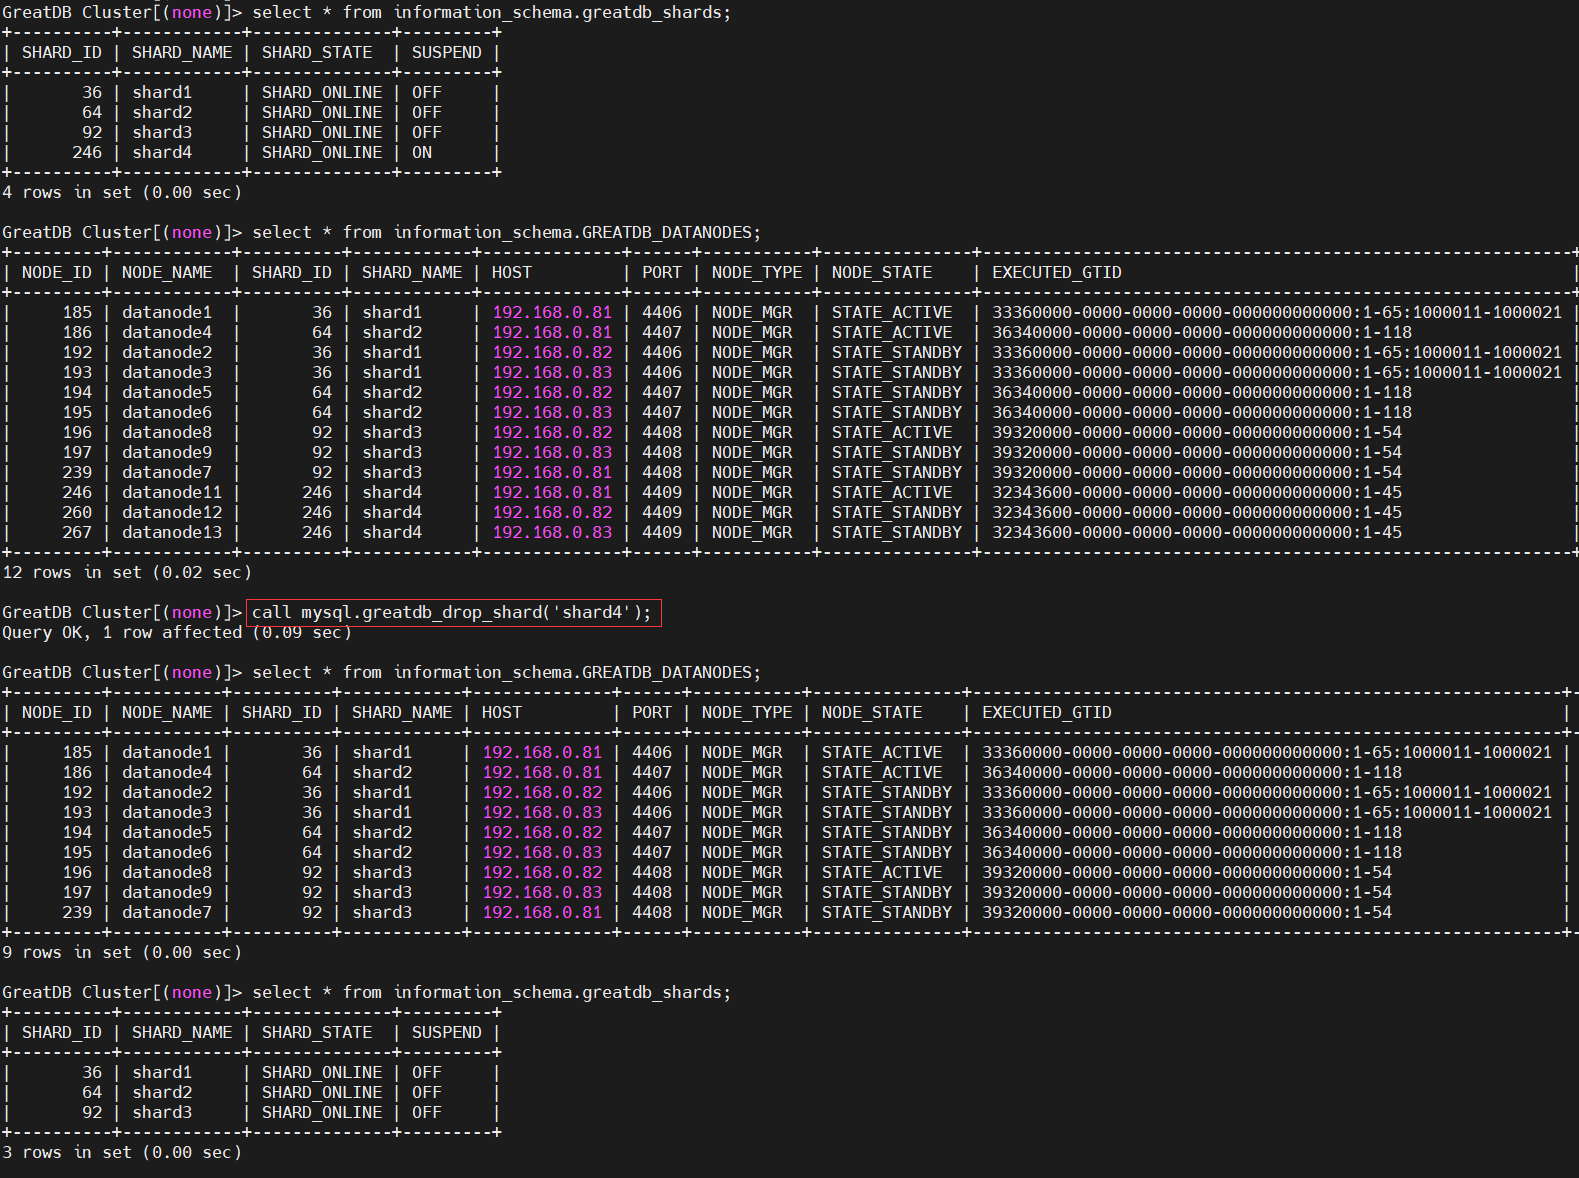
- 调用存储过程删除处于挂起状态的 shard4
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P3306

GreatDB Cluster[(none)]> call mysql.greatdb_drop_shard('shard4');

GreatDB Cluster[(none)]> select * from information_schema.GREATDB_DATANODES;
GreatDB Cluster[(none)]> select * from information_schema.greatdb_shards;
- 关闭实例清理数据文件目录
[root@greatdb1 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.81 -P4409
GreatDB Cluster[(none)]> shutdown;

[root@greatdb2 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.82 -P4409
GreatDB Cluster[(none)]> shutdown;

[root@greatdb3 ~]# greatsql -ugreatdb -pgreatdb -h192.168.0.83 -P4409
GreatDB Cluster[(none)]> shutdown;

[root@greatdb1 ~]# rm -rf /greatdb/dbdata/datanode4409/ /greatdb/conf/datanode4409.cnf
[root@greatdb2 ~]# rm -rf /greatdb/dbdata/datanode4409/ /greatdb/conf/datanode4409.cnf
[root@greatdb3 ~]# rm -rf /greatdb/dbdata/datanode4409/ /greatdb/conf/datanode4409.cnf
GreatDB 数据重分布管理
GreatDB 的数据重分布主要针对的是 Shard 节点在进行扩缩容之后,针对表数据在各个 Shard 间的均匀分布,进行的内部数据迁移的过程。
重分布分为两种情况:
第一种:手动针对指定的表进行迁移分布到指定 Shard。目的是避免数据过于集中在单个 Shard,造成集群局部压力较大的情况。
第二种:自动数据迁移重分布。自动迁移目的是在扩容 Shard 后,针对分区表,全局表自动进行新 Shard 的数据分布均衡,普通表则不会自动迁移仍旧存储在原有 Shard 上。
- 注意:在重分布过程中,会产生短暂的MDL锁,所以在进行数据重分布操作时,避免在业务高峰进行,否则可能会产生业务阻塞情况出现。无论是数据重分布时的扩容迁移,还是缩容迁移,在迁移过程中,每次逐个针对单张表进行迁移。
手动执行数据重分布
手动执行数据重分布,调用接口如下:
CALL mysql.greatdb_migrate_table(‘db_name’, ‘table_name’, part_id, ‘shard_name’ );
选项介绍:
1、part_id 为分区表(partition表)的分区id,如果是分区表,则迁移该表的特定分区数据,如果不是分区表,该值不具有任何意义,将迁移全表数据。
2、shard_name 为迁移的目标Shard,如扩容操作。
CALL `mysql`.`greatdb_migrate_table`('test', 'gt1', , 'sd3');
CALL `mysql`.`greatdb_migrate_table`('test', 'pt1', 2, 'sd3');
GreatDB 缩容删除 Shard 的数据重分布
在部分业务机器需要下线或者进行局部硬件下线,缩减集群规模时,则可以执行数据重新分布迁移到其他Shard上,如下:
Shard 缩容实践:
- 初始有4个Shard,sd1、sd2、sd3、sd4, test.nt1 为普通表,分布在 sd3 中,test.pt1为分片表,其中: part_id = 0 在 sd1 中,part_id = 1 在 sd2 中 ,part_id = 2 在 sd3 中 ,part_id = 3 在 sd4 中 。
- 需求:需要删除 sd3 和 sd4
- 此时需要将 nt1 迁到 sd1,pt1#2 迁到 sd1 中,pt1#3 迁到 sd2 中,则先后执行如下命令:
CALL `mysql`.`greatdb_migrate_table`('test', 'nt1', , 'sd1');
CALL `mysql`.`greatdb_migrate_table`('test', 'pt1', 3, 'sd2');
- 迁移完成后,可以调用greatdb_drop_shard删除Shard,完成缩容操作。
GreatDB 数据节点扩缩后自动数据重分布
新扩容的Shard分片如何使用:
1、在 greatdb_init_datanode() 初始化扩容之后,新创建的分区表会自动分布使用。
2、针对当前 GreatDB 集群存量表数据,手动迁移指定普通表,或表分区到新 Shard。
3、调用 GreatDB 集群数据重分布接口,实现 Shard 间的数据自动平衡重分布。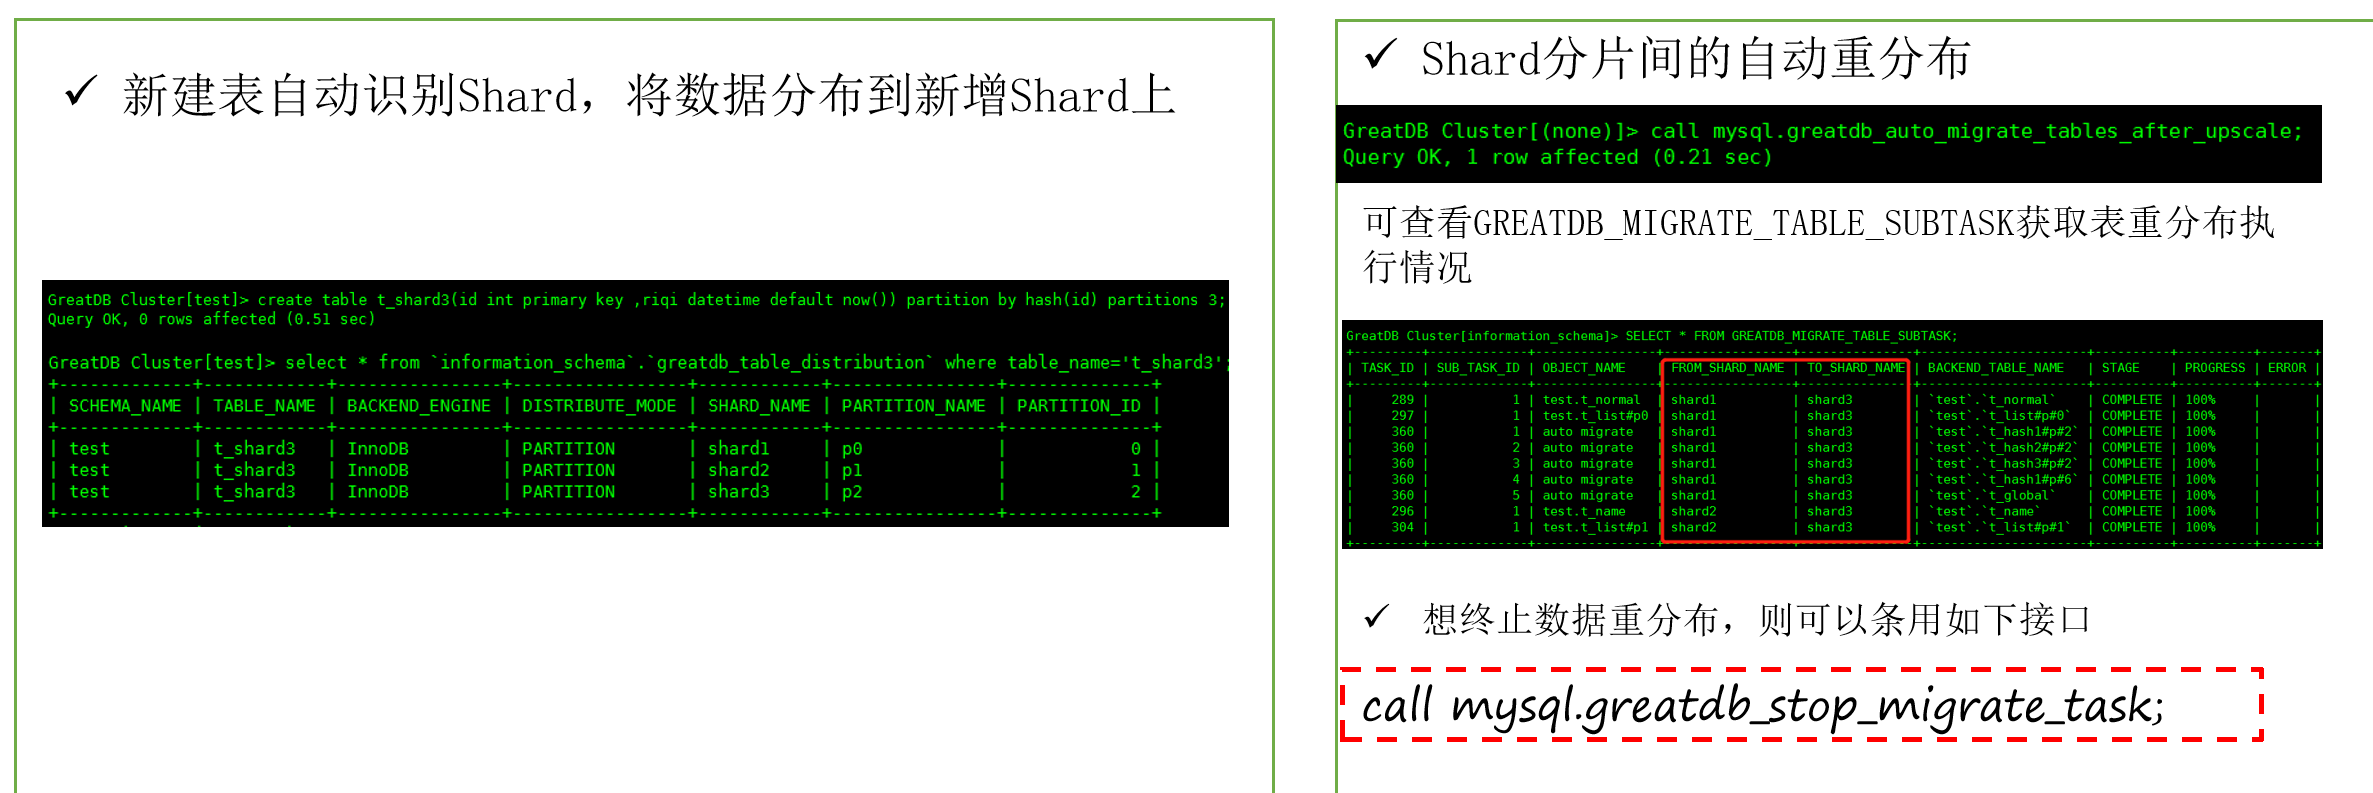
GreatDB 数据重分布查看迁移状态
共有 3 张information_schema的表,可以查看迁移的任务。
1、information_schema.greatdb_task 包含所有的任务信息。
2、information_schema.greatdb_migrate_table_task 包含当前和历史迁移任务的详细信息
3、information_schema.greatdb_migrate_table_subtask 记录子任务的状态信息。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69946831/viewspace-3132095/ ,如需转载,请注明出处,否则将追究法律责任。

