Scylla兼容cassandra API,所以可以使用spark读写cassandra的方法来进行读写
1.查看scyllaDB对应的cassandra版本
1 2 | cqlsh:my_db> SHOW VERSION[cqlsh 5.0.1 | Cassandra 3.0.8 | CQL spec 3.3.1 | Native protocol v4] |
2.查看spark和cassandra对应的版本
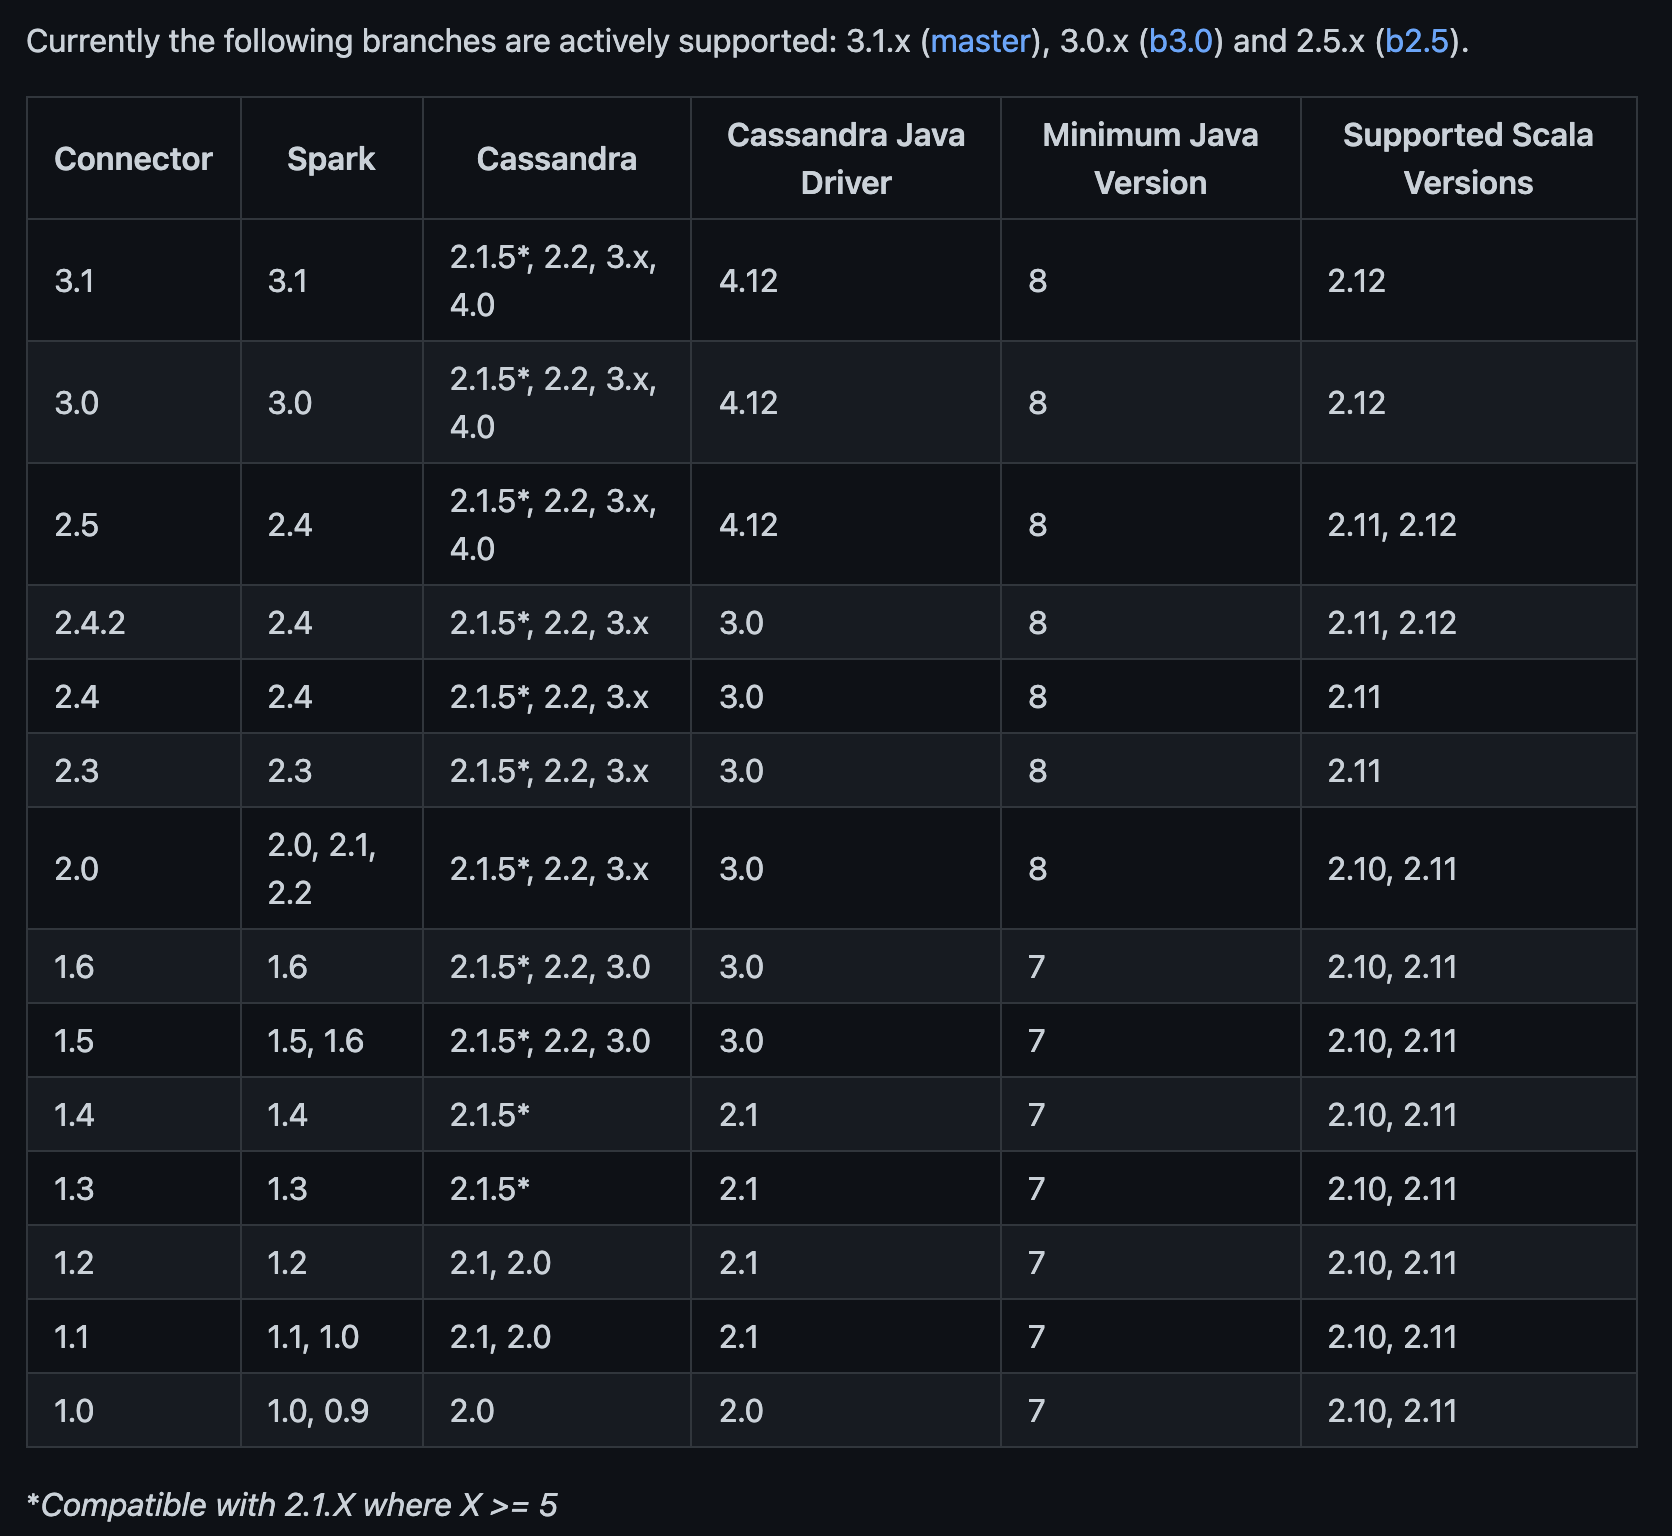
参考:https://github.com/datastax/spark-cassandra-connector
3.写scyllaDB
dataset API写scyllaDB
1 2 3 4 5 | ds2.write .mode("append") .format("org.apache.spark.sql.cassandra") .options(Map("table" -> "my_tb", "keyspace" -> "my_db", "output.consistency.level" -> "ALL", "ttl" -> "8640000")) .save() |
RDD API写scyllaDB
1 2 3 4 | import com.datastax.oss.driver.api.core.ConsistencyLevelimport com.datastax.spark.connector._ds.rdd.saveToCassandra("my_db", "my_tb", writeConf = WriteConf(ttl = TTLOption.constant(8640000), consistencyLevel = ConsistencyLevel.ALL)) |
注意字段的数量和顺序需要和ScyllaDB表的顺序一致,可以使用下面方式select字段
1 2 3 4 5 6 7 8 9 10 | val columns = Seq[String]( "a", "b", "c")val colNames = columns.map(name => col(name))val colRefs = columns.map(name => toNamedColumnRef(name))val df2 = df.select(colNames: _*)df2.rdd .saveToCassandra(ks, table, SomeColumns(colRefs: _*), writeConf = WriteConf(ttl = TTLOption.constant(8640000), consistencyLevel = ConsistencyLevel.ALL)) |
不过官方推荐使用DataFrame API,而不是RDD API
If you have the option we recommend using DataFrames instead of RDDs
1 | https://github.com/datastax/spark-cassandra-connector/blob/master/doc/4_mapper.md |
4.读scyllaDB
1 2 3 4 5 | val df = spark .read .format("org.apache.spark.sql.cassandra") .options(Map( "table" -> "words", "keyspace" -> "test" )) .load() |
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69946831/viewspace-3124766/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
